
要旨
プロンプト可能なセグメンテーションは、点やボックスなどの入力によって対象を指定するが、プロンプトの与え方、対象物の階層、人による対話操作の予算はいずれも結果に影響する。本稿では、SAMの画像符号化とマスク復号のインターフェース、およびSAM 2における動画メモリの文脈を分析し、空間的な重なり、時間的一貫性、意味的な正しさを区別する。図に示すのは矩形の平行移動後に解析的に求めたIoUであり、いずれのSAMモデルの試験成績でもない。[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos[3] Learning Transferable Visual Models From Natural Langua
原文の英語要旨の翻訳
プロンプト可能なセグメンテーションは、対象物とプロンプト予算を指定した対話型システムとして評価される。本稿では、マスクの曖昧性、信頼度予測、時間的メモリ、意味認識を区別する。平行移動した矩形の例を用い、SAMを実行せずにIoUの感度を導出する。ドメイン転移と動画の一貫性には、ラベル付きデータによる独立した評価が必要である。
1. プロンプトは入力形式だけでなくタスクを定義する
ある点は、対象物全体、一部の部品、あるいはテクスチャ領域を指す場合があり、複数のマスクが妥当となりうる。まず対象物の定義とアノテーション方針を定め、その後、点、ボックス、テキストをどのように生成するかを説明すべきである。人が最も有利なプロンプトを選択する場合と、固定された自動プロンプトを用いる場合とではコストが異なる。プロンプト可能なモデルの試験では、複数の候補から事後的に選んだ最良のマスクだけを報告するのではなく、対話操作の回数、修正、失敗をすべて計上する必要がある。[1] Segment Anything
2. 符号化の再利用と軽量な復号には工学的条件がある
画像の符号化結果は複数のプロンプト間で再利用でき、その後、プロンプトとマスクデコーダを用いて結果を生成できる。再利用のキーは、画像、前処理、モデルのバージョンに紐付けなければならない。拡大縮小、切り抜き、座標変換の誤りによって、プロンプトの位置がずれる可能性がある。レイテンシは初回の符号化と後続の対話操作に分け、メモリ使用量も記録すべきである。ウォームキャッシュでの復号だけを測定した場合、その結果を初回読み込みから出力までの総レイテンシとして記述してはならない。[1] Segment Anything
3. 複数のマスクと品質スコアは外部の正解ではない
モデルは曖昧性に対処するため、複数の候補と品質推定値を出力する場合がある。予測スコアには独立した較正が必要であり、アノテーションとの比較を代替できない。最高スコアの候補を選ぶことと、正解を用いて最良の候補を選ぶことは、異なる評価プロトコルである。小さな対象物、細長い境界、遮蔽、類似した隣接対象物も確認すべきであり、平均IoUは重大な失敗を覆い隠す可能性がある。対象物の範囲が一致しない場合、重なりの低さは純粋な視覚的誤りだけでなく、アノテーションの曖昧性に由来することもある。[1] Segment Anything
4. 動画の一貫性があっても、誤った対象物を安定して追跡し続ける可能性がある
SAM 2はプロンプト可能なセグメンテーションを動画の文脈へ拡張する。メモリはフレーム間の伝播を支援する一方、初期の誤りを引き継ぐ可能性もある。時間的な滑らかさと軌跡の連続性は、対象物の同一性や境界の正しさを保証しない。遮蔽、再出現、類似した対象物の位置の入れ替わりには、専用の試験が必要である。新しいプロンプトをいつ許可するか、誰が提供するか、修正回数はいくつかを記録し、メモリのリセットと新しいショットの状況を受け入れ試験に含めるべきである。[2] SAM 2: Segment Anything in Images and Videos
5. セグメンテーションと意味認識では必要な証拠が異なる
マスクはどの画素が対象領域に属するかを示すが、正しい生物種、病理分類、材料分類を必ずしも与えるものではない。CLIP型の表現は画像とテキストの対応に着目しており、精密な画素境界を自動的に提供するものでもない。両者を組み合わせる場合、特に専門領域では、位置特定と意味をそれぞれ検証する必要がある。公開されている自然画像での高い性能を、医療画像、リモートセンシング画像、顕微鏡画像での利用可能性の直接的な証明とみなすことはできない。適法に取得されたドメインのアノテーションを使用し、誤りのコストを明示すべきである。[3] Learning Transferable Visual Models From Natural Langua[1] Segment Anything
6. 検証ではプロンプト予算とデータ分割を固定すべきである
画像の出所または動画シーケンスごとにデータを分離して分割し、隣接フレームの漏洩を防ぐ。プロンプト生成と候補選択の規則を事前に定める。IoU、境界品質、対象物の見失い、対話操作のコストを報告し、大きさ、遮蔽、ドメイン別に層別化する。本稿の矩形の例が示すのは境界変位とIoUの関係のみであり、実際の複雑な形状やモデルの評価を代替できない。実運用にはさらに、バージョン管理されたキャッシュ、失敗時のフォールバック、人による修正経路が必要である。[1] Segment Anything[2] SAM 2: Segment Anything in Images and Videos
主要な数式と導出
(1) Mは予測、Gはアノテーションを表す。空集合と曖昧なアノテーションについては、別途規則を定めるべきである。
LaTeX
\operatorname{IoU}=\frac{|M\cap G|}{|M\cup G|}=\frac{TP}{TP+FP+FN}(2) 同じ大きさの矩形同士が水平方向にのみdだけ平行移動し、垂直方向では完全に重なる場合に成立する。図ではw=100、高さ60を用いる。
LaTeX
\operatorname{IoU}(d)=\frac{w-d}{w+d},\qquad0\le d\le w(3) 符号化結果を再利用する後続の対話操作と初回処理は、別々に計時すべきである。本稿ではモデルのレイテンシを実測していない。
LaTeX
\tau_{\mathrm{interaction}}=\tau_{\mathrm{prompt}}+\tau_{\mathrm{decode}},\quad\tau_{\mathrm{first}}=\tau_{\mathrm{encode}}+\tau_{\mathrm{interaction}}手法と証拠のフロー
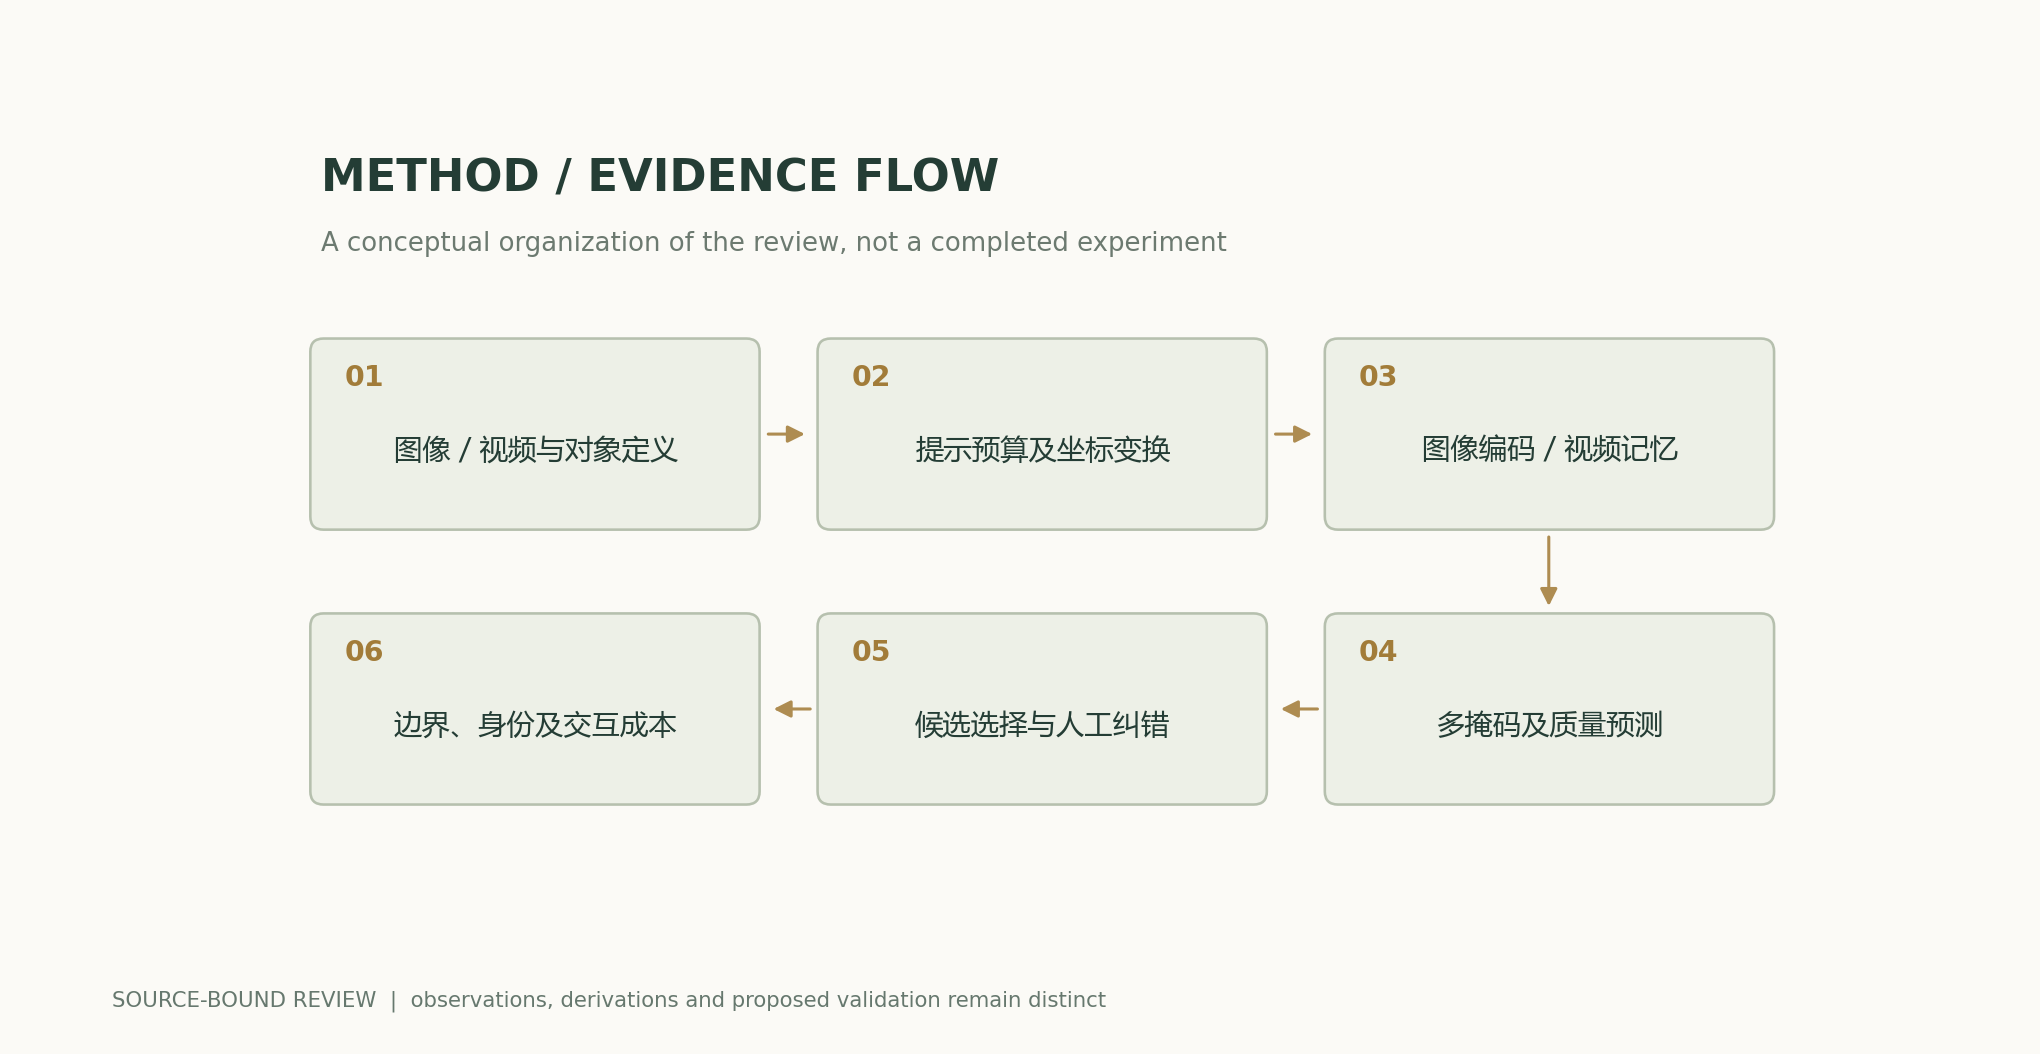
解析図と数値例
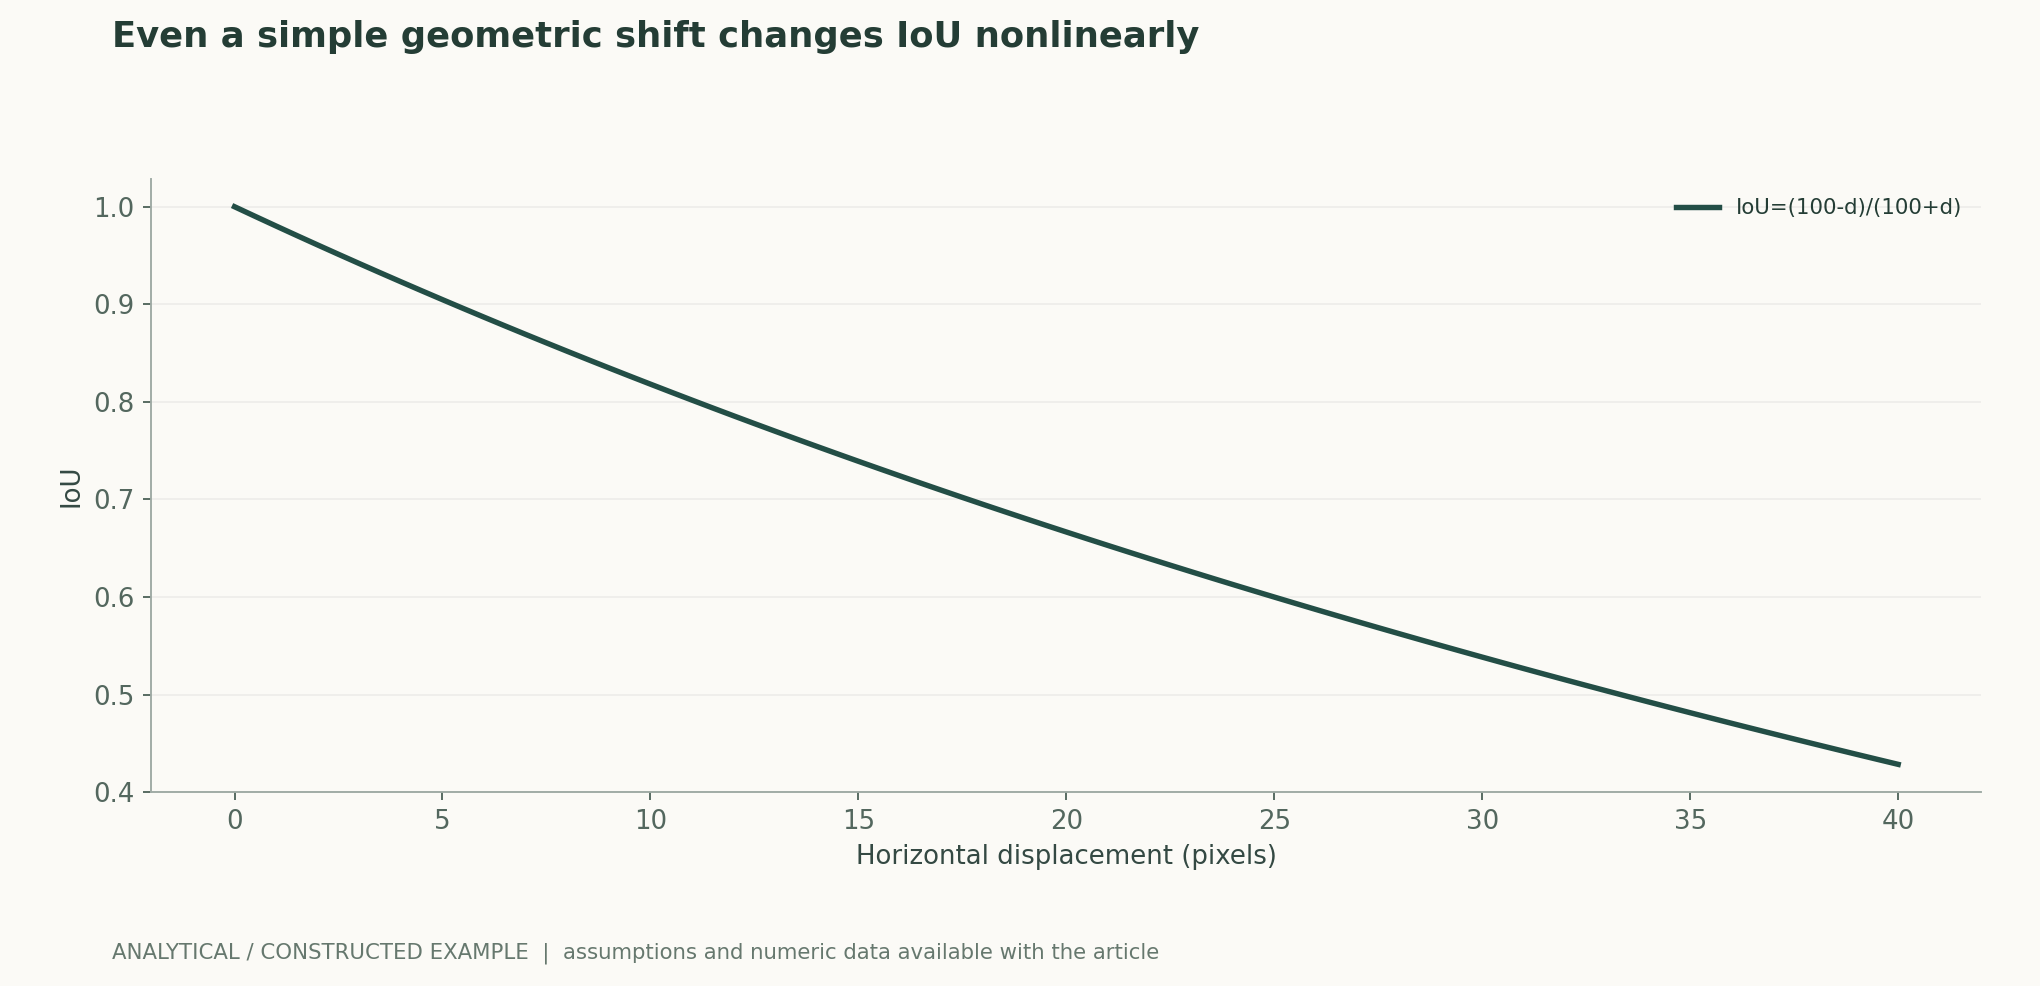
再計算可能な例題
水平方向に10画素移動するとIoU=90/110≈0.818となり、25画素移動すると75/125=0.6となる。複雑な境界とアノテーションの曖昧性は、この矩形モデルでは完全に記述できない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| プロンプトのプロトコル | 点/ボックスの出所、対話操作の回数、対象物の定義を固定する | 人による事後的な選択は結果を過大にする |
| 候補の品質 | 予測に基づく選択と正解に基づく最良候補の選択を区別する | 予測スコアはアノテーションではない |
| 動画メモリ | 遮蔽、再出現、ショット切り替え、修正を試験する | 時間的一貫性があっても、誤った対象物を追跡し続ける可能性がある |
| ドメイン転移 | 独立したドメインのアノテーションとリスクの層別化 | 自然画像での成績を直接外挿することはできない |
検証と実験の計画
- モデル、前処理、対象物の定義、適法に取得されたアノテーションのバージョンを固定する。
- 出所/動画ごとに分割し、隣接フレームや同一画像の変種の漏洩を防ぐ。
- プロンプトと候補選択の予算を事前に固定し、すべての修正を記録する。
- 小さな対象、境界、遮蔽、類似対象物、再出現、新しいショットを試験する。
- 重なり、境界、同一性の喪失、対話操作の回数、層別化した失敗を併せて報告する。
- 初回の符号化とキャッシュを利用する対話操作のコストを別々に測定し、キャッシュのバージョンと座標変換を確認する。
適用範囲と限界
- 矩形のIoUはSAMの成績ではない。
- 時間的一貫性は同一性の正しさを証明しない。
- ドメイン転移には独立したアノテーションが必要である。
- プロンプトと候補の予算は比較に影響する。
一次資料と主張の対応
- Segment Anything, , , , , , , , , , , · 2023-04-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SAM 2: Segment Anything in Images and Videos, , , , , , , , , , , , , , , , , L12: View a PDF of the paper titled SAM 2: Segment Anything in Images and Videos, by Nikhila Ravi and 17 other authors · 2024-08-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Learning Transferable Visual Models From Natural Language SupervisionRadford et al. · 2021-02-26v1; contrastive training and zero-shot transfer
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿の独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前のバージョンの内容を維持している。
概念的な表紙と科学図は分けて扱う。科学図は公開された数式と明示的な仮定から計算し、原論文の結果にはすべて帰属先を明記する。
著者、バージョン、訂正履歴 · /guides/vision-segmentation-foundation/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソース改訂: 6251a250b27bb8b449f59b392f81abd355383770