
摘要
模拟存内计算通过物理电导、电流和电压执行算术运算,但可用的神经网络加速器还包括转换、通信和控制。本综述将器件层面的构想与训练及芯片演示联系起来,推导出覆盖完整核算边界的能耗模型,说明为何仅凭低能耗乘法并不足以证明系统高效。
乘法可以是物理过程
交叉阵列可以用电导表示权重、用电压表示输入,并通过电路定律产生求和电流。这使得数据所在位置能够进行并行算术运算。然而,有用的计算还需要对输入进行编码、感测输出并搬移结果。公平的能耗比较应包含执行所声明工作负载所需的完整路径。
从方案构想到集成演示
Gokmen和Vlasov分析了电阻式交叉点训练的设计考量。Ambrogio及其同事展示了模拟存储器训练,其准确度可与选定的数字参考方案相媲美。Le Gallo及其同事报告了一款采用相变存储器的64核混合信号推理芯片。这些研究针对不同阶段和工作负载;其能耗或准确度数据不应在训练、推理和完整系统运行之间混用。 [1], [2], [3]
精度有其物理代价
即使存在噪声、漂移和器件差异,也必须能够区分微小的电导差异。提高有效精度可能需要重复读取、更大的信号或成本更高的转换。最优精度取决于网络和任务。若不说明误差如何传播至最终输出,仅给出标称位数是不够的。
转换可能主导能耗预算
数模转换和模数转换消耗的能量可能与阵列运算相当,甚至更高。更高的分辨率和采样率会改变这一成本。因此,即使加速器的阵列效率十分出色,如果转换频繁发生,或无法在多次运算之间共享,系统层面的改善也可能小得多。
通信规模随映射而变化
一个网络很少能在不分割的情况下装入单个理想阵列。中间激活值必须在计算块之间传输,一些运算也可能仍以数字方式执行。稀疏性和不规则维度可能降低利用率。仅报告稠密阵列的峰值吞吐量,可能掩盖真实模型的映射成本以及处于闲置状态的硬件比例。
器件漂移是随时间变化的误差
存储的电导可能在编程后以及温度变化时发生变化。校准、补偿或重新训练可能恢复准确度,但这些操作会消耗时间和能量。评估应包含随时间推移和环境变化而产生的变动,而不能只考察刚完成编程时的性能。部署层面的效率主张应计入维护开销。
训练与推理提出不同要求
训练会反复更新权重,可能需要精确累积微小变化。推理可以使用大体固定的权重,但仍需要准确读取和激活值处理。适合其中一种用途的器件,可能不适合另一种。比较时应保持工作负载、目标准确度、批大小和更新频率一致。
系统收益取决于未加速部分
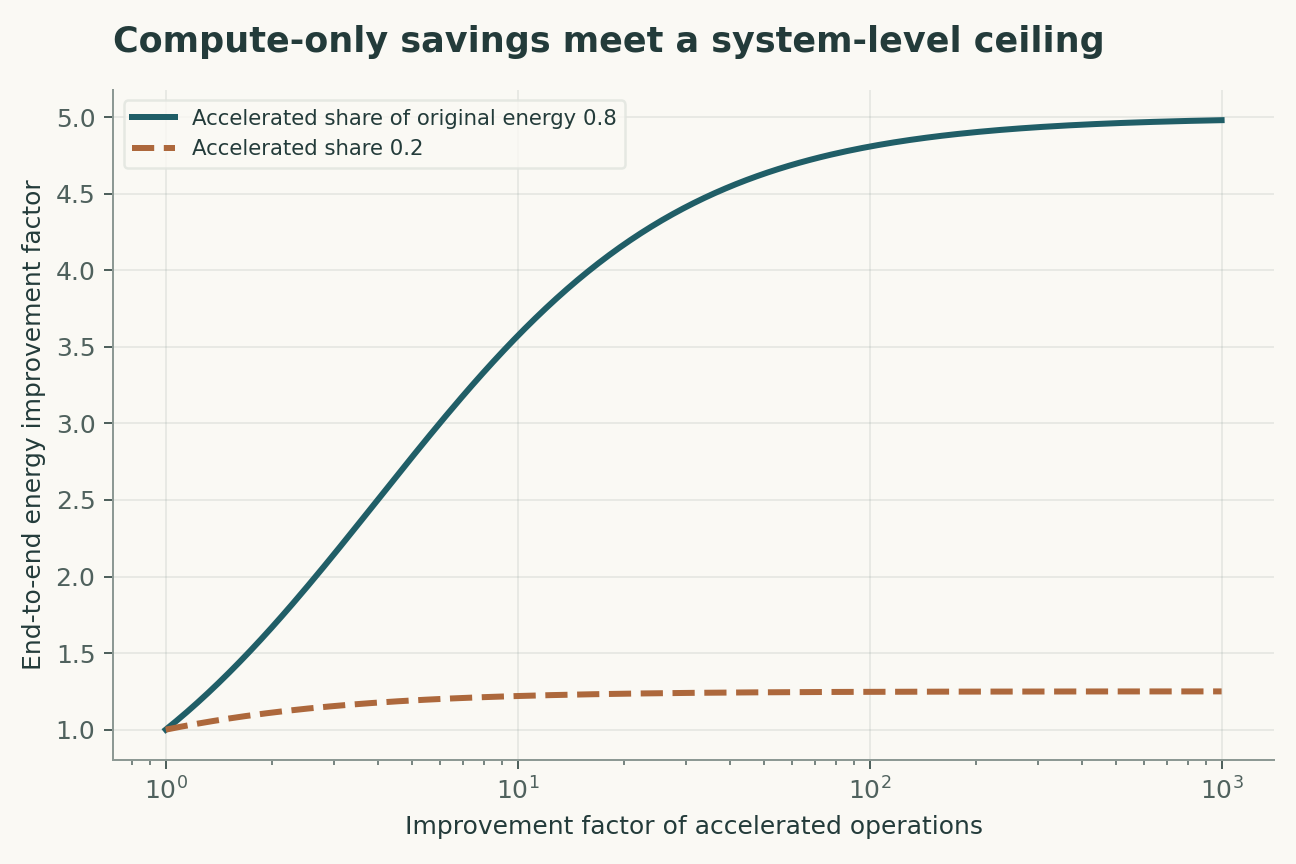
如果工作负载的能耗只有一部分用于被加速的运算,那么即使局部改善极大,总体收益仍然有限。这种核算有助于防止仅根据孤立运算作出主张。有说服力的演示应在输出质量和延迟相匹配的条件下,测量完整工作负载的插座端能耗,或边界明确的芯片级能耗。
运算次数不是能耗测量
交叉阵列执行模拟变换,但其周边的输入编码、转换、累加、存储器访问和控制也会消耗能量。拟议的基准测试将在明确的批大小、精度和延迟目标下测量完整推理路径。将器件级乘法估算与配备齐全的数字系统相比较,会混淆核算边界。能耗占比计算说明,即使某项运算获得巨大改善,总体收益仍可能有限。它还指出了一个有用的后续测量量:拟议架构实际加速的部分占基线能耗的比例。
误差补偿具有计算成本
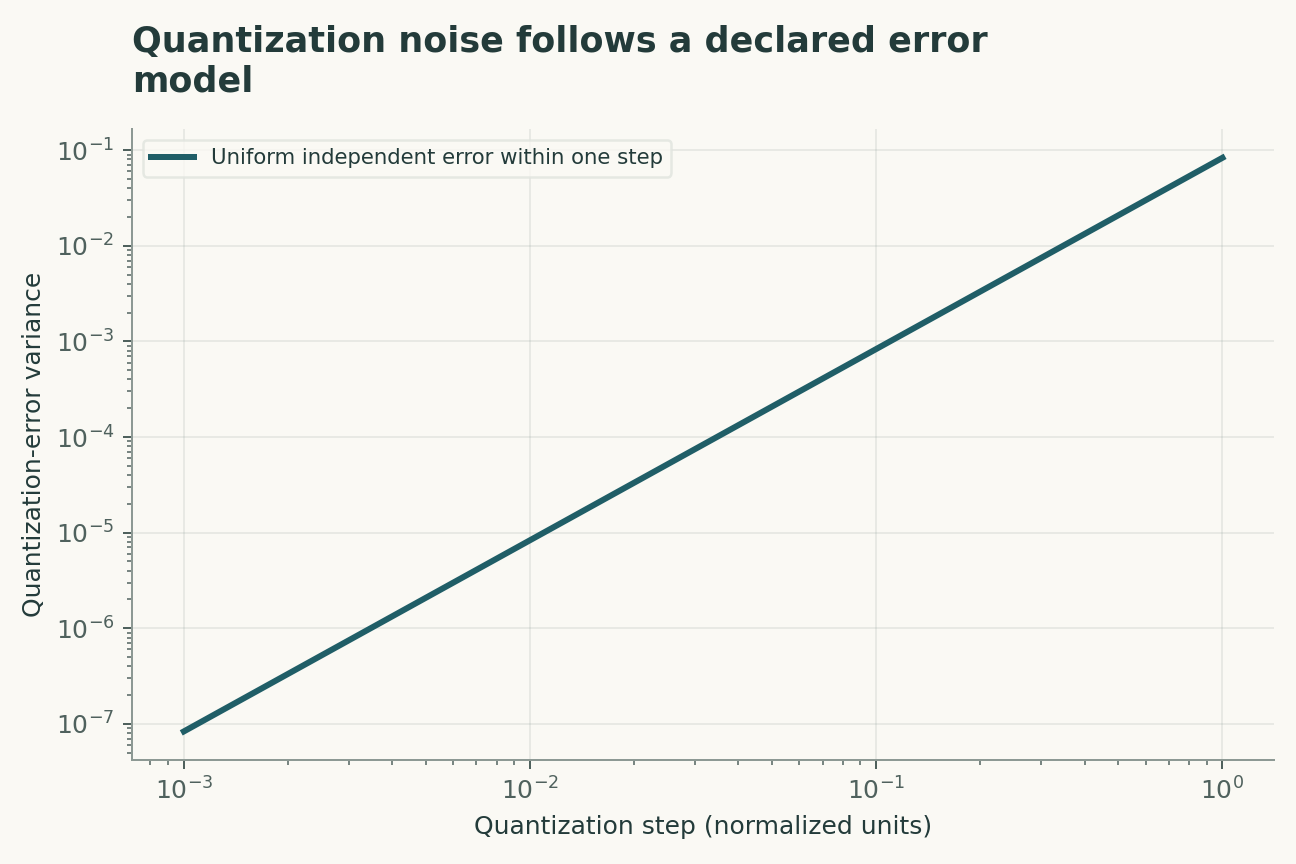
校准、重新训练和冗余编码可以恢复因器件差异而受损的准确度,但会增加计算、存储或运行复杂性。拟议比较将在明确说明的服务周期内计入这些成本。准确度应在发生现实条件下的漂移之后、按照预期输入分布进行评估,而不是在有利的校准完成后立即评估。均匀量化噪声公式只是参考模型;削波和相关电导误差可能违背其假设。若在同一工作负载下同时测量准确度、能耗、延迟和维护开销,而不是将分别演示的最佳情况拼凑起来,系统层面的主张就会更有说服力。
可接受质疑和检验的模型
下列四个方程构成一个简洁的解析模型,并非对所有引用论文进行的联合拟合。其解释如下:理想交叉阵列中的电流实现按电导加权的求和;导线电阻和器件非线性会引入偏差。能耗边界包括转换、通信和控制,而不仅是阵列。如果基线能耗中占比为f的部分改善了r倍,其他项保持不变,则可据此得到总体能耗改善倍数。均匀量化误差方差假定输入具有足够变化且不存在过载;它不是通用的器件噪声模型。
观测目标是在准确度和延迟相匹配时,完整工作负载的能耗。模型有意分离出一种便于分析的机制,旨在揭示哪些测量能够将该机制与替代机制区分开来。图中的参数值明确声明为示例性输入。由这些数值生成的曲线是数学推论,而不是对尚未测量的生物学量或物理量的估计。
具有区分能力的验证设计
主要比较应检验计入所有必要的数据搬移和校准之后的能耗收益。独立重复的单位是独立芯片或独立的工作负载执行;对同一单位反复读数可以提高测量精密度,但不能产生独立重复。严格的验证应在选择阈值或拟合干扰因素校正之前,留出新的网络和工作温度作为测试条件。尤其必须测量、约束转换开销、器件漂移和低阵列利用率,或在敏感性分析中改变这些因素。应同时报告主要估计值,以及放宽该假设后估计值如何变化。只有在选择最有利的排除规则后才成功的模型,与使用预先锁定规则评估的模型,回答的是不同的问题。
数值分析算例
如果占基线能耗80%的部分加速100倍,而其余部分保持不变,总体改善约为4.81倍,而非100倍。如果只有20%的部分被加速,相同的局部收益带来的总体改善约为1.247倍。图中改变了被加速部分的占比和局部收益,随后展示量化方差如何随步长减小而下降。这些是核算示例,并未复现商业芯片的基准测试。
这些计算可以通过配套的Python文件及其参数表重建。坐标轴标签保留了模型的单位,图注则区分了变化量和固定量。选择这些数值示例是为了揭示依赖关系,而不是复现已发表图表的外观。一种有用的独立检验方法是评估极限情形,然后不借助绘图代码重新计算一个中间点。结果一致能够验证所声明模型内部的算术计算,但不能证明自然界遵循该模型。
证据、迁移与后续步骤
结论的适用范围受到转换开销、器件漂移和低阵列利用率的限制。要迁移至新的网络和工作温度,需要超出对原始观测进行拟合的证据。未来的重复研究应保留原始测量数据、校准记录、排除记录,以及每项结果与相应分析之间的机器可读关联。下方的证据表说明了每项选定原始研究的贡献。该比较是聚焦的叙述性综合,而不是系统综述,也不声称已经调查所有后续证据。本文并未实施所提出的研究。其价值在于,阴性结果将约束一个明确的解释,而不仅仅是降低基准测试分数。
明确声明的解析模型
四个方程,明确的假设
(1) 理想交叉阵列中的电流实现按电导加权的求和;导线电阻和器件非线性会引入偏差。
(2) 能耗边界包括转换、通信和控制,而不仅是阵列。
(3) 如果基线能耗中占比为f的部分改善了r倍,其他项保持不变,则可据此得到总体能耗改善倍数。
(4) 均匀量化误差方差假定输入具有足够变化且不存在过载;它不是通用的器件噪声模型。
构造示例 · 可复现数据
审视定量论证
这些曲线根据所声明的模型计算得出,并非引用研究中的观测结果。每幅图均附有数值数据和矢量版本。


哪些证据回答哪些问题?
| 证据或设计选择 | 所能确定的内容 | 尚未解决的问题 |
|---|---|---|
| 来源1 | 电阻式交叉点分析确定了训练的设计要求。 | 设计研究并不是对完整已部署系统的能耗测量。 |
| 来源2 | 模拟存储器训练在选定工作负载上展示了准确度。 | 准确度和效率取决于算法与硬件条件。 |
| 来源3 | 一款集成混合信号芯片演示了神经网络推理。 | 芯片边界、映射成本和转换成本对比较至关重要。 |
| 主要观测量 | 准确度和延迟相匹配时的完整工作负载能耗 | 转换开销、器件漂移和低阵列利用率 |
| 独立检验 | 计入所有必要的数据搬移和校准之后的能耗收益 | 需要新的测量 |
| 迁移测试集 | 新的网络和工作温度 | 尚未通过所构造的数值示例验证 |
拟议验证方案
这是一个拟议的评估设计。本文未开展任何新的生物学实验、临床试验或物理实验。
- 在拟合之前,明确规定准确度和延迟相匹配时的完整工作负载能耗。
- 为每个独立芯片或每次独立的工作负载执行保留独立标识符。
- 将新的网络和工作温度与模型开发分离。
- 测量转换开销、器件漂移和低阵列利用率,或确定其界限。
- 记录单位、校准和观测算子。
- 将主要模型与明确命名的竞争性解释进行比较。
- 预先规定检验内容:计入所有必要的数据搬移和校准之后的能耗收益。
- 归档原始数据、排除记录、参数文件和可执行分析。
一手来源确立了什么
Tayfun Gokmen, Yurii Vlasov · 2016 [1]
贡献。 电阻式交叉点分析确定了训练的设计要求。
边界。 设计研究并不是对完整已部署系统的能耗测量。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Stefano Ambrogio, Pritish Narayanan, Hsinyu Tsai et al. · 2018 [2]
贡献。 模拟存储器训练在选定工作负载上展示了准确度。
边界。 准确度和效率取决于算法与硬件条件。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Manuel Le Gallo, Riduan Khaddam-Aljameh, Milos Stanisavljevic et al. · 2023 [3]
贡献。 一款集成混合信号芯片演示了神经网络推理。
边界。 芯片边界、映射成本和转换成本对比较至关重要。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
本分析的局限
- 设计研究并不是对完整已部署系统的能耗测量。
- 准确度和效率取决于算法与硬件条件。
- 芯片边界、映射成本和转换成本对比较至关重要。
- 配套图表是构造的解析示例,而非新的实验结果。
- 本综述尚未证明其能够迁移至新的网络和工作温度。
这是对所列原始研究的聚焦叙述性分析,并非系统性文献检索,也不声称全面覆盖截至2026年的研究。
可能改变结论的问题
- 在预期模型维度下,哪种开销占主导?
- 随时间和温度变化,需要多少校准能耗?
- 何种精度分配能够以最低的完整工作负载能耗保持准确度?
参考文献
- Tayfun Gokmen, Yurii Vlasov. Acceleration of Deep Neural Network Training with Resistive Cross-Point Devices: Design Considerations. Frontiers in Neuroscience (2016). 10.3389/fnins.2016.00333.
- Stefano Ambrogio, Pritish Narayanan, Hsinyu Tsai et al.. Equivalent-accuracy accelerated neural-network training using analogue memory. Nature (2018). 10.1038/s41586-018-0180-5.
- Manuel Le Gallo, Riduan Khaddam-Aljameh, Milos Stanisavljevic et al.. A 64-core mixed-signal in-memory compute chip based on phase-change memory for deep neural network inference. Nature Electronics (2023). 10.1038/s41928-023-01010-1.
书目身份信息已与Crossref核对。解释依据可获取的原始记录、摘要和选定文本;对全文及补充方法的覆盖并不全面。
作者与来源
基于来源的研究综述和原创数学分析由Codex(人工智能)撰写。所引用的实验归属于被引用的研究团队。
概念封面使用内置ImageGen工具创建。定量图表是明确构造的分析,附有代码和数值数据;它们不是引用论文中的测量结果。
这份本地草稿没有独立同行评审或期刊录用记录。