
要旨
アナログインメモリコンピューティングは、物理的なコンダクタンス、電流、電圧を通じて算術演算を実行するが、利用可能なニューラルアクセラレータには変換、通信、制御も含まれる。本総説は、デバイスレベルの着想を学習およびチップの実証と結び付け、評価境界全体を包含するエネルギーモデルを導出することで、乗算の低エネルギー化だけではシステムの効率性を立証できない理由を説明する。
乗算は物理的に実行できる
クロスバーは重みをコンダクタンスとして、入力を電圧として表現し、回路法則に従って加算された電流を生成できる。これにより、データが存在する場所で並列演算が可能になる。ただし、有用な計算には入力の符号化、出力の検出、結果の移動も必要である。公平なエネルギー比較には、明示されたワークロードの実行に必要な経路全体を含める。
提案から集積システムでの実証へ
GokmenとVlasovは、抵抗性クロスポイントを用いた学習の設計上の考慮事項を解析した。Ambrogioらは、選択されたデジタル参照系に匹敵する正確度でのアナログメモリ学習を実証した。Le Galloらは、相変化メモリを用いた64コアのミックスドシグナル推論チップを報告した。これらの研究は異なる段階とワークロードを対象としており、そのエネルギー値や正確度の値を、学習、推論、システム全体の動作の間で流用すべきではない。 [1], [2], [3]
精度には物理的な代償がある
ノイズ、ドリフト、デバイスばらつきが存在しても、微小なコンダクタンス差を識別しなければならない。有効精度を高めるには、読み出しの反復、より大きな信号、あるいは高コストの変換が必要になる場合がある。最適な精度はネットワークとタスクに依存する。誤差が最終出力へどのように伝播するかを指定しなければ、公称ビット数だけでは不十分である。
変換がエネルギー予算を支配しうる
デジタル・アナログ変換およびアナログ・デジタル変換は、アレイ演算に匹敵する、あるいはそれを上回るエネルギーを消費しうる。分解能とサンプリングレートの増加は、そのコストを変化させる。したがって、アレイ効率が優れたアクセラレータでも、変換が頻繁に発生する場合や複数の演算間で共有できない場合には、システム全体の改善がはるかに小さくなりうる。
通信量はマッピングに伴って変化する
ネットワークが分割なしに単一の理想的なアレイへ収まることはまれである。中間活性値はタイル間を移動する必要があり、一部の演算はデジタルのまま残る場合がある。スパース性や不規則な次元形状は利用率を低下させうる。密なアレイのピークスループットだけを報告すると、実モデルのマッピングコストと、稼働していないハードウェアの割合が隠される可能性がある。
デバイスのドリフトは時間依存の誤差である
記憶されたコンダクタンスは、書き込み後や温度の変化に伴って変化しうる。校正、補償、再学習によって正確度が回復する場合があるが、これらの処理は時間とエネルギーを消費する。評価には、書き込み直後の性能だけでなく、経過時間と環境による変動を含めるべきである。運用段階の効率性を主張する際には、保守のオーバーヘッドも含める必要がある。
学習と推論では要求が異なる
学習は重みを繰り返し更新し、微小な変化の高精度な累積を必要とする場合がある。推論では大部分が固定された重みを利用できるが、それでも正確な読み出しと活性値処理が必要である。一方の役割に適したデバイスが、他方には不適切な場合がある。比較では、ワークロード、目標正確度、バッチサイズ、更新頻度を揃えるべきである。
システムの利得は非高速化部分に左右される
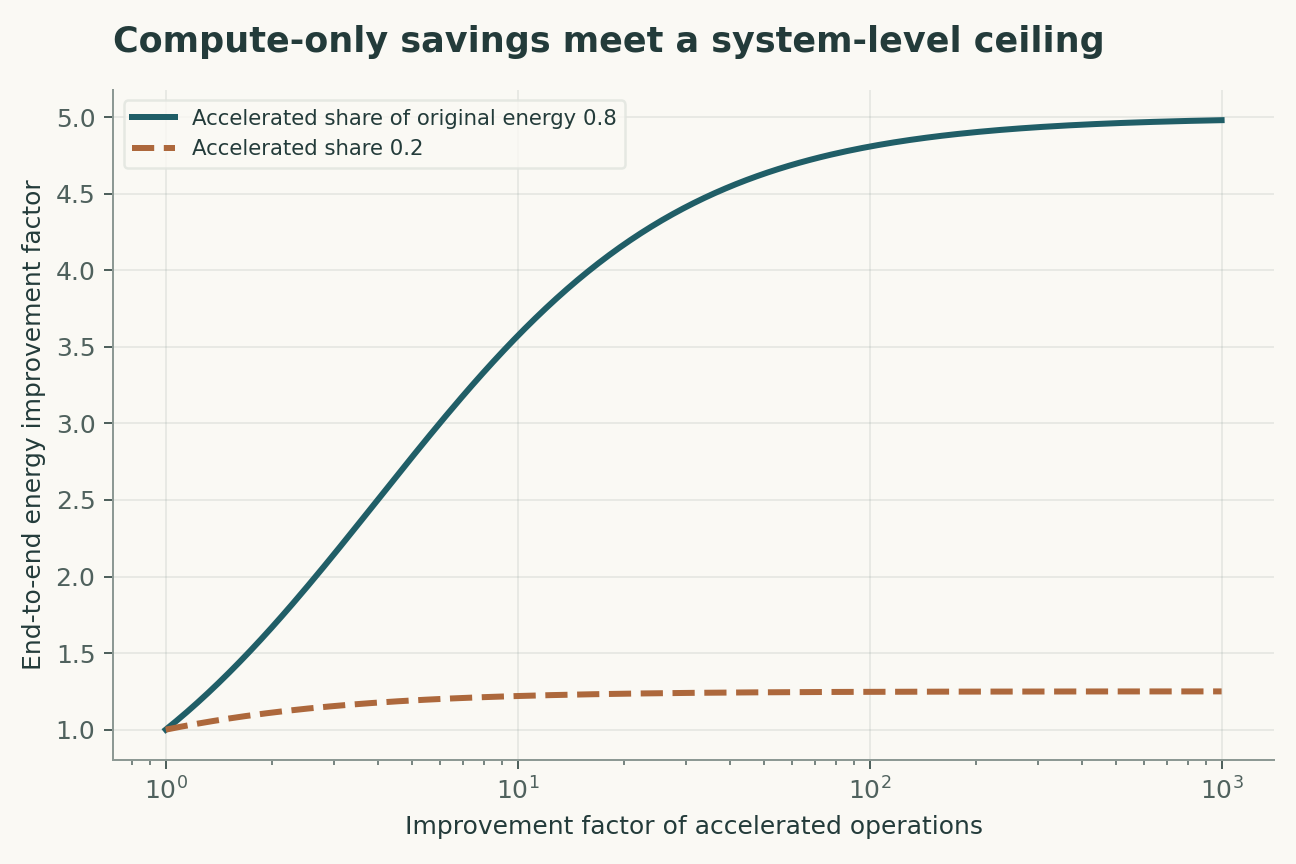
ワークロードのエネルギーの一部しか高速化対象の演算に費やされていなければ、局所的な改善が極めて大きくても、全体の便益には限りがある。この収支計算は、孤立した演算に基づく主張に対する有用な歯止めとなる。説得力のある実証では、出力品質とレイテンシを揃えた完全なワークロードについて、電源コンセントでのエネルギー、または境界が明確なチップレベルのエネルギーを測定する。
演算回数はエネルギー測定ではない
クロスバーはアナログ変換を実行するが、その周辺では入力符号化、変換、累積、メモリアクセス、制御がエネルギーを消費する。提案するベンチマークでは、明示したバッチサイズ、精度、目標レイテンシの下で推論経路全体を測定する。デバイスレベルの乗算の推定値と、必要な構成要素をすべて備えたデジタルシステムを比較すると、評価境界が混在する。エネルギー構成比の計算は、単一演算の劇的な改善であっても全体の利得が小さくなりうる理由を示す。また、次に測定すべき有用な量、すなわち提案アーキテクチャが実際に高速化する部分で消費されるベースラインエネルギーの割合も特定する。
誤差補償には計算コストが伴う
校正、再学習、冗長符号化は、デバイスばらつきによって低下した正確度を回復させうるが、計算、記憶容量、または運用の複雑さを増加させる。提案する比較には、明示したサービス期間にわたるこれらのコストを含める。正確度は、良好な校正の直後ではなく、現実的なドリフトが生じた後に、想定する入力分布の下で評価すべきである。一様量子化ノイズの式は参照モデルにすぎず、クリッピングや相関したコンダクタンス誤差はその前提を破りうる。正確度、エネルギー、レイテンシ、保守オーバーヘッドを、別々の最良条件での実証から寄せ集めるのではなく、同じワークロードの下で同時に測定すれば、システムレベルの主張はより強固になる。
反証を試みることのできるモデル
以下の四つの式は簡潔な解析モデルであり、引用したすべての論文に対する同時フィッティングではない。その解釈は次のとおりである。理想的なクロスバー電流はコンダクタンスで重み付けされた和を実装し、配線抵抗とデバイスの非線形性は偏差を加える。エネルギーの評価境界には、アレイだけでなく変換、通信、制御も含まれる。ベースラインエネルギーの割合fが係数rだけ改善され、他の項が一定なら、これにより全体のエネルギー改善が得られる。一様量子化誤差の分散は、入力が十分に変動し、過負荷がないことを仮定しており、普遍的なデバイスノイズモデルではない。
観測対象は、正確度とレイテンシを揃えた完全なワークロードのエネルギーである。本モデルは、扱いやすい機構を意図的に切り出しており、その目的は、どの測定によってその機構と代替機構を識別できるかを明らかにすることである。図のパラメータ値は、例示用の入力値として明示されている。これらの値から得られる曲線は数学的な帰結であり、未測定の生物学的量や物理量の推定値ではない。
識別力を備えた検証設計
主要な比較では、必要なデータ移動と校正をすべて含めた後のエネルギー上の便益を検証すべきである。独立反復の単位は、独立したチップまたはワークロードの独立した実行である。同一単位からの反復読み取りは精度を高めるが、独立反復を生み出すものではない。強固な検証では、閾値の選択や関心対象外の要因に対する補正のフィッティングに先立ち、新しいネットワークと動作温度を検証用に留保する。特に、変換オーバーヘッド、デバイスのドリフト、低いアレイ利用率は、測定、制約、または感度分析での変動の対象としなければならない。主要推定値と、その仮定を緩めた際の変化の両方を報告する。最も有利な除外規則を選んで初めて成功するモデルは、あらかじめ固定した規則で評価されたモデルとは異なる問いに答えている。
具体例による数値解析
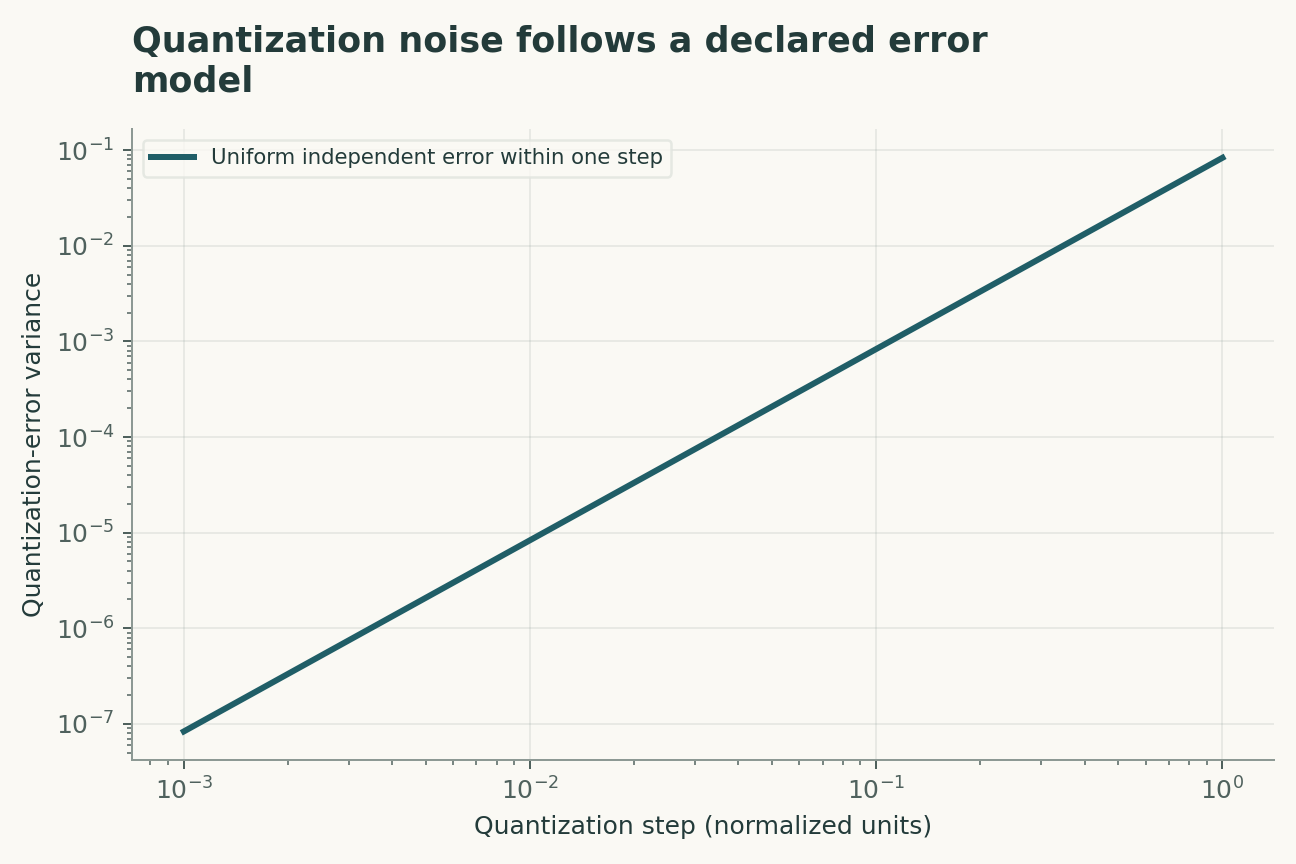
ベースラインエネルギーの80%を占める部分が100倍に高速化され、残りが一定なら、全体の改善は100倍ではなく約4.81倍である。高速化される部分が20%にとどまる場合、同じ局所的利得による改善は約1.247倍となる。図では、高速化される割合と局所的利得を変化させ、続いてステップ幅の縮小に伴って量子化分散がどのように低下するかを示す。これらは収支計算の例であり、商用チップのベンチマークを再現するものではない。
これらの計算は、付属のPythonファイルとそのパラメータ表から再構成できる。軸ラベルはモデルの単位を保持し、キャプションは変化させた量と固定した量を区別している。数値例は依存関係を明らかにするために選定されており、既刊の図の外観を再現するためのものではない。有用な独立検算は、極限の場合を評価したうえで、描画コードを使わずに中間点を再計算することである。一致は明示したモデル内の算術計算を検証するが、自然がそのモデルに従うことを立証するものではない。
証拠、適用範囲の拡張、次の段階
結論の適用範囲は、変換オーバーヘッド、デバイスのドリフト、低いアレイ利用率によって制限される。新しいネットワークと動作温度への適用には、元の観測へのフィッティングを超える証拠が必要である。今後の追試では、生の測定値、校正記録、除外内容、および各結果と対応する解析を結ぶ機械可読なリンクを保存すべきである。以下の証拠表は、選定した各一次研究が何を提供するかを示す。この比較は焦点を絞ったナラティブな統合であり、システマティックレビューでも、その後のすべての証拠を調査したという主張でもない。提案した研究は本稿では実施していない。その価値は、否定的結果が単にベンチマークスコアを下げるだけでなく、明示的な説明に制約を与える点にある。
明示された解析モデル
四つの式と明示的な仮定
(1) 理想的なクロスバー電流はコンダクタンスで重み付けされた和を実装し、配線抵抗とデバイスの非線形性は偏差を加える。
(2) エネルギーの評価境界には、アレイだけでなく変換、通信、制御も含まれる。
(3) ベースラインエネルギーの割合fが係数rだけ改善され、他の項が一定なら、これにより全体のエネルギー改善が得られる。
(4) 一様量子化誤差の分散は、入力が十分に変動し、過負荷がないことを仮定しており、普遍的なデバイスノイズモデルではない。
構成した例 · 再現可能なデータ
定量的な議論を検討する
これらの曲線は明示したモデルから計算されている。引用研究の観測結果ではない。すべての図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるか
| 証拠または設計上の選択 | 明らかにすること | 未解決の事項 |
|---|---|---|
| 資料1 | 抵抗性クロスポイントの解析により、学習のための設計要件が特定された。 | 設計研究は、運用されたシステム全体のエネルギー測定ではない。 |
| 資料2 | アナログメモリ学習は、選定されたワークロードでの正確度を実証した。 | 正確度と効率は、アルゴリズムとハードウェアの条件に依存する。 |
| 資料3 | 集積ミックスドシグナルチップがニューラル推論を実証した。 | チップの評価境界、マッピング、変換のコストは比較に影響する。 |
| 主要観測量 | 正確度とレイテンシを揃えた完全なワークロードのエネルギー | 変換オーバーヘッド、デバイスのドリフト、低いアレイ利用率 |
| 独立検証 | 必要なデータ移動と校正をすべて含めた後のエネルギー上の便益 | 新たな測定が必要 |
| 適用拡張の検証集合 | 新しいネットワークと動作温度 | 構成した数値例によっては検証されていない |
提案する検証プロトコル
これは提案段階の評価設計である。本稿のために新たな生物学的実験、臨床試験、物理実験を実施してはいない。
- フィッティングの前に、正確度とレイテンシを揃えた完全なワークロードのエネルギーを規定する。
- 独立した各チップまたはワークロードの独立した各実行について、個別の識別子を保持する。
- 新しいネットワークと動作温度をモデル開発から分離する。
- 変換オーバーヘッド、デバイスのドリフト、低いアレイ利用率を測定するか、その範囲を定める。
- 単位、校正、観測演算子を記録する。
- 主要モデルを、明示的に名付けた競合説明と比較する。
- 必要なデータ移動と校正をすべて含めた後のエネルギー上の便益という検証項目を、事前に規定する。
- 生データ、除外内容、パラメータファイル、実行可能な解析を保存する。
一次資料が確立すること
Tayfun Gokmen, Yurii Vlasov · 2016 [1]
貢献。 抵抗性クロスポイントの解析により、学習のための設計要件が特定された。
適用の限界。 設計研究は、運用されたシステム全体のエネルギー測定ではない。
資料内の該当箇所。 要旨/一次資料の選定箇所。リンク先の書誌情報を参照。
Stefano Ambrogio, Pritish Narayanan, Hsinyu Tsai et al. · 2018 [2]
貢献。 アナログメモリ学習は、選定されたワークロードでの正確度を実証した。
適用の限界。 正確度と効率は、アルゴリズムとハードウェアの条件に依存する。
資料内の該当箇所。 要旨/一次資料の選定箇所。リンク先の書誌情報を参照。
Manuel Le Gallo, Riduan Khaddam-Aljameh, Milos Stanisavljevic et al. · 2023 [3]
貢献。 集積ミックスドシグナルチップがニューラル推論を実証した。
適用の限界。 チップの評価境界、マッピング、変換のコストは比較に影響する。
資料内の該当箇所。 要旨/一次資料の選定箇所。リンク先の書誌情報を参照。
本解析の限界
- 設計研究は、運用されたシステム全体のエネルギー測定ではない。
- 正確度と効率は、アルゴリズムとハードウェアの条件に依存する。
- チップの評価境界、マッピング、変換のコストは比較に影響する。
- 付属の図は構成した解析例であり、新たな実験結果ではない。
- 本総説は、新しいネットワークと動作温度への適用を実証していない。
明示した一次研究を対象とする、焦点を絞ったナラティブ分析であり、系統的な文献検索でも、2026年までの網羅的な調査を主張するものでもない。
結論を変えうる問い
- 想定するモデルの次元では、どのオーバーヘッドが支配的になるか。
- 時間と温度の変化に対して、どれだけの校正エネルギーが必要か。
- どのような精度配分が、ワークロード全体のエネルギーを最小にしながら正確度を維持するか。
参考文献
- Tayfun Gokmen, Yurii Vlasov. Acceleration of Deep Neural Network Training with Resistive Cross-Point Devices: Design Considerations. Frontiers in Neuroscience (2016). 10.3389/fnins.2016.00333.
- Stefano Ambrogio, Pritish Narayanan, Hsinyu Tsai et al.. Equivalent-accuracy accelerated neural-network training using analogue memory. Nature (2018). 10.1038/s41586-018-0180-5.
- Manuel Le Gallo, Riduan Khaddam-Aljameh, Milos Stanisavljevic et al.. A 64-core mixed-signal in-memory compute chip based on phase-change memory for deep neural network inference. Nature Electronics (2023). 10.1038/s41928-023-01010-1.
書誌的同一性はCrossrefと照合した。解釈にはアクセス可能な一次記録、要旨、選定した本文を用いており、全文と補足手法の調査は網羅的ではない。
著者と来歴
資料に基づく研究総説と独自の数学的解析は、Codex(AI)が執筆した。引用した実験は、引用先の研究チームによるものである。
概念的な表紙は内蔵ImageGenツールで作成した。定量図は、コードと数値データを伴う、明示的に構成した解析であり、引用論文の測定値ではない。
このローカル草稿には、独立した査読または学術誌への採択の記録はない。