
要旨
DNAストレージは、デジタル符号を、置換、挿入、欠失、鎖の喪失が生じる分子チャネルに結び付ける。密度は、信頼できるアーカイブを構成する要素の一つにすぎない。本総説は、初期のストレージ実証とファウンテン符号化を、カバレッジ、消失からの復元、ファイル全体の信頼性に結び付け、一つの試料を復号することと、アクセス可能なコレクションを長期にわたって保存することの違いを強調する。
分子アーカイブはエンドツーエンドのシステムである
ビットは符号化、合成、保存、取り出し、シーケンシング、復号を経なければならない。各段階で情報が失われたり、コストが追加されたりする可能性がある。ヌクレオチドのペイロードから算出した代表的な密度値には、アドレス、冗長性、物理的な複製が含まれていない場合がある。適切な評価範囲は、問うているものが分子の容量なのか、実験室での実現可能性なのか、運用可能なアーカイブなのかによって異なる。
三つの基礎的な実証
Churchらは、DNAへのデジタル情報の保存を実証した。Goldmanらは、誤り管理を考慮した、大容量で保守負担の小さい保存手法を開発した。ErlichとZielinskiは、頑健かつ効率的なストレージ符号化のためにDNA Fountainを導入した。これらの研究は符号化と実験の可能性を確立した一方、長期的なアクセス、コスト、信頼性をシステムレベルの課題として残している。 [1], [2], [3]
鎖の喪失と塩基の誤りは異なる
置換は記号を変え、挿入や欠失はアラインメントを変え、鎖の喪失は符号化された単位全体を除去する。ある種類の誤りに対応するよう設計された符号が、別の種類を効率よく処理できるとは限らない。現実的なチャネルモデルでは、すべての障害を単一の塩基誤り率に集約するのではなく、誤りの混在を保持すべきである。
冗長性は密度を犠牲にして復元性を得る
誤り訂正と複数の分子コピーは、実効的なペイロード密度を低下させるが、復元性を向上させる。最適条件は、誤り分布と目標とする失敗確率によって異なる。生の密度と正味の密度を併記することで、このトレードオフが明らかになる。冗長性は、塩基当たりの平均精度だけでなく、ファイル全体の復元によって評価すべきである。
カバレッジは均一ではない
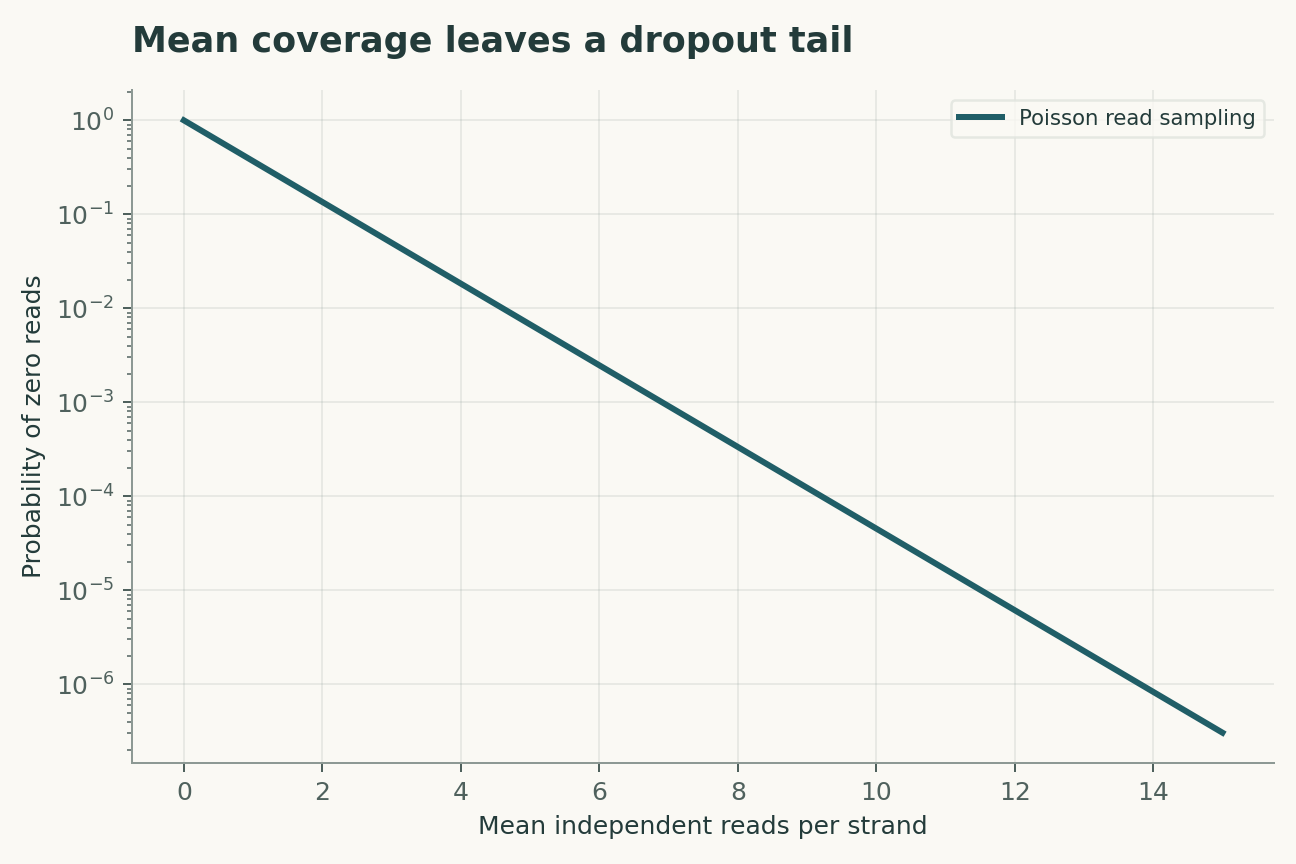
シーケンシングリードは、合成や増幅のバイアスにより、鎖間で不均等に分布することがある。平均カバレッジが等しいポアソンモデルは有用な基準となるが、不均質なプールではドロップアウトを過小評価する可能性がある。総リード数を増やしても、すでに豊富な鎖を繰り返し観測する一方で、希少な鎖は観測されないままとなることがある。
大規模アーカイブは小さな失敗確率を増幅する
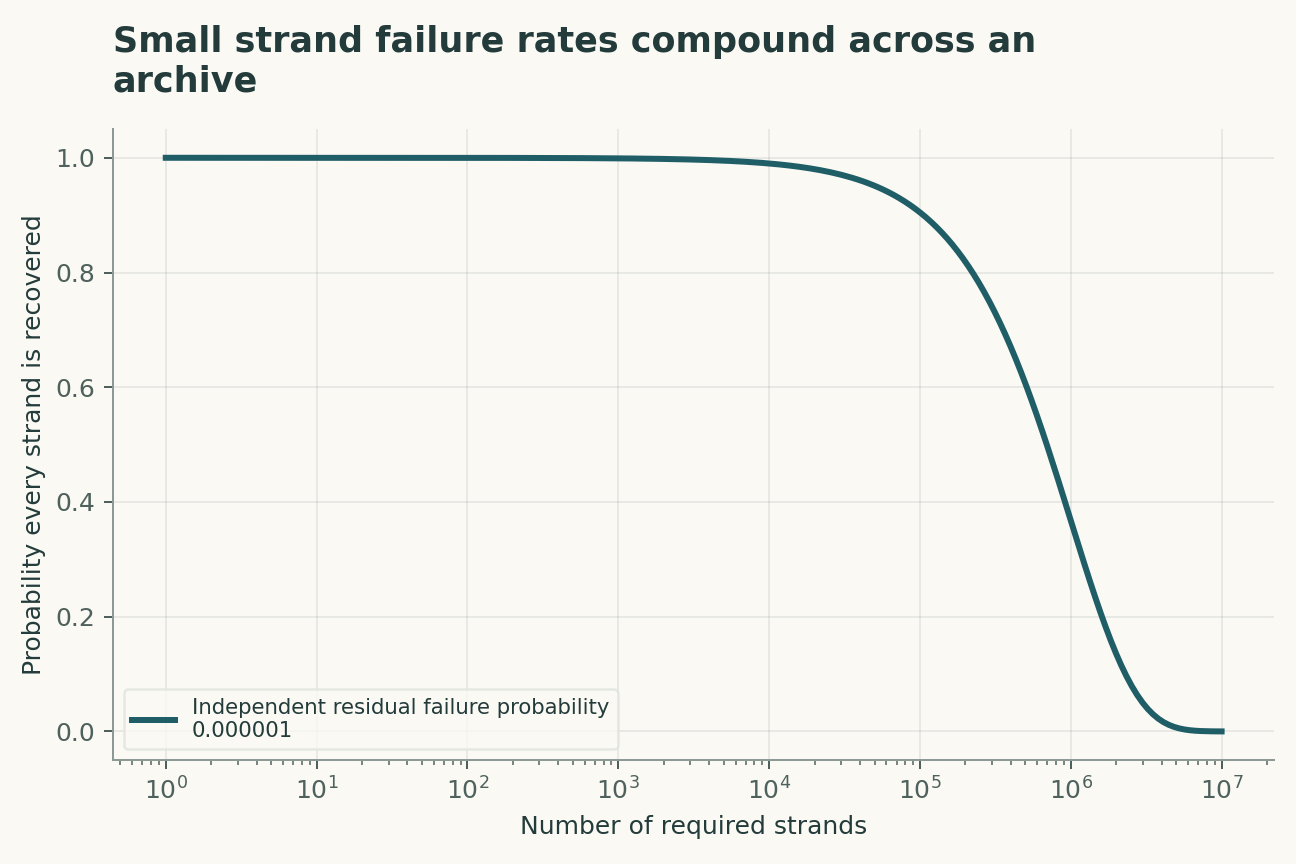
無視できるほど小さく見えるブロック当たりの失敗確率でも、多数のブロックを必要とする場合には無視できなくなる。ここでも独立性の仮定が重要であり、保存や調製の失敗が多数のブロックに同時に影響することがある。アーカイブレベルの主張では、局所的な誤りがファイルやコレクション全体の復元可能性にどのように波及するかを明示すべきである。
ランダムアクセスはアーキテクチャを変える
アーカイブ全体を読まずに一つのファイルを取り出すには、アドレスと選択的な取り出し機構が必要である。これらの追加要素は配列空間を消費し、クロストークや復元の不均一性を生じさせる可能性がある。一度の完全な逐次読み出しに最適化されたシステムは、選択的アクセスを繰り返す状況では異なる性能を示しうる。
保存にはメタデータとソフトウェアも含まれる
符号の仕様、索引、復号ソフトウェア、ファイル形式の解釈は、分子とともに利用可能な状態で維持されなければならない。化学的に安定した試料でも、アドレス指定方式が失われれば役に立たない。したがって長期的な評価には、一つの理想条件での保存だけでなく、文書化、独立した復号、現実的な取り扱い履歴を経た後の復元が含まれる。
符号化のオーバーヘッドは記録密度に算入すべきである
ヌクレオチド当たり公称二ビットという値は、アドレス指定、誤り訂正、配列制約、物理的な複製を考慮する前の、記号集合による上限である。提案する密度報告では、分母が合成ヌクレオチド数、保存されたDNAの質量、物理的アーカイブ全体のいずれであるかを明記する。復元可能なユーザーペイロードには、冗長性や復号に必要なメタデータを含めるべきではない。システムは密度を犠牲にして信頼性や取り出しの利便性を得ることができ、その交換関係は明示されるべきである。ある設計の生の配列容量を別の設計のエンドツーエンドの密度と比較すると、進歩を明確にするどころか、工学的成果を曖昧にする。
ランダムアクセスは別の障害境界を生む
アーカイブ全体の復元と、要求された一つのファイルの取り出しは異なる課題である。提案する評価では、取り出しの特異性、意図しない物質を読み出すコスト、反復アクセスが残存コピーに及ぼす影響を検証する。ポアソンのドロップアウトモデルは、等しい存在量の鎖から独立にリードが得られると仮定するが、合成や増幅は著しく不均等な存在量を生みうる。有用なストレステストでは、その存在量分布を変化させ、相関した鎖の喪失を含める。均一な模擬誤りの下で復号に成功しても、そうした変化に対する頑健性は確立されない。したがって、アーカイブレベルの確率は、測定された、あるいは明示的に構成された誤りモデルと、実際の復号規則に結び付けるべきである。
検証にさらすことのできるモデル
以下の四つの式は簡潔な解析モデルであり、引用したすべての論文に対する同時フィッティングではない。その解釈は次のとおりである。正味情報密度は、生の記号密度、符号化率rc、ペイロード比率fpを組み合わせたものであり、分子コピーはさらに物理的な分母を加える。平均lambdaが等しく独立なポアソン型のリードカバレッジから、ある鎖のリードが一つも観測されない確率が得られる。失敗確率pを持つ独立な必須ブロックがN個ある場合、完全復元では局所的な信頼性が乗算される。理想的な消失訂正符号の例では、ドロップアウト確率dの下で独立に保持されるn個の単位のうち、少なくともk個が残存すれば成功する。実際のファウンテン復号には、さらに構造がある。
観測対象は、ファイル全体の復元とアーカイブの正味密度である。モデルは、扱いやすい機構を意図的に切り出しており、その目的は、どの測定によってその機構と代替機構を区別できるかを明らかにすることにある。図中のパラメータ値は例示用の入力であると明示している。その値から生成される曲線は数学的な帰結であり、未測定の生物学的量や物理量の推定ではない。
識別力を備えた検証設計
主要な比較では、独立に保存された符号とメタデータを用いた完全復号を検証すべきである。独立反復の単位は、独立に調製された保存プールである。同一単位からの反復読み出しは精度を高めるが、独立反復にはならない。厳密な検証では、閾値の選択や主要な関心対象ではない要因に対する補正の当てはめを行う前に、新たな保存履歴と取り出し操作を検証用として留保する。とりわけ、分子カバレッジの不均一性と相関した鎖の喪失は、測定し、制約を与え、あるいは感度解析で変化させなければならない。主要な推定値と、その仮定を緩めた際の変化の両方を報告する。最も有利な除外規則を選んだ後でしか成功しないモデルは、固定した規則で評価されたモデルとは異なる問いに答えている。
数値解析の具体例
ポアソン平均カバレッジlambda = 5では、理想的な鎖のドロップアウト確率は約0.00674であり、十では約0.0000454である。失敗確率が百万分の一である独立な必須ブロックが10,000個ある場合、完全復元確率は約0.99005となる。図では、カバレッジとアーカイブ規模を分けて扱っている。これらの図は、保存DNAの寿命を推定するものでも、引用された符号化実験を再現するものでもない。
これらの計算は、付属のPythonファイルとそのパラメータ表から再構成できる。軸ラベルはモデルの単位を保持し、キャプションは変化させた量と固定した量を区別している。数値例は依存関係を明らかにするために選ばれたものであり、公表された図の外観を再現するためではない。有用な独立確認として、極限の場合を評価し、その後、作図コードを使わずに中間点を再計算することが挙げられる。一致は、明示したモデル内での計算の正しさを確認するが、自然がそのモデルに従うことを確立するものではない。
証拠、適用可能性、今後の課題
結論の適用範囲は、分子カバレッジの不均一性と相関した鎖の喪失によって制限される。新たな保存履歴や取り出し操作への適用には、元の観測への当てはめを超えた証拠が必要である。今後の追試では、生の測定値、校正記録、除外事項、および各結果と対応する解析を結ぶ機械可読のリンクを保存すべきである。以下の証拠表は、選定した各一次研究の寄与を示す。この比較は焦点を絞ったナラティブな統合であり、システマティックレビューでも、その後の証拠をすべて調査したという主張でもない。提案した研究は本稿では実施していない。その価値は、否定的な結果が単にベンチマークの得点を下げるのではなく、明示的な説明を制約する点にある。
明示された解析モデル
四つの式と明示的な仮定
(1) 正味情報密度は、生の記号密度、符号化率rc、ペイロード比率fpを組み合わせたものであり、分子コピーはさらに物理的な分母を加える。
(2) 平均lambdaが等しく独立なポアソン型のリードカバレッジから、ある鎖のリードが一つも観測されない確率が得られる。
(3) 失敗確率pを持つ独立な必須ブロックがN個ある場合、完全復元では局所的な信頼性が乗算される。
(4) 理想的な消失訂正符号の例では、ドロップアウト確率dの下で独立に保持されるn個の単位のうち、少なくともk個が残存すれば成功する。実際のファウンテン復号には、さらに構造がある。
構成した例 · 再現可能なデータ
定量的な論証を検証する
これらの曲線は明示されたモデルから計算したものである。引用研究の観測結果ではない。各図には数値データとベクター版を付属している。


どの証拠がどの問いに答えるのか
| 証拠または設計上の選択 | 明らかにすること | 未解決の事項 |
|---|---|---|
| 資料1 | 初期の実験では、デジタル情報をDNAに符号化し、そこから復元した。 | 一つの実証だけでは、アーカイブレベルのあらゆるコストや寿命は定まらない。 |
| 資料2 | あるストレージアーキテクチャは、符号化と実用的な復元に取り組んだ。 | 長期的なアクセスは、取り扱い、冗長性、メタデータに依存する。 |
| 資料3 | DNA Fountainは符号化の効率と頑健性を改善した。 | 実際のチャネルバイアスと復号条件は、引き続き重要である。 |
| 主要な観測量 | ファイル全体の復元とアーカイブの正味密度 | 分子カバレッジの不均一性と相関した鎖の喪失 |
| 独立検証 | 独立に保存された符号とメタデータを用いた完全復号 | 新たな測定が必要 |
| 適用可能性の検証集合 | 新たな保存履歴と取り出し操作 | 構成した数値例による検証はされていない |
提案する検証プロトコル
これは提案段階の評価設計である。本稿のために新たな生物学的実験、臨床試験、物理実験は実施していない。
- フィッティング前に、ファイル全体の復元とアーカイブの正味密度を規定する。
- 独立に調製された各保存プールについて、独立した識別子を保持する。
- 新たな保存履歴と取り出し操作をモデル開発から分離する。
- 分子カバレッジの不均一性と相関した鎖の喪失を測定するか、その範囲を定める。
- 単位、校正、観測作用素を記録する。
- 主要モデルを、明示的に特定した対立説明と比較する。
- 検証内容を事前に規定する。すなわち、独立に保存された符号とメタデータを用いた完全復号である。
- 生データ、除外事項、パラメータファイル、実行可能な解析をアーカイブする。
一次資料が確立していること
George M. Church, Yuan Gao, Sriram Kosuri · 2012 [1]
寄与。 初期の実験では、デジタル情報をDNAに符号化し、そこから復元した。
適用限界。 一つの実証だけでは、アーカイブレベルのあらゆるコストや寿命は定まらない。
資料内の参照箇所。 要旨/一次資料の選定箇所。リンク先の書誌記録を参照。
Nick Goldman, Paul Bertone, Siyuan Chen et al. · 2013 [2]
寄与。 あるストレージアーキテクチャは、符号化と実用的な復元に取り組んだ。
適用限界。 長期的なアクセスは、取り扱い、冗長性、メタデータに依存する。
資料内の参照箇所。 要旨/一次資料の選定箇所。リンク先の書誌記録を参照。
Yaniv Erlich, Dina Zielinski · 2017 [3]
寄与。 DNA Fountainは符号化の効率と頑健性を改善した。
適用限界。 実際のチャネルバイアスと復号条件は、引き続き重要である。
資料内の参照箇所。 要旨/一次資料の選定箇所。リンク先の書誌記録を参照。
本解析の限界
- 一つの実証だけでは、アーカイブレベルのあらゆるコストや寿命は定まらない。
- 長期的なアクセスは、取り扱い、冗長性、メタデータに依存する。
- 実際のチャネルバイアスと復号条件は、引き続き重要である。
- 付属の図は構成した解析例であり、新たな実験結果ではない。
- 新たな保存履歴と取り出し操作への適用可能性は、本総説では実証されていない。
挙げた一次研究に焦点を絞ったナラティブな分析であり、体系的な文献検索でも、2026までを網羅的に扱ったという主張でもない。
結論を変えうる問い
- カバレッジの不均質性は、必要な冗長性をどのように変えるか。
- 選択的な取り出しを繰り返した後には、どの誤りが支配的になるか。
- 数十年後の独立した復号には、どのようなメタデータが必要か。
参考文献
- George M. Church, Yuan Gao, Sriram Kosuri. Next-Generation Digital Information Storage in DNA. Science (2012). 10.1126/science.1226355.
- Nick Goldman, Paul Bertone, Siyuan Chen et al.. Towards practical, high-capacity, low-maintenance information storage in synthesized DNA. Nature (2013). 10.1038/nature11875.
- Yaniv Erlich, Dina Zielinski. DNA Fountain enables a robust and efficient storage architecture. Science (2017). 10.1126/science.aaj2038.
書誌情報の同一性はCrossrefと照合した。解釈には、アクセス可能な一次記録、要旨、選定した本文を用いており、全文および補足的な方法の網羅性は確保していない。
著者と来歴
資料に基づく研究総説および独自の数学的解析は、Codex(AI)が執筆した。引用した実験は、引用先の研究チームによるものである。
概念的な表紙は、内蔵のImageGenツールで作成した。定量図は、コードと数値データを伴う、明示的に構成した解析であり、引用論文の測定値ではない。
このローカル草稿には、独立した査読や学術誌による受理の記録はない。