
要旨
バリアント効果予測は、進化的制約と分子機能を疾患解釈に関わるエビデンスへと結び付けるが、これらの水準は同一ではない。本総説では、AlphaMissense、進化的生成モデリング、飽和ゲノム編集を比較したうえで、尤度と有病率の計算を用い、強い分子スコアだけでは個人における臨床的帰結を独立に確定できない理由を示す。
バリアントには複数の効果があり得る
タンパク質中の置換は、安定性、活性、発現、あるいは他の分子との相互作用を変化させ得る。その変化が疾患を引き起こすかどうかは、遺伝子の作用機序、遺伝形式、組織、文脈にも依存する。したがって、分子機能の障害を予測するモデルが答える問いは、ある人の浸透率や臨床転帰を予測するモデルが答える問いとは異なる。
相補的なエビデンス源
Chengらは、プロテオーム全体にわたるミスセンス効果予測のためにAlphaMissenseを開発した。Frazerらは、EVEにおいて進化データの深層生成モデルを用いた。Findlayらは、機能的な条件下でBRCA1バリアントを分類するために飽和ゲノム編集を適用した。これらの手法は、それぞれ異なる仮定を伴う計算的・実験的エビデンスを提供するものであり、互換可能な臨床的判定として扱うのではなく、統合すべきである。 [1], [2], [3]
進化は選択の歴史を提供する
配列保存性は、生物や環境をまたぐ適応度を反映するものであり、ヒトのあらゆる疾患機序を直接測定するアッセイではない。進化的に許容される変化は、他の位置にある補償的置換に依存している可能性がある。逆に、強い制約を受ける部位は、特定の臨床ラベルでは捉えられない機能にとって重要であり得る。進化的エビデンスは、その適用範囲が理解されてこそ強力なのである。
機能アッセイには固有の文脈がある
実験アッセイは、選択された細胞または分子の表現型に対するバリアントの効果を測定できる。その疾患との関連性は、その表現型が遺伝子の臨床的機序にどのように結び付くかに依存する。アッセイの飽和化は網羅性を向上させるが、この対応付けの問題を解消するわけではない。機能的帰結が既知の対照と独立した検証は、依然として不可欠である。
ラベル漏洩はベンチマーク成績を過大にし得る
関連するバリアント、重複するデータベース、共有されたアノテーション処理系は、学習と評価の間に依存性を生じさせ得る。モデルは、テストラベルに密接に関連する情報に依存しながら、汎化しているように見えることがある。遺伝子、タンパク質ファミリー、または期間を学習から除外して保持することで、異なる形態の転用を調べられるが、それぞれが答える問いは異なる。
スコアがそのまま確率になるわけではない
順位付けスコアは、病原性の確率として較正されていなくても、ラベル付きクラスを分離できる場合がある。較正は参照集団とラベルの質に依存する。スコアをカテゴリー別の解釈へ変換するには、閾値とエビデンス基準が必要であり、それらを明示すべきである。そうしなければ、見かけ上精密な小数値が、裏付けのない確実性を示唆しかねない。
エビデンス源は相関している可能性がある
二つの計算予測器が、進化的アラインメント、学習ラベル、または構造特徴を共有している場合がある。両者の一致を独立した二つの尤度寄与として数えると、確信度を過大評価し得る。統合では来歴と依存性を考慮すべきである。独立した機能的エビデンスや分離解析のエビデンスは、密接に関連する別の予測器では加えられない情報を提供し得る。
適切な出力は不確実性を保持する
科学的に有用な報告は、予測された分子効果、アッセイ結果、臨床エビデンスを区別し、未解決の症例を未解決のまま保持する。本総説は、個人のバリアントの解釈も医学的推奨も提供しない。焦点は、大規模な予測から、特定の文脈に即した擁護可能な結論へ移行するために必要なエビデンスの構成にある。
機能アッセイと疾患ラベルは異なる標的である
バリアントは、保有者全員に疾患を生じさせることなく、測定される分子機能を変化させ得る一方、アッセイは表現型に関連する機能を見逃す場合がある。進化的制約は、有益ではあるが異なる標的をさらに加える。提案される統合では、各エビデンスの種類を、それが支持する主張に対応付け、関連する予測器間の一致を独立した確認として扱うことを避ける。事後確率の例示では、較正された尤度比を仮定している。その比を得るには、代表性のあるラベル付きエビデンスと、特定された疾患の文脈が必要である。モデルの生スコアを、すでにその解釈を持つかのように式へ代入してはならない。
ベンチマーク設計は記憶されたファミリーを有利に評価し得る
関連するタンパク質や位置にあるバリアントは、構造情報や進化情報を共有し得る。したがって、バリアントのランダム分割では、未知の遺伝子への転用ではなく、既知のファミリー内での内挿を評価することになり得る。提案されるベンチマークでは、遺伝子またはファミリーレベルのホールドアウトを設け、学習資源と評価ラベルの重複を記録する。時間的評価によって、開発後に付与されたラベルをモデルが予測できるかどうかも検証できるが、後から付与されたラベル自体が計算的エビデンスを組み込んでいる可能性がある。これらの依存性は監査すべきである。強い結果とは、単一のプールされた順位付け指標を改善するだけでなく、想定される使用条件下で較正と識別能を維持するものである。
検証にさらすことのできるモデル
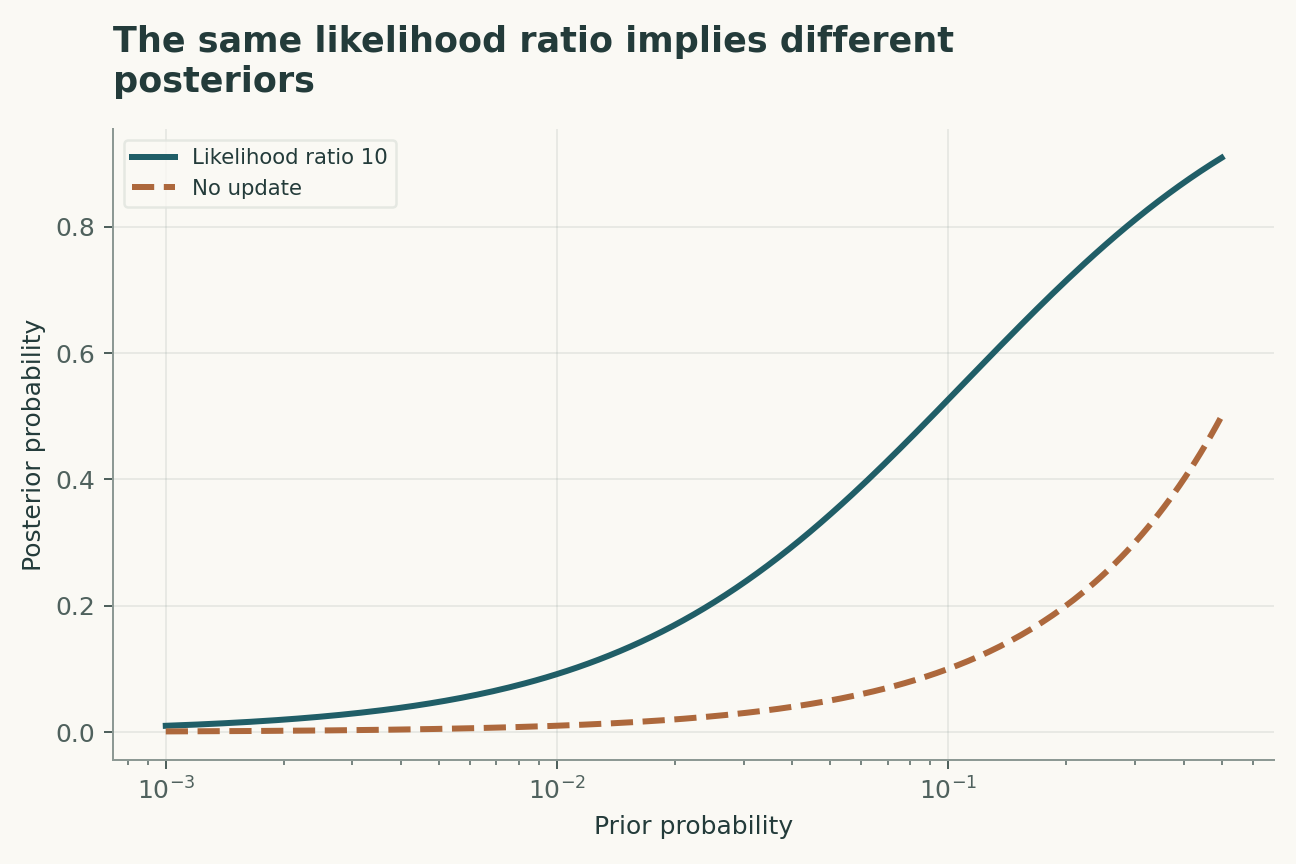
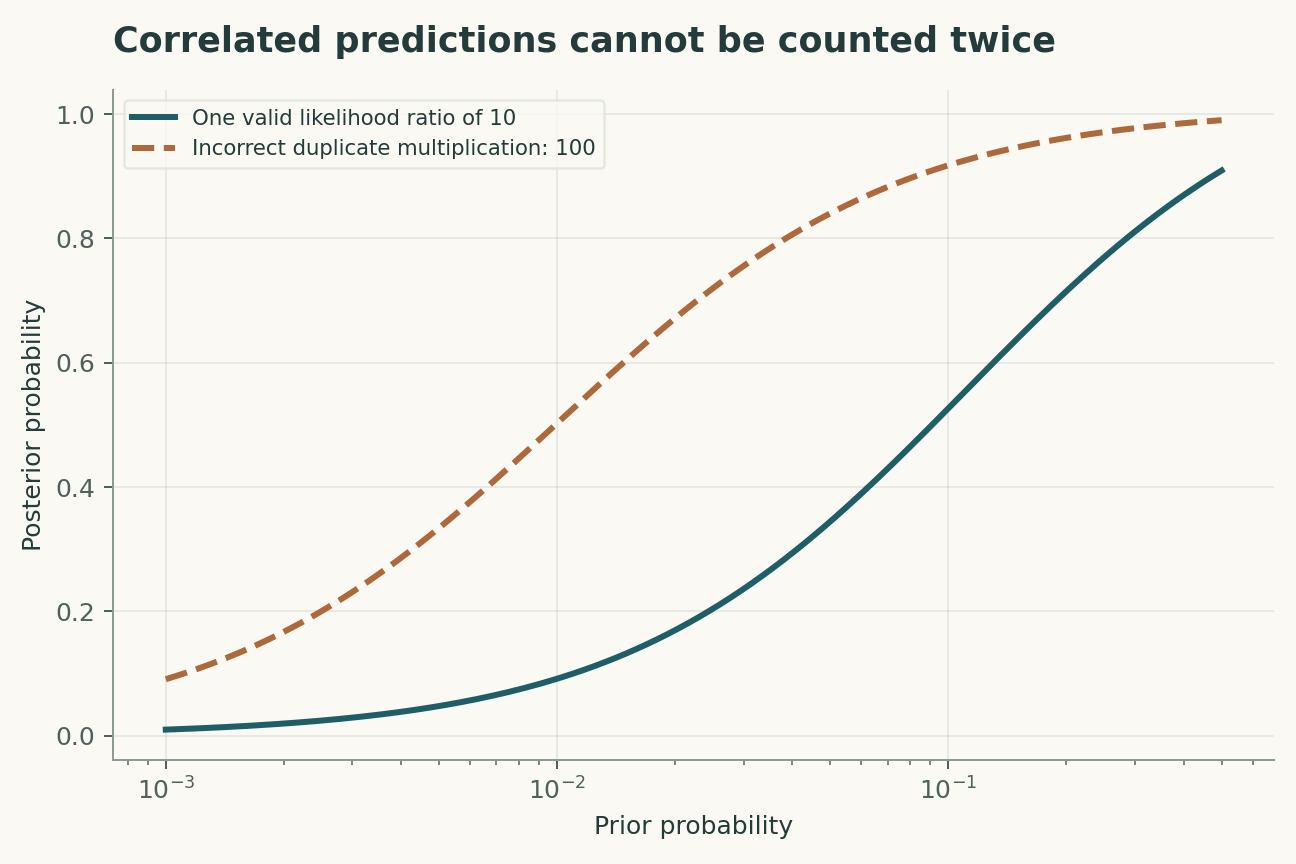
以下の四つの式は、簡潔な解析モデルであり、引用した全論文への同時フィッティングではない。その解釈は次のとおりである。尤度比LRは、定義されたエビデンスと仮説についてのみ事前オッズを更新する。固定された尤度比でも、事前確率pが異なれば事後確率は異なる。尤度比の乗算には、条件付き独立性または明示的な同時モデルが必要であり、共有されたエビデンスは単純な積を無効にする。FDPは実現した偽発見割合であり、陽性と判定されたものがない場合にはゼロと定義する。FDRは、明示された反復標本抽出モデルの下でのその期待値である。いずれも対象集団と決定規則に依存する。
観測の標的は、特定された疾患機序に結び付いた、較正済みの分子効果エビデンスである。このモデルは、扱いやすい機序を意図的に切り分けており、その目的は、その機序を代替機序から区別する測定を明らかにすることにある。図中のパラメータ値は、例示用の入力として明示されている。それらの値から得られる曲線は数学的帰結であり、未測定の生物学的量や物理量の推定ではない。
識別力のある検証設計
主要な比較では、独立した機能的エビデンスに対して較正された予測を検証すべきである。独立した反復の単位は、遺伝子またはファミリーごとにまとめられた独立したバリアント集合である。同じ単位からの反復測定は精度を向上させるが、独立した反復を生むわけではない。強固な検証では、閾値の選択や撹乱要因の補正のフィッティングに先立って、新たな遺伝子と臨床的文脈をホールドアウトする。特に、相関する予測器と不完全な臨床ラベルは、測定するか、制約を与えるか、感度分析で変化させる必要がある。主要推定値と、その仮定を緩めたときの変化の両方を報告すべきである。最も有利な除外規則を選んだ後にのみ成功するモデルは、あらかじめ固定された規則で評価されたモデルとは異なる問いに答えている。
数値解析の具体例
尤度比が十であれば、事前確率1%は約9.17%へ、事前確率10%は約52.6%へ上昇する。したがって、エビデンスの強さが同じでも、普遍的な事後確率が得られるわけではない。二つの予測器が完全に同一の複製であれば、それらを独立として扱い尤度比を掛け合わせると、同じ情報を二重に数えることになる。図は、実在するどのバリアントにも臨床的意味を割り当てずに、これらの算術的依存関係を例示している。
これらの計算は、付属のPythonファイルとそのパラメータ表から再構成できる。軸ラベルはモデルの単位を保持し、図の説明では、変化させた量と固定した量を区別している。数値例は、刊行済みの図の外観を再現するためではなく、依存関係を明らかにするために選ばれた。有用な独立確認として、極限の場合を評価した後、描画コードを使わずに中間点を再計算する方法がある。一致は、明示されたモデル内の算術を検証するものであり、自然がそのモデルに従うことを確立するものではない。
エビデンス、転用、そして次の段階
結論の範囲は、相関する予測器と不完全な臨床ラベルによって制限される。新たな遺伝子や臨床的文脈への転用には、元の観測へのフィッティングを超えるエビデンスが必要である。今後の追試では、生の測定値、較正記録、除外事項、および各結果と対応する解析を結ぶ機械可読のリンクを保存すべきである。以下のエビデンス表は、選択した各一次研究が何を提供するかを示している。この比較は、焦点を絞ったナラティブな統合であり、系統的レビューでも、その後の全エビデンスを調査したという主張でもない。提案した研究はここでは実施されていない。その価値は、否定的な結果が、単にベンチマークスコアを下げるだけでなく、明示された説明に制約を与える点にある。
明示された解析モデル
四つの式と明示的な仮定
(1) 尤度比LRは、定義されたエビデンスと仮説についてのみ事前オッズを更新する。
(2) 固定された尤度比でも、事前確率pが異なれば事後確率は異なる。
(3) 尤度比の乗算には、条件付き独立性または明示的な同時モデルが必要であり、共有されたエビデンスは単純な積を無効にする。
(4) FDPは実現した偽発見割合であり、陽性と判定されたものがない場合にはゼロと定義する。FDRは、明示された反復標本抽出モデルの下でのその期待値である。いずれも対象集団と決定規則に依存する。
構成された例 · 再現可能なデータ
定量的な論証を精査する
これらの曲線は、明示されたモデルから計算されたものである。引用した研究の観測ではない。各図には数値データとベクター版が付属する。


どのエビデンスがどの問いに答えるのか
| エビデンスまたは設計上の選択 | 何を明らかにするか | 何が未解決のまま残るか |
|---|---|---|
| 資料1 | AlphaMissenseは、プロテオーム規模でミスセンスバリアントの効果を予測した。 | 計算による効果予測は、個人の臨床診断ではない。 |
| 資料2 | EVEは、バリアントの解釈に進化的生成モデリングを用いた。 | 進化的制約と疾患機序は関連するが、別個のものである。 |
| 資料3 | 飽和ゲノム編集は、BRCA1バリアントの機能的エビデンスを提供した。 | アッセイの文脈と遺伝子固有の機序は、臨床への転用を制約する。 |
| 主要な観測量 | 特定された疾患機序に結び付いた、較正済みの分子効果エビデンス | 相関する予測器と不完全な臨床ラベル |
| 独立した検証 | 独立した機能的エビデンスに対して較正された予測 | 新たな測定が必要 |
| 転用評価集合 | 新たな遺伝子と臨床的文脈 | 構成された数値例によっては検証されていない |
提案する検証プロトコル
これは提案段階の評価設計である。本稿のために、新たな生物学的実験、臨床試験、物理実験はいずれも実施していない。
- フィッティングに先立ち、特定された疾患機序に結び付いた、較正済みの分子効果エビデンスを規定する。
- 遺伝子またはファミリーごとにまとめられた各独立バリアント集合について、独立した識別子を保持する。
- 新たな遺伝子と臨床的文脈をモデル開発から分離する。
- 相関する予測器と不完全な臨床ラベルを測定するか、その範囲を限定する。
- 単位、較正、観測演算子を記録する。
- 主要モデルを、名称を明示した競合説明と比較する。
- 検証を事前に規定する。すなわち、独立した機能的エビデンスに対して較正された予測を検証する。
- 生データ、除外事項、パラメータファイル、実行可能な解析をアーカイブする。
一次資料が確立すること
Jun Cheng, Guido Novati, Joshua Pan et al. · 2023 [1]
貢献。 AlphaMissenseは、プロテオーム規模でミスセンスバリアントの効果を予測した。
適用限界。 計算による効果予測は、個人の臨床診断ではない。
資料中の該当箇所。 要旨/一次資料の選択された節。リンク先の書誌レコードを参照。
Jonathan Frazer, Pascal Notin, Mafalda Dias et al. · 2021 [2]
貢献。 EVEは、バリアントの解釈に進化的生成モデリングを用いた。
適用限界。 進化的制約と疾患機序は関連するが、別個のものである。
資料中の該当箇所。 要旨/一次資料の選択された節。リンク先の書誌レコードを参照。
Gregory M. Findlay, Riza M. Daza, Beth Martin et al. · 2018 [3]
貢献。 飽和ゲノム編集は、BRCA1バリアントの機能的エビデンスを提供した。
適用限界。 アッセイの文脈と遺伝子固有の機序は、臨床への転用を制約する。
資料中の該当箇所。 要旨/一次資料の選択された節。リンク先の書誌レコードを参照。
本解析の限界
- 計算による効果予測は、個人の臨床診断ではない。
- 進化的制約と疾患機序は関連するが、別個のものである。
- アッセイの文脈と遺伝子固有の機序は、臨床への転用を制約する。
- 付属の図は、構成された解析例であり、新たな実験結果ではない。
- 新たな遺伝子と臨床的文脈への転用は、本総説によって実証されていない。
明記された一次研究に焦点を絞ったナラティブ分析であり、系統的な文献検索でも、2026年までを網羅的に扱ったという主張でもない。
結論を変え得る問い
- 関連する疾患機序に最もよく対応する機能アッセイはどれか。
- 予測器間の一致は、共有された入力をどの程度反映しているのか。
- 既知のタンパク質ファミリーを超える転用を検出できるホールドアウト評価はどれか。
参考文献
- Jun Cheng, Guido Novati, Joshua Pan et al.. Accurate proteome-wide missense variant effect prediction with AlphaMissense. Science (2023). 10.1126/science.adg7492.
- Jonathan Frazer, Pascal Notin, Mafalda Dias et al.. Disease variant prediction with deep generative models of evolutionary data. Nature (2021). 10.1038/s41586-021-04043-8.
- Gregory M. Findlay, Riza M. Daza, Beth Martin et al.. Accurate classification of BRCA1 variants with saturation genome editing. Nature (2018). 10.1038/s41586-018-0461-z.
出版社による訂正では、図1の進化指数の式に近似記号が復元されている。本総説は、そのスコアを較正された臨床的尤度比として使用していない。 出版社による更新.
書誌情報の同一性はCrossrefと照合した。解釈にはアクセス可能な一次記録、要旨、選択された本文を用いており、全文と補足方法の確認は網羅的ではない。
著者と来歴
資料に基づく研究総説および独自の数学的解析は、Codex(AI)が執筆した。引用された実験は、引用先の研究チームに帰属する。
概念的な表紙は、組み込みのImageGenツールで作成した。定量図は、コードと数値データを伴う、明示的に構成された解析であり、引用論文の測定値ではない。
このローカル草稿には、独立した査読や学術誌への受理の記録はない。