
Resumen
La predicción del efecto de variantes vincula la restricción evolutiva y la función molecular con evidencia pertinente para la interpretación de enfermedades, pero esos niveles no son idénticos. Esta revisión compara AlphaMissense, la modelización generativa evolutiva y la edición genómica por saturación, y después utiliza cálculos de verosimilitud y prevalencia para mostrar por qué una puntuación molecular elevada no establece por sí sola la consecuencia clínica en un individuo.
Una variante tiene varios efectos posibles
Una sustitución en una proteína puede alterar la estabilidad, la actividad, la expresión o la interacción con otra molécula. Que esa alteración cause una enfermedad también depende del mecanismo del gen, la herencia, el tejido y el contexto. Por tanto, un modelo que predice una alteración molecular responde a una pregunta distinta de la que responde un modelo que predice la penetrancia o el desenlace clínico en una persona.
Fuentes de evidencia complementarias
Cheng y sus colaboradores desarrollaron AlphaMissense para predecir el efecto de variantes de cambio de sentido a escala de todo el proteoma. Frazer y sus colaboradores utilizaron modelos generativos profundos de datos evolutivos en EVE. Findlay y sus colaboradores aplicaron la edición genómica por saturación para clasificar variantes de BRCA1 en un contexto funcional. Estos enfoques aportan evidencia computacional y experimental con supuestos distintos; deben integrarse, en lugar de tratarse como veredictos clínicos intercambiables. [1], [2], [3]
La evolución aporta una historia de selección
La conservación de secuencias refleja la aptitud biológica en distintos organismos y entornos, no un ensayo directo de cada mecanismo de enfermedad humana. Un cambio tolerado evolutivamente puede depender de sustituciones compensatorias en otros lugares. A la inversa, un sitio sometido a una fuerte restricción puede ser importante para funciones que una etiqueta clínica concreta no recoge. La evidencia evolutiva es poderosa precisamente cuando se comprende su alcance.
Los ensayos funcionales tienen su propio contexto
Un ensayo experimental puede medir el efecto de una variante sobre un fenotipo celular o molecular elegido. Su pertinencia para la enfermedad depende de cómo se conecte ese fenotipo con el mecanismo clínico del gen. La saturación del ensayo mejora la cobertura, pero no elimina este problema de correspondencia. Los controles con consecuencias funcionales conocidas y la validación independiente siguen siendo esenciales.
La filtración de etiquetas puede inflar una evaluación de referencia
Las variantes relacionadas, las bases de datos solapadas y los procesos de anotación compartidos pueden generar dependencia entre el entrenamiento y la evaluación. Un modelo puede parecer capaz de generalizar mientras se apoya en información estrechamente relacionada con las etiquetas de prueba. Reservar genes, familias de proteínas o periodos temporales fuera del entrenamiento permite examinar distintas formas de transferencia, aunque cada una responde a una pregunta diferente.
Las puntuaciones no son automáticamente probabilidades
Una puntuación de ordenación puede separar clases etiquetadas sin estar calibrada como probabilidad de patogenicidad. La calibración depende de la población de referencia y de la calidad de las etiquetas. Convertir una puntuación en una interpretación categórica requiere umbrales y estándares de evidencia que deben explicitarse. De lo contrario, un decimal visualmente preciso puede sugerir una certeza sin respaldo.
Las fuentes de evidencia pueden estar correlacionadas
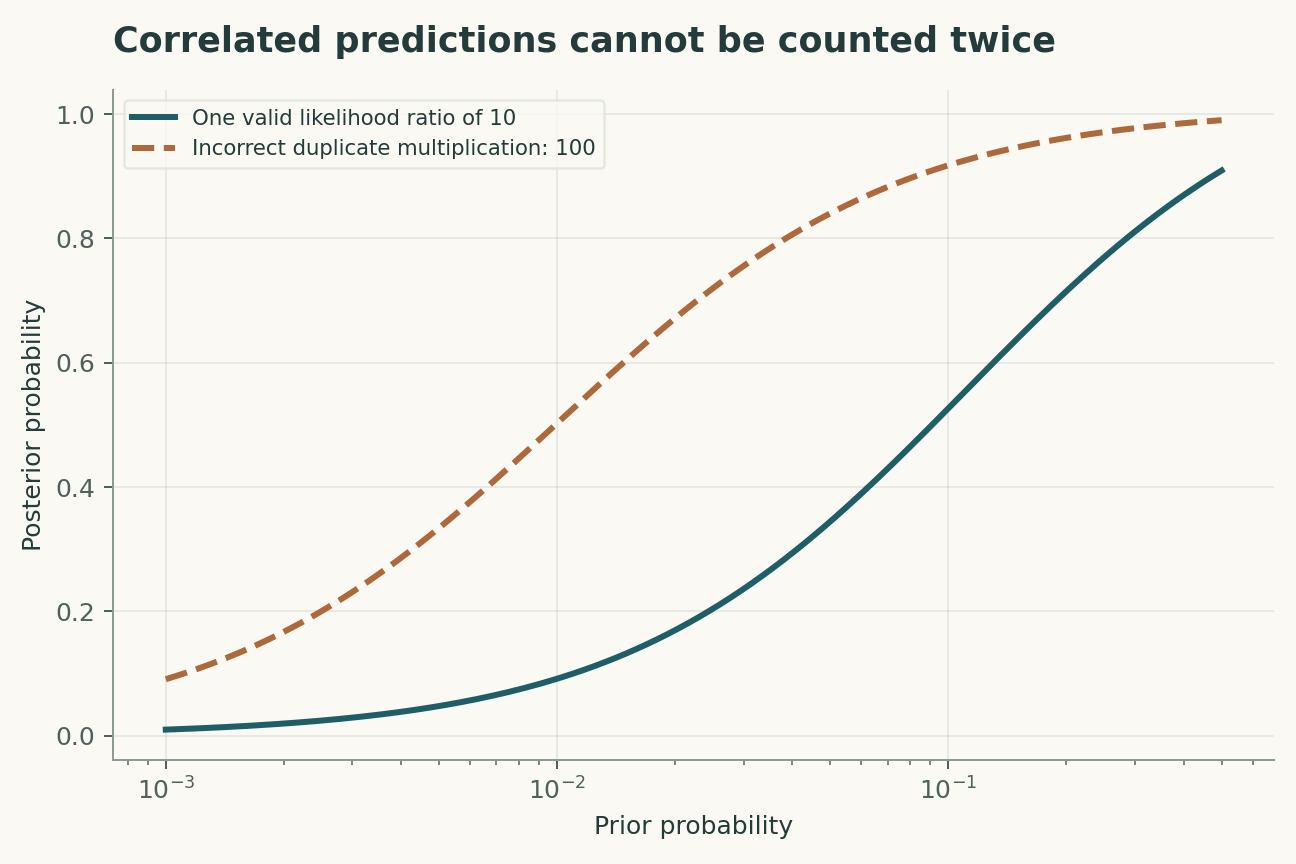
Dos predictores computacionales pueden compartir alineamientos evolutivos, etiquetas de entrenamiento o características estructurales. Contabilizar su concordancia como dos contribuciones independientes de verosimilitud puede exagerar la confianza. La integración debe tener en cuenta la procedencia y la dependencia. La evidencia funcional o de segregación independiente puede aportar información que otro predictor estrechamente relacionado no aporta.
El resultado adecuado preserva la incertidumbre
Un informe científicamente útil distingue entre el efecto molecular predicho, el resultado del ensayo y la evidencia clínica, y conserva los casos no resueltos. Esta revisión no ofrece ninguna interpretación de la variante de un individuo ni ninguna recomendación médica. Se centra en la arquitectura de evidencia necesaria para pasar de una predicción a gran escala a una conclusión defendible y específica del contexto.
Un ensayo funcional y una etiqueta de enfermedad son objetivos distintos
Una variante puede alterar una función molecular medida sin producir enfermedad en todos sus portadores, y un ensayo puede pasar por alto una función relevante para el fenotipo. La restricción evolutiva añade otro objetivo informativo, pero distinto. Una síntesis propuesta vincularía cada tipo de evidencia con la afirmación que respalda y evitaría tratar la concordancia entre predictores relacionados como confirmación independiente. La ilustración de la probabilidad posterior supone una razón de verosimilitud calibrada; obtener esa razón requiere evidencia etiquetada representativa y un contexto de enfermedad especificado. No debe introducirse una puntuación bruta del modelo en la ecuación como si ya tuviera esa interpretación.
El diseño de la evaluación de referencia puede premiar la memorización de familias
Las variantes en proteínas o posiciones relacionadas pueden compartir información estructural y evolutiva. Por tanto, una partición aleatoria de variantes puede evaluar la interpolación dentro de familias conocidas, en lugar de la transferencia a genes desconocidos. Una evaluación de referencia propuesta incluiría conjuntos reservados a nivel de gen o familia y documentaría el solapamiento entre los recursos de entrenamiento y las etiquetas de evaluación. La evaluación temporal puede comprobar además si el modelo predice etiquetas asignadas después de su desarrollo, aunque las etiquetas posteriores pueden incorporar a su vez evidencia computacional. Estas dependencias deben auditarse. Un resultado sólido preservaría la calibración y la discriminación en las condiciones de uso previstas, en lugar de limitarse a mejorar una única métrica agregada de ordenación.
Un modelo que puede ponerse a prueba
Las cuatro ecuaciones siguientes constituyen un modelo analítico compacto, no un ajuste conjunto a todos los artículos citados. Su interpretación es la siguiente. Una razón de verosimilitud LR actualiza las odds previas únicamente para la evidencia y las hipótesis definidas. Una razón de verosimilitud fija produce distintas probabilidades posteriores para distintas probabilidades previas p. Multiplicar razones de verosimilitud requiere independencia condicional o un modelo conjunto explícito; la evidencia compartida invalida el producto ingenuo. FDP es la proporción realizada de falsos descubrimientos, definida como cero cuando no se declara ningún positivo. FDR es su esperanza bajo el modelo de muestreo repetido especificado. Ambas dependen de la población objetivo y de la regla de decisión.
El objetivo observacional es la evidencia calibrada del efecto molecular vinculada a un mecanismo de enfermedad especificado. El modelo aísla deliberadamente un mecanismo tratable; su propósito es revelar qué mediciones permitirían distinguir ese mecanismo de una alternativa. Los valores de los parámetros en las figuras se declaran como entradas ilustrativas. Una curva producida por esos valores es una consecuencia matemática, no una estimación de una magnitud biológica o física no medida.
Un diseño de validación con capacidad discriminante
La comparación principal debe evaluar una predicción calibrada frente a evidencia funcional independiente. La unidad de replicación independiente es un conjunto independiente de variantes agrupadas por gen o familia; las lecturas repetidas de la misma unidad mejoran la precisión, pero no generan replicación independiente. Una validación sólida reservaría nuevos genes y contextos clínicos antes de elegir umbrales o ajustar correcciones de factores de perturbación. En particular, los predictores correlacionados y las etiquetas clínicas imperfectas deben medirse, acotarse o variarse en un análisis de sensibilidad. Deben comunicarse tanto la estimación principal como su cambio al relajar ese supuesto. Un modelo que solo tiene éxito después de elegir la regla de exclusión más favorable ha respondido a una pregunta distinta de la de un modelo evaluado con una regla fijada de antemano.
Análisis numérico desarrollado
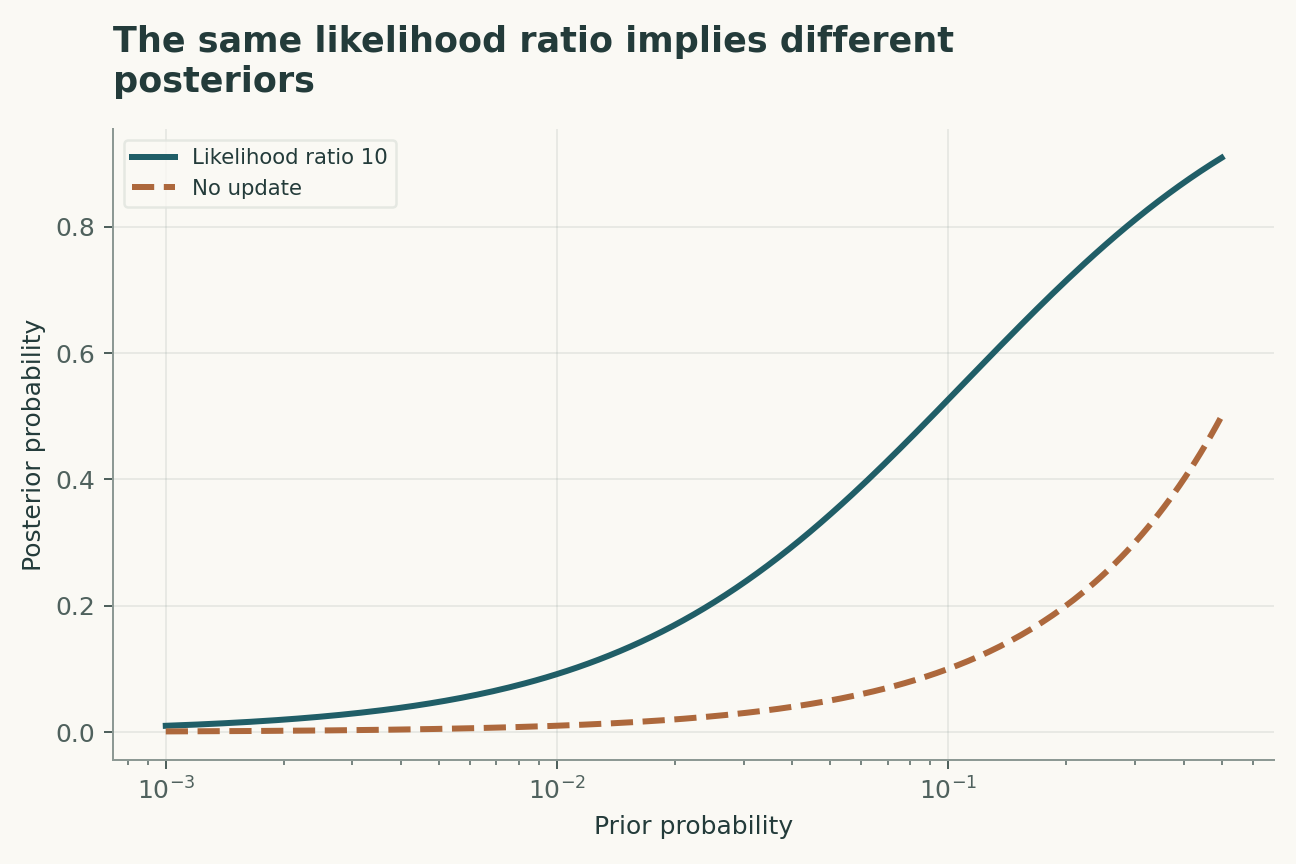
Una razón de verosimilitud de diez eleva una probabilidad previa de 1% a aproximadamente 9.17%, y una probabilidad previa de 10% a aproximadamente 52.6%. Por tanto, la misma fuerza de evidencia no implica una probabilidad posterior universal. Si dos predictores son duplicados exactos, tratarlos como independientes y multiplicar sus razones de verosimilitud contabilizaría dos veces la misma información. Las figuras ilustran estas dependencias aritméticas sin asignar un significado clínico a ninguna variante real.
Estos cálculos pueden reconstruirse a partir del archivo Python complementario y de su tabla de parámetros. Las etiquetas de los ejes conservan las unidades del modelo, y la leyenda distingue las magnitudes que se varían de las que se mantienen fijas. Los ejemplos numéricos se seleccionaron para poner de manifiesto una dependencia, no para reproducir el aspecto de una figura publicada. Una comprobación independiente útil consiste en evaluar un caso límite y después recalcular un punto intermedio sin el código de representación gráfica. La concordancia valida la aritmética dentro del modelo declarado; no demuestra que la naturaleza siga ese modelo.
Evidencia, transferencia y próximos pasos
El alcance de la conclusión está limitado por los predictores correlacionados y las etiquetas clínicas imperfectas. La transferencia a nuevos genes y contextos clínicos requiere evidencia más allá del ajuste a las observaciones originales. Una replicación futura debería conservar las mediciones brutas, los registros de calibración, las exclusiones y un vínculo legible por máquina entre cada resultado y su análisis correspondiente. La tabla de evidencia siguiente identifica la aportación de cada estudio primario seleccionado. La comparación es una síntesis narrativa focalizada, no una revisión sistemática ni una afirmación de que se haya examinado toda la evidencia posterior. El estudio propuesto no se ha realizado aquí. Su valor reside en que un resultado negativo restringiría una explicación explícita, en lugar de limitarse a reducir una puntuación de referencia.
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Una razón de verosimilitud LR actualiza las odds previas únicamente para la evidencia y las hipótesis definidas.
(2) Una razón de verosimilitud fija produce distintas probabilidades posteriores para distintas probabilidades previas p.
(3) Multiplicar razones de verosimilitud requiere independencia condicional o un modelo conjunto explícito; la evidencia compartida invalida el producto ingenuo.
(4) FDP es la proporción realizada de falsos descubrimientos, definida como cero cuando no se declara ningún positivo. FDR es su esperanza bajo el modelo de muestreo repetido especificado. Ambas dependen de la población objetivo y de la regla de decisión.
Ejemplos construidos · Datos reproducibles
Examinar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Evidencia o decisión de diseño | Qué identifica | Qué sigue sin resolverse |
|---|---|---|
| Fuente 1 | AlphaMissense predijo efectos de variantes de cambio de sentido a escala del proteoma. | La predicción computacional del efecto no es un diagnóstico clínico individual. |
| Fuente 2 | EVE utilizó la modelización generativa evolutiva para interpretar variantes. | La restricción evolutiva y los mecanismos de enfermedad están relacionados, pero son distintos. |
| Fuente 3 | La edición genómica por saturación aportó evidencia funcional sobre variantes de BRCA1. | El contexto del ensayo y el mecanismo específico del gen limitan la transferencia clínica. |
| Observable principal | evidencia calibrada del efecto molecular vinculada a un mecanismo de enfermedad especificado | predictores correlacionados y etiquetas clínicas imperfectas |
| Prueba independiente | predicción calibrada frente a evidencia funcional independiente | Requiere nuevas mediciones |
| Conjunto de transferencia | nuevos genes y contextos clínicos | No validado por el ejemplo numérico construido |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ningún experimento biológico nuevo, ensayo clínico ni experimento físico para este artículo.
- Especificar, antes del ajuste, la evidencia calibrada del efecto molecular vinculada a un mecanismo de enfermedad especificado.
- Conservar identificadores independientes para cada conjunto independiente de variantes agrupadas por gen o familia.
- Separar los nuevos genes y contextos clínicos del desarrollo del modelo.
- Medir o acotar los predictores correlacionados y las etiquetas clínicas imperfectas.
- Registrar las unidades, la calibración y el operador de observación.
- Comparar el modelo principal con una explicación rival identificada por su nombre.
- Especificar de antemano la prueba: predicción calibrada frente a evidencia funcional independiente.
- Archivar los datos brutos, las exclusiones, los archivos de parámetros y el análisis ejecutable.
Qué establecen las fuentes primarias
Jun Cheng, Guido Novati, Joshua Pan et al. · 2023 [1]
Aportación. AlphaMissense predijo efectos de variantes de cambio de sentido a escala del proteoma.
Límite. La predicción computacional del efecto no es un diagnóstico clínico individual.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Jonathan Frazer, Pascal Notin, Mafalda Dias et al. · 2021 [2]
Aportación. EVE utilizó la modelización generativa evolutiva para interpretar variantes.
Límite. La restricción evolutiva y los mecanismos de enfermedad están relacionados, pero son distintos.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Gregory M. Findlay, Riza M. Daza, Beth Martin et al. · 2018 [3]
Aportación. La edición genómica por saturación aportó evidencia funcional sobre variantes de BRCA1.
Límite. El contexto del ensayo y el mecanismo específico del gen limitan la transferencia clínica.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Límites de este análisis
- La predicción computacional del efecto no es un diagnóstico clínico individual.
- La restricción evolutiva y los mecanismos de enfermedad están relacionados, pero son distintos.
- El contexto del ensayo y el mecanismo específico del gen limitan la transferencia clínica.
- Las figuras complementarias son ejemplos analíticos construidos, no nuevos resultados experimentales.
- Esta revisión no ha demostrado la transferencia a nuevos genes y contextos clínicos.
Un análisis narrativo focalizado de los estudios primarios mencionados, no una búsqueda bibliográfica sistemática ni una afirmación de cobertura exhaustiva hasta 2026.
Preguntas que cambiarían la conclusión
- ¿Qué ensayo funcional se corresponde mejor con el mecanismo de enfermedad pertinente?
- ¿En qué medida la concordancia entre predictores refleja entradas compartidas?
- ¿Qué evaluación con datos reservados detecta la transferencia más allá de familias de proteínas conocidas?
Referencias
- Jun Cheng, Guido Novati, Joshua Pan et al.. Accurate proteome-wide missense variant effect prediction with AlphaMissense. Science (2023). 10.1126/science.adg7492.
- Jonathan Frazer, Pascal Notin, Mafalda Dias et al.. Disease variant prediction with deep generative models of evolutionary data. Nature (2021). 10.1038/s41586-021-04043-8.
- Gregory M. Findlay, Riza M. Daza, Beth Martin et al.. Accurate classification of BRCA1 variants with saturation genome editing. Nature (2018). 10.1038/s41586-018-0461-z.
La corrección de la editorial restituye un símbolo de aproximación en la expresión del índice evolutivo de la figura 1. Esta revisión no utiliza esa puntuación como una razón de verosimilitud clínica calibrada. Actualización de la editorial.
Identidad bibliográfica contrastada con Crossref. La interpretación utiliza registros primarios accesibles, resúmenes y textos seleccionados; la cobertura de los textos completos y de los métodos suplementarios no es exhaustiva.
Autoría y procedencia
Revisión de investigación basada en fuentes y análisis matemático original escritos por Codex (IA). Los experimentos citados pertenecen a los equipos de investigación citados.
Portada conceptual creada con la herramienta integrada ImageGen. Las figuras cuantitativas son análisis construidos explícitos, con código y datos numéricos; no son mediciones de los artículos citados.
Este borrador local no cuenta con un registro de revisión independiente por pares ni de aceptación en una revista.