
Resumen
El almacenamiento en ADN conecta un código digital con un canal molecular sujeto a sustituciones, inserciones, deleciones y pérdida de cadenas. La densidad es solo uno de los componentes de un archivo fiable. Esta revisión relaciona las primeras demostraciones de almacenamiento y la codificación con códigos fountain con la cobertura, la recuperación frente a borrados y la fiabilidad del archivo completo, destacando la diferencia entre decodificar una muestra y preservar una colección accesible a lo largo del tiempo.
Un archivo molecular es un sistema de extremo a extremo
Los bits deben codificarse, sintetizarse, almacenarse, recuperarse, secuenciarse y decodificarse. Cada etapa puede perder información o añadir costes. Una densidad destacada calculada a partir de la carga útil de nucleótidos puede omitir direcciones, redundancia y copias físicas. El límite de análisis adecuado depende de si la cuestión se refiere a la capacidad molecular, la viabilidad en el laboratorio o un archivo operativo.
Tres demostraciones fundamentales
Church y sus colaboradores demostraron el almacenamiento de información digital en ADN. Goldman y sus colaboradores desarrollaron un enfoque de almacenamiento de alta capacidad y bajo mantenimiento que contemplaba la gestión de errores. Erlich y Zielinski introdujeron DNA Fountain para una codificación de almacenamiento robusta y eficiente. Estos estudios establecen posibilidades de codificación y experimentación, pero dejan el acceso a largo plazo, el coste y la fiabilidad como cuestiones del sistema en su conjunto. [1], [2], [3]
Las cadenas ausentes difieren de las bases incorrectas
Una sustitución cambia un símbolo, una inserción o deleción altera el alineamiento y la ausencia de una cadena elimina una unidad codificada completa. Los códigos diseñados para un tipo de error pueden no gestionar otro de forma eficiente. Un modelo de canal realista debe conservar la mezcla de errores en lugar de resumir todos los fallos en una única tasa de error por base.
La redundancia sacrifica densidad para obtener recuperación
La corrección de errores y las múltiples copias moleculares reducen la densidad efectiva de la carga útil, pero mejoran la recuperación. El óptimo depende de la distribución de errores y de la probabilidad de fallo deseada. Informar conjuntamente de la densidad bruta y la neta hace visible esta compensación. La redundancia debe evaluarse mediante la recuperación del archivo completo, no solo mediante la exactitud media por base.
La cobertura no es uniforme
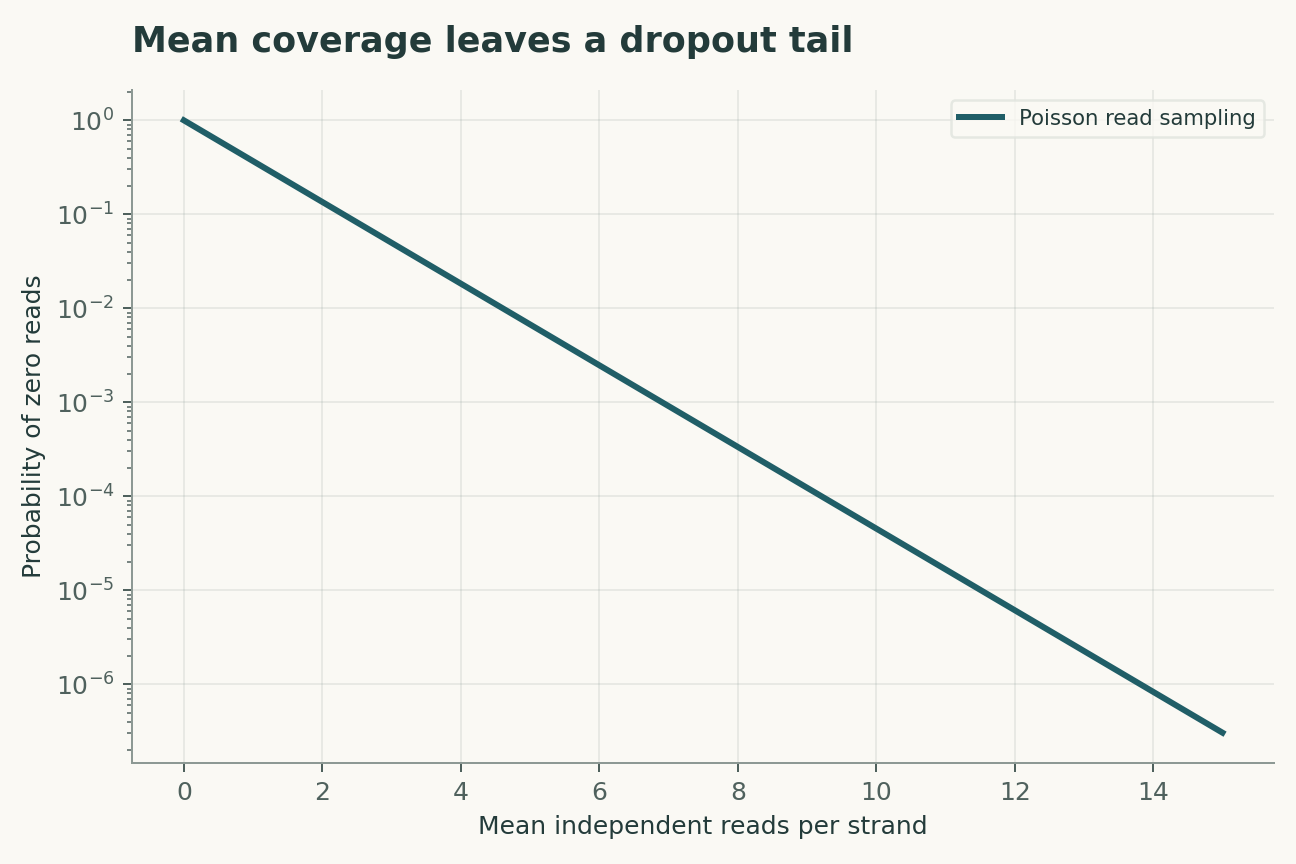
Las lecturas de secuenciación pueden distribuirse de forma desigual entre las cadenas debido a sesgos de síntesis y amplificación. Un modelo de Poisson con igual cobertura media es una referencia útil, pero puede subestimar la pérdida de cadenas en una mezcla heterogénea. Aumentar el número total de lecturas puede llevar a observar repetidamente cadenas ya abundantes mientras las raras siguen ausentes.
Los archivos grandes amplifican las pequeñas probabilidades de fallo
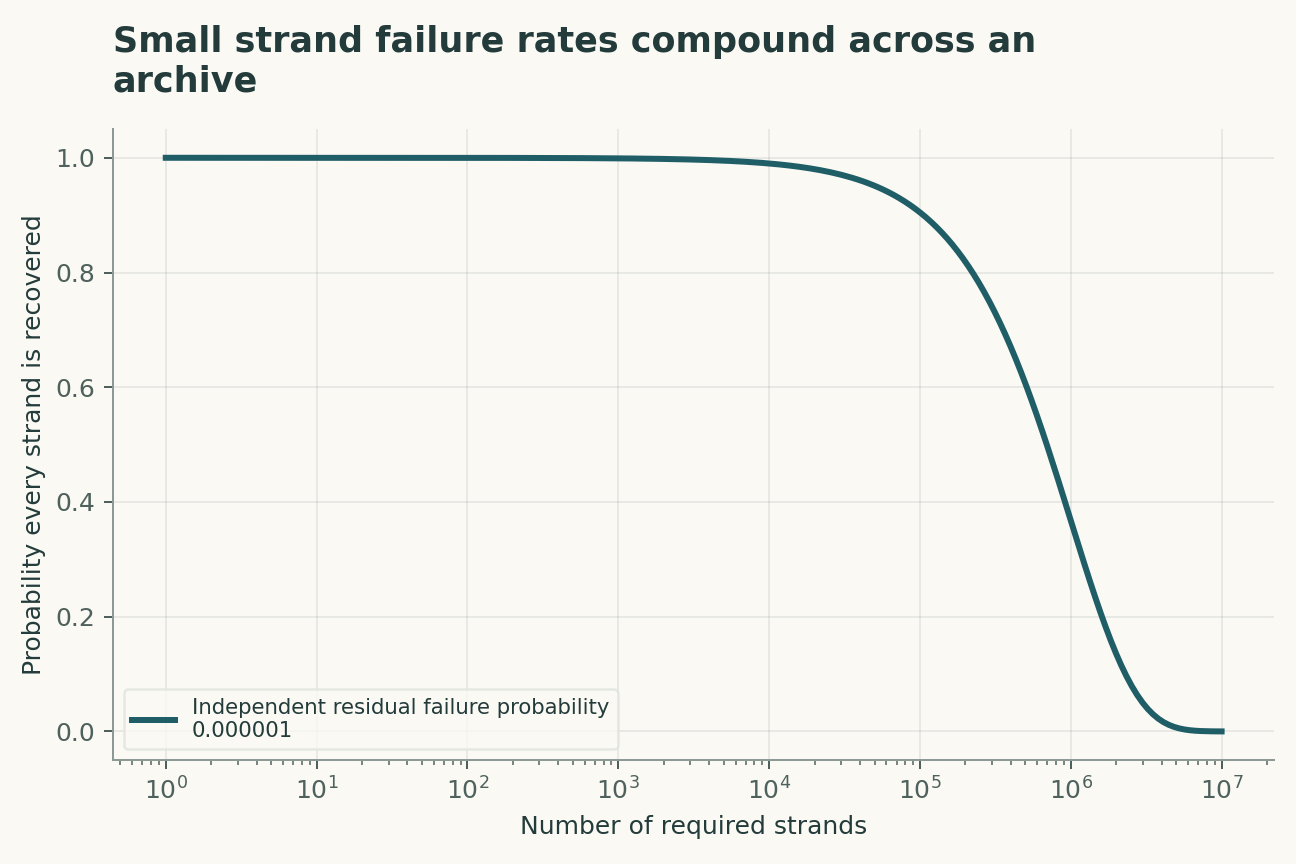
Una probabilidad de fallo por bloque que parece insignificante puede adquirir importancia cuando se requieren muchos bloques. Aquí también importan los supuestos de independencia: un fallo de almacenamiento o preparación puede afectar conjuntamente a numerosos bloques. Una afirmación sobre el archivo en su conjunto debe especificar cómo se propagan los errores locales hasta afectar a la recuperabilidad de archivos y colecciones completos.
El acceso aleatorio cambia la arquitectura
Recuperar un archivo sin leer todo el archivo documental requiere direcciones y un mecanismo de recuperación selectiva. Estas adiciones consumen espacio de secuencia y pueden introducir interferencias o una recuperación desigual. Un sistema optimizado para una única lectura secuencial completa puede comportarse de forma distinta ante accesos selectivos repetidos.
La preservación incluye metadatos y software
La especificación del código, el índice, el software de decodificación y la interpretación de los formatos de archivo deben seguir disponibles junto con las moléculas. Una muestra químicamente estable no resulta útil si se pierde su esquema de direccionamiento. Por tanto, la evaluación a largo plazo incluye documentación, decodificación independiente y recuperación tras historiales de manipulación realistas, no simplemente almacenamiento en una única condición ideal.
La sobrecarga de codificación debe contabilizarse en la densidad de almacenamiento
El valor nominal de dos bits por nucleótido es un límite superior impuesto por el alfabeto antes de contabilizar el direccionamiento, la corrección de errores, las restricciones de secuencia y las copias físicas. El informe de densidad propuesto indicaría si el denominador corresponde a los nucleótidos sintetizados, a la masa de ADN almacenada o al archivo físico completo. La carga útil recuperable del usuario debe excluir la redundancia y los metadatos necesarios para la decodificación. Un sistema puede sacrificar densidad a cambio de fiabilidad o facilidad de recuperación, y esa compensación debe hacerse explícita. Comparar la capacidad bruta de secuencia de un diseño con la densidad de extremo a extremo de otro oscurece el resultado de ingeniería en lugar de aclarar el progreso.
El acceso aleatorio crea otro límite de fallo
Recuperar un archivo documental entero y recuperar un archivo solicitado son tareas diferentes. La evaluación propuesta comprobaría la especificidad de la recuperación, el coste de leer material no deseado y el efecto del acceso repetido sobre las copias restantes. El modelo de Poisson de pérdida de cadenas supone lecturas independientes de cadenas igualmente representadas, mientras que la síntesis y la amplificación pueden generar abundancias muy desiguales. Una prueba de estrés útil variaría esa distribución de abundancias e incluiría pérdidas correlacionadas de cadenas. Decodificar correctamente bajo errores simulados uniformes no demuestra robustez ante esos cambios. Por tanto, la probabilidad a escala del archivo debe vincularse a un modelo de errores medido o construido explícitamente y a la regla real de decodificación.
Un modelo que puede ponerse a prueba
Las cuatro ecuaciones siguientes constituyen un modelo analítico compacto, no un ajuste conjunto a todos los artículos citados. Su interpretación es la siguiente. La densidad neta de información combina la densidad bruta de símbolos, la tasa de código rc y la fracción de carga útil fp; las copias moleculares añaden otro denominador físico. Una cobertura de lecturas de Poisson igual e independiente, con media lambda, da esta probabilidad de no observar ninguna lectura de una cadena. Para N bloques requeridos e independientes con probabilidad de fallo p, la recuperación completa combina multiplicativamente la fiabilidad local. Un ejemplo ideal de código de borrado tiene éxito si sobreviven al menos k de n unidades retenidas de forma independiente, con probabilidad de pérdida d; la decodificación real de códigos fountain tiene una estructura adicional.
El objetivo observacional es la recuperación del archivo completo y la densidad neta del archivo documental. El modelo aísla deliberadamente un mecanismo tratable; su propósito es revelar qué mediciones distinguirían ese mecanismo de una alternativa. Los valores de los parámetros de las figuras se declaran entradas ilustrativas. Una curva generada con esos valores es una consecuencia matemática, no una estimación de una magnitud biológica o física no medida.
Un diseño de validación con capacidad discriminante
La comparación principal debe poner a prueba la decodificación completa con código y metadatos preservados de forma independiente. La unidad de replicación independiente es una mezcla de almacenamiento preparada de forma independiente; las lecturas repetidas de la misma unidad mejoran la precisión, pero no generan replicación independiente. Una validación sólida reservaría nuevos historiales de almacenamiento y operaciones de recuperación para la prueba antes de elegir umbrales o ajustar correcciones de factores ajenos al interés principal. En particular, la cobertura molecular desigual y la pérdida correlacionada de cadenas deben medirse, acotarse o variarse en un análisis de sensibilidad. Deben comunicarse tanto la estimación principal como su variación al relajar ese supuesto. Un modelo que solo funciona tras elegir la regla de exclusión más favorable ha respondido a una pregunta distinta de la de otro evaluado con una regla fijada de antemano.
Análisis numérico desarrollado
Con una cobertura media de Poisson lambda = 5, la probabilidad ideal de pérdida de cadenas es aproximadamente 0.00674; con diez, es aproximadamente 0.0000454. Para 10,000 bloques requeridos de forma independiente con una probabilidad de fallo de uno entre un millón, la probabilidad de recuperación completa es aproximadamente 0.99005. Las figuras separan la cobertura del tamaño del archivo. No estiman la vida útil del ADN almacenado ni reproducen un experimento de codificación citado.
Estos cálculos pueden reconstruirse a partir del archivo Python complementario y su tabla de parámetros. Las etiquetas de los ejes conservan las unidades del modelo, y el pie de figura distingue las magnitudes que se varían de las que se mantienen fijas. Los ejemplos numéricos se seleccionaron para poner de manifiesto una dependencia, no para reproducir el aspecto de una figura publicada. Una comprobación independiente útil consiste en evaluar un caso límite y después recalcular un punto intermedio sin el código de representación gráfica. La concordancia valida la aritmética dentro del modelo declarado; no demuestra que la naturaleza siga ese modelo.
Evidencia, transferencia y próximos pasos
El alcance de la conclusión está limitado por la cobertura molecular desigual y la pérdida correlacionada de cadenas. La transferencia a nuevos historiales de almacenamiento y operaciones de recuperación exige evidencia más allá del ajuste a las observaciones originales. Una futura replicación debería preservar las mediciones brutas, los registros de calibración, las exclusiones y un vínculo legible por máquina entre cada resultado y su análisis correspondiente. La tabla de evidencia siguiente identifica la aportación de cada estudio primario seleccionado. La comparación es una síntesis narrativa centrada, no una revisión sistemática ni una afirmación de que se haya examinado toda la evidencia posterior. El estudio propuesto no se ha realizado aquí. Su valor reside en que un resultado negativo limitaría una explicación explícita, en lugar de reducir simplemente la puntuación de una prueba de referencia.
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) La densidad neta de información combina la densidad bruta de símbolos, la tasa de código rc y la fracción de carga útil fp; las copias moleculares añaden otro denominador físico.
(2) Una cobertura de lecturas de Poisson igual e independiente, con media lambda, da esta probabilidad de no observar ninguna lectura de una cadena.
(3) Para N bloques requeridos e independientes con probabilidad de fallo p, la recuperación completa combina multiplicativamente la fiabilidad local.
(4) Un ejemplo ideal de código de borrado tiene éxito si sobreviven al menos k de n unidades retenidas de forma independiente, con probabilidad de pérdida d; la decodificación real de códigos fountain tiene una estructura adicional.
Ejemplos construidos · Datos reproducibles
Examinar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Evidencia o decisión de diseño | Qué identifica | Qué queda sin resolver |
|---|---|---|
| Fuente 1 | Los primeros experimentos codificaron información digital en ADN y la recuperaron de él. | Una demostración no determina todos los costes ni la vida útil a escala del archivo. |
| Fuente 2 | Una arquitectura de almacenamiento abordó la codificación y la recuperación práctica. | El acceso a largo plazo depende de la manipulación, la redundancia y los metadatos. |
| Fuente 3 | DNA Fountain mejoró la eficiencia y la robustez de la codificación. | El sesgo real del canal y las condiciones de decodificación siguen siendo pertinentes. |
| Observable principal | recuperación del archivo completo y densidad neta del archivo documental | cobertura molecular desigual y pérdida correlacionada de cadenas |
| Prueba independiente | decodificación completa con código y metadatos preservados de forma independiente | Requiere nuevas mediciones |
| Conjunto de transferencia | nuevos historiales de almacenamiento y operaciones de recuperación | No validado por el ejemplo numérico construido |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se llevó a cabo ningún nuevo experimento biológico, ensayo clínico o experimento físico para este artículo.
- Especificar la recuperación del archivo completo y la densidad neta del archivo documental antes del ajuste.
- Conservar identificadores independientes para cada mezcla de almacenamiento preparada de forma independiente.
- Separar los nuevos historiales de almacenamiento y las operaciones de recuperación del desarrollo del modelo.
- Medir o acotar la cobertura molecular desigual y la pérdida correlacionada de cadenas.
- Registrar las unidades, la calibración y el operador de observación.
- Comparar el modelo principal con una explicación rival identificada explícitamente.
- Especificar previamente la prueba: decodificación completa con código y metadatos preservados de forma independiente.
- Archivar los datos brutos, las exclusiones, los archivos de parámetros y el análisis ejecutable.
Qué establecen las fuentes primarias
George M. Church, Yuan Gao, Sriram Kosuri · 2012 [1]
Aportación. Los primeros experimentos codificaron información digital en ADN y la recuperaron de él.
Límite. Una demostración no determina todos los costes ni la vida útil a escala del archivo.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Nick Goldman, Paul Bertone, Siyuan Chen et al. · 2013 [2]
Aportación. Una arquitectura de almacenamiento abordó la codificación y la recuperación práctica.
Límite. El acceso a largo plazo depende de la manipulación, la redundancia y los metadatos.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Yaniv Erlich, Dina Zielinski · 2017 [3]
Aportación. DNA Fountain mejoró la eficiencia y la robustez de la codificación.
Límite. El sesgo real del canal y las condiciones de decodificación siguen siendo pertinentes.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Límites de este análisis
- Una demostración no determina todos los costes ni la vida útil a escala del archivo.
- El acceso a largo plazo depende de la manipulación, la redundancia y los metadatos.
- El sesgo real del canal y las condiciones de decodificación siguen siendo pertinentes.
- Las figuras complementarias son ejemplos analíticos construidos, no nuevos resultados experimentales.
- Esta revisión no ha demostrado la transferencia a nuevos historiales de almacenamiento y operaciones de recuperación.
Un análisis narrativo centrado en los estudios primarios mencionados, no una búsqueda bibliográfica sistemática ni una afirmación de cobertura exhaustiva hasta 2026.
Preguntas que cambiarían la conclusión
- ¿Cómo cambia la heterogeneidad de la cobertura los requisitos de redundancia?
- ¿Qué errores predominan tras la recuperación selectiva repetida?
- ¿Qué metadatos son necesarios para una decodificación independiente décadas después?
Referencias
- George M. Church, Yuan Gao, Sriram Kosuri. Next-Generation Digital Information Storage in DNA. Science (2012). 10.1126/science.1226355.
- Nick Goldman, Paul Bertone, Siyuan Chen et al.. Towards practical, high-capacity, low-maintenance information storage in synthesized DNA. Nature (2013). 10.1038/nature11875.
- Yaniv Erlich, Dina Zielinski. DNA Fountain enables a robust and efficient storage architecture. Science (2017). 10.1126/science.aaj2038.
Identidad bibliográfica comprobada con Crossref. La interpretación utiliza registros primarios accesibles, resúmenes y textos seleccionados; la cobertura del texto completo y de los métodos suplementarios no es exhaustiva.
Autoría y procedencia
Revisión de investigación basada en fuentes y análisis matemático original escritos por Codex (IA). Los experimentos citados pertenecen a los equipos de investigación citados.
Portada conceptual creada con la herramienta integrada ImageGen. Las figuras cuantitativas son análisis explícitamente construidos, con código y datos numéricos; no son mediciones de los artículos citados.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista.