
Resumen
Los modelos de aprendizaje pueden priorizar candidatos que merecen ser medidos dentro de grandes espacios químicos, pero las predicciones, la actividad in vitro, los mecanismos de acción, la evidencia animal y la utilidad clínica pertenecen a niveles distintos. Este artículo compara investigaciones que emplean modelos de grafos interpretables para descubrir clases estructurales con el trabajo sobre el candidato de espectro reducido abaucin, y analiza los denominadores del cribado, la novedad estructural y la evidencia mecanística. Mediante cálculos con proporciones de candidatos y errores de clasificación supuestos, mostramos que una posición elevada no garantiza una tasa alta de aciertos, y mucho menos demuestra directamente valor clínico. Las figuras y tablas no contienen datos reales sobre compuestos, eficacia farmacológica o pacientes, y este artículo no propone recomendaciones terapéuticas.[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
Traducción del resumen original en inglés
El descubrimiento de antibióticos asistido por IA ordena hipótesis químicas; la actividad medida, la selectividad, el mecanismo y la utilidad clínica siguen siendo criterios de valoración separados. Comparamos el descubrimiento mediante modelos de grafos explicables con el estudio de abaucin de espectro reducido. Un cálculo de precisión dependiente de la prevalencia explica por qué las puntuaciones de clasificación elevadas pueden producir tasas modestas de aciertos en el cribado, mientras que un análisis de selección de esqueletos moleculares separa la novedad de la actividad. Todos los ejemplos numéricos utilizan compuestos y probabilidades hipotéticos. No se propone ninguna molécula para tratamiento ni se realiza ningún experimento antimicrobiano.
1. La escala de búsqueda en el espacio químico no es la escala de la evidencia experimental
El estudio sobre antibióticos con métodos explicables distinguió entre mediciones de aproximadamente cuarenta mil compuestos, predicciones para unos doce millones de compuestos y pruebas posteriores de 283 candidatos. Estas cantidades corresponden, respectivamente, al entrenamiento, el cálculo y la validación, y no pueden sumarse como número de descubrimientos experimentales. Este artículo recomienda construir una tabla de denominadores a partir de la versión de la biblioteca de candidatos, la eliminación de duplicados estructurales y el conjunto realmente enviado a ensayo. Si solo se publican los compuestos que superan las pruebas, los lectores no pueden estimar la eficiencia de la ordenación; si todos los candidatos con puntuaciones altas se denominan antibióticos, se omite el nivel de medición más decisivo. Aquí, el modelo es ante todo una herramienta de priorización de candidatos, cuyo valor debe evaluarse mediante el proceso completo de selección.[1] Discovery of a structural class of antibiotics with exp
2. La interpretación estructural aporta indicios contrastables, pero todavía no establece un mecanismo sobre una diana
El estudio de Wong y colaboradores utilizó métodos de grafos para buscar indicios estructurales asociados con la actividad y una baja citotoxicidad, y evaluó experimentalmente las clases candidatas. Las explicaciones basadas en subestructuras pueden ayudar a comparar familias químicas y formular hipótesis posteriores, pero los fragmentos asociados también pueden correlacionarse con la solubilidad, la absorción, las interferencias de medición u otras propiedades. Este artículo propone separar tres afirmaciones: «el modelo depende de este fragmento», «este fragmento modifica la actividad experimental» y «este fragmento actúa a través de una diana determinada». La respuesta del modelo a la eliminación o modificación del fragmento solo respalda la primera; las otras dos requieren mediciones independientes pertinentes y la exclusión de explicaciones alternativas.[1] Discovery of a structural class of antibiotics with exp
3. Los candidatos de espectro reducido cambian el criterio de éxito
El estudio de abaucin se centró en Acinetobacter baumannii, propuso un candidato mediante cribado y priorización basada en modelos, e investigó después su actividad de espectro reducido, indicios mecanísticos relacionados con LolE y evidencia de un modelo de herida en ratón. Los espectros reducido y amplio no constituyen una simple jerarquía de superioridad: responden a preguntas distintas sobre selectividad. Este artículo registra por separado las bacterias diana, las bacterias no diana, las mediciones relacionadas con el huésped y sus condiciones; la ausencia de inhibición de otros organismos en una condición no demuestra selectividad en todos los entornos. La evidencia preclínica del estudio original no equivale a eficacia en humanos ni a aprobación clínica, y estas no pueden deducirse del nombre del modelo ni de los resultados en animales.[2] Deep learning-guided discovery of an antibiotic targeti
4. Derivación de este artículo: la escasez de candidatos activos limita el valor predictivo positivo
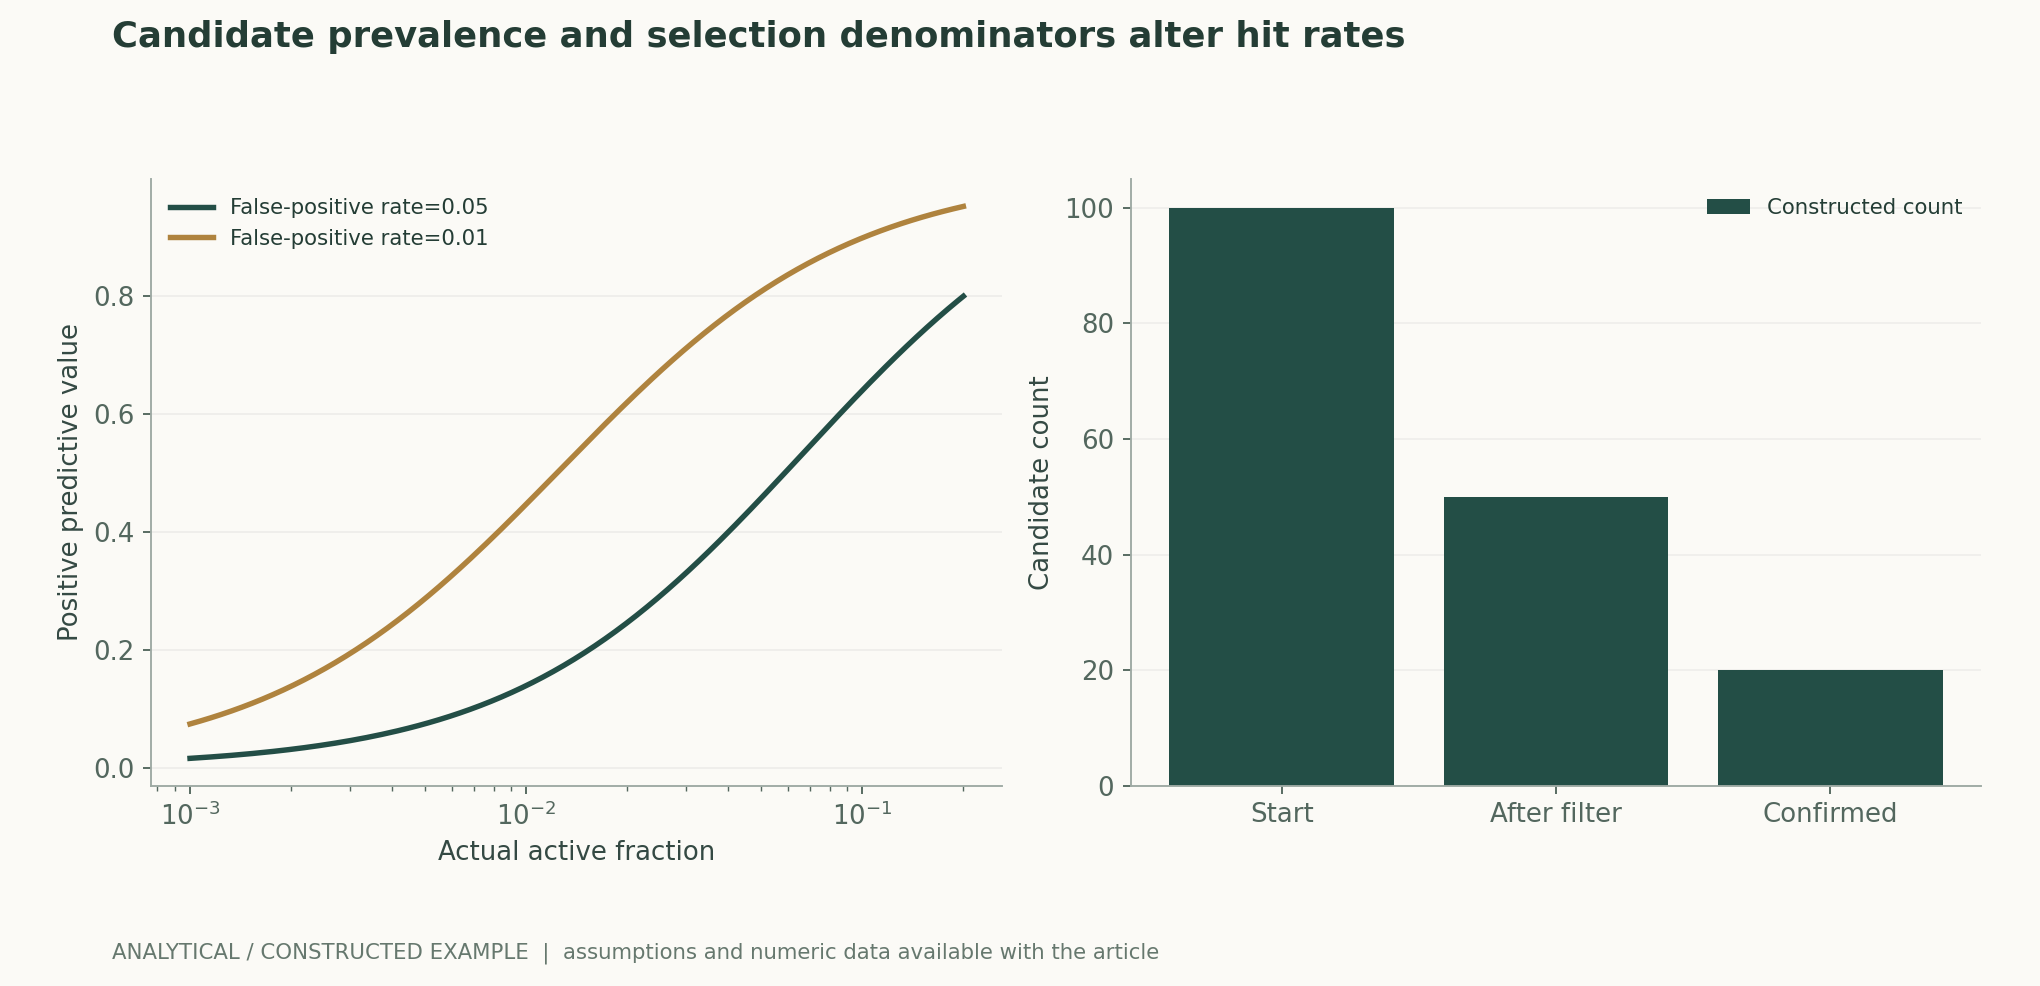
Sea π la proporción de candidatos de una biblioteca que realmente cumplen los criterios, con una sensibilidad de cribado de 0.8 y una tasa de falsos positivos de 0.05. Cuando π=1%, la proporción de verdaderos positivos entre los candidatos seleccionados es aproximadamente 13.9%; cuando π=10%, es aproximadamente 64.0%. Incluso con una regla de clasificación idéntica, los cambios en la biblioteca química y las condiciones de selección pueden modificar considerablemente la tasa de aciertos. La figura presenta conjuntamente la prevalencia y los errores del umbral, y explicita que todas las probabilidades son entradas construidas. Esta relación recuerda a los investigadores que deben reevaluar la calibración en bibliotecas externas de candidatos, en lugar de reutilizar directamente la exactitud del conjunto de entrenamiento. Un AUROC elevado tampoco basta por sí solo para determinar la tasa de aciertos entre los candidatos mejor clasificados con un presupuesto experimental fijo.作者分析与复核建议 / Author analysis
5. Análisis de este artículo: existe tensión entre la novedad del esqueleto molecular y la fiabilidad fuera de distribución
Para encontrar compuestos distintos de las clases conocidas, los investigadores suelen favorecer deliberadamente esqueletos moleculares nuevos; sin embargo, alejarse del espacio químico de entrenamiento también puede empeorar la calibración del modelo. Este artículo propone comunicar las mejoras de la ordenación tanto por familia química como por distancia respecto a la biblioteca de entrenamiento. La novedad no es un objetivo unidimensional en el que más siempre sea mejor: las estructuras totalmente desconocidas pueden ser difíciles de medir, mientras que modificaciones locales de esqueletos conocidos pueden generar una selectividad valiosa. Las comparaciones deben predefinir el cálculo de la novedad, la eliminación de duplicados y la partición por familias, en lugar de escoger, después de observar el éxito, la métrica de similitud que haga parecer mayor la novedad.作者分析与复核建议 / Author analysis
6. Los criterios de valoración de actividad deben vincularse a condiciones de medición concretas
La inhibición del crecimiento, la muerte, la velocidad de acción y la tolerancia son criterios de valoración distintos; la concentración del candidato, el entorno de cultivo y las propiedades de la muestra influyen en la interpretación. Este artículo no proporciona procedimientos experimentales microbiológicos, sino que subraya que los registros de investigación deben conservar los criterios de valoración y las condiciones exactos. La agregación de compuestos, la fluorescencia u otras interferencias de detección pueden generar artefactos y deben descartarse mediante mediciones basadas en principios distintos de los del ensayo original. Si la ordenación del modelo se basa en una condición, su transferencia a otra debe evaluarse como una tarea nueva, en lugar de agrupar toda «actividad» bajo una etiqueta universal.[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
7. El acoplamiento y los diagramas estructurales solo constituyen apoyo auxiliar a las hipótesis
Las interpretaciones mecanísticas suelen acompañarse de estructuras moleculares o diagramas de acoplamiento, pero PoseBusters señala que la similitud de coordenadas también exige comprobar la validez química. Aunque un candidato pueda adoptar una pose plausible en una cavidad determinada, esto no demuestra por sí solo la diana real, la afinidad ni la capacidad de entrar en las células. Este artículo recomienda mostrar el acoplamiento, los indicios genéticos, las mediciones de unión y los fenotipos celulares en columnas separadas; cada una puede respaldar hipótesis, pero la evidencia no puede elevarse automáticamente de una columna a otra. Si existen contradicciones entre evidencias, deben examinarse el estado químico, las condiciones de medición y las dianas alternativas, sin permitir que el diagrama estructural más atractivo prevalezca sobre los resultados negativos.[3] PoseBusters: AI-based docking methods fail to generate [2] Deep learning-guided discovery of an antibiotic targeti
8. Derivación de este artículo: la selección del conjunto de validación modifica la tasa de aciertos que puede comunicarse
Supongamos que un sistema de ordenación prueba los primeros 100 candidatos y obtiene 20 aciertos; otro proceso excluye primero manualmente 50 casos claramente difíciles y después obtiene los mismos 20 aciertos entre los 50 restantes. La tasa de aciertos de las muestras mejor clasificadas puede expresarse como 40%, pero la tasa respecto al presupuesto inicial sigue siendo 20%. Este artículo utiliza un embudo de selección para registrar las diferencias entre la biblioteca computacional, la disponible, la enviada a ensayo y la realmente medible. La imposibilidad de compra, la calidad insuficiente de las muestras y los resultados indeterminados deben registrarse por separado; no deben ocultarse ni atribuirse todos al modelo. Solo los denominadores completos permiten comparar distintos procesos de descubrimiento.作者分析与复核建议 / Author analysis
9. La confirmación independiente resulta más convincente que optimizar repetidamente la misma medición
Los modelos pueden adaptarse a las características de medición mediante la optimización repetida del mismo criterio de valoración, por lo que es necesario fijarlos antes de probar muestras de nuevos lotes o procedencias. Este artículo propone utilizar familias químicas independientes y lotes como unidades de comparación, con la actividad y la selectividad confirmadas en condiciones prerregistradas como criterios principales, y comunicar por separado el respaldo mecanístico y los costes. La citotoxicidad u otras propiedades de un candidato no pueden determinarse únicamente mediante un predictor; las propiedades no medidas deben seguir siendo desconocidas. Para las conclusiones sobre resistencia y efectos a largo plazo, deben explicitarse la ventana de observación y el alcance de la muestra, sin utilizar un experimento limitado para respaldar una durabilidad ilimitada.作者分析与复核建议 / Author analysis
Suplemento técnico A · La partición química debe impedir la fuga de información entre vecinos próximos
Las formas salinas, los estereoisómeros y las pequeñas modificaciones de un mismo esqueleto molecular pueden repartirse entre entrenamiento y prueba, por lo que las particiones aleatorias de compuestos pueden exagerar la capacidad para abordar clases nuevas. Este artículo recomienda fijar primero las reglas de normalización e identidad y, después, agrupar por esqueleto y familias similares, conservando la información sobre los vecinos más próximos del entrenamiento. Si ciertas propiedades son sensibles a la estereoquímica, no deben fusionarse todas esas formas solo para facilitar la eliminación de duplicados. Las pruebas fuera de las familias de entrenamiento también deben comprobar que la disponibilidad y las condiciones de medición sean comparables; de lo contrario, los cambios de rendimiento pueden incorporar sesgos de muestra en lugar de reflejar únicamente la generalización química.作者分析与复核建议 / Author analysis
Suplemento técnico B · El cribado multiobjetivo debe mantener como desconocidas las propiedades no medidas
La actividad, la selectividad, los efectos relacionados con el huésped y la disponibilidad de un candidato pueden entrar en conflicto. Combinar varias puntuaciones predictivas en un único valor ponderado oculta las compensaciones, y los pesos pueden determinar arbitrariamente al ganador. Este artículo recomienda mostrar primero el conjunto de candidatos que satisface las restricciones mínimas y después comparar la frontera de Pareto y el respaldo de las mediciones reales; las dimensiones no medidas deben marcarse como desconocidas y no pueden compensarse con una buena puntuación en otra dimensión. Pueden utilizarse pesos fijos para una tarea claramente definida, pero deben establecerse antes de las pruebas de candidatos externos y acompañarse de un análisis de sensibilidad independiente.作者分析与复核建议 / Author analysis
Suplemento técnico C · La interpretación de fragmentos debe contrastarse con los efectos concomitantes de los cambios estructurales
Eliminar una subestructura modifica simultáneamente muchas propiedades fisicoquímicas, por lo que una disminución de la actividad experimental no implica necesariamente que ese fragmento reconozca directamente una diana específica. Este artículo propone considerar los cambios locales, las propiedades globales y las interferencias de medición como explicaciones paralelas, y distinguirlas mediante evidencia independiente apropiada. La interpretación del modelo puede priorizar controles informativos, pero no sustituir esas mediciones. Si el fragmento solo se elimina dentro del modelo, el resultado revela la dependencia del modelo; aunque también cambien los resultados experimentales, todavía deben examinarse las muestras y las condiciones antes de profundizar en el mecanismo.[1] Discovery of a structural class of antibiotics with exp
Suplemento técnico D · La selección de candidatos debe fijarse antes de la confirmación externa
Cribar repetidamente la misma biblioteca de validación la convierte gradualmente en retroalimentación para el entrenamiento. Este artículo recomienda fijar los candidatos, la ordenación y los umbrales después del último ajuste del modelo y someterlos después a mediciones independientes para su confirmación; deben guardarse previamente resúmenes de todas las predicciones para evitar que solo se publiquen los aciertos. También deben hacerse públicas estadísticas apropiadas sobre los esqueletos fallidos y los casos no medibles, para ayudar a investigaciones posteriores a comprender los límites. Así puede distinguirse la capacidad externa del propio método del éxito final tras un prolongado proceso humano de ensayo y error, sin negar la legitimidad de las iteraciones durante la exploración.作者分析与复核建议 / Author analysis
10. Conclusión: la priorización mediante IA debe contribuir a una evidencia química más fiable
El valor del descubrimiento de antibióticos mediante IA radica en aumentar la probabilidad de que recursos de medición limitados identifiquen direcciones químicas dignas de estudio, en lugar de convertir directamente candidatos computacionales en conclusiones farmacológicas. Este artículo vincula la interpretación estructural, las probabilidades de cribado y los niveles de validación, y subraya que cada éxito necesita denominadores exactos y evidencia independiente. Las mediciones y los logros preclínicos de los artículos originales corresponden a sus equipos originales; los contraejemplos analíticos de este artículo solo sirven para mejorar el diseño de la investigación. Los fracasos, los procesos de selección y las correcciones que puedan verificarse públicamente impulsarán el descubrimiento real más que el crecimiento continuo del número de candidatos predichos.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) La sensibilidad s, la tasa de falsos positivos f y la proporción π de candidatos que cumplen los criterios determinan conjuntamente la tasa de aciertos entre los seleccionados.
LaTeX
\operatorname{PPV}=\frac{s\pi}{s\pi+f(1-\pi)}(2) Proporción que cumple los criterios según las mediciones entre los primeros K candidatos con un presupuesto fijo; deben predefinirse la ordenación y el tratamiento de los casos no medibles.
LaTeX
\operatorname{Precision@K}=\frac1K\sum_{i=1}^{K}y_{(i)}(3) Similitud de Tanimoto para conjuntos de huellas binarias; los cambios en las definiciones de huella y esqueleto modifican el criterio de novedad.
LaTeX
T(A,B)=\frac{|A\cap B|}{|A\cup B|}(4) Cadena condicional de selección, posibilidad de medición y confirmación independiente; deben conservarse los denominadores completos en cada etapa.
LaTeX
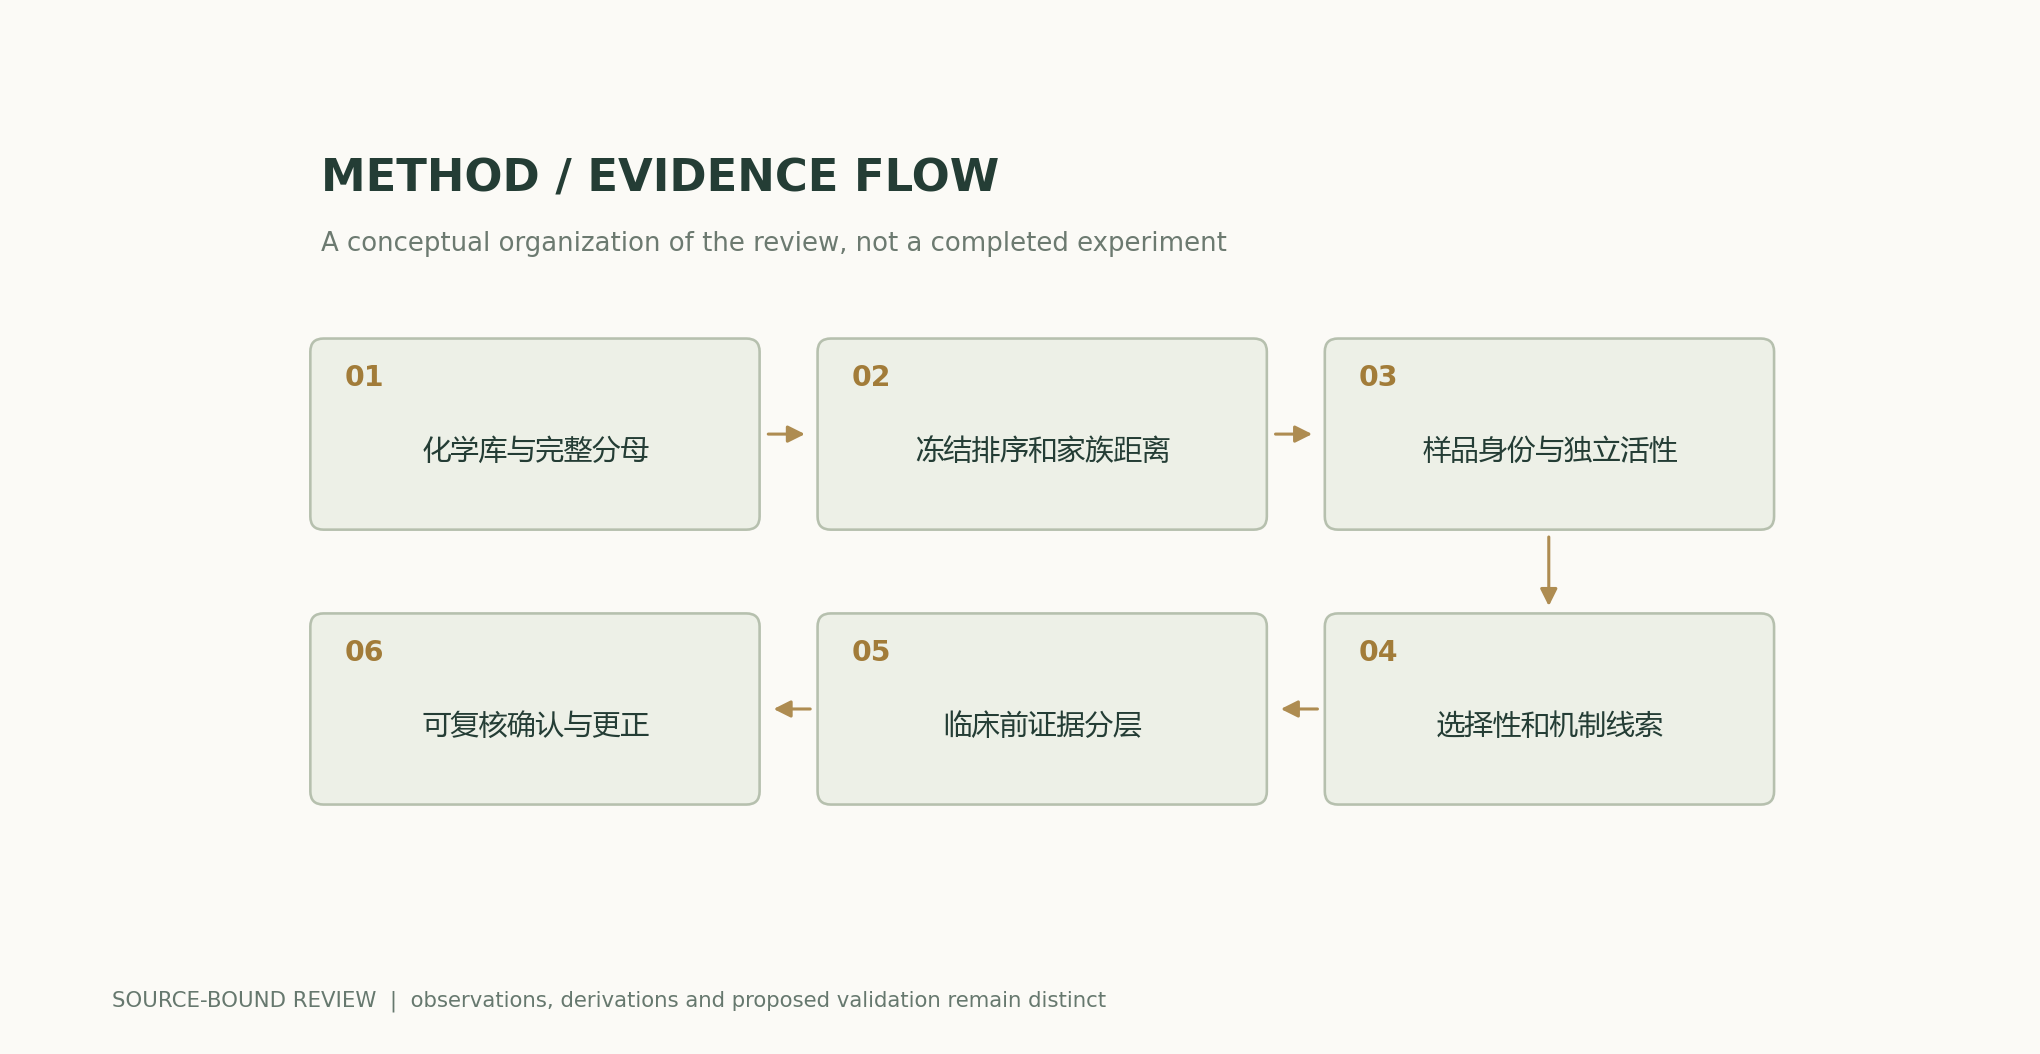
P(\mathrm{confirmed})=P(S)P(M\mid S)P(C\mid M,S)Flujo metodológico y de evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Cuando la proporción de candidatos activos es 1%, con s=0.8 y f=0.05, el PPV es aproximadamente 0.139130; cuando esa proporción es 10%, es aproximadamente 0.64. 20/50=40% y 20/100=20% utilizan denominadores distintos.
Comparación de métodos
| Nivel | Conclusión que puede respaldarse | Aún requiere demostración independiente |
|---|---|---|
| Puntuación computacional alta | Merece prioridad para su medición | Actividad real |
| Actividad medida | Efecto en condiciones especificadas | Comportamiento en condiciones amplias y selectividad |
| Interpretación de fragmentos estructurales | Indicios de asociaciones del modelo | Mecanismo sobre la diana |
| Mediciones de espectro reducido o del huésped | Selectividad entre los organismos medidos | Comportamiento en todos los entornos y a largo plazo |
| Modelo animal | Evidencia preclínica en ese modelo | Efectos en humanos |
| Proceso de descubrimiento | Resultados confirmados dentro del presupuesto | Aprobación clínica o recomendaciones terapéuticas |
Plan de verificación y experimentación
- Fijar la biblioteca de candidatos, la normalización estructural, la eliminación de duplicados y la partición por familias químicas.
- Prerregistrar los criterios de valoración de actividad y selectividad, conservando las condiciones de medición sin fusionar tareas distintas.
- Comunicar cinco denominadores: computados, disponibles, enviados a ensayo, medibles y confirmados.
- Evaluar la calibración y Precision@K con presupuesto fijo en esqueletos externos.
- Descartar interferencias de detección mediante muestras independientes y mediciones basadas en principios diferentes.
- Separar la interpretación de fragmentos, el acoplamiento, los indicios mecanísticos y la evidencia funcional.
- Utilizar familias y lotes como unidades estadísticas, conservando los casos no medibles y los resultados negativos.
- Publicar fuentes exactas y correcciones, mantener como desconocidas las propiedades no medidas y no formular afirmaciones de uso clínico.
Ámbito de aplicación y limitaciones
- Las probabilidades y el embudo de cribado de este artículo no son datos reales de rendimiento farmacológico.
- No se proponen, sintetizan ni prueban nuevos compuestos antibacterianos.
- La evidencia animal y mecanística de los estudios originales no puede trasladarse directamente a humanos.
- La novedad y la calibración dependen de la biblioteca de candidatos y de la representación estructural.
- Este artículo analiza la metodología de investigación y no proporciona orientación diagnóstica, terapéutica ni sobre procedimientos microbiológicos.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultados del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| 39,312 mediciones, 12,076,365 predicciones y 283 pruebas posteriores corresponden a etapas distintas. | Las cantidades computacionales no se consideran cantidades de descubrimientos medidos. | Descubrimiento de una clase estructural de antibióticos mediante aprendizaje profundo explicableResumen |
| Comunica un candidato de espectro reducido, indicios mecanísticos y evidencia de un modelo de herida en ratón. | No constituye eficacia clínica en humanos ni aprobación. | Descubrimiento guiado por aprendizaje profundo de un antibiótico dirigido contra Acinetobacter baumanniiResumen; caracterización |
Preguntas de investigación que merece la pena contrastar
- Manteniendo fija la distancia entre familias, ¿pueden los fragmentos interpretables mejorar la tasa de confirmación independiente?
- ¿Qué limita más los resultados de las bibliotecas químicas externas: el desajuste de calibración o la posibilidad de medir las muestras?
- Con presupuestos completamente equiparados, ¿mejora el cribado multiobjetivo la actividad y la selectividad confirmadas de forma independiente?
Correspondencia entre fuentes primarias y afirmaciones
- Discovery of a structural class of antibiotics with explainable deep learningWong et al. · 2023-12-2039,312 measured compounds; 12,076,365 predicted; 283 tested; preclinical activity and structural rationales.
- Deep learning-guided discovery of an antibiotic targeting Acinetobacter baumanniiLiu et al. · 2023-05-25Narrow-spectrum lead, LolE-related mechanism and mouse wound-model evidence; not a clinical approval.
- PoseBusters: AI-based docking methods fail to generate physically valid poses or generalise to novel sequencesButtenschoen, Morris and Deane · 2024Physical validity tests, benchmark scope and sequence novelty; not a benchmark of every later model.
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo contrastan las ecuaciones enumeradas y los supuestos explícitamente declarados. Este sitio todavía no dispone de una revisión por pares independiente de este artículo ni de registros de modelos originales o experimentos clínicos o físicos originales asociados a él.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; conserva las fuentes de cada sección y los límites entre la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas especifican, punto por punto, los supuestos y los criterios de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c