
要旨
学習モデルは広大な化学空間から測定に値する候補を優先的に選択できるが、予測、in vitro活性、作用機序、動物でのエビデンス、臨床的有用性は異なる階層に属する。本稿は、解釈可能なグラフモデルによって構造クラスを発見する研究と、狭域スペクトル候補abaucinに関する研究を比較し、スクリーニングの分母、構造的新規性、機序のエビデンスを分析する。候補の割合と分類誤差を仮定した計算を通じて、高順位が高いヒット率を保証せず、まして臨床的価値を直接示すものではないことを説明する。図表には実際の化合物、薬効、患者のデータは含まれず、本稿は治療上の推奨を提示しない。[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
原文の英語要旨の日本語訳
AI支援による抗生物質発見は化学的仮説を順位付けするものであり、測定された活性、選択性、機序、臨床的有用性はそれぞれ独立した評価項目である。本稿は、説明可能なグラフモデルによる発見と、狭域スペクトルのabaucin研究を比較する。有病率に相当する候補中の陽性割合に依存した適合率の計算により、高い順位付けスコアでもスクリーニングのヒット率が限定的となり得る理由を説明し、骨格選択の分析によって新規性と活性を分離する。数値による例示にはすべて仮想的な化合物と確率を用いる。治療用に提案する分子はなく、抗微生物実験も実施していない。
1. 化学空間の探索規模は実験的エビデンスの規模ではない
説明可能な抗生物質研究では、約四万化合物の測定、約千二百万化合物の予測、283候補の追加試験が区別されている。これらの数量はそれぞれ学習、計算、検証に属し、合算して実験的発見数とすることはできない。本稿は、候補ライブラリの版、構造の重複除去、実際に試験へ提出した集合に基づいて分母表を作成することを提案する。試験に成功した化合物のみを公表すれば、読者は順位付けの効率を推定できない。高得点の候補をすべて抗生物質と呼べば、最も重要な測定段階を飛ばすことになる。ここでのモデルはまず候補の優先順位付けの道具であり、その価値は選択過程全体を通して検証すべきである。[1] Discovery of a structural class of antibiotics with exp
2. 構造の解釈は検証可能な手掛かりを与えるが、標的を介した機序の証明には至らない
Wongらの研究は、グラフ手法を用いて活性と低い細胞毒性に関連する構造的手掛かりを探索し、候補クラスを実験的に評価した。部分構造の解釈は化学ファミリーの比較や後続の仮説の提案に役立つが、関連するフラグメントは、溶解性、吸収、測定干渉、その他の性質とも同時に関連している可能性がある。本稿は、「モデルがこのフラグメントに依存する」「このフラグメントが実験的活性を変える」「このフラグメントが特定の標的を介して作用する」を三つの主張として分けるべきだと論じる。フラグメントの削除・変更に対するモデルの応答が支持するのは第一の主張のみであり、後二者には対応する独立測定と代替説明の排除が必要である。[1] Discovery of a structural class of antibiotics with exp
3. 狭域スペクトル候補は成功の評価項目を変える
abaucin研究はAcinetobacter baumanniiを対象とし、スクリーニングとモデルによる優先順位付けを通じて候補を提示したうえで、狭域スペクトル活性、LolEに関連する機序の手掛かり、マウス創傷モデルでのエビデンスをさらに検討した。狭域スペクトルと広域スペクトルは単純な優劣関係ではなく、異なる選択性の問いに答えるものである。本稿では、標的菌、非標的菌、宿主関連の測定、条件を別々に記録する。ある条件で他の対象を阻害しないことは、すべての環境での選択性を証明しない。原研究の前臨床エビデンスはヒトでの有効性や臨床承認と同義ではなく、後者をモデルの名称や動物の結果から補うことはできない。[2] Deep learning-guided discovery of an antibiotic targeti
4. 本稿の導出:活性候補の希少性が陽性的中率を制限する
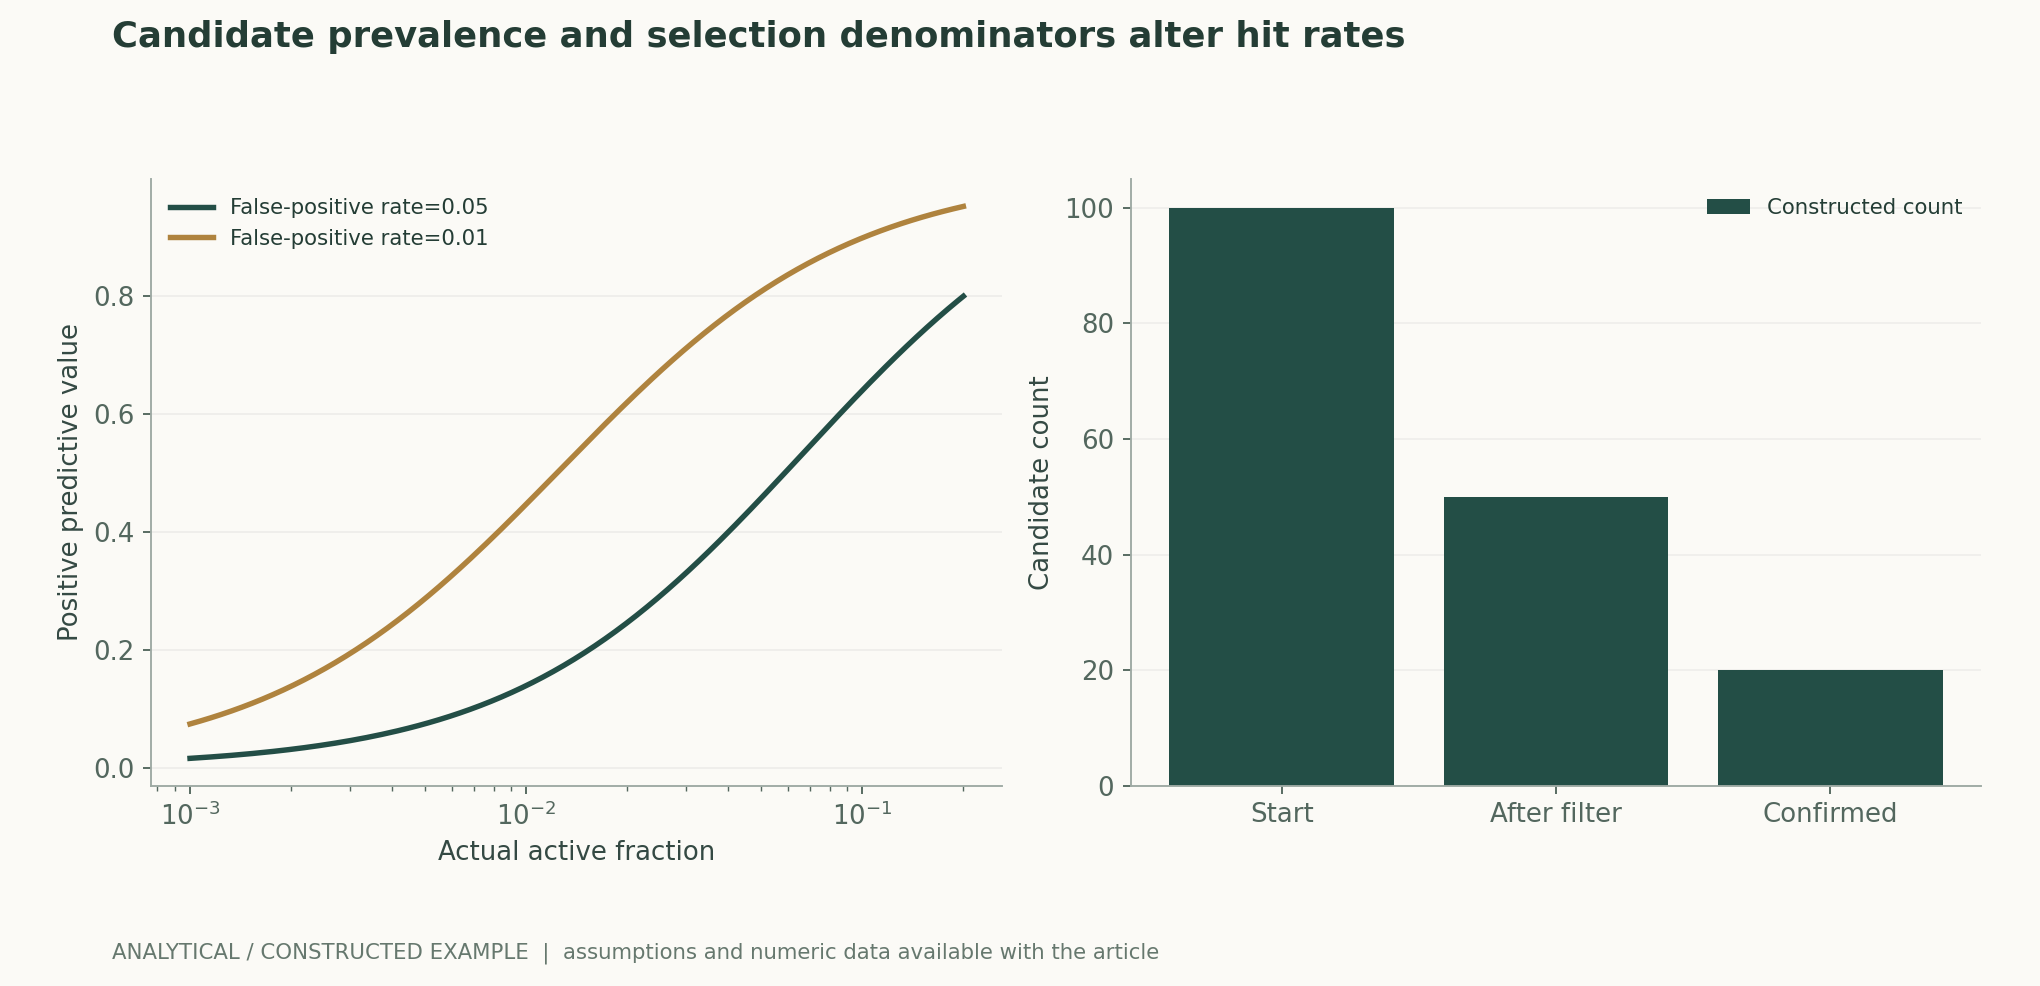
候補ライブラリで真に基準を満たす割合をπ、スクリーニングの感度を0.8、偽陽性率を0.05とする。π=1%のとき、選択された候補の真陽性割合は約13.9%であり、π=10%のときは約64.0%となる。分類規則が完全に同じでも、化学ライブラリと選択条件の変化によってヒット率は大きく変わり得る。図は陽性割合と閾値による誤りを並べ、すべての確率が構成した入力であることを明示する。この関係は、学習集合の正解率をそのまま流用するのではなく、外部候補ライブラリで較正を再評価すべきことを研究者に示している。高いAUROCだけでも、固定された実験予算下で上位候補のヒット率を決定することはできない。作者分析与复核建议 / Author analysis
5. 本稿の分析:骨格の新規性と分布外での信頼性には緊張関係がある
既知のクラスと異なる化合物を見つけるため、研究者はしばしば新しい骨格を意図的に優先する。しかし、学習時の化学空間から遠ざかるほど、モデルの較正が損なわれる可能性もある。本稿は、化学ファミリーと学習ライブラリからの距離の両方に基づいて順位付けの利得を報告することを提案する。新規性は大きいほどよいという一次元の目標ではない。全く未知の構造は測定が難しい可能性があり、既知の骨格に対する局所的な変化でも価値ある選択性を生み得る。比較では、新規性の計算、重複除去、ファミリー分類を事前に定義し、成功を観察してから最も新規に見える類似度基準を選ぶべきではない。作者分析与复核建议 / Author analysis
6. 活性の評価項目は具体的な測定条件と結び付けなければならない
増殖阻害、殺菌、作用速度、トレランスなどは異なる評価項目であり、候補の濃度、培養環境、試料の性質はいずれも解釈に影響する。本稿は微生物実験の操作手順を提供するものではなく、研究記録に正確な評価項目と条件を保存する必要性を強調する。化合物の凝集、蛍光、その他の検出干渉はアーティファクトを生む可能性があり、元の検出原理とは異なる測定によって排除しなければならない。モデルの順位付けがある条件に基づく場合、別の条件への移行は新しい課題として評価すべきであり、すべての「活性」を一つの汎用ラベルにまとめるべきではない。[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
7. ドッキングと構造図は仮説の補助的根拠にとどまる
機序の説明には分子構造やドッキング図がよく添えられるが、PoseBustersは、座標の類似性に加えて化学的妥当性の確認が必要であると指摘している。候補が特定のポケット内で妥当なポーズを取れるとしても、それだけでは真の標的、親和性、細胞内への移行能力を証明できない。本稿は、ドッキング、遺伝学的手掛かり、結合測定、細胞表現型を別々の欄に示すことを提案する。各欄は仮説を支持し得るが、欄をまたいで自動的に証拠の水準を引き上げることはできない。異なるエビデンスが矛盾する場合は、化学状態、測定条件、代替標的を検討し、最も見栄えのよい構造図によって陰性結果を退けるべきではない。[3] PoseBusters: AI-based docking methods fail to generate [2] Deep learning-guided discovery of an antibiotic targeti
8. 本稿の導出:検証集合の選択は報告可能なヒット率を変える
ある順位付け器が上位100候補を試験し、20件がヒットしたとする。別の手順では、まず明らかに困難な50件を人手で除外し、残る50件から同じく20件のヒットを得たとする。上位試料のヒット率は40%と表せるが、当初の予算を起点とした率は依然として20%である。本稿では選択ファネルを用い、計算対象ライブラリ、入手可能なライブラリ、試験提出ライブラリ、実際に測定可能なライブラリを区別して記録する。購入不能、試料品質の不足、判定不能は別々に記録すべきであり、隠すことも、すべてをモデルの責任とすることもできない。異なる発見手順を比較できるのは、完全な分母がある場合のみである。作者分析与复核建议 / Author analysis
9. 同一測定の反復的な最適化よりも独立した確認の方が説得力を持つ
モデルは同じ評価項目を反復的に最適化することで測定特性に適応し得るため、固定したうえで新しいバッチや新しい供給源の試料を検証する必要がある。本稿は、独立した化学ファミリーとバッチを比較単位とし、事前登録した条件で確認された活性と選択性を主要評価項目とし、機序の支持と費用を別途報告することを提案する。候補の細胞毒性やその他の性質を予測器だけで判定することはできず、未測定のものは未知のままにしなければならない。耐性や長期効果などの結論については、観察期間と試料範囲を明示し、限定的な実験によって無期限の持続性を支持すべきではない。作者分析与复核建议 / Author analysis
技術補足 A · 化合物データの分割は近傍間の情報漏洩を防ぐ必要がある
同一骨格の塩形、立体異性体、小さな修飾が学習集合とテスト集合にまたがる可能性があるため、化合物のランダム分割は新しいクラスへの能力を過大評価し得る。本稿は、まず標準化と同一性の規則を固定し、その後、骨格と類似ファミリーごとにグループ化するとともに、最も近い学習化合物の情報を保持することを提案する。特定の性質が立体化学に敏感な場合、重複除去の便宜のためにそれらをすべて統合してはならない。学習ファミリー外のテストでも、入手可能性と測定条件が同等かを確認すべきである。そうでなければ、性能の変化に試料の偏りが混入し、化学的汎化のみを反映しない可能性がある。作者分析与复核建议 / Author analysis
技術補足 B · 多目的スクリーニングでは未測定の性質を未知のまま保持する必要がある
候補の活性、選択性、宿主関連の影響、入手可能性は互いに対立し得る。複数の予測スコアを重み付きの単一値に集約するとトレードオフが隠れ、重みが恣意的に優勝者を決める可能性もある。本稿は、まず最低限の制約を満たす候補集合を示し、その後パレートフロンティアと実測による支持を比較することを提案する。未測定の次元は未知と記し、別の項目の良好なスコアで相殺してはならない。明確な課題には固定重みを利用できるが、外部候補の試験前に決定し、別途感度分析を行う必要がある。作者分析与复核建议 / Author analysis
技術補足 C · フラグメントの解釈は構造変更に伴う副次的影響と照合する必要がある
部分構造を一つ削除すると多くの物理化学的性質が同時に変わるため、実験的活性の低下は、そのフラグメントが特定の標的を直接認識することを必ずしも意味しない。本稿は、局所的変化、全体的性質、測定干渉を並列の説明として扱い、適切な独立したエビデンスによって区別することを提案する。モデルの解釈は情報量の多い対照を優先的に選べるが、これらの測定に代わることはできない。モデル内でのみフラグメントを削除した場合、得られるのはモデルの依存性である。実験でも変化が生じたとしても、機序をさらに論じるには試料と条件の確認がなお必要である。[1] Discovery of a structural class of antibiotics with exp
技術補足 D · 外部確認の前に候補選択を固定すべきである
同一の検証ライブラリを繰り返しスクリーニングすると、それは徐々に学習へのフィードバックとなる。本稿は、最後のモデル調整後に候補、順位、閾値を固定し、独立した測定に委ねて確認することを提案する。ヒットした対象のみの公表を防ぐため、すべての予測の概要を事前に保存する。失敗した骨格や測定不能な対象についても適切な統計を公開し、後続研究が限界を理解できるようにすべきである。これにより、探索段階で本来妥当な反復を否定することなく、手法自体の外部での能力と、長期にわたる人手の試行錯誤の末の最終的成功を区別できる。作者分析与复核建议 / Author analysis
10. 結論:AIによる優先順位付けは、より信頼できる化学的エビデンスに資するべきである
AIによる抗生物質発見の価値は、計算上の候補をそのまま薬剤に関する結論へ変えることではなく、限られた測定資源によって研究に値する化学的方向性を見いだす可能性を高めることにある。本稿は、構造の解釈、スクリーニング確率、検証の階層を結び付け、個々の成功に正確な分母と独立したエビデンスが必要であることを強調する。原論文の測定と前臨床成果は原研究チームに帰属し、本稿の解析的反例は研究設計の改善にのみ用いられる。公開され再検証可能な失敗、選択過程、訂正は、拡大し続ける予測候補数よりも、実質的な発見を促進する。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 感度s、偽陽性率f、候補が基準を満たす割合πが、選択候補のヒット率を共同で決定する。
LaTeX
\operatorname{PPV}=\frac{s\pi}{s\pi+f(1-\pi)}(2) 固定予算下の上位K候補のうち、実測で基準を満たす割合。順位付けと測定不能例の扱いは事前に定義しなければならない。
LaTeX
\operatorname{Precision@K}=\frac1K\sum_{i=1}^{K}y_{(i)}(3) 二値フィンガープリント集合のTanimoto類似度。フィンガープリントと骨格の定義を変えると、新規性の評価基準も変わる。
LaTeX
T(A,B)=\frac{|A\cap B|}{|A\cup B|}(4) 選択、測定可能性、独立した確認という条件付きの連鎖。各段階で完全な分母を保持すべきである。
LaTeX
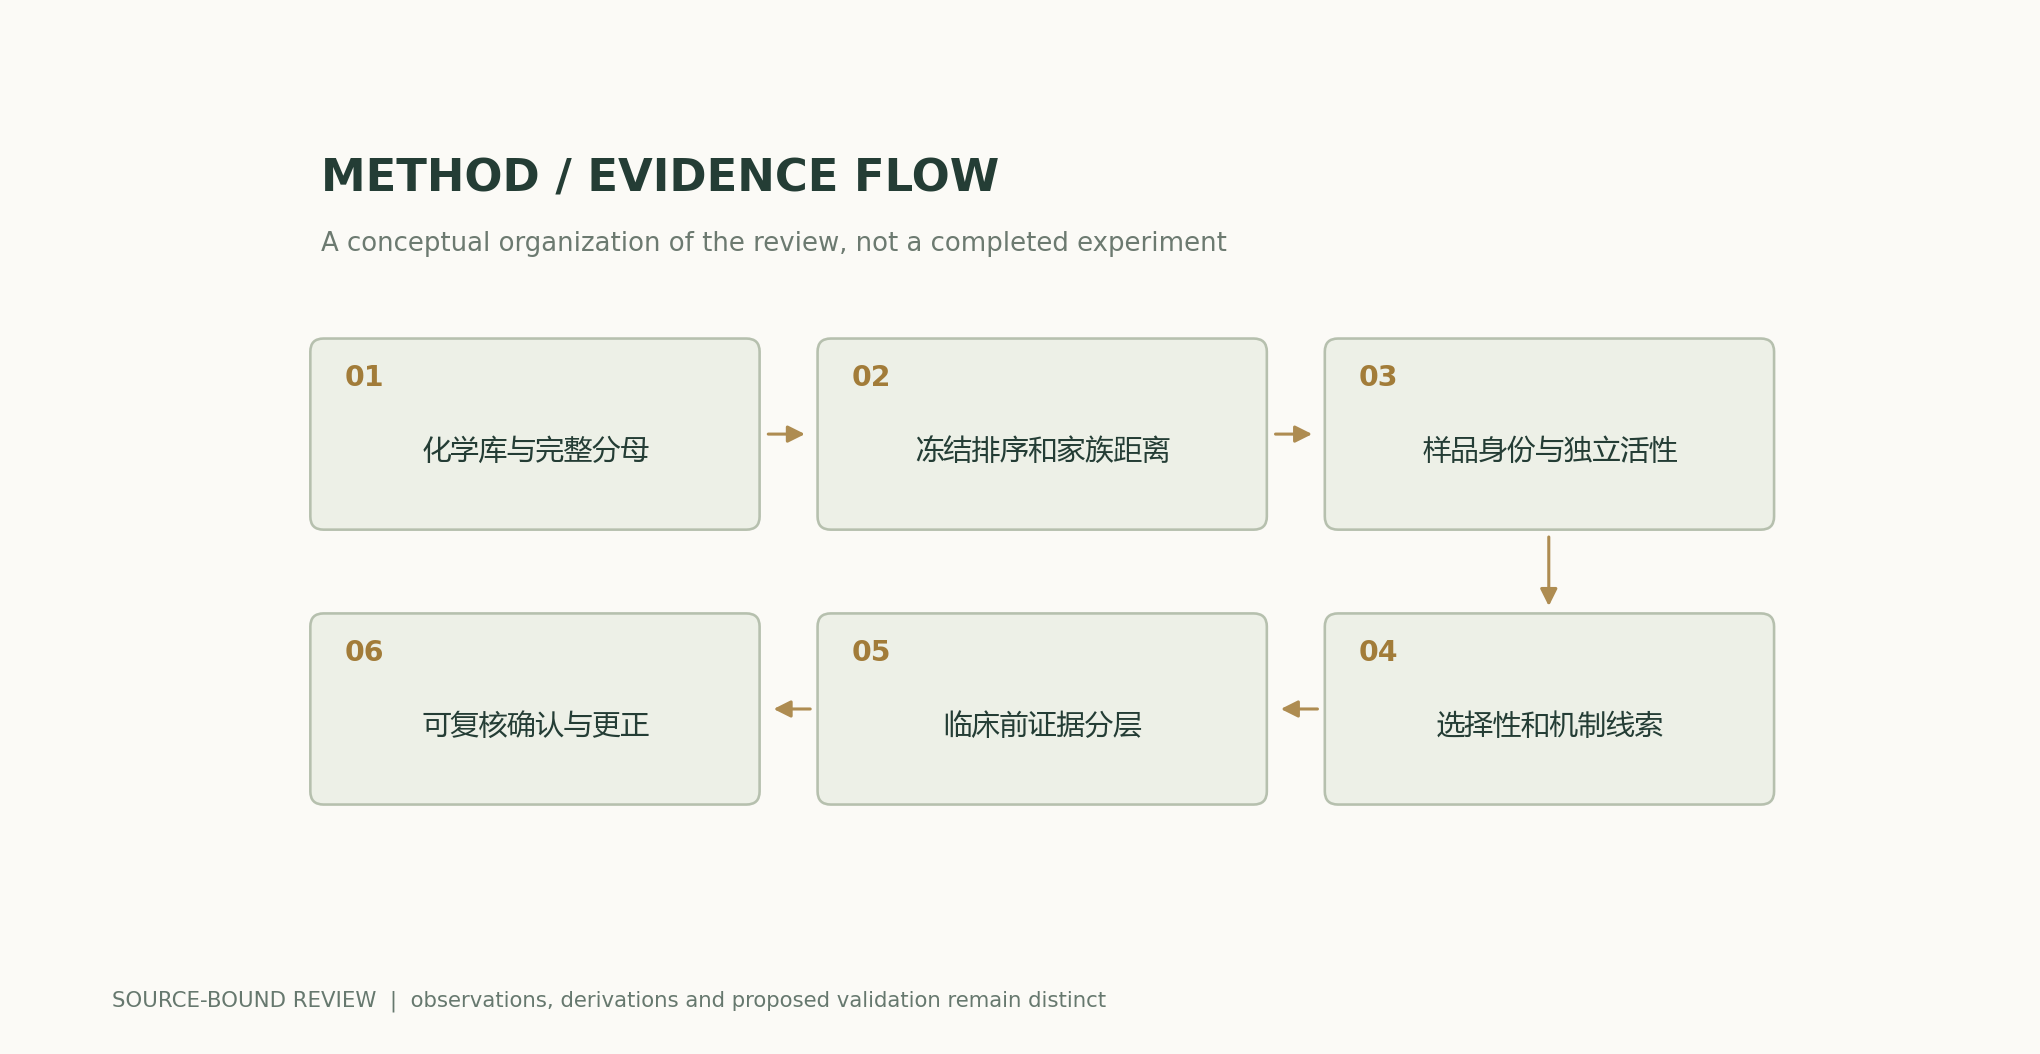
P(\mathrm{confirmed})=P(S)P(M\mid S)P(C\mid M,S)方法とエビデンスの流れ
解析図と数値例
再計算可能な計算例
活性を持つ候補の割合が1%で、s=0.8かつf=0.05のとき、PPVは約0.139130となる。その割合が10%のときは約0.64となる。20/50=40%と20/100=20%では分母が異なる。
方法の比較
| 階層 | 支持できる結論 | なお独立した証明が必要な事項 |
|---|---|---|
| 計算上の高得点 | 優先的に測定する価値 | 真の活性 |
| 実測された活性 | 指定条件下での効果 | 幅広い条件での挙動と選択性 |
| 構造フラグメントの解釈 | モデル内の関連性の手掛かり | 標的を介した機序 |
| 狭域スペクトルまたは宿主に関する測定 | 測定済み対象間での選択性 | あらゆる環境および長期での挙動 |
| 動物モデル | 当該モデルでの前臨床エビデンス | ヒトでの効果 |
| 発見の手順 | 予算内で確認された成果 | 臨床承認または治療上の推奨 |
再検証と実験の計画
- 候補ライブラリ、構造の標準化、重複除去、化学ファミリーの分類を固定する。
- 活性と選択性の評価項目を事前登録し、異なる課題を統合せず測定条件を保存する。
- 計算対象、入手可能、試験提出、測定可能、確認済みという五つの分母を報告する。
- 外部骨格で較正と固定予算下のPrecision@Kを評価する。
- 独立した試料と異なる原理の測定によって検出干渉を排除する。
- フラグメントの解釈、ドッキング、機序の手掛かり、機能的エビデンスを分ける。
- ファミリーとバッチを統計単位とし、測定不能例と陰性結果を保持する。
- 正確な出典と訂正を公開し、未測定の性質は未知のまま保持し、臨床使用に関する主張を行わない。
適用範囲と限界
- 本稿の確率とスクリーニングファネルは、実際の薬剤性能データではない。
- 新規抗菌化合物の提案、合成、試験は行っていない。
- 原研究の動物および機序に関するエビデンスをヒトへ直接移転することはできない。
- 新規性と較正は候補ライブラリおよび構造表現に依存する。
- 本稿は研究方法の分析であり、診療や微生物操作の指針を提供しない。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 39,312件の測定、12,076,365件の予測、283件の追加試験は異なる段階に属する。 | 計算対象数を実測による発見数とみなさない。 | 説明可能な深層学習による抗生物質の構造クラスの発見要旨 |
| 狭域スペクトル候補、機序の手掛かり、マウス創傷モデルのエビデンスを報告している。 | ヒトでの臨床効果や承認を示すものではない。 | 深層学習に導かれたAcinetobacter baumanniiを標的とする抗生物質の発見要旨;特性評価 |
検証に値する研究課題
- ファミリー間距離を固定した場合、解釈可能なフラグメントは独立した確認率を高められるか。
- 較正の不整合と試料の測定可能性のどちらが、外部化学ライブラリから得られる成果をより強く制限するか。
- 予算全体を一致させた場合、多目的スクリーニングは独立に確認された活性と選択性を改善するか。
一次資料と主張の対応
- Discovery of a structural class of antibiotics with explainable deep learningWong et al. · 2023-12-2039,312 measured compounds; 12,076,365 predicted; 283 tested; preclinical activity and structural rationales.
- Deep learning-guided discovery of an antibiotic targeting Acinetobacter baumanniiLiu et al. · 2023-05-25Narrow-spectrum lead, LolE-related mechanism and mouse wound-model evidence; not a clinical approval.
- PoseBusters: AI-based docking methods fail to generate physically valid poses or generalise to novel sequencesButtenschoen, Morris and Deane · 2024Physical validity tests, benchmark scope and sequence novelty; not a benchmark of every later model.
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典を伴う研究レビューと独自の解析である。原論文の実験は原研究チームに帰属し、本稿の計算は記載した数式と明示した仮定のみを検証する。当サイトには現時点で、本稿に対する独立した査読、または本稿に関する独自モデル、臨床実験、物理実験の記録はない。
初出:AIと科学的発見に関する詳細特集。各節の出典を保持し、原研究のエビデンスと著者の解析の境界を明確にする。
概念的な表紙はImageGenが生成した。科学図は付属のコードと数値ファイルを用いて作成し、図注では仮定と測定基準を項目ごとに説明している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・版の履歴
ソースの改訂: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c