
摘要
学习模型可以在大化学空间中优先选择值得测量的候选,但预测、体外活性、作用机制、动物证据与临床效用属于不同层级。本文比较可解释图模型发现结构类别的研究与窄谱候选 abaucin 的工作,分析筛选分母、结构新颖性与机制证据。通过假定候选比例和分类误差的计算,我们说明高排名并不保证高命中,更不能直接说明临床价值。图表没有真实化合物、药效或患者数据,本文不提出治疗建议。[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
English abstract
AI-assisted antibiotic discovery ranks chemical hypotheses; measured activity, selectivity, mechanism and clinical usefulness remain separate endpoints. We compare explainable graph-model discovery with the narrow-spectrum abaucin study. A prevalence-dependent precision calculation explains why high ranking scores can yield modest screening hit rates, while a scaffold-selection analysis separates novelty from activity. All numerical illustrations use hypothetical compounds and probabilities. No molecule is proposed for treatment and no antimicrobial experiment is performed.
1. 化学空间的搜索规模不是实验证据规模
解释型抗生素研究区分了约四万化合物的测量、约一千二百万化合物的预测与 283 个候选的后续测试。这些数量分别属于训练、计算和验证,不能相加成实验发现数。本文建议以候选库版本、结构去重和实际送验集合构建分母表。若只公布测试成功的化合物,读者无法估计排序效率;若把所有高分候选称为抗生素,则跳过了最关键的测量层。模型在这里首先是候选优先级工具,其价值应由完整选择过程检验。[1] Discovery of a structural class of antibiotics with exp
2. 结构解释给出可检验线索,但还不是靶点机制
Wong 等人的研究用图方法寻找与活性及低细胞毒性相关的结构线索,并对候选类别作实验评价。子结构解释能够帮助比较化学家族和提出后续假说,但相关片段可能同时关联溶解性、吸收、测量干扰或其他性质。本文主张将“模型依赖该片段”“该片段改变实验活性”和“该片段通过某靶点发挥作用”分成三种主张。删改片段的模型响应只支持第一种,后两种需要相应独立测量与替代解释排除。[1] Discovery of a structural class of antibiotics with exp
3. 窄谱候选改变了成功终点
Abaucin 研究面向鲍曼不动杆菌,通过筛选与模型优选提出候选,并进一步研究窄谱活性及与 LolE 相关的机制线索和小鼠伤口模型证据。窄谱与广谱并非简单优劣排序,它们回答不同选择性问题。本文将目标菌、非目标菌、宿主相关测量与条件分别登记;某条件下不抑制其他对象不能证明所有环境中的选择性。原研究的临床前证据不等同于人类有效性或临床批准,后者不能由模型名称或动物结果补出。[2] Deep learning-guided discovery of an antibiotic targeti
4. 本文推导:稀少活性候选限制阳性预测值
设候选库中真实达标比例为 π,筛选敏感度 0.8、假阳性率 0.05。在 π=1% 时,入选候选的真阳性比例约 13.9%;π=10% 时约 64.0%。即使分类规则完全相同,化学库与选择条件改变也会显著改变命中率。图将比例和阈值误差并列,明确所有概率都是构造输入。这个关系提醒研究者在外部候选库上重新评估校准,而不是直接沿用训练集上的准确率。高 AUROC 也不能单独确定固定实验预算下的前排命中率。作者分析与复核建议 / Author analysis
5. 本文分析:骨架新颖性与分布外可靠性存在张力
为了找到不同于已知类别的化合物,研究者往往主动偏好新骨架;但离训练化学空间更远,也可能降低模型校准。本文提出同时按化学家族和与训练库的距离报告排序收益。新颖性不是越大越好的一维目标:完全陌生结构可能难以测量,已知骨架上的局部变化也可能产生有价值的选择性。比较应预定义新颖性计算、去重与家族划分,不在观察到成功后才挑选最显得新颖的相似度口径。作者分析与复核建议 / Author analysis
6. 活性终点必须绑定具体测量条件
抑制增长、杀灭、作用速度和耐受等是不同终点;候选浓度、培养环境和样品性质都影响解释。本文不提供微生物实验操作,而强调研究记录需保存准确终点与条件。化合物聚集、荧光或其他检测干扰可能产生假象,必须通过与原检测原理不同的测量排除。若模型排序是基于一个条件,迁移到另一个条件则应作为新任务评价,而不是将所有“活性”合并为一个通用标签。[1] Discovery of a structural class of antibiotics with exp[2] Deep learning-guided discovery of an antibiotic targeti
7. 对接与结构图只处于辅助假说层
机制解释常配合分子结构或对接图,但 PoseBusters 指出坐标相似还需检查化学有效性。即使候选能在某个口袋形成合理姿态,也不能独立证明真实靶点、亲和力和细胞进入能力。本文建议把对接、遗传线索、结合测量和细胞表型分栏显示;每一栏都可以支持假说,却不能跨栏自动升级。若不同证据冲突,应检查化学状态、测量条件及替代靶点,不以最漂亮的一张结构图压过负结果。[3] PoseBusters: AI-based docking methods fail to generate [2] Deep learning-guided discovery of an antibiotic targeti
8. 本文推导:验证集选择会改变可报告的命中率
假设某排序器测试前 100 个候选,命中 20 个;另一个流程先人工排除 50 个明显困难对象,再在剩余 50 个中命中同样 20 个。前排样品命中率可以写成 40%,但原始预算起点仍是 20%。本文用选择漏斗记录计算库、可获得库、送验库与实际可测库的区别。无法购买、样品质量不足与不可判定应分别登记,既不能隐去,也不能全部归责模型。只有完整分母才能比较不同发现流程。作者分析与复核建议 / Author analysis
9. 独立确认比反复优化同一测量更有说服力
模型可以通过反复优化同一终点适应测量特性,因而需要冻结后再检验新批次或新来源样品。本文提出以独立化学家族和批次为比较单位,主要终点为预注册条件下的确认活性与选择性,另报机制支持和成本。候选的细胞毒性或其他性质不能只由预测器判定;尚未测量应保持未知。对耐药性与长期效果等结论,观察窗口和样本范围必须明确,不用一项有限实验支持无限持久性。作者分析与复核建议 / Author analysis
技术补充 A · 化学拆分要阻止近邻泄漏
同骨架的盐型、立体异构和小修饰可能跨训练测试,随机化合物切分因此可能夸大对新类别的能力。本文建议先固定标准化和身份规则,再按骨架与相似家族分组,并保留最近训练邻居。若某些性质对立体化学敏感,不能为方便去重而把它们全部合并。家族外测试也应检查可获得性和测量条件是否相当,否则性能变化可能混入样品偏差,而非单纯反映化学泛化。作者分析与复核建议 / Author analysis
技术补充 B · 多目标筛选需要保留未测性质
一个候选的活性、选择性、宿主相关影响与可获得性可以互相冲突。将多个预测分数加权成单值会隐去取舍,权重又可能人为决定优胜者。本文建议先展示满足最低约束的候选集合,再比较 Pareto 前沿与实测支持;没有测量的维度标为未知,不能由另一项好分数抵消。固定权重可用于明确任务,但必须在外部候选测试前确定,并另做敏感性分析。作者分析与复核建议 / Author analysis
技术补充 C · 片段解释需对照结构改变的副作用
删除一个子结构同时改变许多物理化学性质,实验活性下降不一定说明该片段直接识别特定靶点。本文提出把局部变化、整体性质和测量干扰作为并列解释,并通过适当独立证据区分。模型解释可优先选择有信息量的对照,但不能代替这些测量。若只在模型内删除片段,得到的是模型依赖性;若实验也变化,仍需检查样品和条件,才能进一步讨论机制。[1] Discovery of a structural class of antibiotics with exp
技术补充 D · 外部确认应冻结候选选择
反复筛选同一验证库,会让它逐渐成为训练反馈。本文建议在最后一次模型调整后冻结候选、排序和阈值,再交由独立测量确认;所有预测先保存摘要,防止只发布命中对象。失败的骨架和不可测对象也应公开适当统计,帮助后续研究理解边界。这样才能区分方法本身的外部能力与长期人工试错后的最终成功,而不否定探索阶段本来合理的迭代。作者分析与复核建议 / Author analysis
10. 结论:AI 优选应服务于更可靠的化学证据
AI 抗生素发现的价值在于让有限测量资源更有可能找到值得研究的化学方向,而不是让计算候选直接变成药物结论。本文将结构解释、筛选概率与验证层级连接起来,强调每次成功都需要准确分母和独立证据。原论文的测量与临床前成果归原团队,本文的解析反例只用于改进研究设计。可公开复核的失败、选择过程和更正,将比不断扩大的预测候选数字更能推动真实发现。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 敏感度 s、假阳性率 f 和候选达标比例 π 共同决定入选命中率。
LaTeX
\operatorname{PPV}=\frac{s\pi}{s\pi+f(1-\pi)}(2) 固定预算前 K 个候选的实测达标比例,排序和不可测处理必须预定义。
LaTeX
\operatorname{Precision@K}=\frac1K\sum_{i=1}^{K}y_{(i)}(3) 二元指纹集合的 Tanimoto 相似度;指纹与骨架定义改变会改变新颖性口径。
LaTeX
T(A,B)=\frac{|A\cap B|}{|A\cup B|}(4) 入选、可测、独立确认的条件链;各阶段应保留完整分母。
LaTeX
P(\mathrm{confirmed})=P(S)P(M\mid S)P(C\mid M,S)方法与证据流程
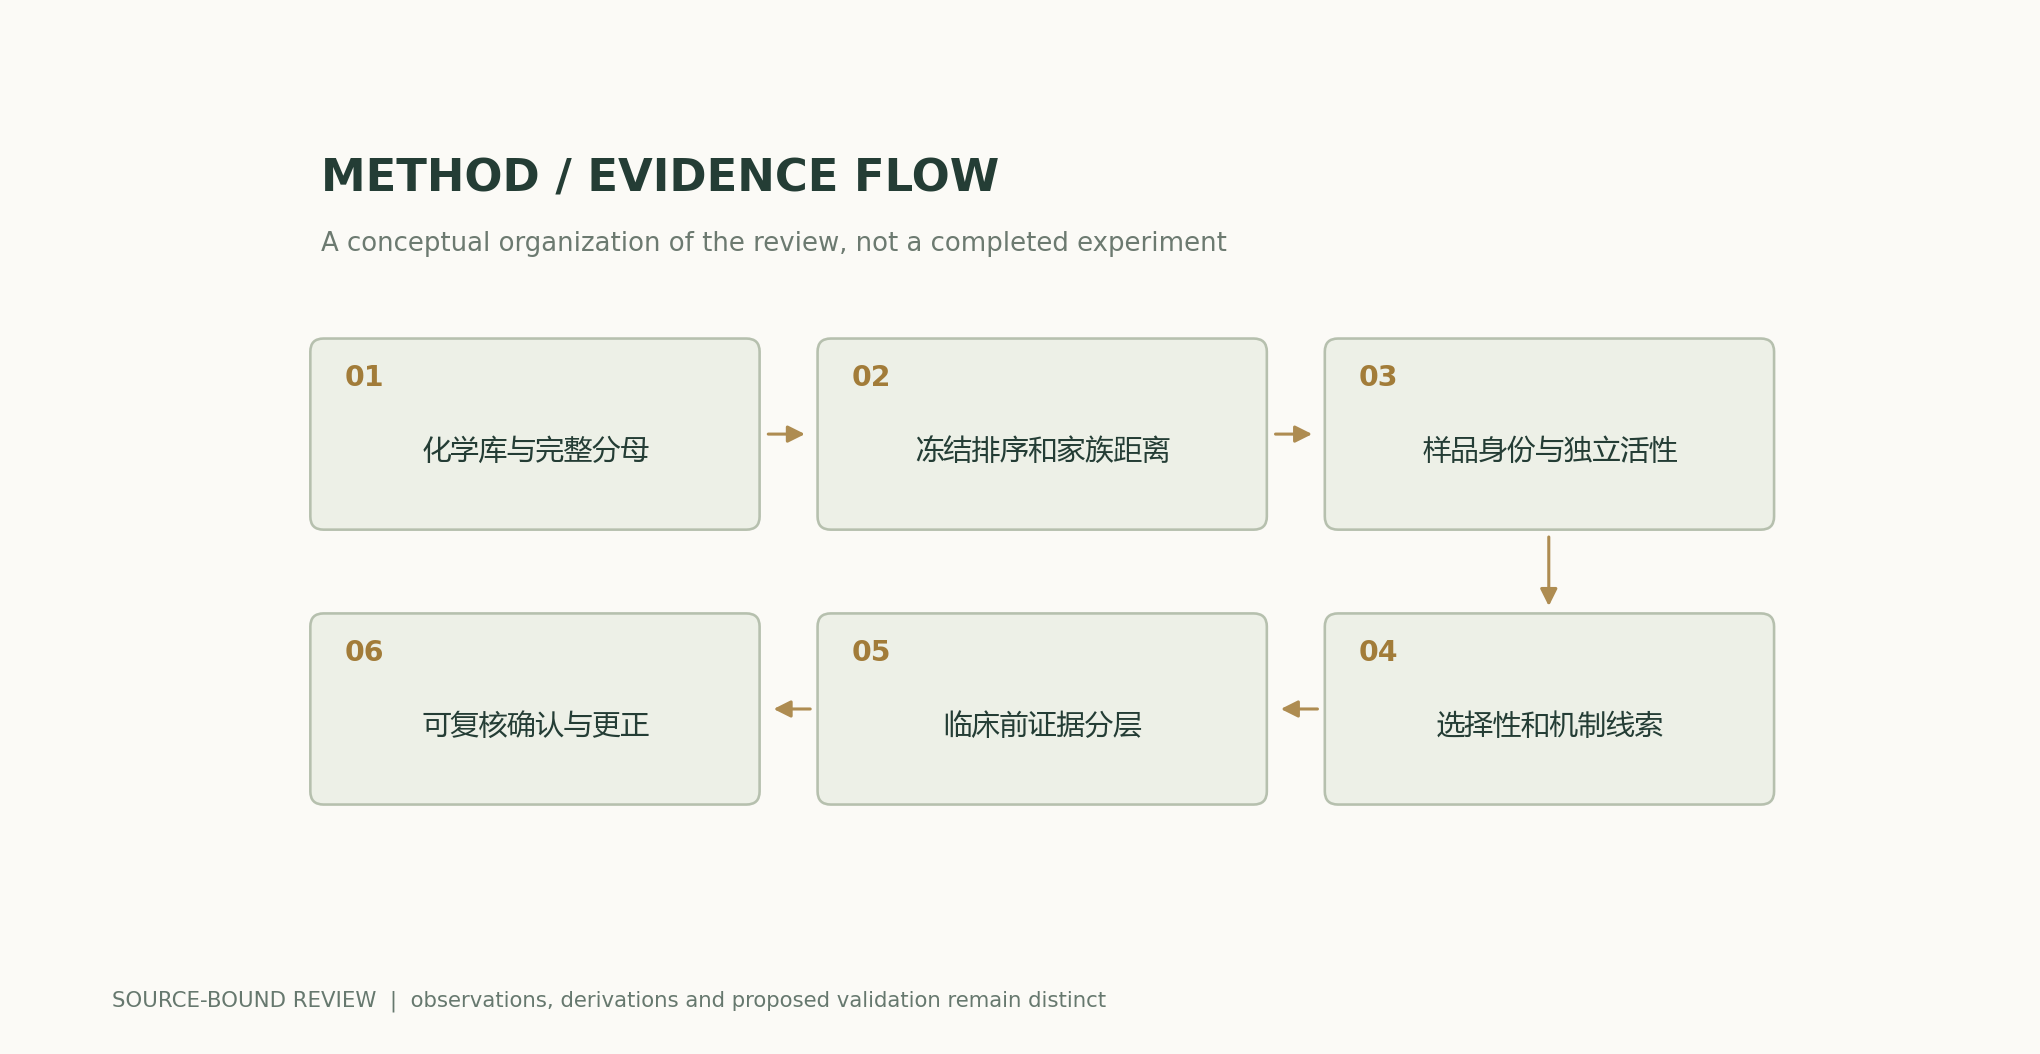
解析图与数值示例
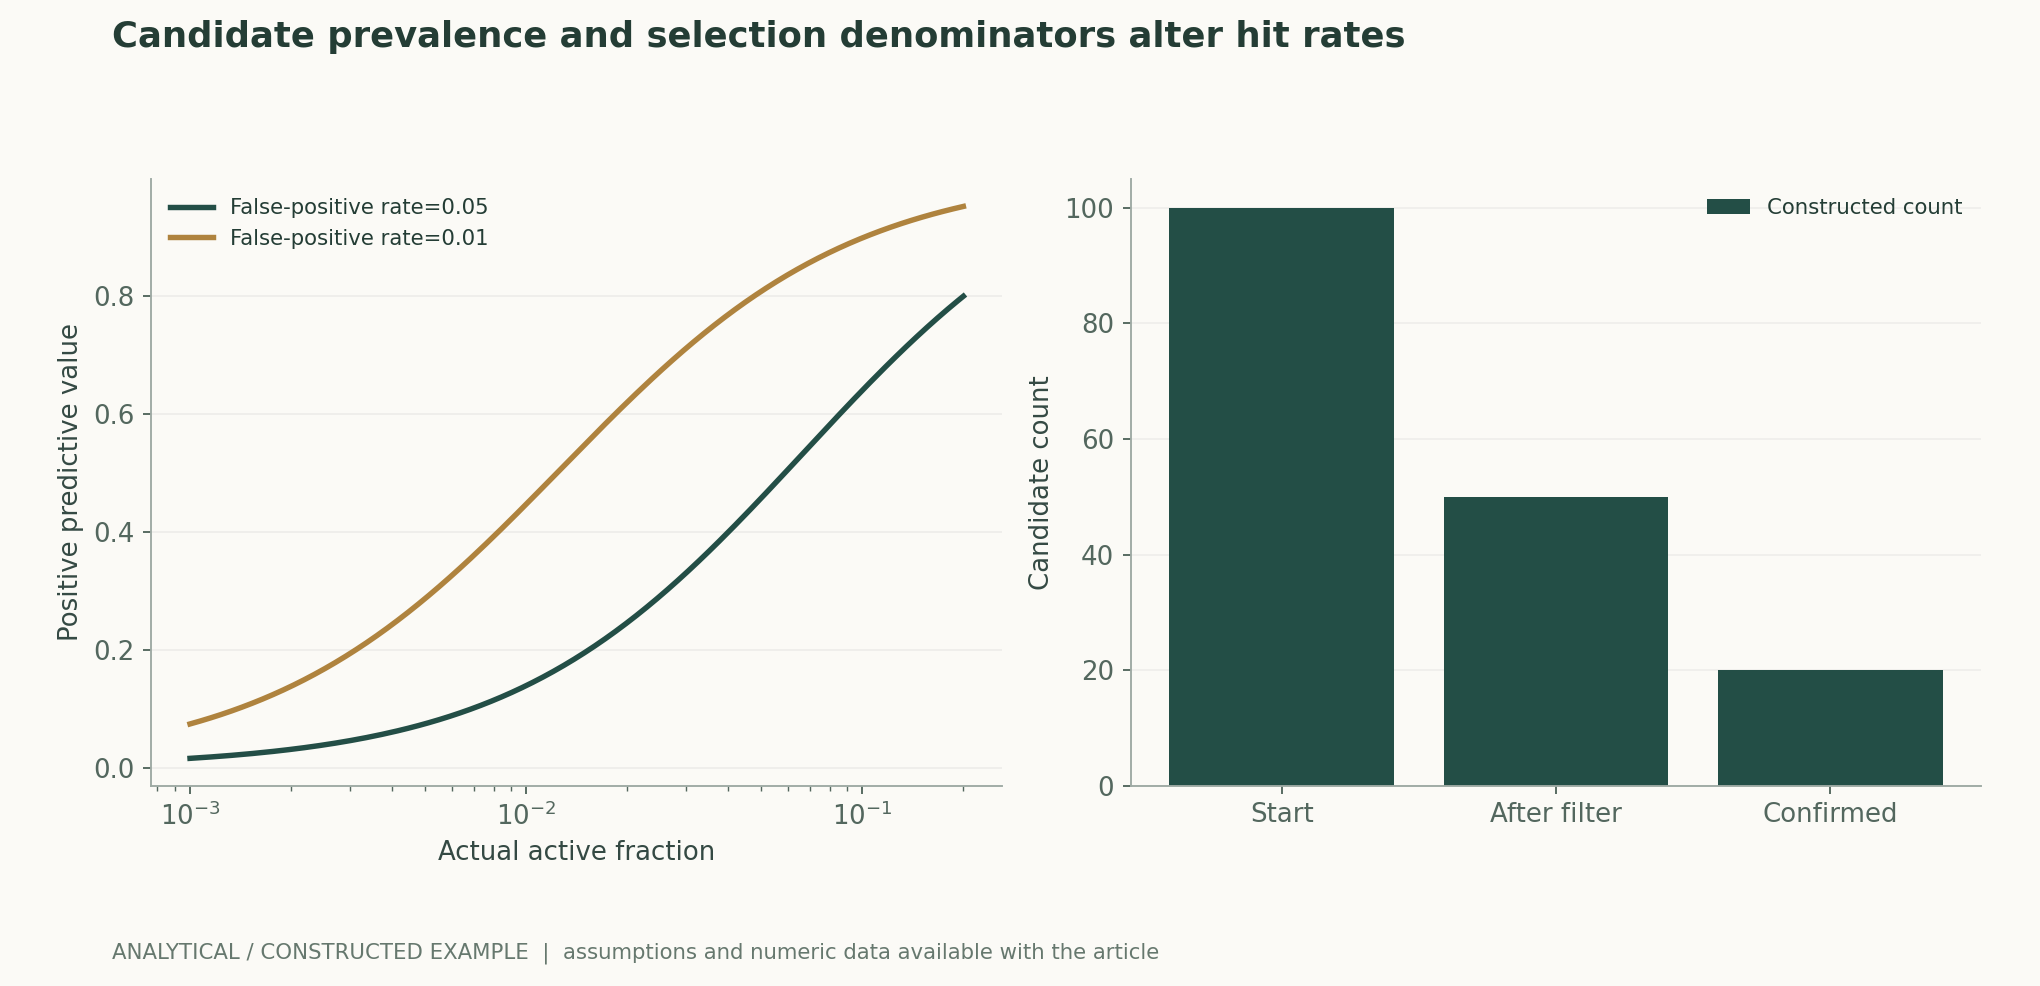
可复算例题
活性比例1%、s=0.8、f=0.05时PPV约0.139130;比例10%时约0.64。20/50=40%与20/100=20%是不同分母。
方法比较
| 层级 | 可支持结论 | 仍需独立证明 |
|---|---|---|
| 计算高分 | 值得优先测量 | 真实活性 |
| 实测活性 | 指定条件下效应 | 广泛条件与选择性 |
| 结构片段解释 | 模型关联线索 | 靶点机制 |
| 窄谱或宿主测量 | 已测对象的选择性 | 全部环境与长期表现 |
| 动物模型 | 该模型的临床前证据 | 人类效果 |
| 发现流程 | 预算内确认产出 | 临床批准或治疗建议 |
复核与实验方案
- 冻结候选库、结构标准化、去重与化学家族划分。
- 预注册活性与选择性终点,保存测量条件而不合并不同任务。
- 报告计算、可获得、送验、可测与确认五个分母。
- 在外部骨架上评估校准和固定预算 Precision@K。
- 以独立样品和不同原理测量排除检测干扰。
- 将片段解释、对接、机制线索与功能证据分开。
- 以家族和批次为统计单位,保留不可测及负结果。
- 公开准确来源与更正,未测性质保留未知,不作临床使用宣称。
适用范围与局限
- 本文概率与筛选漏斗不是真实药物性能数据。
- 没有提出、合成或测试新抗菌化合物。
- 原研究的动物及机制证据不能直接迁移到人类。
- 新颖性与校准依赖候选库和结构表示。
- 本文是研究方法分析,不提供诊疗或微生物操作指导。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 39,312 个测量、12,076,365 个预测和 283 个后续测试属于不同阶段。 | 不将计算数量当成实测发现数。 | Discovery of a structural class of antibiotics with explainable deep learningAbstract |
| 报告窄谱候选、机制线索和小鼠伤口模型证据。 | 并非人类临床效果或批准。 | Deep learning-guided discovery of an antibiotic targeting Acinetobacter baumanniiAbstract; characterization |
值得检验的研究问题
- 固定家族距离后,可解释片段能否提高独立确认率?
- 校准失配还是样品可测性更限制外部化学库产出?
- 完整预算匹配下,多目标筛选是否改善独立活性与选择性?
一手来源与主张对应
- Discovery of a structural class of antibiotics with explainable deep learningWong et al. · 2023-12-2039,312 measured compounds; 12,076,365 predicted; 283 tested; preclinical activity and structural rationales.
- Deep learning-guided discovery of an antibiotic targeting Acinetobacter baumanniiLiu et al. · 2023-05-25Narrow-spectrum lead, LolE-related mechanism and mouse wound-model evidence; not a clinical approval.
- PoseBusters: AI-based docking methods fail to generate physically valid poses or generalise to novel sequencesButtenschoen, Morris and Deane · 2024Physical validity tests, benchmark scope and sequence novelty; not a benchmark of every later model.
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c