
要旨
自律実験室の核心は、ロボットが連続稼働することではなく、実験エージェントが信頼できる測定に基づいて次の行動を選択し、独立に確認可能な新しい知識を生み出せるかどうかにある。A-Labは計算による候補、文献からの示唆、ロボット、相同定を結び付ける。一方、Coscientistは、言語モデルによる文書、コード、実験インターフェースのオーケストレーションを探究する。本稿は両者の閉ループを比較し、測定の誤判定、選択バイアス、エージェントの権限が発見の信頼性に与える影響を分析する。陽性的中率と能動学習の予算の関係を導出し、完全な実験台帳と独立した確認プロトコルを提案する。図中の確率と目的関数はいずれも構成例であり、実際の化学実験や装置操作は行っていない。[1] An autonomous laboratory for the accelerated synthesis [2] Autonomous chemical research with large language models
原文英語要旨の日本語訳
自律実験室は、実験上の意思決定を、信頼できる測定および追跡可能な状態遷移と結び付けなければならない。本稿では、A-Labの固相ワークフローと、Coscientistにおける言語モデルによるオーケストレーションを比較する。ベイズ意思決定の例を用いて、測定の特異度と目標の出現割合が見かけ上の発見に与える影響を示す。また、期待改善量の構成例によって、活用と不確実性の低減を区別する。完全な実験台帳、予算を揃えたベースライン、目標の独立した確認を提案する。本稿では化学実験や実験室での操作は一切行っていない。
1. 自動実行、自律的意思決定、科学的発見は異なる三つの水準である
システムが手順を自動的に投入できることは実行インターフェースが接続されていることを示し、フィードバックに基づいて計画を変更できることは自律的意思決定の存在を示す。さらに、新しい対象や規則性を独立に確認できて初めて、科学的発見が成立する。A-Labの研究は多様な情報と実験フィードバックを意思決定に取り込み、Coscientistは言語モデルと実験ツールの組合せを示している。本稿は、各結果について実行の完了、目標の達成、独立した確認を併記し、人の介入を別に記載することを提案する。すべての難しい目標を研究者が事前に選別する必要があるシステムでは、その自律性の範囲を実態に即して限定すべきである。[1] An autonomous laboratory for the accelerated synthesis [2] Autonomous chemical research with large language models
2. 候補データベースは、すでに実現された物質の一覧ではない
計算による材料探索は実験する価値のある構造を提案でき、A-Labはさらに調製と評価の段階を対象とする。その間には、調製経路、反応速度論、競合相、測定の解釈といった課題が存在する。本稿は、各目標について計算上の識別情報、試料の識別情報、評価の識別情報を個別に設けるべきだと主張する。構造ファイル、実際のバッチ、最終的な解釈を、一つの名称だけで結び付けてはならない。混合相や類似した既知構造が得られた場合は、その結果を保持し、目標一覧に単純に成功と記録すべきではない。原研究が報告した件数は、その研究の目標と確認規則に属するものであり、当サイトの新たな実験記録として転記してはならない。[1] An autonomous laboratory for the accelerated synthesis [3] Scaling deep learning for materials discovery
3. 測定の解釈は閉ループ内のモデルであり、透明な窓ではない
A-Labは回折などの実験データを自動解釈し、追加の精密化によって確認する。このことは、自律システムが計画モデルだけでなく、測定モデルと認識モデルにも依存することを示している。認識器の学習用参照データと目標の間に系統的な差異がある場合、未知の結果や混合した結果を最も近いカテゴリーに分類してしまう可能性がある。本稿は、生信号、前処理、候補となる解釈、確認手順を一緒に保存することを提案する。計画器にブール値の「成功」だけを渡してはならない。それでは目標成分の含有量、代替解釈、不確実性が分からず、次に最も情報量の多い実験を選ぶことも困難になる。[1] An autonomous laboratory for the accelerated synthesis
4. 本稿の導出:希少な目標の陽性判定には高い特異度が必要である
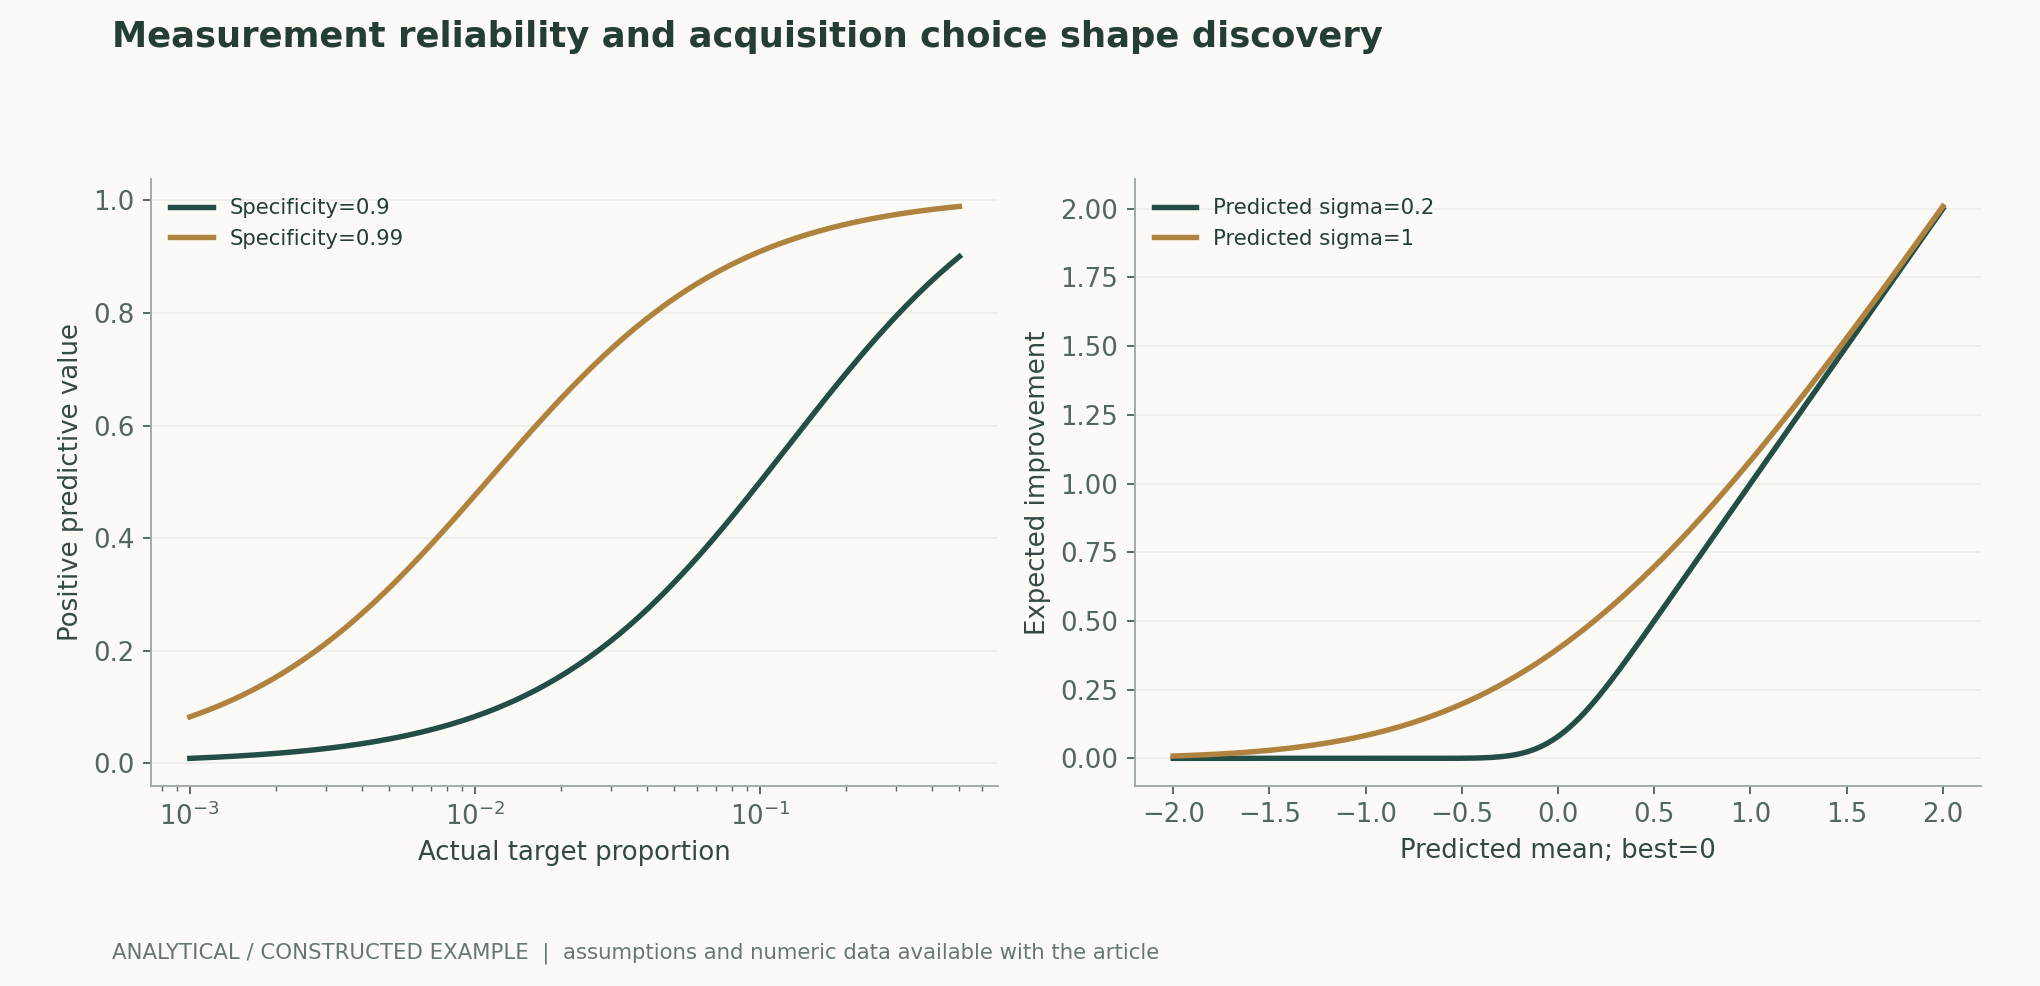
候補が実際に基準を満たす割合をπ、測定の感度をSe、特異度をSpとすると、陽性的中率はSeπをSeπ+(1−Sp)(1−π)で除した値となる。π=0.1、Se=0.9、Sp=0.9という構成条件では、陽性のうち真に基準を満たすのは半数にすぎない。Spを0.99に高めると、陽性的中率は約0.909となる。図は目標の割合と特異度の共同の影響を示す。これはA-Labの誤判定率ではなく、発見のプロセスでは確認段階を独立に検証する必要があることを示すものである。特に、目標が希少で、システムが探索規模を継続的に拡大する場合に重要となる。作者分析与复核建议 / Author analysis
5. 能動学習には最適化目標と情報利得の明確化が必要である
A-Labは実験フィードバックを用いて後続の試行を調整する。能動的意思決定の価値は、限られた予算で、より測定に値する条件を選ぶことにある。本稿は、しばしば混同される三つの目標、すなわち基準を満たす試料をできるだけ早く見つけること、現時点で最良の性能を高めること、機構や実行可能領域に関する不確実性を減らすことを区別する。これらは異なる実験を選択し得る。予測平均の最大値だけを追求する戦略は既知領域の活用に偏る。不確実性を重視する戦略は探索を行い得るが、測定不能な領域に予算を浪費する可能性もある。評価ではあらかじめ目標を規定すべきであり、実行後に別の目標を用いて成功を説明すべきではない。[1] An autonomous laboratory for the accelerated synthesis
6. 本稿の解析:期待改善量における探索と活用の均衡
予測される目的値がガウス分布に従うという単純化した条件では、期待改善量は平均と現在の最良値との差、および不確実性によって共同で決まる。図では現在の閾値をゼロに固定し、複数の平均と標準偏差を比較する。平均が高く不確実性が低い場合と、平均が低く不確実性が高い場合とで、期待改善量が等しくなることがある。この計算は一つの獲得関数を説明するだけであり、実験プラットフォームの実際の戦略を表すものではない。モデルの不確実性が較正されていなければ、数式は誤った期待値を精密に計算し得る。そのため、戦略の選択に使用されていない外部測定によって較正を確認しなければならない。作者分析与复核建议 / Author analysis
7. 言語モデルによるオーケストレーションは状態の真値から分離すべきである
Coscientistは、言語モデルが文書、コード、ツールを利用して限定された研究課題を遂行することを示している。本稿は、その工学上の要点を、計画、実行確認応答、測定結果を異なるオブジェクトとして扱うことにあると考える。テキスト上の「完了」は装置による実際の完了を意味せず、ツールが成功を返しても、タスクの受理だけを示している場合がある。各手順には、一意の識別情報、事前条件、冪等性の規則、実状態の読み戻しが必要である。タイムアウト後に再試行する場合は、先行手順がすでに実行されたかをまず確認し、重複した実験を独立した二つの結果と誤認することを避けるべきである。自律性の程度は、エージェントの対話の長さではなく、検証可能な状態遷移によって定義される。[2] Autonomous chemical research with large language models
8. 実験台帳はすべての失敗と資源消費を保持すべきである
一つの目標の検証には、複数回の調製、測定、修正を要する場合がある。本稿は、目標単位と試行単位の成功率、累積消耗品使用量、装置時間、人の作業時間を分単位で併記することを提案する。センサー故障、ロボットの失敗、試料の測定不能、科学的な陰性結果は個別に記録し、すべて削除したり、すべてモデルの誤りに算入したりしてはならない。人や単純な戦略と比較する際には、目標の難易度と予算を揃える。複数の目標について並行して試行するシステムでは、スケジュールと待機時間を保存し、並列処理のスループットを単一目標の科学的効率向上と誤解釈しないようにすべきである。作者分析与复核建议 / Author analysis
9. 自律的意思決定が主要な結論をすべて自己確認することはできない
閉ループ内の計画器が目標の定義、試料の選択、結果の解釈を同時に担うと、確証バイアスが生じやすい。本稿は、最終的な目標確認を事前に固定した独立の手続きに割り当て、一部の試料について盲検またはバッチをまたいだ再検証を行うことを提案する。独立性は必ずしも別の装置を意味せず、評価規則と選択過程が適切に分離されていることを意味する。特に重要な結論には、外部での実験的再現も必要となる。後続の確認によって初期判断が覆された場合は、元の結果、理由、版を保持し、失敗した試料を過去の発見一覧から黙って削除してはならない。作者分析与复核建议 / Author analysis
10. 自律性の価値を検証する予算を揃えた研究
目標集合、測定規則、予算を事前登録し、固定レシピ、無作為または単純な能動的戦略、完全な自律システムを比較することを提案する。主要評価項目は独立に確認された目標数と資源単位当たりの知識利得、副次評価項目は実行の信頼性と人の介入である。アブレーションでは、文献、計算による事前情報、フィードバックをそれぞれ除去し、利得がどこから生じるかを判断すべきである。利点が実行速度に限られる場合も有効な工学的成果ではあるが、それを同程度の発見能力の向上として提示することは避けるべきである。未知または未確認の対象は、すべて公開表にその状態を残す。作者分析与复核建议 / Author analysis
技術補足 A · 情報利得と成功率は常に一致するわけではない
ある実験はほぼ確実に失敗するとしても、主要な二つの機構を識別できるかもしれない。別の実験は既知の成功を繰り返す可能性が高くても、知識をほとんど増やさないかもしれない。したがって、自律的科学のあらゆる課題を成功試料の割合だけで評価することはできない。本稿は、目標が最適化、網羅、機構同定、再現のいずれであるかを事前に明示し、それに応じて情報利得と費用を定義することを提案する。信頼できる確率モデルがなければ、情報利得は意思決定のための近似にすぎず、外部からの検証を必要とする。最適化目標に失敗した後で、探索の成功だったとその場で言い換えてはならない。すべての目標変更について、実験台帳に明確な時点と理由を記録すべきである。作者分析与复核建议 / Author analysis
技術補足 B · 観測と欠測の機構を意思決定に組み込む必要がある
未完了または測定不能の試料は、しばしば無作為には生じない。特定の条件では装置の故障や信号不足が起こりやすい。能動学習が成功した測定だけを受け取ると、訓練集合は測定可能性によって選択され、実行可能領域を誤って推定する可能性がある。本稿は、実行失敗、測定失敗、科学的な陰性結果に異なる状態を付与し、意思決定モデルが費用と測定不能の確率を明示的に考慮できるようにすることを提案する。欠測値を既定でゼロ応答と見なしたり、そのまま削除したりしてはならない。完全な失敗台帳は、モデル規模を一律に拡大するのではなく、計画、装置、測定のどこを改善すべきかの判断に役立つ。作者分析与复核建议 / Author analysis
技術補足 C · 状態遷移には冪等性と状態の読み戻しが必要である
タスク投入に一意の識別情報が付与された後は、再試行で同じ識別情報を再利用するか、新しい試行を明示的に作成すべきである。完了確認応答を試料、装置、時刻と結び付け、さらに実測によって後続手順の条件を確認する必要がある。本稿は、投入には成功したが確認応答が失われた場合や、装置は完了したがネットワークが切断された場合などを故障注入試験で模擬し、重複実行や誤った手順の飛ばしが生じないことを確認するよう提案する。これらの試験はワークフローの実装だけを検証するものであり、化学的結果ではない。実行の信頼性と科学的成果率は分けて報告すべきである。信頼できるワークフローはデータの解釈を守るが、測定そのものを代替することはできない。作者分析与复核建议 / Author analysis
技術補足 D · 独立した確認は発見の水準に対応すべきである
ある相の存在、試料の純度、性能、新規性の確認は、それぞれ異なる課題であり、異なる証拠と参照ライブラリが必要になる場合がある。本稿は、各発見について確認の種類と未達の条件を明示し、後続の再検証を同一の目標および試料バッチに紐付けることを提案する。データベースの更新によって対象が新規ではないと判明した場合、元の実験結果は保持できるが、新規性についての結論には訂正を追記すべきである。このような版管理の仕組みにより、自律プラットフォームは、撤回不能な成功一覧によって見かけの成果量を維持するのではなく、訂正を蓄積できる。作者分析与复核建议 / Author analysis
11. 結論:自律的科学には監査可能な測定と意思決定が必要である
将来の実験室にとって重要な進歩は、選択、実行、測定、確認を信頼できる閉ループとして結び付けることである。本稿の確率的反例と獲得関数は、誤った確認と未較正の不確実性のいずれも、自動化によるバイアスの拡大を招き得ることを示す。信頼できるシステムは、各目標が計算上の候補から実試料へ、さらに独立した確認へと至る経路を読者が再構成でき、消費と失敗も把握できるようにすべきである。このような自律性の記録があって初めて、ロボットの連続稼働を、蓄積可能で再現可能な科学的知識へと転換できる。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 目標の割合と測定精度が与えられたときの陽性的中率。本稿の入力は構成した確率である。
LaTeX
\operatorname{PPV}=\frac{\operatorname{Se}\,\pi}{\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)}(2) 目的の最大化、ガウス予測、σ>0を条件とする期待改善量の式。σ=0では決定論的極限を取る。
LaTeX
\operatorname{EI}(x)=(\mu(x)-f^*)\Phi(z)+\sigma(x)\phi(z),\quad z=\frac{\mu(x)-f^*}{\sigma(x)}(3) 事前に定めた目標単位で計量する。実験試行単位の成果率は別記する必要がある。
LaTeX
\operatorname{yield}_{\mathrm{target}}=\frac{N_{\mathrm{independently\ confirmed}}}{N_{\mathrm{predefined\ targets}}}(4) 情報利得、費用、時間に関する一般的な意思決定記帳の形式。実際の実験最適化には使用していない。
LaTeX
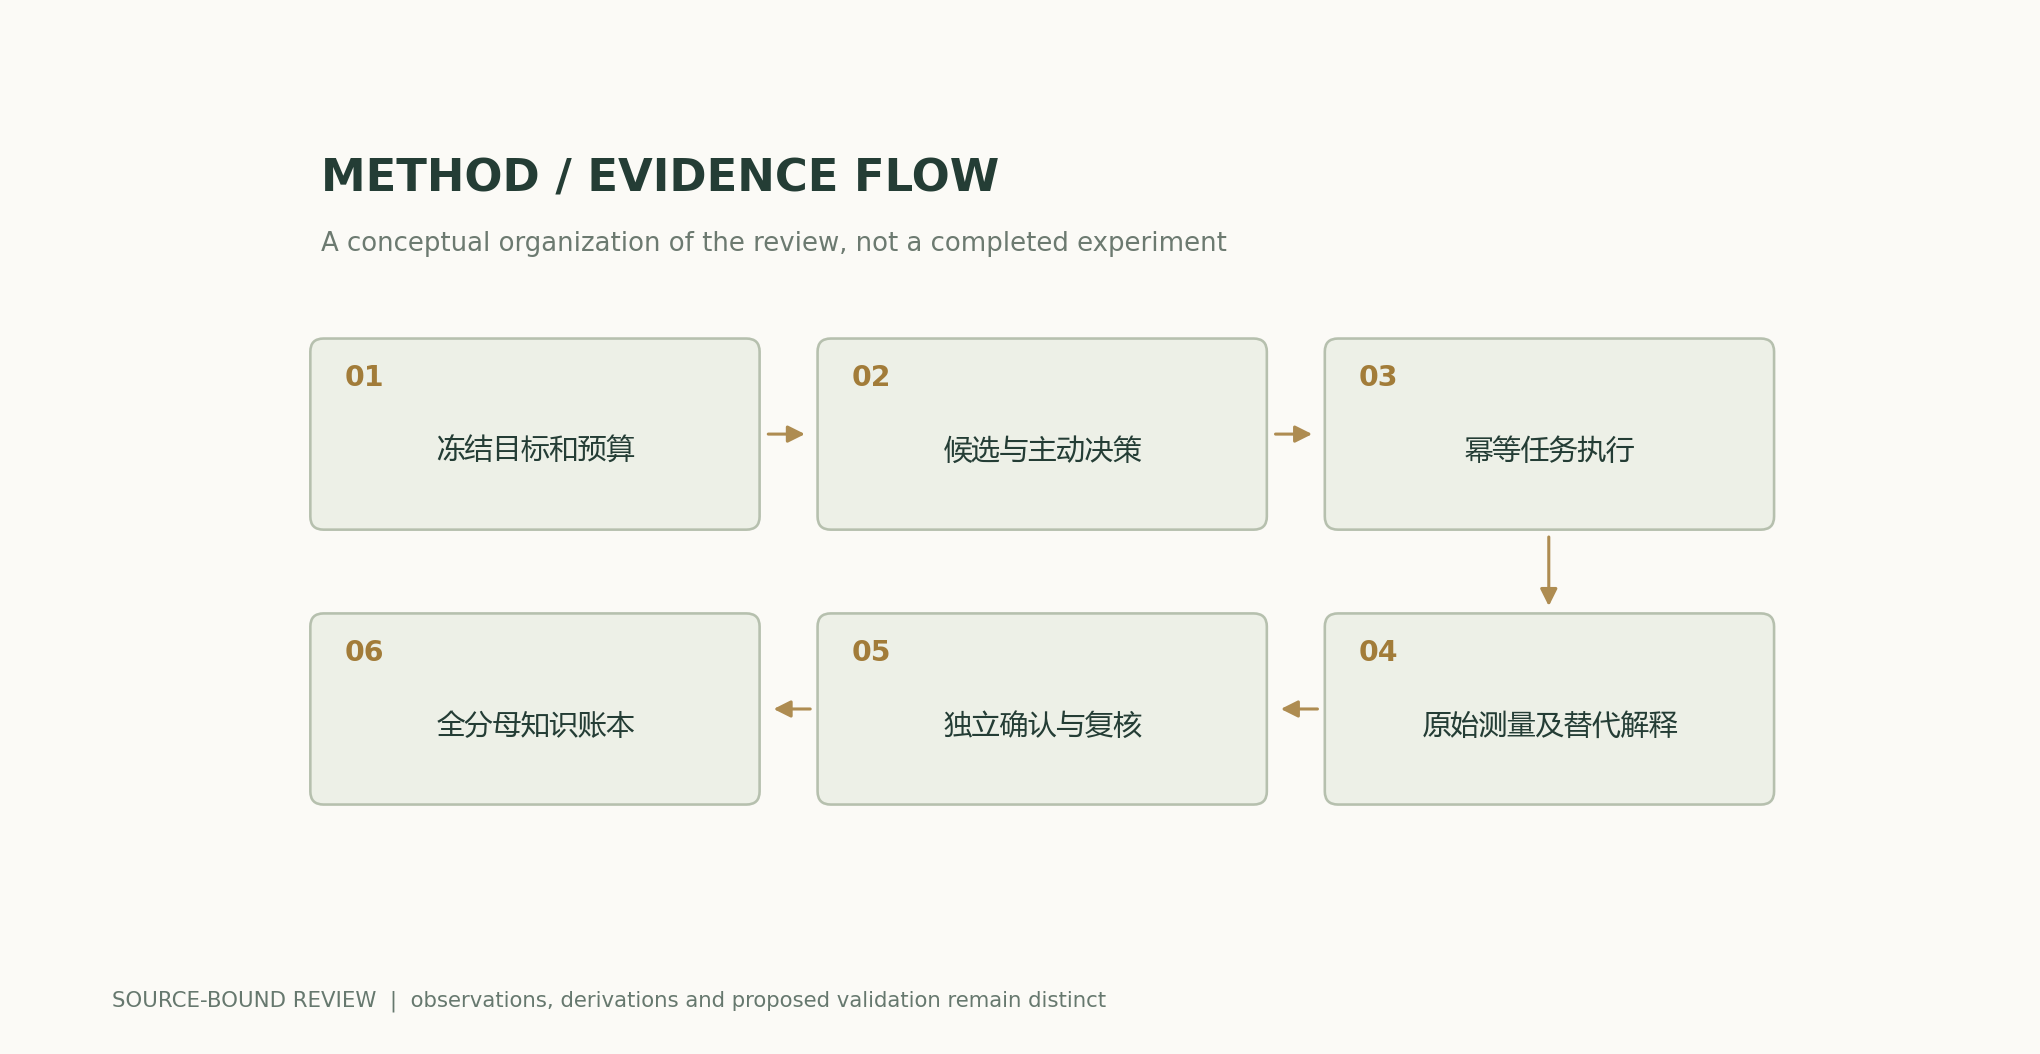
U(x)=\mathbb E[\Delta\mathcal I\mid x]-\lambda_C C(x)-\lambda_T T(x)方法と証拠の流れ
解析図と数値例
再計算可能な例題
目標の割合が0.1のとき、特異度0.9ではPPV=0.5となり、特異度0.99では約0.909091となる。平均が0のとき、ガウス予測ではEI=sigma/sqrt(2pi)となる。
方法の比較
| 状態 | 必要な読み戻し可能な証拠 | 個別に保持すべき事項 |
|---|---|---|
| 候補の提案 | 構造/仮説と出典の版 | 実現可能性は不明 |
| 実験の投入 | タスクの識別情報と事前条件 | 受理は実行を意味しない |
| 実行完了 | 装置の確認応答、時刻、試料の識別情報 | タイムアウト、再試行、人の介入 |
| 自動解釈 | 生信号と解釈器の版 | 代替候補の相と不確実性 |
| 目標の確認 | 事前に固定した独立の確認規則 | 混合相と判定不能 |
| 知識の産出 | バッチ間の再現と完全な分母 | 陰性結果と資源費用 |
再検証と実験計画
- 目標、測定可能な評価項目、予算、自律性の範囲を事前登録する。
- 候補、タスク、試料、測定、解釈に正確な識別情報を設ける。
- 生信号、モデルの版、すべての代替解釈を保持する。
- 実行がタイムアウトした場合は、まず状態を読み戻し、冪等性の規則に従って再試行を判断する。
- 予測と測定の不確実性を較正し、計画器のテキストを真値として扱わない。
- 主要な目標を独立の手続きで確認し、別途バッチ間の再検証を行う。
- 目標単位と試行単位で、成果率、費用、人の介入を個別に報告する。
- 失敗と訂正は追記して保存する。本稿の解析計算は実際の発見に算入しない。
適用範囲と限界
- 実験装置の操作や新物質の合成は行っていない。
- PPVとEIは仮定した分布を用いており、原プラットフォームの実測には対応しない。
- 情報利得は目標とモデルに依存し、単一のスコアで普遍的に比較することはできない。
- 測定器、計画器、実験過程のいずれにも分布の変化が生じ得る。
- 自律実行の成果は、独立した確認や外部での再現と同義ではない。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| ロボット、計算情報と文献情報、自動測定、フィードバック最適化を接続する。 | 各発見は、目標と相確認の規則に依存する。 | 無機材料の合成を加速する自律実験室ワークフロー;相同定;能動学習 |
| 言語モデルによる文書、コード、実験インターフェースの限定的なオーケストレーションを示す。 | 実証された範囲は、任意の化学研究における完全な自律性を意味しない。 | 大規模言語モデルによる自律的な化学研究要旨と実験 |
| 計算上の候補と安定性研究は、実験の選択に事前情報を与える。 | 計算された構造は、実験による実現を意味しない。 | 材料発見に向けた深層学習の大規模化発見のパイプライン |
検証に値する研究課題
- 独立した確認後、自律的戦略による目標の産出は、単純なベースラインに比べてどの程度増加するか。
- 測定の誤判定が、計画の質以上に発見効率を制約するのはどのような場合か。
- 同一の実験予算の下で、異なる情報源が寄与するのは速度か、それとも知識利得か。
一次資料と主張の対応
- An autonomous laboratory for the accelerated synthesis of inorganic materialsSzymanski et al. · 2023Robotic solid-state workflow; phase identification, Rietveld refinement and active-learning feedback.
- Autonomous chemical research with large language modelsBoiko et al. · 2023-12-20LLM orchestration of documentation, code and laboratory interfaces; demonstrated experiments have bounded scope.
- Scaling deep learning for materials discoveryAmil Merchant, Simon Batzner, Samuel S. Schoenholz, Muratahan Aykol, Gowoon Cheon, Ekin Dogus Cubuk · 2023-11-29Abstract; Active learning; Discovered stable crystals; Methods
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典を伴う研究レビューと独自の解析である。原論文の実験は原研究チームによるものであり、本稿の計算は記載した数式と明示した仮定のみを検証する。当サイトには現時点で、本稿に対する独立した査読、または本稿に関する独自モデル、臨床実験、物理実験の記録はない。
初公開:AIと科学的発見の詳細特集。節ごとの出典と、原研究の証拠および著者による解析の境界を保持する。
概念的な表紙画像はImageGenが生成した。科学図は付随するコードと数値ファイルから作成し、図注で仮定と測定の定義を項目ごとに説明する。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開と版の履歴
ソースのリビジョン: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c