
摘要
自主实验室的核心不是机器人连续运行,而是实验代理能否根据可靠测量选择下一步,并产生可独立确认的新知识。A-Lab 将计算候选、文献启发、机器人与相鉴定连接;Coscientist 探索语言模型对文档、代码和实验接口的编排。本文比较两种闭环,分析测量误判、选择偏差和代理权限如何影响发现可信度。我们推导阳性预测值与主动学习的预算关系,提出完整实验账本和独立确认协议。图中概率与目标函数均为构造示例,未进行实际化学实验或设备操作。[1] An autonomous laboratory for the accelerated synthesis [2] Autonomous chemical research with large language models
English abstract
An autonomous laboratory must connect experimental decisions to trustworthy measurements and traceable state transitions. We compare A-Lab's solid-state workflow with language-model orchestration in Coscientist. A Bayesian decision example shows how measurement specificity and target prevalence affect apparent discovery; an expected-improvement construction separates exploitation from uncertainty reduction. We propose complete experiment ledgers, budget-matched baselines and independent target confirmation. No chemical experiment or laboratory action is performed here.
1. 自动执行、自治决策与科学发现是三个层级
一个系统能自动提交步骤,说明执行接口已经连通;能依据反馈更换方案,说明存在自治决策;能够独立确认新对象或新规律,才进一步形成科学发现。A-Lab 的研究把多类信息和实验反馈接入决策,Coscientist 则展示语言模型与实验工具的组合。本文建议为每个结果同时报告执行完成、目标达成与独立确认,另列人工介入。若一个系统需要研究者预先筛选所有困难目标,它的自治范围应如实限定。[1] An autonomous laboratory for the accelerated synthesis [2] Autonomous chemical research with large language models
2. 候选数据库不是已经实现的物质清单
计算材料发现可以提出值得实验的结构,A-Lab 进一步面向制备与表征环节。两者之间存在制备路径、动力学、竞争相与测量解释等问题。本文主张为每个目标分别建立计算身份、样品身份和表征身份:结构文件、实际批次与最终解释不能只用一个名称连接。若制得混合相或相近已知结构,应保留这些结果,而不是在目标列表中简单记作成功。原研究报告的数量属于其目标与确认规则,不应被复制成本站的新实验记录。[1] An autonomous laboratory for the accelerated synthesis [3] Scaling deep learning for materials discovery
3. 测量解释是闭环中的模型,而不是透明窗口
A-Lab 对衍射等实验数据进行自动解释并使用进一步精修确认,这说明自治系统依赖的不仅是规划模型,还有测量与识别模型。若识别器的训练参考与目标有系统差异,它可能把未知或混合结果归为最相近类别。本文提出将原始信号、预处理、候选解释及确认步骤一起保存。规划器不能只收到一个布尔“成功”,否则无法知道目标含量、替代解释与不确定性,也难以选择下一次最有信息量的实验。[1] An autonomous laboratory for the accelerated synthesis
4. 本文推导:少见目标下的阳性判定需要高特异性
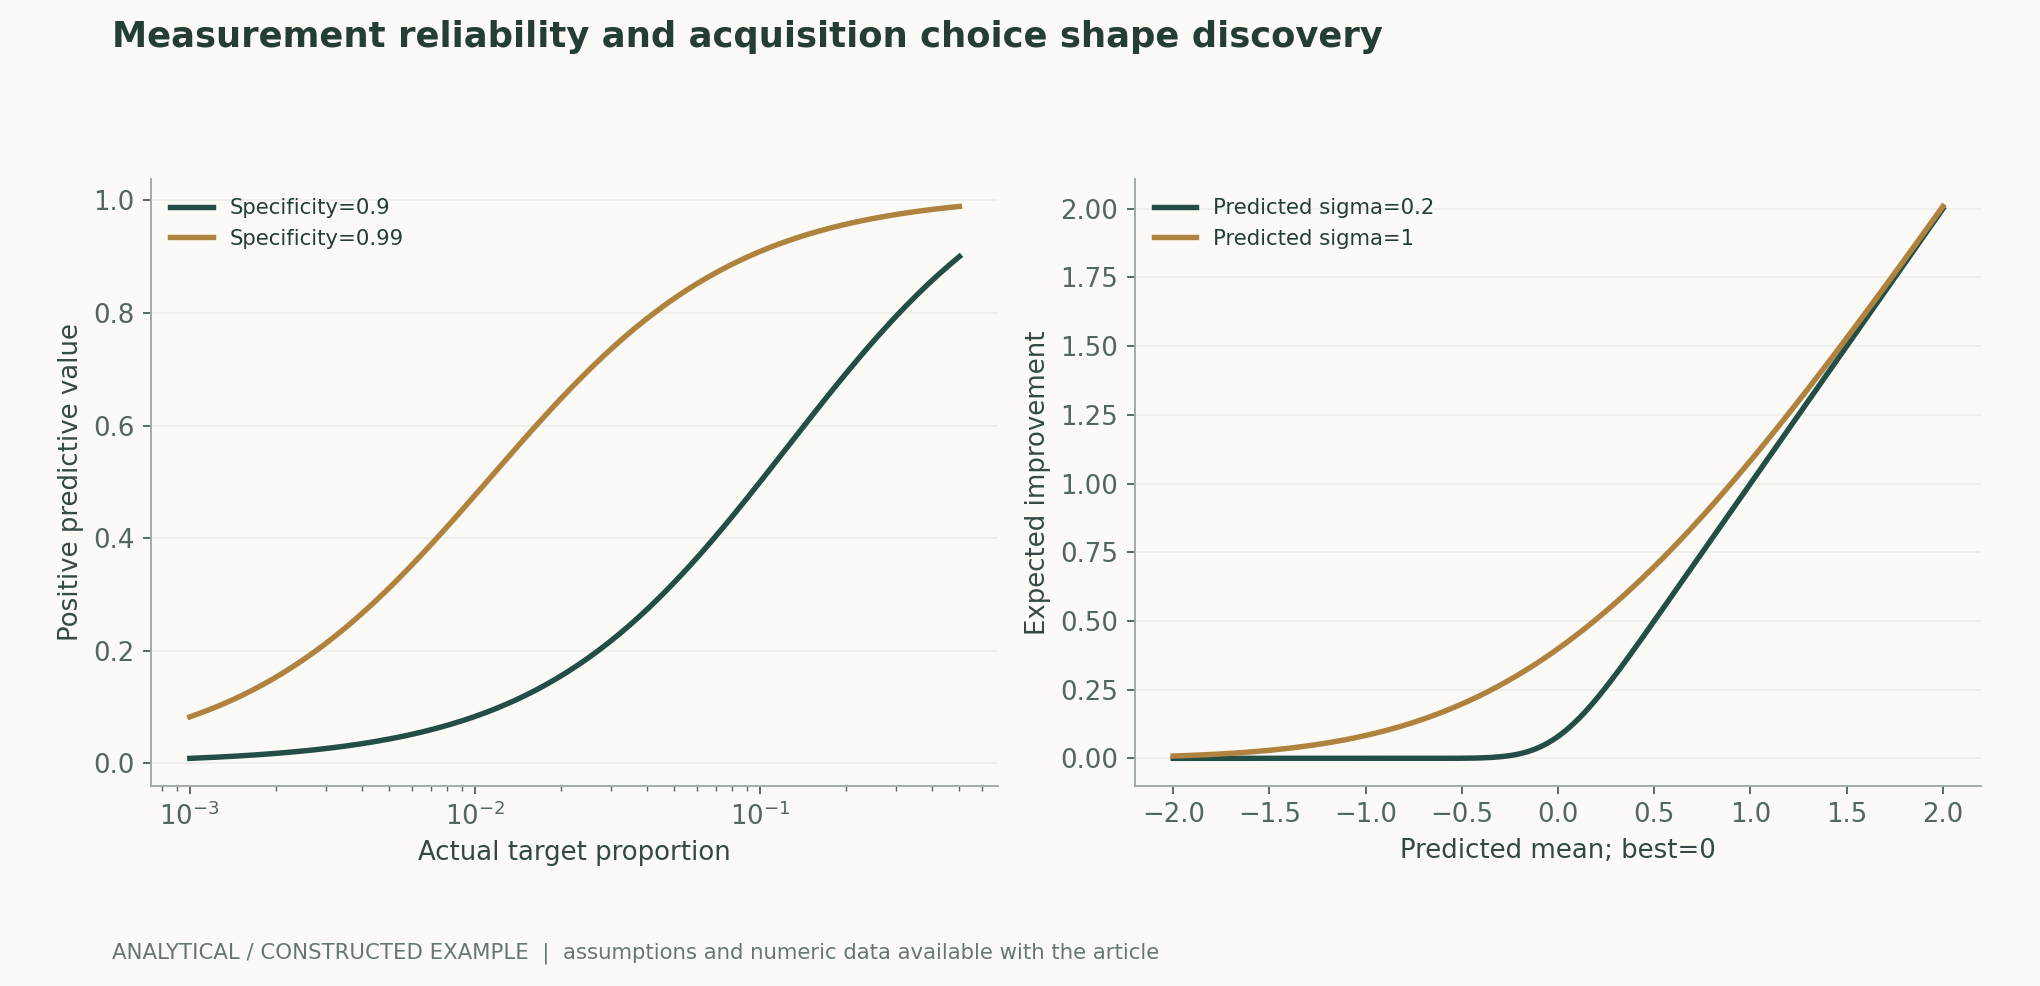
设候选实际达标比例为 π,测量敏感度 Se、特异度 Sp,则阳性预测值为 Seπ 除以 Seπ+(1−Sp)(1−π)。在 π=0.1、Se=0.9、Sp=0.9 的构造条件下,阳性中只有一半真实达标;将 Sp 提高到 0.99,阳性预测值约为 0.909。图展示目标比例与特异度的联合影响。这不是 A-Lab 的误判率,而是证明发现流程必须独立检验确认环节,尤其当目标稀少且系统持续扩大搜索规模时。作者分析与复核建议 / Author analysis
5. 主动学习需要明确优化目标与信息收益
A-Lab 利用实验反馈调整后续尝试,主动决策的价值是用有限预算选择更值得测量的条件。本文区分三个常被混用的目标:尽快找到一个达标样品、提高当前最佳性能、减少对机制或可行区间的不确定性。它们可能选择不同实验。只追求最高预测均值的策略偏向利用已知区域;关注不确定性的策略可能探索,却也可能浪费预算在不可测区域。评价应先规定目标,而不是在执行后用另一个目标解释成功。[1] An autonomous laboratory for the accelerated synthesis
6. 本文解析:期望改进的探索利用平衡
在预测目标值服从高斯分布的简化条件下,期望改进由超过当前最好值的均值差和不确定性共同决定。图固定当前阈值为零,比较多个均值和标准差;高均值低不确定性与低均值高不确定性可能有相同改进期望。这个计算只解释一种采集函数,不代表实验平台实际策略。若模型不确定性未校准,公式可以精确计算一个错误期望,因此必须在未参与策略选择的外部测量上检查校准。作者分析与复核建议 / Author analysis
7. 语言模型编排应与状态真值分离
Coscientist 展示语言模型利用文档、代码和工具完成限定研究任务。本文认为其工程关键是让计划、执行回执和测量结果成为不同对象:文本中说“完成”不等于设备实际完成,工具返回成功也可能只表示接受任务。每个步骤需有唯一身份、前置条件、幂等规则和实际回读。若超时后重试,应先确认前一步是否已经执行,避免重复实验被误认为两个独立结果。自治程度由可验证状态转换定义,而不是由代理对话长度定义。[2] Autonomous chemical research with large language models
8. 实验账本应保留全部失败与资源消耗
一次目标验证可能经历多次制备、测量或修正。本文建议同时报告按目标和按尝试的成功率、累计耗材、设备时间与人工分钟数。传感器故障、机器人失败、样品不可测与科学负结果应分别记录,不能全部删除或全部算成模型错误。对比人工或简单策略时,使用相同目标难度与预算;若系统在多个目标上并行尝试,应保存排程和等待时间,避免把并行吞吐误解释为单目标科学效率提高。作者分析与复核建议 / Author analysis
9. 自主决策不能自我确认全部关键结论
闭环中的规划器若同时定义目标、选择样本和解释结果,容易形成确认偏差。本文提出将最终目标确认分配给冻结的独立流程,并对部分样品做盲法或跨批次复核。独立性不一定意味着另一台机器,而是评价规则与选择过程有适当隔离;对特别重要结论,还需外部实验复现。若后续确认推翻最初判断,应保留原结果、原因和版本,不把失败样品从历史发现列表中静默移除。作者分析与复核建议 / Author analysis
10. 一个能检验自治价值的预算匹配研究
我们提出预注册目标集合、测量规则与预算,比较固定配方、随机或简单主动策略、完整自治系统。主要终点为独立确认目标数与单位资源知识收益;次要终点为执行可靠性和人工介入。消融应分别去除文献、计算先验或反馈,判断增益来自哪里。若系统只在执行速度上获益,也是一项有效工程成果,但应避免包装成发现能力的同等提升。所有未知或未确认对象在公开表中保留状态。作者分析与复核建议 / Author analysis
技术补充 A · 信息增益与成功产率不总一致
一个实验可能几乎肯定失败,却能区分两个关键机制;另一个实验很可能重复已知成功,却几乎不增加知识。因此自主科学不能只用成功样品比例评价所有任务。本文建议预先说明目标是优化、覆盖、机制识别还是复现,并据此定义信息收益和成本。若没有可信概率模型,信息增益只是决策近似,需要外部检查。系统不能在优化目标失败后临时改称探索成功,所有目标变更应在实验账本中有明确时间和原因。作者分析与复核建议 / Author analysis
技术补充 B · 观察与缺失机制需要进入决策
未完成或不可测样品往往并非随机:某些条件更容易造成设备失败或信号不足。若主动学习只收到成功测量,训练集会被可测性选择,可能错误估计可行区域。本文提出给执行失败、测量失败和科学负结果不同状态,允许决策模型显式考虑成本与不可测概率。缺失值不能默认为零响应,也不能直接删除。完整失败账本有助判断系统应改进规划、设备还是测量,而不是一概增加模型规模。作者分析与复核建议 / Author analysis
技术补充 C · 状态转换应具备幂等与回读
任务提交获得唯一身份后,重试应复用同一身份或明确创建新尝试。完成回执需要绑定样品、设备与时间,再由实际测量确认后续条件。本文建议在故障注入测试中模拟提交成功但回执丢失、设备完成但网络断开等情况,检查不会重复执行或错误跳步。这些测试只验证流程实现,不是化学结果;应将执行可靠性与科学产率分开报告。一个可靠工作流能保护数据解释,但不能替代测量本身。作者分析与复核建议 / Author analysis
技术补充 D · 独立确认应匹配发现层级
确认存在某相、确认样品纯度、确认性能与确认新颖性是不同任务,可能需要不同证据和参考库。本文建议为每个发现声明确认类型与未满足条件,再将后续复核附着到同一目标和样品批次。若数据库更新发现对象并不新颖,原实验结果仍可保留,但新颖性结论应追加更正。这样的版本机制让自主平台可以积累纠错,而不是以不可撤回的成功列表维持表面产量。作者分析与复核建议 / Author analysis
11. 结论:自主科学需要可审计的测量与决策
未来实验室的关键进步是让选择、执行、测量和确认形成可靠闭环。本文的概率反例与采集函数说明,错误确认和不校准的不确定性都可能使自动化扩大偏差。一个可信系统应允许读者重建每个目标从计算候选到实际样品再到独立确认的路径,并看见消耗和失败。只有这样的自治记录,才能把机器人持续运行转化为可以累积和复现的科学知识。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 给定目标比例与测量准确性的阳性预测值;本文输入为构造概率。
LaTeX
\operatorname{PPV}=\frac{\operatorname{Se}\,\pi}{\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)}(2) 最大化目标、高斯预测且σ>0的期望改进公式;σ=0取确定性极限。
LaTeX
\operatorname{EI}(x)=(\mu(x)-f^*)\Phi(z)+\sigma(x)\phi(z),\quad z=\frac{\mu(x)-f^*}{\sigma(x)}(3) 按预定目标计量;按实验尝试的产率须另列。
LaTeX
\operatorname{yield}_{\mathrm{target}}=\frac{N_{\mathrm{independently\ confirmed}}}{N_{\mathrm{predefined\ targets}}}(4) 一般信息收益与成本时间的决策记账形式,未用于真实实验优化。
LaTeX
U(x)=\mathbb E[\Delta\mathcal I\mid x]-\lambda_C C(x)-\lambda_T T(x)方法与证据流程
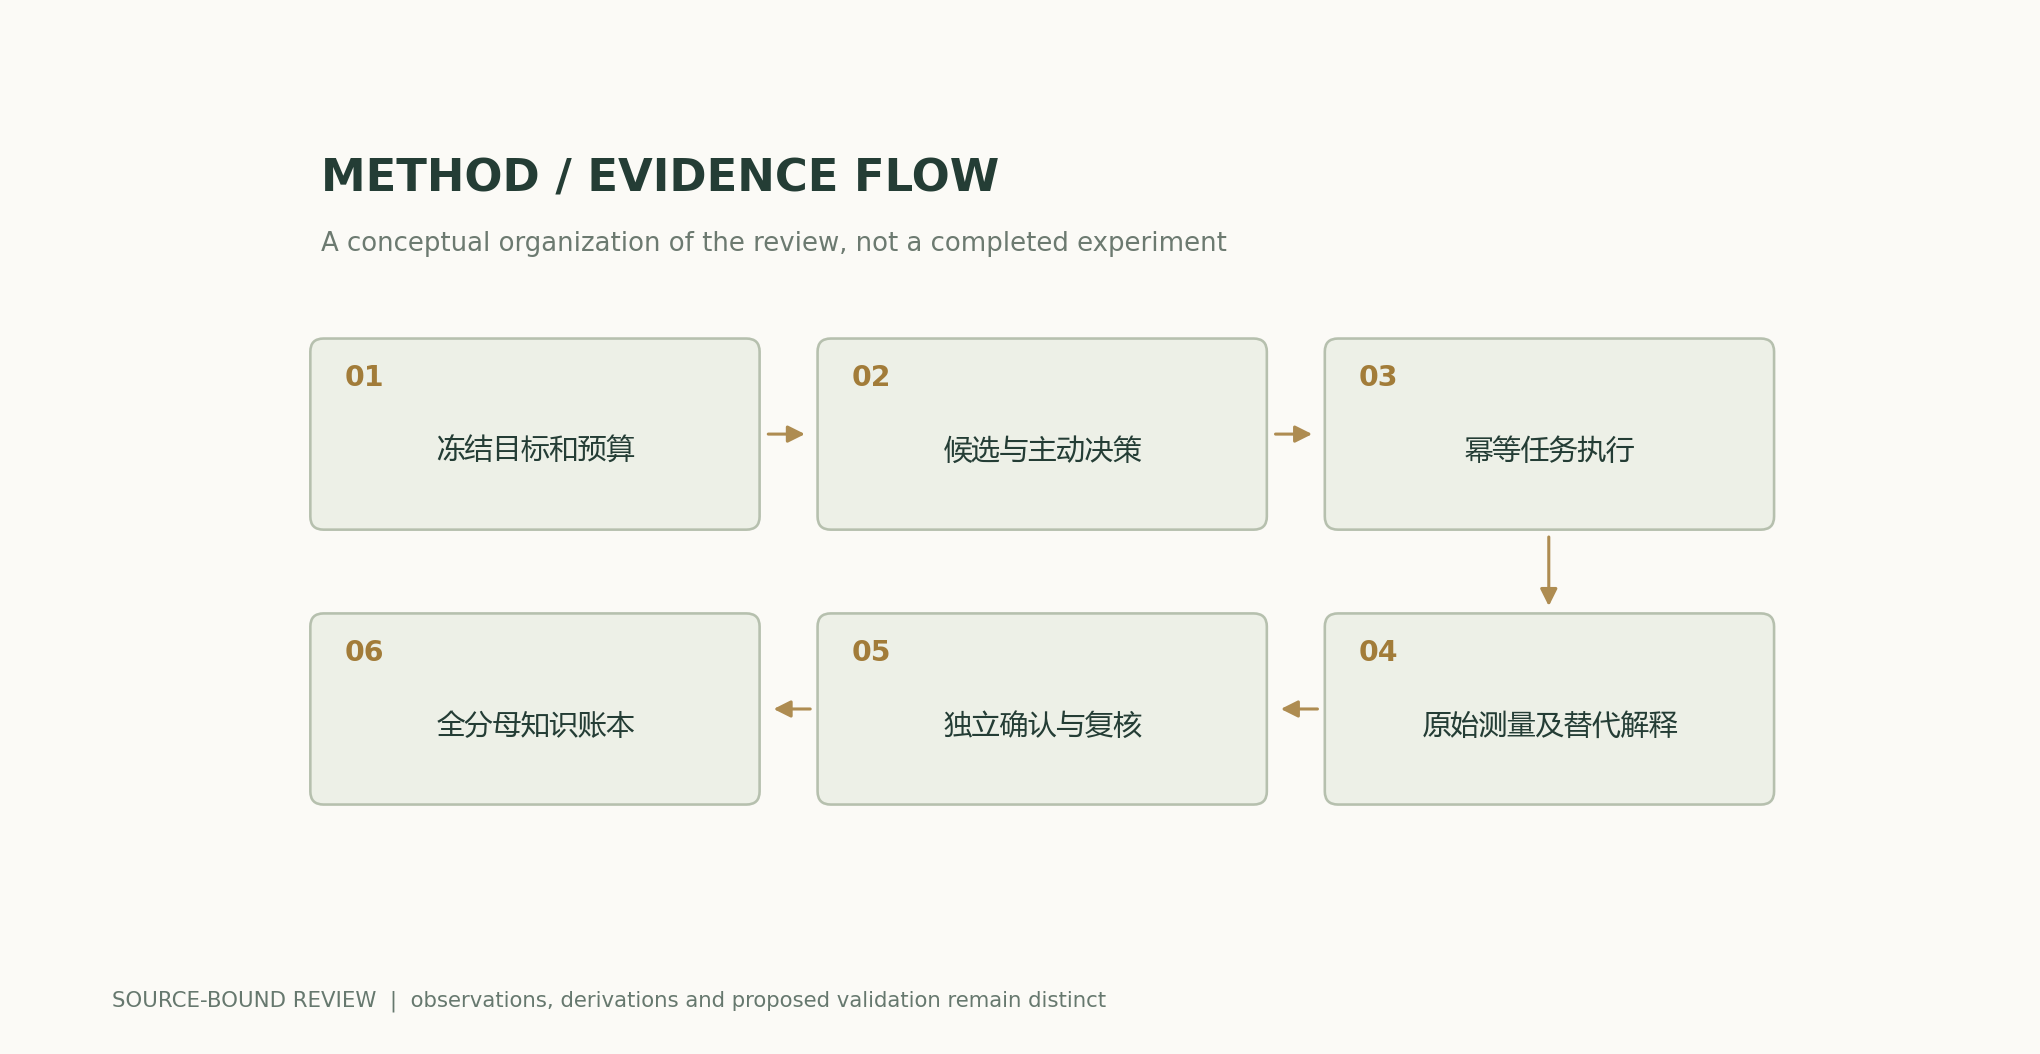
解析图与数值示例
可复算例题
目标比例0.1时,特异度0.9得到PPV=0.5,特异度0.99时约0.909091。均值0时高斯EI=sigma/sqrt(2pi)。
方法比较
| 状态 | 所需可回读证据 | 应独立保留 |
|---|---|---|
| 候选提出 | 结构 / 假说与来源版本 | 可实现性未知 |
| 实验提交 | 任务身份与前置条件 | 接受不等于执行 |
| 执行完成 | 设备回执、时间与样品身份 | 超时、重试与人工介入 |
| 自动解释 | 原始信号与解释器版本 | 替代相与不确定性 |
| 目标确认 | 冻结的独立确认规则 | 混合相和不可判定 |
| 知识产出 | 跨批复现与完整分母 | 负结果及资源成本 |
复核与实验方案
- 预注册目标、可测终点、预算和自治范围。
- 为候选、任务、样品、测量与解释建立准确身份。
- 保留原始信号、模型版本与所有替代解释。
- 执行超时后先回读状态,再按幂等规则决定重试。
- 校准预测和测量不确定性,不把规划器文本当真值。
- 用独立流程确认关键目标,另做跨批次复核。
- 按目标与按尝试分别报告产率、成本和人工介入。
- 失败与更正追加保存;本文解析计算不计入真实发现。
适用范围与局限
- 没有操作实验设备或合成新物质。
- PPV 与 EI 使用假定分布,不对应原平台实测。
- 信息收益依赖目标和模型,无法用单一分数普遍比较。
- 测量器、规划器和实验过程都可能分布变化。
- 自主执行成果不等同于独立确认或外部复现。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 连接机器人、计算与文献信息、自动测量和反馈优化。 | 每个发现依赖目标与相确认规则。 | An autonomous laboratory for the accelerated synthesis of inorganic materialsWorkflow; phase identification; active learning |
| 展示语言模型对文档、代码和实验接口的限定编排。 | 演示范围不等于任意化学研究的完全自治。 | Autonomous chemical research with large language modelsAbstract and experiments |
| 计算候选与稳定性研究为实验选择提供先验。 | 计算结构不等于实验实现。 | Scaling deep learning for materials discoveryDiscovery pipeline |
值得检验的研究问题
- 独立确认后,自治策略相对简单基线的目标产出增益有多少?
- 测量误判何时比规划质量更限制发现效率?
- 不同信息来源在相同实验预算下贡献的是速度还是知识增益?
一手来源与主张对应
- An autonomous laboratory for the accelerated synthesis of inorganic materialsSzymanski et al. · 2023Robotic solid-state workflow; phase identification, Rietveld refinement and active-learning feedback.
- Autonomous chemical research with large language modelsBoiko et al. · 2023-12-20LLM orchestration of documentation, code and laboratory interfaces; demonstrated experiments have bounded scope.
- Scaling deep learning for materials discoveryAmil Merchant, Simon Batzner, Samuel S. Schoenholz, Muratahan Aykol, Gowoon Cheon, Ekin Dogus Cubuk · 2023-11-29Abstract; Active learning; Discovered stable crystals; Methods
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c