
Resumen
Los benchmarks de sistemas informáticos convierten observaciones en afirmaciones comparativas, pero la validez de ese paso depende del diseño experimental. Esta revisión conecta trabajos sobre sesgo de medición, evaluación rigurosa del rendimiento y disposiciones de ejecución aleatorizadas para distinguir las observaciones repetidas de las unidades experimentales independientes. Un modelo jerárquico de varianza muestra por qué aumentar las iteraciones dentro de una ejecución no puede eliminar la incertidumbre entre ejecuciones. Un ejemplo construido de mezcla de cargas de trabajo muestra cómo un sistema que es más rápido en cada carga puede parecer más lento cuando las mezclas comparadas difieren. Ambas figuras son demostraciones analíticas, no mediciones de un compilador o servicio. El material complementario ejecutable comprueba el cálculo de la varianza, la inversión debida a la mezcla y la invariancia frente a las unidades de una aceleración media geométrica. Un protocolo propuesto explicita la intervención, la población, la unidad de replicación, las reglas de exclusión y el tamaño del efecto de importancia práctica. El objetivo es una afirmación cuyo alcance pueda defenderse, en lugar de un intervalo de confianza estrecho asociado a una comparación mal definida.
1. La afirmación precede al cronómetro
Un benchmark debería comenzar con una pregunta sobre una población definida de ejecuciones. ¿La afirmación se refiere a un binario en una máquina, a futuros despliegues en distintas máquinas o a una familia de cargas de trabajo? Cada objetivo requiere una replicación y un muestreo diferentes. La intervención también debe ser clara. Cambiar una opción del compilador mientras se modifican la disposición de la memoria, el orden de las entradas y la duración del proceso no aísla el efecto de esa opción. Una temporización precisa no puede corregir una intervención ambigua. Exprese el estimando en lenguaje corriente antes de elegir un estadístico de resumen: por ejemplo, el cambio en la latencia de las solicitudes completadas bajo una distribución de llegadas y un presupuesto de recursos fijos. Esto permite juzgar si las observaciones recogidas realmente abordan la pregunta prevista.
2. De qué advierten los estudios primarios
Mytkowicz y sus colegas muestran que condiciones experimentales aparentemente inocuas pueden sesgar las mediciones de sistemas informáticos. Kalibera y Jones desarrollan un marco para tratar la variabilidad del rendimiento y la repetición experimental en los niveles pertinentes. Stabilizer utiliza disposiciones de ejecución aleatorizadas para abordar efectos dependientes de la disposición en la evaluación del rendimiento. Estas contribuciones cuestionan distintos atajos: suponer que las decisiones de configuración son inocuas, tratar todas las repeticiones como equivalentes e inferir causalidad a partir de una única disposición favorable. No implican que todos los benchmarks sean inválidos ni que la aleatorización resuelva todos los factores de confusión. Su valor metodológico compartido consiste en incorporar las fuentes de variación al diseño. La bibliografía también deja constancia de que el registro accesible de los autores de Kalibera y Jones identifica un manuscrito corregido, de modo que la procedencia de la versión sigue siendo explícita. [1], [2], [3]
3. La repetición tiene una jerarquía
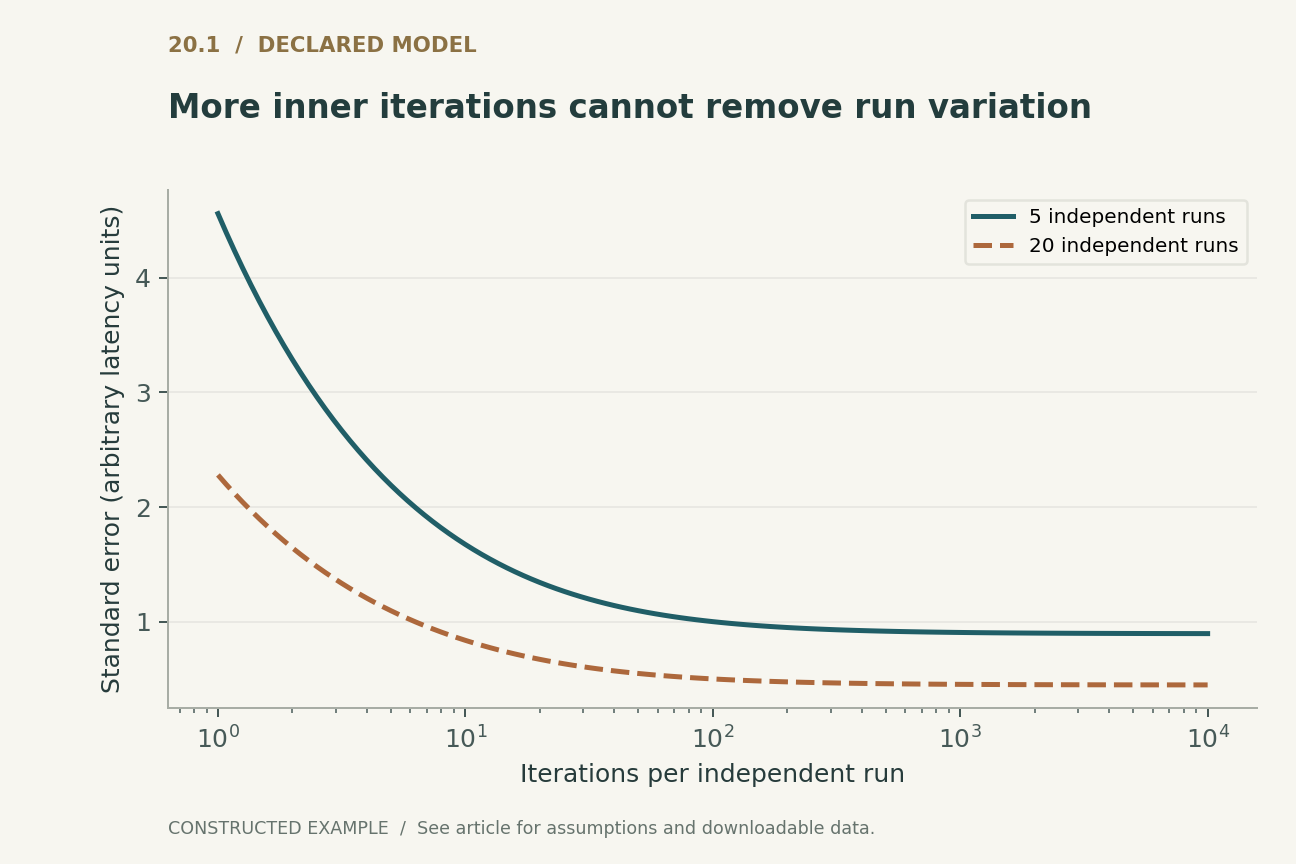
Supongamos que la ejecución r tiene un desplazamiento específico y que cada iteración dentro de ella presenta ruido adicional. Promediar más iteraciones reduce el componente intraejecución, pero no crea nuevos desplazamientos independientes entre ejecuciones. En un modelo sencillo de efectos aleatorios, la varianza de la media global contiene un término entre ejecuciones dividido por el número de ejecuciones y un término intraejecución dividido tanto por las ejecuciones como por las iteraciones. Si solo se inicia el proceso una vez, miles de mediciones del bucle interno pueden seguir compartiendo la misma disposición, historia térmica y estado del entorno de ejecución. Tratarlas como miles de despliegues independientes subestima la incertidumbre sobre el comportamiento de un despliegue a otro. La unidad de replicación adecuada se deriva de la afirmación, no de la frecuencia de muestreo del cronómetro.
4. Un límite inferior visible del error que restringe la precisión
La primera figura fija una desviación estándar entre ejecuciones de dos unidades arbitrarias de latencia y una desviación estándar intraejecución de diez. Después aumenta las iteraciones para cinco o veinte ejecuciones independientes. El error estándar se aproxima a un límite inferior positivo determinado por el término entre ejecuciones. Estos números se han construido deliberadamente; no son estimaciones de un sistema real. Su propósito es mostrar por qué un experimento puede beneficiarse más de inicios independientes adicionales que de muchas más iteraciones en un solo inicio. Un estudio real debería estimar los componentes de la varianza o utilizar un análisis adecuado que tenga en cuenta los conglomerados, comprobando a la vez si son plausibles la estacionariedad y la independencia entre ejecuciones. Un intervalo estrecho calculado bajo una jerarquía incorrecta no establece precisión respecto a la población deseada.
5. Las mezclas de cargas de trabajo pueden invertir la conclusión principal
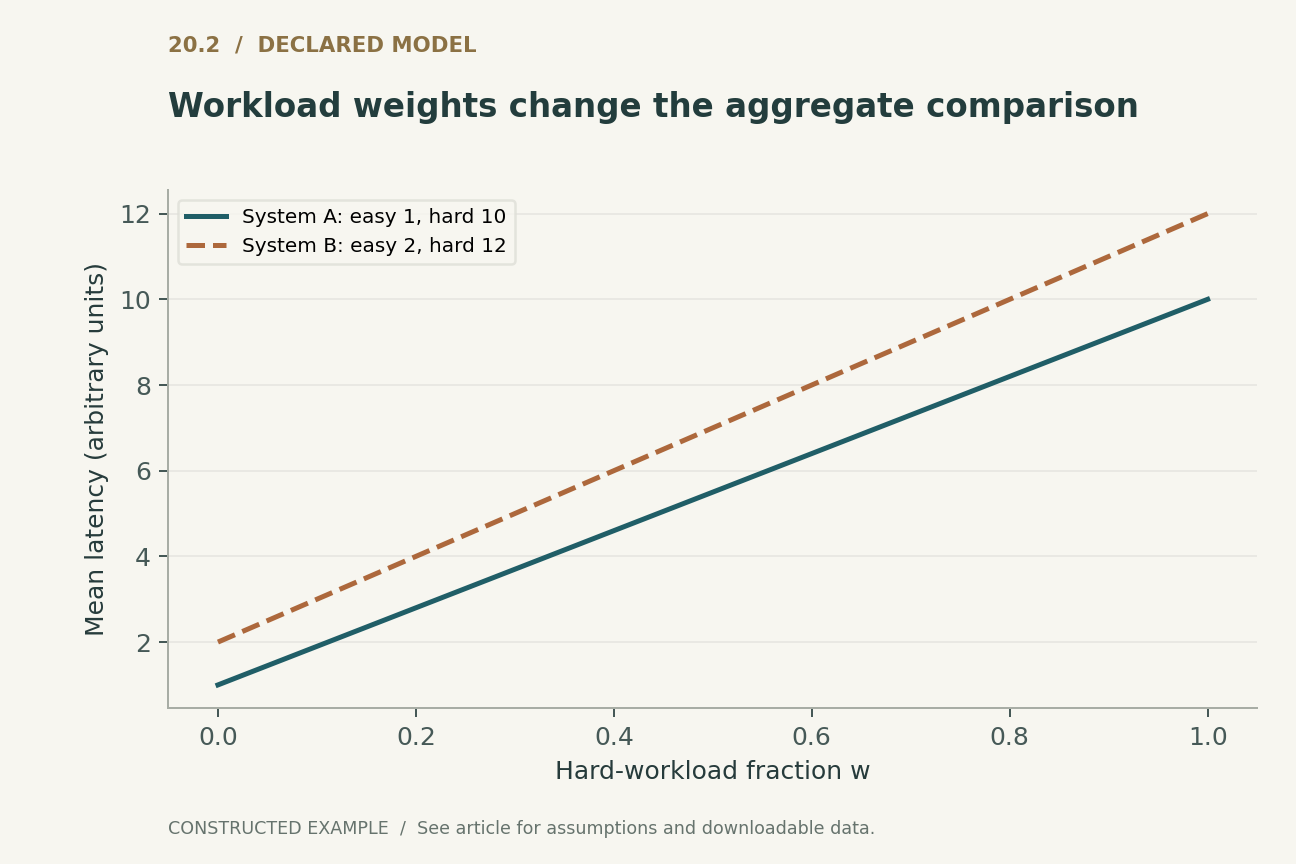
Consideremos dos clases de cargas de trabajo. El sistema A tarda una unidad en la clase fácil y diez en la difícil; el sistema B tarda dos y doce. A es más rápido dentro de ambas clases. Si A se mide con un noventa por ciento de trabajo difícil, su media es 9.1. Si B se mide con un diez por ciento de trabajo difícil, su media es 3.0. La comparación agregada hace que A parezca más lento porque las cargas de trabajo difieren. Con la misma mezcla a partes iguales, las medias son 5.5 y 7.0. Este es un ejemplo construido de confusión, no evidencia sobre un producto. Demuestra por qué un benchmark debe informar de la composición de la carga de trabajo y estandarizar o estratificar la comparación antes de interpretar una diferencia agregada como un efecto de la implementación.
6. La agregación define la pregunta
Una media aritmética de la latencia responde a una pregunta distinta de una media geométrica de las aceleraciones por carga de trabajo. Esta última otorga el mismo peso a los logaritmos de las razones cuando cada carga recibe el mismo peso, mientras que una razón entre los tiempos totales de ejecución da mayor influencia a las cargas más largas. Ninguna es automáticamente correcta. La elección depende de si el objetivo es una batería con pesos iguales, una distribución de cargas de trabajo en despliegue, el coste computacional total o un objetivo de servicio de latencia. Presente los resultados de los componentes para que los lectores puedan reconstruir ponderaciones alternativas. Cambiar las unidades no debería modificar una aceleración adimensional; cambiar los pesos de las cargas de trabajo sí puede hacerlo legítimamente. El material complementario ejecutable comprueba la primera propiedad y el artículo hace visible la segunda elección en lugar de ocultarla en una sola puntuación.
7. La aleatorización y el emparejamiento resuelven problemas específicos
Aleatorizar el orden de ejecución puede reducir la asociación entre el tratamiento y las condiciones que varían con el tiempo. Emparejar ejecuciones próximas o comparables por otros criterios puede reducir el ruido cuando la variable de emparejamiento es pertinente y se especifica de antemano. Ninguno de los métodos garantiza la independencia ni elimina todos los efectos de arrastre. Una caché precalentada, un entorno de ejecución ya compilado, un estado térmico o una carga de fondo compartida pueden persistir entre tratamientos. El diseño debería describir los procedimientos de restablecimiento y comprobar los efectos del orden. Las disposiciones aleatorizadas abordan una clase de dependencia de la disposición, pero no sustituyen la selección de cargas de trabajo ni unos límites de temporización correctos. El análisis debe seguir la estructura de asignación y agrupación utilizada en el experimento, en lugar de aplicar una fórmula para muestras independientes solo por comodidad.
8. Las ejecuciones fallidas también son observaciones
Un servicio que agota el tiempo de espera ante una solicitud difícil no puede evaluarse únicamente por sus finalizaciones satisfactorias sin describir esa selección. Excluir fallos puede hacer que un sistema inestable parezca rápido. Del mismo modo, descartar ejecuciones lentas después de ver los resultados puede eliminar precisamente la interferencia que encontraría un despliegue. Defina de antemano criterios de exclusión basados en fallos de configuración observables y publique tanto la regla como el número de observaciones excluidas. Si los reintentos forman parte del contrato del servicio, incluya su consumo de recursos y su demora de extremo a extremo. Un benchmark debería indicar si su afirmación se refiere a operaciones satisfactorias condicionadas al éxito o a toda la carga de trabajo ofrecida. Son estimandos diferentes y no deberían compartir una cifra de latencia sin etiquetar.
9. Qué comprueba el material complementario y qué no puede comprobar
El apéndice construye una matriz de covarianza para el modelo jerárquico declarado y calcula directamente la varianza de la media; después la compara con la expresión cerrada. Comprueba la inversión entre las dos clases de cargas de trabajo y confirma que la aceleración media geométrica no cambia cuando los tiempos de ambos sistemas se reescalan de una unidad a otra. Estas comprobaciones deterministas pueden revelar errores algebraicos o de agregación. No estiman intervalos de confianza para datos reales de benchmarks, no validan un modelo causal del hardware ni establecen la eficacia de Stabilizer. Una evaluación real requiere datos independientes y un análisis adecuado a su diseño. Las figuras sirven como contraejemplos inspeccionables de errores de razonamiento habituales, no como resultados de rendimiento.
10. Una presentación de resultados que permite una lectura escéptica
Un informe defendible publica el generador o la traza de la carga de trabajo, la configuración del sistema, los límites de temporización, la jerarquía de ejecuciones, la aleatorización, las exclusiones y el código de análisis. Expone la importancia práctica de un efecto y su incertidumbre. Cuando se han explorado muchas configuraciones, distingue la selección exploratoria de una comparación confirmatoria con nuevas ejecuciones. La conclusión identifica la población a la que se aplica y las condiciones que probablemente la invalidarían. Una presentación así puede hacer que un resultado modesto sea más valioso que una aceleración espectacular pero frágil. El criterio no es que desaparezcan todas las fuentes de variación. Es que el lector pueda identificar qué se cambió, qué se mantuvo fijo, cómo se evaluó la incertidumbre y qué explicaciones alternativas siguen abiertas.
Ejecutado localmente · Alcance acotado
Cálculo de covarianza, inversión por cargas de trabajo e invariancia frente a las unidades
Estadísticas construidas; sin intervalo de confianza empírico ni comparación del rendimiento de productos.
Se superaron 6 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar la evidencia de verificación registrada
{
  "variance": [
    {
      "runs": 2,
      "iterations": 3,
      "direct": 18.666666666666664,
      "formula": 18.666666666666668
    },
    {
      "runs": 5,
      "iterations": 4,
      "direct": 5.800000000000001,
      "formula": 5.8
    },
    {
      "runs": 10,
      "iterations": 2,
      "direct": 5.399999999999999,
      "formula": 5.4
    }
  ],
  "unmatched_means": [
    9.1,
    3.0
  ],
  "matched_means": [
    5.5,
    7.0
  ]
}
Descargar los 20 ejemplos ejecutablesLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Efectos de ejecución independientes U con varianza sigma_b al cuadrado y errores intraejecución independientes con varianza sigma_w al cuadrado; un modelo declarado, no datos ajustados.
(2) R ejecuciones independientes con J iteraciones cada una en la jerarquía equilibrada indicada.
(3) Valores de latencia construidos para las clases fácil y difícil; w es la fracción de carga difícil y debe coincidir para una comparación directa.
(4) Media geométrica con pesos iguales de aceleraciones positivas por carga de trabajo; un estimando distinto de la razón entre los tiempos totales.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Decisión de diseño | Pregunta que resuelve | Modo de fallo si se omite |
|---|---|---|
| Unidad experimental | Qué cuenta como replicación independiente | Pseudorreplicación |
| Pesos de las cargas de trabajo | Qué población representa el agregado | Confusión por la mezcla |
| Límites de temporización | Qué trabajo incluye la variable de resultado | Preparación o reintentos ocultos |
| Exclusiones declaradas de antemano | Qué observaciones entran en el análisis | Selección después de ver los resultados |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ningún benchmark de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Escribir el estimando y el umbral del efecto de importancia práctica antes de medir.
- Especificar las intervenciones, los pesos de las cargas de trabajo y los límites de temporización.
- Elegir unidades de ejecución independientes y registrar la estructura de iteraciones anidadas.
- Aleatorizar o emparejar de forma adecuada y documentar los restablecimientos y los efectos de arrastre.
- Conservar los fallos y aplicar únicamente criterios de exclusión declarados de antemano.
- Publicar los resultados de los componentes, el método de incertidumbre, los datos brutos y la sensibilidad a la ponderación de las cargas.
Qué establecen las fuentes primarias
Todd Mytkowicz, Amer Diwan, Matthias Hauswirth et al. · 2009 [1]
Contribución. Decisiones de configuración aparentemente inocuas pueden sesgar las mediciones del rendimiento.
Límite. El resultado motiva controles explícitos, no la afirmación de que todos los benchmarks sean erróneos.
Localización de la fuente. Artículo de ASPLOS y registro de publicación de IBM.
Tomas Kalibera, Richard Jones · 2013 [2]
Contribución. La evaluación del rendimiento debería tener en cuenta la variabilidad en los niveles de repetición pertinentes.
Límite. El modelo utilizado aquí es una construcción analítica simplificada, no una reproducción de la evaluación del artículo.
Localización de la fuente. Registro del manuscrito corregido de los autores en la University of Kent.
Charlie Curtsinger, Emery D. Berger · 2013 [3]
Contribución. Las disposiciones de ejecución aleatorizadas pueden abordar efectos de medición dependientes de la disposición.
Límite. La aleatorización de la disposición no elimina la confusión por cargas de trabajo ni todas las fuentes de variación.
Localización de la fuente. Stabilizer, mecanismo y planteamiento experimental.
Límites de este análisis
- No se sometió a benchmark ningún sistema real ni se afirma obtener un intervalo de confianza empírico.
- El modelo equilibrado de efectos aleatorios excluye varias dependencias posibles y la no estacionariedad.
- La inversión entre dos cargas de trabajo es un ejemplo construido deliberadamente.
- Las referencias seleccionadas no sustituyen un tratamiento completo del diseño experimental o la inferencia causal.
Una revisión analítica focalizada de tres fuentes primarias fundamentales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué componentes de la varianza dominan el rendimiento de un despliegue a otro en los sistemas heterogéneos modernos?
- ¿Cómo pueden las baterías de benchmarks publicar pesos de cargas de trabajo que reflejen múltiples poblaciones legítimas de usuarios?
- ¿Qué formato de presentación permite distinguir el ajuste exploratorio de la evaluación confirmatoria?
Referencias
- Todd Mytkowicz, Amer Diwan, Matthias Hauswirth et al.. Producing wrong data without doing anything obviously wrong!. Proceedings of the 14th international conference on Architectural support for programming languages and operating systems (2009). 10.1145/1508244.1508275.
- Tomas Kalibera, Richard Jones. Rigorous benchmarking in reasonable time. Proceedings of the 2013 international symposium on memory management (2013). 10.1145/2464157.2464160.
- Charlie Curtsinger, Emery D. Berger. STABILIZER: statistically sound performance evaluation. Proceedings of the eighteenth international conference on Architectural support for programming languages and operating systems (2013). 10.1145/2451116.2451141.
Acceso a la fuente [1]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo o del material suplementario.
Acceso a la fuente [2]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo o del material suplementario.
Nota sobre la versión. El registro enlazado de la University of Kent identifica explícitamente un manuscrito corregido de los autores; utilice esa versión para los detalles metodológicos.
Acceso a la fuente [3]. Registro primario, resumen y texto accesible seleccionado; no una auditoría exhaustiva del texto completo o del material suplementario.
Las identidades bibliográficas se contrastaron con Crossref y con registros primarios de editoriales, autores o instituciones. Las notas siguientes sobre acceso a las fuentes y versiones describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se suministran Python y CSV. No son mediciones de productos desplegados ni benchmarks de rendimiento reproducidos.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.