
Resumen
El servicio de modelos de lenguaje combina una gran ocupación fija de memoria para los parámetros con un estado de atención dependiente de las solicitudes y una generación de longitud variable. Esta revisión relaciona PagedAttention, FlashAttention y Orca para distinguir tres mecanismos: la asignación del estado de claves y valores, la reducción del tráfico de memoria de la atención y la planificación a nivel de iteración. Derivamos presupuestos explícitos de memoria de claves y valores para configuraciones multicabeza y de consultas agrupadas, cuantificamos el desperdicio en las colas de las páginas bajo una distribución de longitudes declarada y comparamos un cálculo pequeño de softmax en línea con la atención densa. Las curvas adjuntas son modelos contables, no pruebas de rendimiento de GPU ni reproducciones de las aceleraciones descritas en los artículos fuente. Su propósito es revelar cuándo una afirmación sobre el servicio cambia tácitamente la precisión, la longitud del contexto, la concurrencia, la longitud de salida o el objetivo del servicio. Un protocolo de evaluación propuesto informa conjuntamente del tiempo hasta el primer token, la latencia entre tokens, la tasa de solicitudes completadas y los máximos de uso de memoria, a la vez que comprueba las propiedades numéricas y de aislamiento de solicitudes. La eficiencia de los kernels y la eficiencia de la planificación del servicio se tratan como afirmaciones complementarias que pueden comprobarse por separado.
1. Un resultado de servicio necesita una distribución de solicitudes
Un identificador de modelo y el nombre de una GPU no bastan para definir un experimento de servicio. Las solicitudes tienen longitudes de entrada, longitudes generadas, tiempos de llegada y criterios de finalización. Una carga de trabajo con entradas cortas y salidas largas somete a presión recursos distintos de los de una carga dominada por precargas largas. La concurrencia modifica tanto la cantidad de estado de atención activo como las oportunidades de procesamiento por lotes. Las condiciones de parada también pueden modificar el trabajo medido: generar un presupuesto fijo de tokens difiere de detenerse en un delimitador específico de la aplicación. Por tanto, el objeto experimental principal debería ser una distribución de solicitudes completadas bajo un proceso de llegada declarado. El rendimiento en tokens sigue siendo útil, pero debe vincularse a esa distribución y al objetivo de latencia que el planificador debía cumplir.
2. Tres mecanismos que no deben confundirse
PagedAttention organiza la gestión de la caché de claves y valores en torno a mecanismos de asignación paginada y uso compartido. FlashAttention reduce el tráfico de memoria de la atención mediante un algoritmo de atención exacta que tiene en cuenta la E/S. Orca introduce la planificación a nivel de iteración para el servicio de inferencia de transformadores. Estos mecanismos abordan, respectivamente, la asignación, la ejecución de kernels y la planificación. Una mejora de la gestión de memoria no demuestra por sí sola un menor coste aritmético del kernel, y un kernel de atención más rápido no demuestra una planificación equitativa de las solicitudes. Los artículos fuente aportan implementaciones y evaluaciones concretas, pero este artículo no reproduce sus afirmaciones cuantitativas de rendimiento. En su lugar, sus cálculos explicitan los límites de los recursos para que una prueba posterior pueda atribuir una mejora a un mecanismo y no a un cambio inadvertido de la carga de trabajo o de la precisión. [1], [2], [3]
3. El presupuesto de claves y valores puede formularse explícitamente
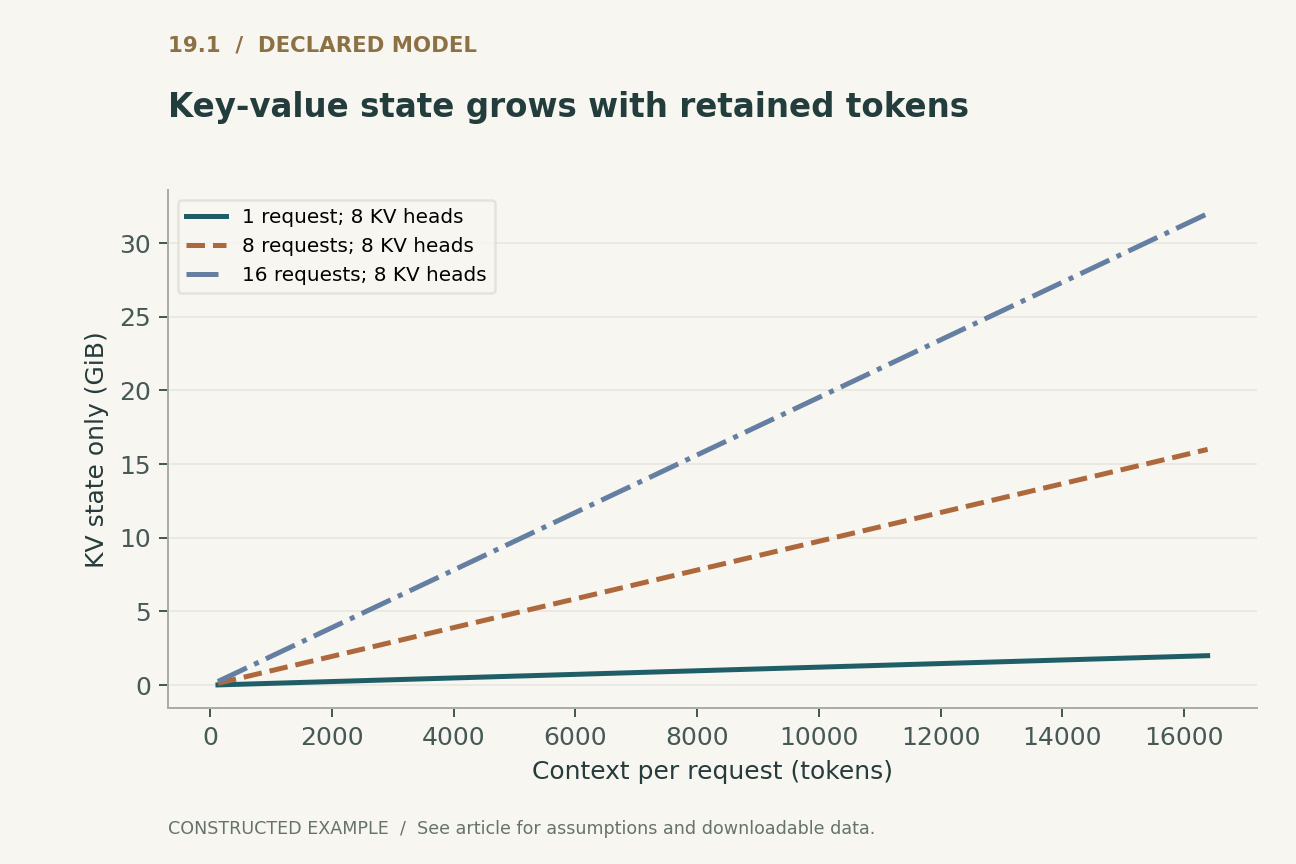
Para un decodificador con L capas, H cabezas de claves y valores, dimensión de cabeza d y b bytes por escalar almacenado, el estado de claves y valores sin comprimir requiere dos por L por H por d por b bytes por token retenido. El factor dos corresponde a las claves y los valores. Esta cantidad se multiplica por la suma de las longitudes de secuencia retenidas de todas las solicitudes activas. Con 32 capas, ocho cabezas de claves y valores, dimensión 128 y dos bytes por escalar, esto supone 128 KiB por token. Por tanto, una solicitud de 4,096 tokens utiliza 0.5 GiB solo para este estado. Utilizar 32 cabezas de claves y valores, manteniendo idénticos los demás supuestos, eleva la cifra a 2 GiB. Estos son ejemplos arquitectónicos declarados, no las especificaciones de un modelo desplegado concreto.
4. La eficiencia de asignación no abarca todo el presupuesto de memoria
Los pesos del modelo, las activaciones, los búferes de espacio de trabajo, los búferes de comunicación y los metadatos del asignador también consumen memoria. El trabajo temporal de precarga puede producir un máximo de uso mayor que el de la decodificación estable. Cuantizar los pesos no cuantiza automáticamente la caché de claves y valores, y cambiar la precisión de las claves y los valores puede modificar el comportamiento numérico. Una estimación de capacidad debe enumerar estos términos por separado y reservar un margen para la sobrecarga específica de la implementación. La figura representa deliberadamente solo el término de claves y valores para que siga siendo reproducible con exactitud. No debe interpretarse como el número de solicitudes que puede atender una GPU. Ese número requiere un perfil medido de toda la memoria con el entorno de ejecución, el modelo, la configuración de kernels y la política de admisión elegidos.
5. La paginación modifica la fragmentación, con un coste residual
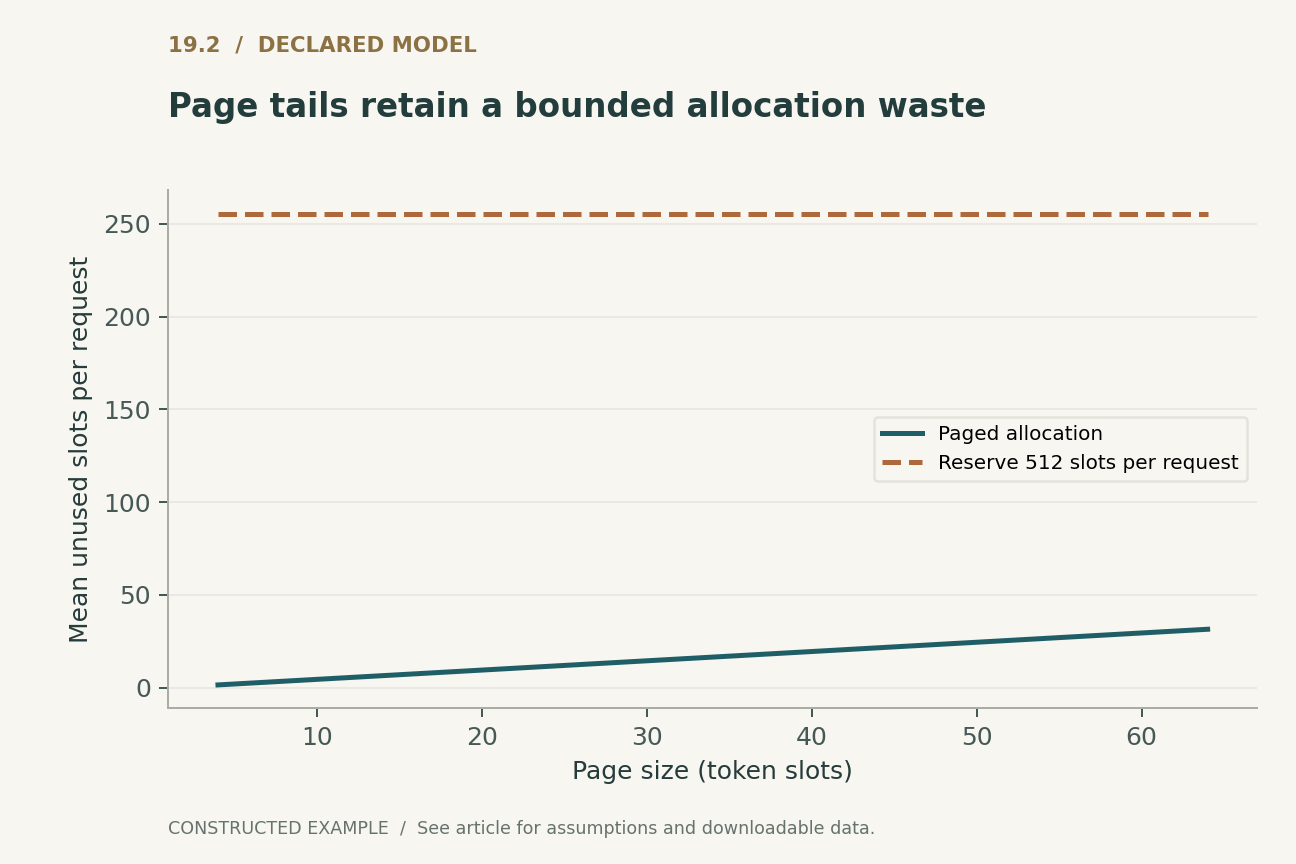
Si una solicitud de longitud T utiliza páginas de B posiciones de tokens, su capacidad asignada es B multiplicado por el resultado de redondear hacia arriba el cociente T/B al entero más próximo. Para una solicitud no vacía, la cola sin utilizar tiene entre cero y B menos una posiciones. Bajo una distribución uniforme de longitudes enteras desde uno hasta 512, y con un tamaño de página que divide a 512, el desperdicio medio de cola es exactamente (B menos uno) dividido entre dos. Un esquema que reserva 512 posiciones para cada solicitud desperdicia una media de 255.5 posiciones bajo la misma distribución construida. Esta comparación aísla la asignación de la cola; excluye los metadatos, el uso compartido, la fragmentación externa y la expulsión de caché. No reproduce las mediciones de memoria de vLLM ni afirma que las páginas más pequeñas sean siempre más rápidas.
6. La atención exacta sigue teniendo un contrato numérico
La atención densa forma puntuaciones escaladas entre consultas y claves, aplica softmax y multiplica por los valores. Una implementación que tenga en cuenta la E/S puede evitar materializar la matriz completa de puntuaciones procesando bloques y manteniendo estadísticas de normalización acumuladas. Esto reduce el almacenamiento intermedio y el movimiento de memoria sin convertir la atención densa en un problema aritmético generalmente subcuadrático. «Exacta» describe la operación de atención, no una promesa de identidad bit a bit para cualquier orden de evaluación en coma flotante. Una prueba de rendimiento debe indicar el tipo de datos, las reglas de acumulación, la tolerancia y el intervalo de entradas probado. Los logits extremos son especialmente útiles para las pruebas porque una implementación inestable puede desbordarse aunque un ejemplo aleatorio moderado parezca correcto. El apéndice incluye una pequeña comparación de softmax en línea en doble precisión como comprobación algebraica, no como validación de un kernel de GPU.
7. La planificación revela objetivos de latencia contrapuestos
Un lote grande puede mejorar la utilización del hardware y, al mismo tiempo, hacer esperar a una solicitud corta recién llegada. El trabajo de precarga y los pasos de decodificación también tienen formas distintas, por lo que un planificador de iteraciones debe decidir cómo compartir recursos entre solicitudes que se encuentran en etapas diferentes. El tiempo hasta el primer token mide una experiencia; la latencia entre tokens mide otra; el tiempo total de finalización mide una tercera. Ninguna puede inferirse únicamente de los tokens por segundo agregados. Deben comunicarse distribuciones por longitud de entrada y de salida, junto con las solicitudes fallidas y canceladas. Una política que rechaza tácitamente las entradas largas para mejorar las medias ha modificado la carga de trabajo admitida. Las reglas de admisión forman parte de la descripción experimental y deben incluirse al comparar la capacidad del servicio.
8. Los prefijos compartidos necesitan reglas de propiedad y duración
Reutilizar el estado de claves y valores para prefijos idénticos puede reducir el trabajo repetido, pero plantea cuestiones de identidad, mutabilidad y duración. Una clave de caché debe identificar todas las entradas que afectan al estado, incluidas la versión del modelo y la configuración de ejecución pertinente. Las páginas reutilizadas no deben permitir que una solicitud observe la continuación privada de otra ni que modifique incorrectamente el estado compartido. La cancelación y la expulsión deben liberar referencias sin liberar páginas que sigan en uso. Estas son obligaciones de corrección independientes de un resultado de rendimiento. Por tanto, una evaluación de despliegue debe incluir pruebas de aislamiento de solicitudes y casos de cancelación concurrente. Un kernel de atención matemáticamente válido no puede compensar un asignador o planificador que devuelve el estado de la solicitud equivocada.
9. Qué demuestra el complemento ejecutable
El complemento comprueba la contabilidad de bytes y un ejemplo de asignación de páginas con seis solicitudes. Después calcula pequeñas matrices de atención densa y las compara con una recurrencia de softmax en línea usando una semilla fija, varios tamaños de bloque y una tolerancia declarada. Entradas adicionales con logits grandes ponen a prueba la normalización numérica. Estas pruebas solo validan la construcción de Python suministrada. No ejecutan FlashAttention, PagedAttention ni Orca, y no ofrecen ninguna comparación de velocidad del hardware. Las figuras muestran los GiB de claves y valores frente al contexto retenido y el desperdicio medio de las colas de las páginas frente al tamaño de página. Se exportan todos los parámetros y matrices. El propósito es ofrecer a los lectores cálculos de recursos que puedan inspeccionar de forma independiente antes de interpretar una prueba completa de rendimiento del servicio.
10. Una prueba de rendimiento que respalda una decisión de despliegue
Fije el modelo, el tokenizador, la configuración numérica, el proceso de llegada y la distribución de longitudes. Compare los sistemas con los mismos objetivos de finalización y latencia, midiendo la memoria durante toda la precarga y la decodificación. Incluya las reglas de calentamiento, el estado de la caché, las cancelaciones, los fallos y las repeticiones independientes. Verifique salidas representativas o un criterio de aceptación numérica declarado antes de interpretar la velocidad. Después explique qué mecanismo cambió el resultado: menor desperdicio del estado, menor tráfico de memoria, mejor solapamiento o una compensación distinta en la planificación. Una conclusión sólida especifica la región en la que se sostiene y el recurso que se vuelve limitante fuera de ella. Los ejemplos analíticos de esta revisión respaldan esa disciplina; no certifican una capacidad de producción ni una clasificación universal de los motores de servicio.
Ejecutado localmente · Alcance acotado
Contabilidad de KV y páginas, más una comparación numérica de softmax en línea
Matrices pequeñas de NumPy en binary64; no es un kernel de GPU de FlashAttention, un motor de servicio ni una prueba de rendimiento.
Se superaron 15 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "bytes_per_token": 131072,
  "page_tail_slots": 32,
  "largest_absolute_error": 2.220446049250313e-16,
  "attention_cases": 8
}
Descargar los 20 ejemplos ejecutablesLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Solo claves y valores sin comprimir; excluye pesos, activaciones, metadatos, relleno y otros espacios de trabajo.
(2) N solicitudes no vacías, longitudes enteras de tokens y tamaño de página B; medido en posiciones de tokens.
(3) Longitudes enteras uniformes desde 1 hasta un múltiplo positivo de B, ambos inclusive; esta distribución es una construcción explícita.
(4) Normalización de softmax en línea para un nuevo bloque de puntuaciones; el acumulador de valores ponderados se reescala por el mismo factor.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Mecanismo | Recurso al que se dirige | Comprobación complementaria requerida |
|---|---|---|
| Paginación de claves y valores | Asignación y reutilización del estado | Propiedad, duración y memoria total |
| Atención que tiene en cuenta la E/S | Almacenamiento intermedio y tráfico de memoria | Tolerancia numérica y forma de la carga de trabajo |
| Planificación de iteraciones | Utilización de los lotes y progreso de las solicitudes | Latencias del primer token, entre tokens y de finalización |
| Control de admisión | Capacidad y sobrecarga | Solicitudes rechazadas y semántica de la carga de trabajo sin cambios |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Fije el modelo, el tokenizador, la precisión, los kernels y la configuración del planificador.
- Publique las llegadas, las longitudes de entrada, las longitudes de salida y las condiciones de parada.
- Valide el comportamiento numérico y la propiedad de las solicitudes antes de medir tiempos.
- Mida los máximos de uso de toda la memoria durante la precarga y la decodificación.
- Informe de las solicitudes completadas, las tres medidas de latencia, las cancelaciones y los fallos.
- Repita ejecuciones independientes con un estado de caché explícito y objetivos de servicio equivalentes.
Qué establecen las fuentes primarias
Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al. · 2023 [1]
Contribución. Los mecanismos de asignación paginada y uso compartido abordan la gestión del estado de claves y valores.
Límite. El cálculo construido del desperdicio excluye varios costes reales del asignador.
Localización en la fuente. Artículo de PagedAttention, descripción del diseño.
Tri Dao, Daniel Y. Fu, Stefano Ermon et al. · 2022 [2]
Contribución. La atención exacta que tiene en cuenta la E/S evita materializar grandes resultados intermedios mediante un algoritmo por bloques.
Límite. Una operación exacta no implica igualdad bit a bit universal ni aritmética densa subcuadrática.
Localización en la fuente. Artículo de FlashAttention, algoritmo y análisis de E/S.
Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al. · 2022 [3]
Contribución. La planificación a nivel de iteración aborda la ejecución de inferencia de transformadores en la capa de servicio.
Límite. Un resultado de rendimiento del planificador debe evaluarse junto con sus condiciones de latencia y carga de trabajo.
Localización en la fuente. Orca, descripción del diseño y de la planificación.
Límites de este análisis
- No se sometió a pruebas de rendimiento ninguna GPU ni motor de servicio.
- Las cifras de memoria incluyen únicamente el término de claves y valores o de asignación indicado.
- La implementación de softmax en línea es una pequeña comprobación en Python, no una implementación ni una validación de FlashAttention.
- Los artículos fuente seleccionados no abarcan todos los kernels, arquitecturas o sistemas de servicio posteriores.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos originales desarrollados. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso y versiones de las fuentes se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Cómo deberían los controladores de admisión reservar recursos para los picos de precarga sin dejar un margen ocioso excesivo?
- ¿Pueden comprobarse la propiedad y la recuperación de recursos de los prefijos compartidos independientemente de los kernels numéricos?
- ¿Qué familias de cargas de trabajo revelan cuándo la sobrecarga de paginación supera el ahorro por la reducción del desperdicio de cola?
Referencias
- Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al.. Efficient Memory Management for Large Language Model Serving with PagedAttention. Proceedings of the 29th Symposium on Operating Systems Principles (2023). 10.1145/3600006.3613165.
- Tri Dao, Daniel Y. Fu, Stefano Ermon et al.. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. Advances in Neural Information Processing Systems 35 (2022). Primary source.
- Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al.. Orca: A Distributed Serving System for Transformer-Based Generative Models. USENIX OSDI (2022). Primary source.
Acceso a la fuente [1]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [3]. Registro primario, resumen y texto accesible seleccionado; no es una auditoría exhaustiva del texto completo ni del material suplementario.
Las identidades bibliográficas se cotejaron con Crossref y con registros primarios de editoriales, autores o instituciones. Las notas sobre acceso y versiones de las fuentes que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.