
摘要
语言模型服务将规模较大的固定参数内存占用、依赖请求的注意力状态以及可变长度生成结合在一起。本综述关联 PagedAttention、FlashAttention 和 Orca,以区分三种机制:键值状态分配、注意力内存流量削减以及迭代级调度。我们推导多头与分组查询配置下的显式键值内存预算,在明确给定的长度分布下量化页尾浪费,并将小规模在线 softmax 计算与稠密注意力进行比较。配套曲线是核算模型,并非 GPU 基准测试,也不是对来源论文所报告加速效果的复现。其目的是揭示有关服务的主张何时悄然改变了精度、上下文长度、并发量、输出长度或服务目标。提出的评估方案同时报告首令牌时间、令牌间延迟、已完成请求吞吐量和内存使用峰值,并检查数值性质与请求隔离性质。高效内核与高效服务调度被视为相互补充、可分别检验的主张。
1. 服务结果需要有请求分布作为背景
模型标识符和 GPU 名称不足以定义一次服务实验。请求具有提示长度、生成长度、到达时间和完成标准。由短提示与长输出构成的工作负载,与以长预填充为主的工作负载,会对不同资源施加压力。并发量既改变活跃注意力状态的数量,也改变批处理的机会。停止条件同样可能改变测得的工作量:生成固定令牌预算与在应用专用分隔符处停止并不相同。因此,主要实验对象应是在明确给定的到达过程下,已完成请求的分布。令牌吞吐量仍有价值,但必须将其与这一分布以及调度器被要求满足的延迟目标关联起来。
2. 不应混淆的三种机制
PagedAttention 围绕分页分配与共享机制组织键值缓存管理。FlashAttention 通过感知 IO 的精确注意力算法减少注意力内存流量。Orca 为 Transformer 推理服务引入迭代级调度。这些机制分别针对分配、内核执行和调度。内存管理的改进本身并不能证明内核算术成本降低,而更快的注意力内核也不能证明请求调度公平。来源论文提供了具体实现和评估,但本文不复现其数值性能主张。本文的计算转而明确资源边界,使后续基准测试能够将收益归因于某种机制,而不是未被注意到的工作负载或精度变化。 [1], [2], [3]
3. 键值预算可以明确写出
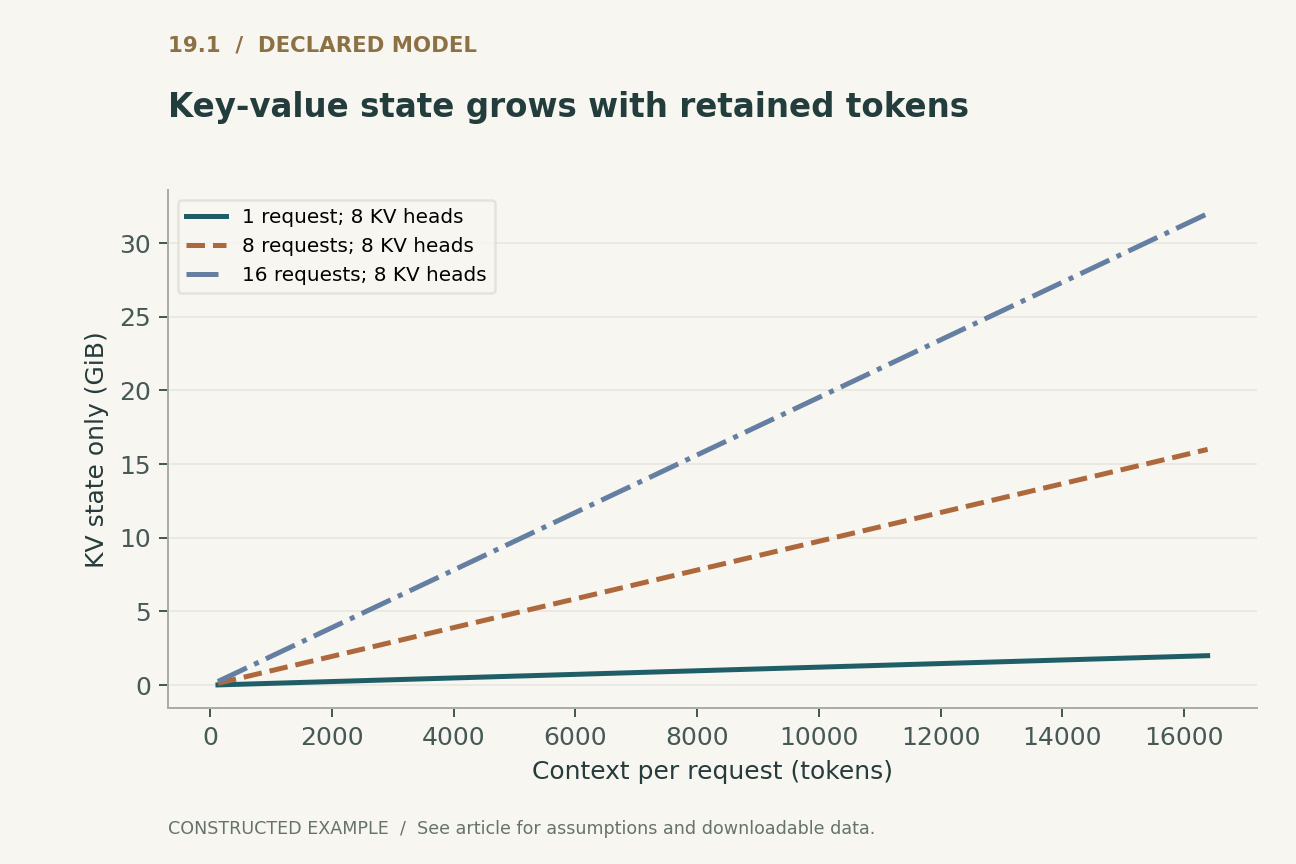
对于具有 L 层、H 个键值头、头维度 d、每个存储标量占 b 字节的解码器,未压缩的键值状态对每个保留令牌需要二乘 L 乘 H 乘 d 乘 b 字节。系数二对应键和值。再乘以所有活跃请求的保留序列长度之和。在 32 层、八个键值头、维度 128、每个标量二字节的条件下,每个令牌占 128 KiB。因此,一个长度为 4,096 个令牌的请求,仅此状态就占用 0.5 GiB。在其他假设完全相同的情况下,使用 32 个键值头会使其增至 2 GiB。这些是明确给定的架构示例,并非某个具名已部署模型的规格。
4. 分配效率并非内存预算的全部
模型权重、激活值、工作空间缓冲区、通信缓冲区以及分配器元数据也会消耗内存。临时预填充工作可能产生高于稳态解码阶段的内存峰值。量化权重不会自动量化键值缓存,而改变键值精度可能改变数值行为。容量估算应分别列出这些项,并为实现特定的开销预留余量。图中有意只绘制键值项,以保持严格可复现性。不应将其解读为 GPU 能够服务的请求数量。要得到该数量,需要在所选运行时、模型、内核配置和准入策略下,对完整内存使用情况进行实测。
5. 分页改变碎片化,但仍有残余成本
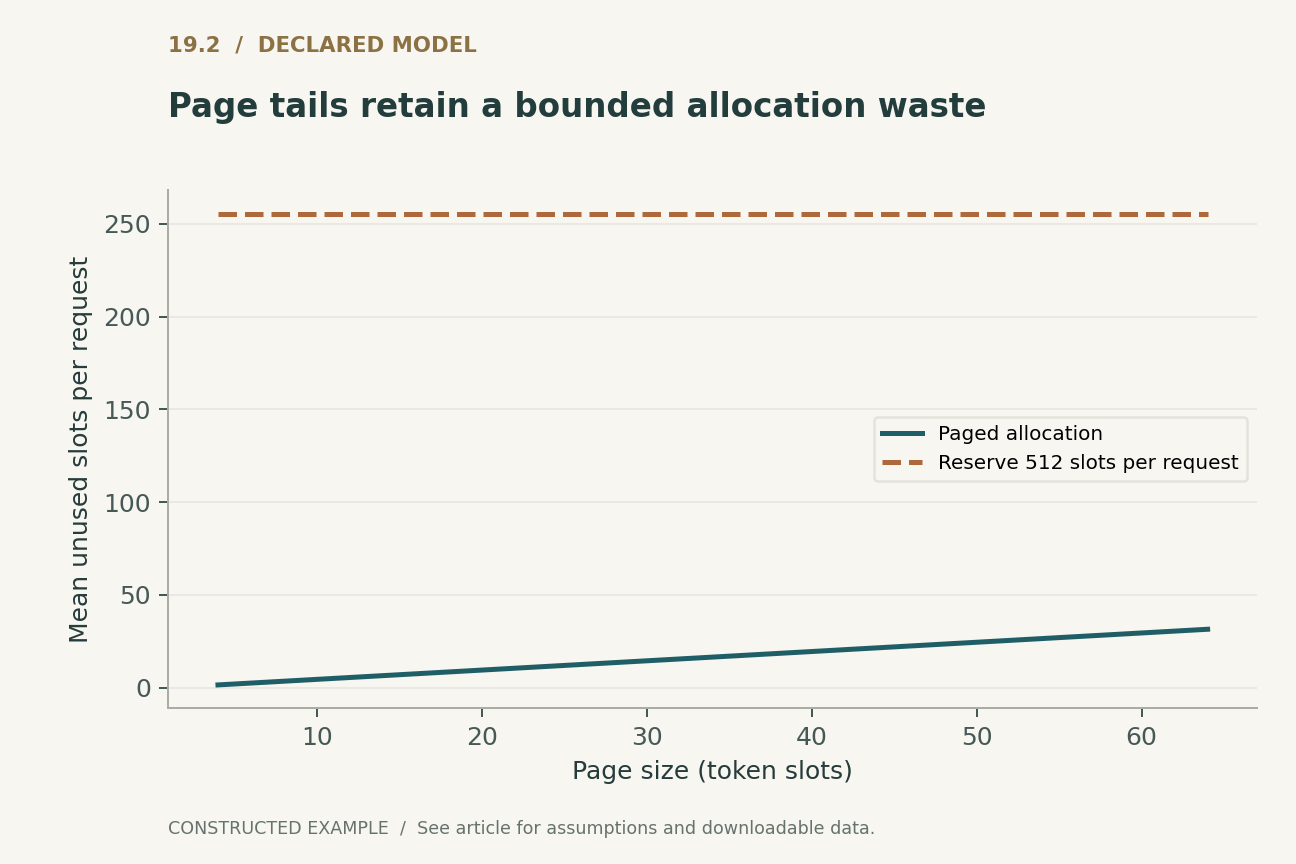
如果长度为 T 的请求使用每页含 B 个令牌槽位的页面,其分配容量就是 B 乘以 T 除以 B 后向上取整的结果。对于非空请求,未使用的尾部至少为零个槽位,至多为 B 减一个槽位。当整数长度在一至 512 之间均匀分布,且页面大小能够整除 512 时,平均尾部浪费恰好为 B 减一后除以二。在同一人为构造的分布下,为每个请求预留 512 个槽位的方案平均浪费 255.5 个槽位。这一比较单独考察尾部分配,不包括元数据、共享、外部碎片和缓存驱逐。它既不是对 vLLM 内存测量结果的复现,也不意味着更小的页面总是更快。
6. 精确注意力仍有数值契约
稠密注意力先形成缩放后的查询—键得分,应用 softmax,再与值相乘。感知 IO 的实现可以通过分块处理并维护累积归一化统计量,避免将完整得分矩阵实体化。这会减少中间存储和内存数据搬移,但并不会使稠密注意力在一般情况下变成次二次算术复杂度的问题。“精确”描述的是注意力运算,而不是承诺在所有浮点求值顺序下都逐位相同。基准测试应说明数据类型、累加规则、容差和测试输入范围。极端 logits 是尤其有用的测试输入,因为即使中等幅度的随机示例看起来正确,不稳定的实现仍可能溢出。附录包含一项小规模双精度在线 softmax 比较,用于代数检查,而非 GPU 内核验证。
7. 调度揭示相互竞争的延迟目标
大批次可能提高硬件利用率,同时让新到达的短请求等待。预填充工作与解码步骤的计算形状也不同,因此迭代调度器必须决定如何在处于不同阶段的请求之间共享资源。首令牌时间衡量一种体验,令牌间延迟衡量另一种体验,总完成时间则衡量第三种体验。任何一种都无法仅从汇总的每秒令牌数推断。应按提示长度和输出长度报告分布,并一并报告失败和取消的请求。为改善平均值而悄然拒绝长提示的策略,已经改变了准入的工作负载。准入规则属于实验描述的一部分,在比较服务容量时也应纳入。
8. 共享前缀需要所有权与生命周期规则
为相同前缀复用键值状态可以减少重复工作,但也引入了身份标识、可变性和生命周期问题。缓存键必须标识所有影响状态的输入,包括模型版本和相关执行配置。复用页面不得让某个请求观察到另一请求的私有续写内容,也不得让其错误修改共享状态。取消和驱逐需要释放引用,同时不能释放仍在使用的页面。这些是独立于吞吐量结果的正确性义务。因此,部署评估应包含请求隔离测试和并发取消情形。数学上有效的注意力内核,无法弥补返回了错误请求状态的分配器或调度器。
9. 配套可执行材料展示了什么
配套材料检查字节核算以及一个包含六个请求的页面分配示例。随后计算小规模稠密注意力数组,并使用固定随机种子、多个块大小和明确的容差,将其与在线 softmax 递推进行比较。额外的大 logits 输入用于检验数值归一化。这些测试仅验证所提供的 Python 构造。它们不执行 FlashAttention、PagedAttention 或 Orca,也不提供任何硬件速度比较。图表展示键值状态 GiB 数随保留上下文的变化,以及平均页尾浪费随页面大小的变化。所有参数和数组均予以导出。其目的是在读者解读完整的服务基准测试之前,提供可独立检查的资源计算。
10. 支持部署决策的基准测试
固定模型、分词器、数值配置、到达过程和长度分布。在相同的完成目标和延迟目标下比较系统,并在预填充与解码全程测量内存。纳入预热规则、缓存状态、取消、失败以及独立重复运行。在解读速度之前,验证代表性输出或明确给定的数值验收标准。随后解释是哪种机制改变了结果:状态浪费减少、内存流量降低、更好的重叠执行,还是不同的调度权衡。有力的结论应明确其成立的范围,以及超出该范围后成为瓶颈的资源。本综述中的分析示例支持这种规范,但不为生产环境容量或服务引擎的普遍排名提供认证。
已在本地执行 · 范围有限
KV 与页面核算,以及在线 softmax 数值比较
小规模 binary64 NumPy 数组;并非 FlashAttention GPU 内核、服务引擎或吞吐量基准测试。
15 项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
检查记录的验证见证
{
  "bytes_per_token": 131072,
  "page_tail_slots": 32,
  "largest_absolute_error": 2.220446049250313e-16,
  "attention_cases": 8
}明确给定的分析模型
四个方程与显式假设
(1) 仅包含未压缩的键和值;不包括权重、激活值、元数据、填充和其他工作空间。
(2) N 个非空请求,整数令牌长度,页面大小为 B;以令牌槽位计量。
(3) 整数长度从 1 到 B 的某个正整数倍均匀分布,两端均包含;此分布为显式构造。
(4) 针对新得分块的在线 softmax 归一化;加权值累加器按相同因子重新缩放。
构造示例 · 可复现数据
检查定量论证
这些曲线根据明确给定的模型计算而来,并非所引用研究中的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪类问题?
| 机制 | 针对的资源 | 所需的配套检查 |
|---|---|---|
| 键值分页 | 分配与状态复用 | 所有权、生命周期和总内存 |
| 感知 IO 的注意力 | 中间存储与内存流量 | 数值容差与工作负载形状 |
| 迭代调度 | 批次利用率与请求进度 | 首令牌延迟、令牌间延迟与完成延迟 |
| 准入控制 | 容量与过载 | 被拒绝的请求与不变的工作负载语义 |
提出的验证方案
这是一项拟议的评估设计。未执行生产系统或硬件基准测试。单独执行的有限模型记录在可执行检查中。
- 固定模型、分词器、精度、内核和调度器配置。
- 公布到达信息、提示长度、输出长度和停止条件。
- 计时前验证数值行为与请求所有权。
- 在预填充和解码期间测量完整内存使用峰值。
- 报告已完成请求、全部三项延迟指标、取消和失败。
- 在明确缓存状态并匹配服务目标的条件下,重复进行独立运行。
一手来源确立了什么
Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al. · 2023 [1]
贡献。 分页分配与共享机制针对键值状态管理。
边界。 构造的浪费计算排除了若干真实的分配器成本。
来源定位。 PagedAttention 论文,设计说明。
Tri Dao, Daniel Y. Fu, Stefano Ermon et al. · 2022 [2]
贡献。 感知 IO 的精确注意力通过分块算法,避免将大型中间结果实体化。
边界。 运算精确不意味着普遍的逐位相等,也不意味着稠密算术计算具有次二次复杂度。
来源定位。 FlashAttention 论文,算法与 IO 分析。
Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al. · 2022 [3]
贡献。 迭代级调度针对服务层的 Transformer 推理执行。
边界。 调度器的吞吐量结果必须结合其延迟和工作负载条件进行评估。
来源定位。 Orca,设计与调度说明。
本分析的局限
- 未对任何 GPU 或服务引擎进行基准测试。
- 内存数值仅包括所述键值项或分配项。
- 在线 softmax 实现是一项小规模 Python 检查,并非 FlashAttention 的实现或验证。
- 所选来源论文并未涵盖后续所有内核、架构或服务系统。
这是一篇聚焦于三项选定的奠基性一手来源、并附有原创计算示例的分析综述。它不是对截至 2026 年文献的穷尽性或系统性综述。来源访问情况与版本说明随参考文献记录。
可能改变结论的问题
- 准入控制器应如何为预填充峰值预留资源,同时避免过多闲置余量?
- 能否独立于数值内核检查共享前缀的所有权与资源回收?
- 哪些工作负载类别能够揭示分页开销何时超过减少尾部浪费带来的收益?
参考文献
- Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al.. Efficient Memory Management for Large Language Model Serving with PagedAttention. Proceedings of the 29th Symposium on Operating Systems Principles (2023). 10.1145/3600006.3613165.
- Tri Dao, Daniel Y. Fu, Stefano Ermon et al.. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. Advances in Neural Information Processing Systems 35 (2022). Primary source.
- Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al.. Orca: A Distributed Serving System for Transformer-Based Generative Models. USENIX OSDI (2022). Primary source.
来源 [1] 的访问情况。 一手记录、摘要及部分可访问正文;并非对全文或补充材料的穷尽性审查。
来源 [2] 的访问情况。 一手记录、摘要及部分可访问正文;并非对全文或补充材料的穷尽性审查。
来源 [3] 的访问情况。 一手记录、摘要及部分可访问正文;并非对全文或补充材料的穷尽性审查。
书目身份信息已与 Crossref 以及出版方、作者或机构的一手记录核对。下文的来源访问与版本说明描述了核查范围;这并非穷尽性的全文审查。
作者身份与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析构造与拟议评估设计归属于本文。
封面为 ImageGen 概念插图。技术图表由明确给定的模型或有限示例计算生成,并提供 Python 和 CSV。它们并非已部署产品的测量结果,也不是性能基准测试的复现。
此本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查所述小模型,并非对所引用系统的形式化验证。