
要旨
言語モデルのサービングでは、パラメータによる大きな固定メモリ占有量に、リクエスト依存の注意状態と可変長の生成が組み合わさる。本レビューはPagedAttention、FlashAttention、Orcaを関連付け、キー・バリュー状態の割り当て、注意計算に伴うメモリトラフィックの削減、反復単位のスケジューリングという三つの機構を区別する。マルチヘッド構成とグループ化クエリ構成についてキー・バリューメモリの予算を明示的に導出し、明示した長さ分布の下でページ末尾の浪費を定量化するとともに、小規模なオンラインsoftmax計算を密な注意計算と比較する。付属する曲線は使用量の算定モデルであり、GPUベンチマークでも、原論文の高速化結果の再現でもない。その目的は、サービングに関する主張において、精度、コンテキスト長、同時実行数、出力長、サービス目標が暗黙に変更される場合を明らかにすることである。提案する評価プロトコルでは、数値特性とリクエスト分離特性を検査しながら、最初のトークンまでの時間、トークン間レイテンシ、完了リクエストのスループット、メモリ使用量の最高水位を併せて報告する。カーネルの効率性とサービススケジューリングの効率性は、相互補完的であり、個別に検証可能な主張として扱う。
1. サービングの結果にはリクエスト分布が必要である
モデル識別子とGPU名だけでは、サービング実験を定義するには不十分である。リクエストには、プロンプト長、生成長、到着時刻、完了条件がある。短いプロンプトと長い出力からなるワークロードが負荷をかける資源は、長いプリフィルが支配的なワークロードのそれとは異なる。同時実行数は、使用中の注意状態の量とバッチ化の機会の両方を変える。停止条件も測定される仕事量を変えうる。固定されたトークン予算まで生成することと、アプリケーション固有の区切りで停止することは異なる。したがって、主要な実験対象は、明示された到着過程の下で完了したリクエストの分布であるべきである。トークンスループットは依然として有用だが、その分布と、スケジューラが満たすよう要求されたレイテンシ目標に結び付ける必要がある。
2. 混同すべきでない三つの機構
PagedAttentionは、ページ単位の割り当てと共有の機構を中心にキー・バリューキャッシュ管理を構成する。FlashAttentionは、入出力を考慮した厳密な注意アルゴリズムにより、注意計算のメモリトラフィックを削減する。Orcaは、Transformer推論のサービングに反復単位のスケジューリングを導入する。これらの機構は、それぞれ割り当て、カーネル実行、スケジューリングを対象とする。メモリ管理の改善だけでカーネルの算術コストの低下が立証されるわけではなく、注意カーネルの高速化だけで公平なリクエストスケジューリングが立証されるわけでもない。原論文は具体的な実装と評価を提供しているが、本記事はその数値的な性能主張を再現するものではない。代わりに、本記事の計算は資源の境界を明示し、後続のベンチマークが改善を、見過ごされたワークロードや精度の変更ではなく、特定の機構に帰属できるようにする。 [1], [2], [3]
3. キー・バリューの予算は明示的に定式化できる
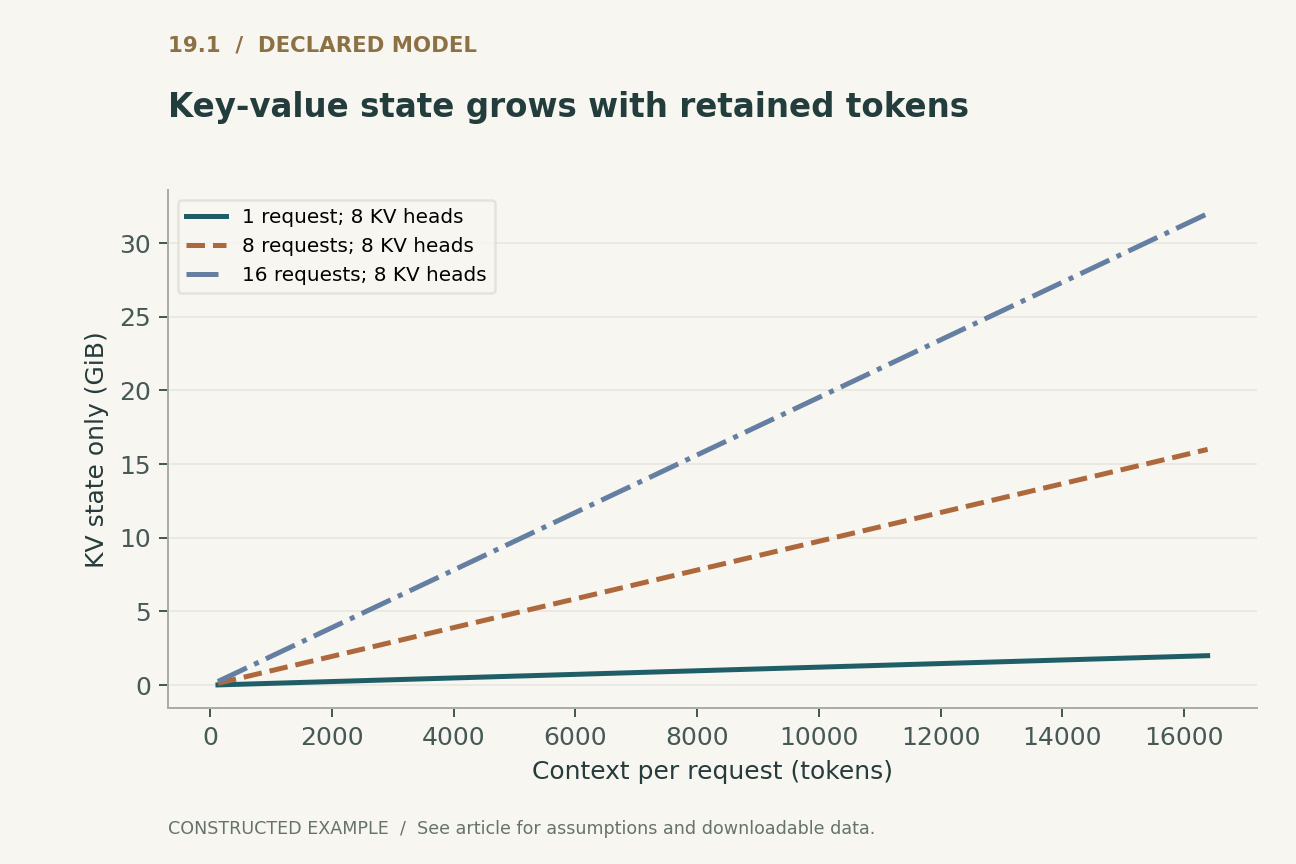
層数L、キー・バリューヘッド数H、ヘッド次元d、保存するスカラー当たりのバイト数bを持つデコーダでは、非圧縮のキー・バリュー状態に、保持トークン当たり二×L×H×d×bバイトが必要となる。係数の二はキーとバリューに対応する。これに、使用中の全リクエストにおける保持シーケンス長の総和を掛ける。32層、八つのキー・バリューヘッド、次元128、スカラー当たり二バイトの場合、トークン当たり128 KiBとなる。したがって、4,096トークンのリクエストは、この状態だけで0.5 GiBを使用する。他の仮定を同一にしてキー・バリューヘッドを32個にすると、2 GiBに増加する。これらは明示したアーキテクチャの例であり、特定の名称を持つデプロイ済みモデルの仕様ではない。
4. 割り当て効率だけではメモリ予算全体を捉えられない
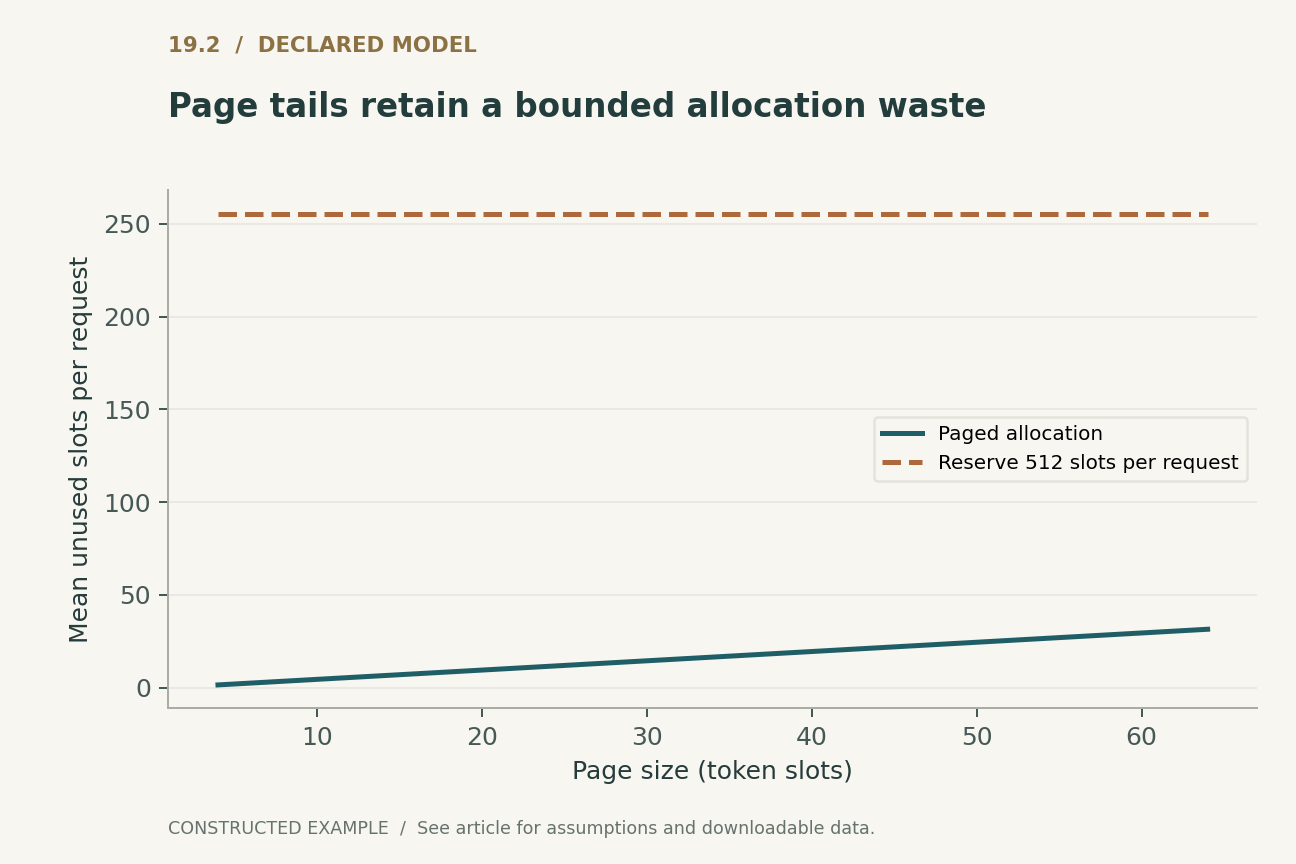
モデルの重み、活性値、ワークスペースバッファ、通信バッファ、アロケータのメタデータもメモリを消費する。プリフィル中の一時的な処理により、定常的なデコード時よりも高いメモリ使用量の最高水位が生じる場合がある。重みを量子化してもキー・バリューキャッシュが自動的に量子化されるわけではなく、キー・バリューの精度を変えると数値的挙動が変わりうる。容量推定では、これらの項を個別に列挙し、実装固有のオーバーヘッドのために余裕を確保する必要がある。図では厳密な再現性を保つため、意図的にキー・バリューの項だけを描いている。これをGPUが処理できるリクエスト数と解釈してはならない。その数を求めるには、選択したランタイム、モデル、カーネル構成、受け入れ方針の下で、メモリ全体の使用状況を測定する必要がある。
5. ページングは断片化を変えるが、残余コストがある
長さTのリクエストが、B個のトークンスロットからなるページを使う場合、その割り当て容量は、TをBで割った値の天井関数にBを掛けたものとなる。空でないリクエストでは、未使用の末尾は零スロット以上、Bから一を引いたスロット数以下である。一から512までの整数長が一様に分布し、ページサイズが512を割り切る場合、末尾の平均浪費は、Bから一を引いて二で割った値に厳密に等しい。各リクエストに512スロットを予約する方式では、同じ構成された分布の下で、平均255.5スロットが浪費される。この比較は末尾の割り当てだけを切り分けたものであり、メタデータ、共有、外部断片化、キャッシュからの追い出しは含まない。vLLMのメモリ測定の再現ではなく、ページが小さいほど常に高速であるという主張でもない。
6. 厳密な注意計算にも数値的な契約がある
密な注意計算は、スケーリングしたクエリ・キーのスコアを形成し、softmaxを適用して、バリューを乗じる。入出力を考慮した実装では、ブロックを処理し、逐次的な正規化統計量を維持することで、完全なスコア行列の実体化を回避できる。これにより、中間記憶とメモリ間のデータ移動は削減されるが、密な注意計算が一般に劣二次の算術計算問題へ変わるわけではない。「厳密」とは注意演算を記述するものであり、浮動小数点のあらゆる評価順序でビット単位の一致を保証するものではない。ベンチマークでは、データ型、累積規則、許容誤差、検査した入力範囲を明示すべきである。極端なロジットは特に有用な検査対象となる。中程度のランダムな例で正しく見えても、不安定な実装ではオーバーフローが起こりうるためである。付録には、GPUカーネルの検証ではなく代数的な確認として、倍精度による小規模なオンラインsoftmax比較を含める。
7. スケジューリングが明らかにする競合するレイテンシ目標
大きなバッチはハードウェア利用率を改善する一方で、新たに到着した短いリクエストを待たせる場合がある。プリフィル処理とデコードステップでは計算形状も異なるため、反復スケジューラは、異なる段階にあるリクエスト間で資源をどのように共有するかを決めなければならない。最初のトークンまでの時間は利用体験の一側面を測り、トークン間レイテンシは別の側面を測り、総完了時間はさらに別の側面を測る。いずれも、集計された毎秒トークン数だけからは推定できない。失敗したリクエストやキャンセルされたリクエストと併せて、プロンプト長と出力長ごとの分布を報告すべきである。平均値を改善するために長いプロンプトを暗黙に拒否する方針は、受け入れるワークロードを変更している。受け入れ規則は実験記述の一部であり、サービス容量を比較する際にも含めるべきである。
8. 共有プレフィックスには所有権と寿命の規則が必要である
同一のプレフィックスについてキー・バリュー状態を再利用すると、重複した処理を減らせるが、同一性、可変性、寿命に関する問題が生じる。キャッシュキーは、モデルのバージョンや関連する実行構成を含め、状態に影響するすべての入力を識別しなければならない。再利用されるページによって、あるリクエストが別のリクエストの非公開の継続部分を参照したり、共有状態を不適切に変更したりできてはならない。キャンセルと追い出しでは、使用中のページを解放せずに参照を解放する必要がある。これらは、スループットの結果とは独立した正しさの要件である。したがって、デプロイ評価にはリクエスト分離の検査と同時キャンセルの事例を含めるべきである。数学的に妥当な注意カーネルでも、誤ったリクエストの状態を返すアロケータやスケジューラを補うことはできない。
9. 付属の実行可能資料が示すこと
付属資料では、バイト数の算定と、六つのリクエストからなるページ割り当ての例を検査する。次に、小規模な密な注意配列を計算し、固定シード、複数のブロックサイズ、明示した許容誤差を用いて、オンラインsoftmaxの漸化式と比較する。大きなロジットを持つ追加の入力で、数値的な正規化を検査する。これらの検査が検証するのは、提供したPythonによる構成だけである。FlashAttention、PagedAttention、Orcaは実行せず、ハードウェアの速度比較も提供しない。図は、保持コンテキストに対するキー・バリューのGiB数と、ページサイズに対するページ末尾の平均浪費を示す。すべてのパラメータと配列をエクスポートする。その目的は、読者が完全なサービングベンチマークを解釈する前に、独立に確認できる資源計算を提供することである。
10. デプロイ判断を支えるベンチマーク
モデル、トークナイザ、数値構成、到着過程、長さ分布を固定する。同じ完了目標とレイテンシ目標の下でシステムを比較し、プリフィルとデコードを通してメモリを測定する。ウォームアップ規則、キャッシュ状態、キャンセル、失敗、独立した反復実行を含める。速度を解釈する前に、代表的な出力、または明示した数値的受け入れ基準を検証する。その上で、状態の浪費削減、メモリトラフィックの低下、重畳の改善、あるいは異なるスケジューリング上のトレードオフのうち、どの機構が結果を変えたかを説明する。強固な結論は、それが成立する領域と、その領域外で制約となる資源を特定する。本レビューの解析例は、この姿勢を支えるものであり、本番環境の容量やサービングエンジンの普遍的な順位を保証するものではない。
ローカルで実行済み · 限定された範囲
KVとページの使用量算定、およびオンラインsoftmaxの数値比較
小規模なbinary64のNumPy配列を使用する。FlashAttentionのGPUカーネル、サービングエンジン、スループットベンチマークではない。
15件のアサーションが合格した。 これらの検査は、提供した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認する
{
  "bytes_per_token": 131072,
  "page_tail_slots": 32,
  "largest_absolute_error": 2.220446049250313e-16,
  "attention_cases": 8
}明示された解析モデル
四つの方程式と明示的な仮定
(1) 非圧縮のキーとバリューのみ。重み、活性値、メタデータ、パディング、その他のワークスペースは含まない。
(2) 空でないN件のリクエスト、整数のトークン長、ページサイズBを仮定し、トークンスロット単位で測る。
(3) 1からBの正の倍数まで、両端を含む整数長の一様分布。この分布は明示的に構成したものである。
(4) 新しいスコアブロックに対するオンラインsoftmaxの正規化。重み付きバリューの累積量も同じ係数で再スケーリングする。
構成した例 · 再現可能なデータ
定量的な論証を確認する
これらの曲線は、明示したモデルから計算したものである。引用した研究の観測値ではない。各図には数値データとベクター版を付属する。


どの証拠がどの問いに答えるのか
| 機構 | 対象となる資源 | 必要な補完的検査 |
|---|---|---|
| キー・バリューのページング | 割り当てと状態の再利用 | 所有権、寿命、総メモリ量 |
| 入出力を考慮した注意計算 | 中間記憶とメモリトラフィック | 数値的許容誤差とワークロードの形状 |
| 反復スケジューリング | バッチ利用率とリクエストの進行 | 最初のトークン、トークン間、完了までのレイテンシ |
| 受け入れ制御 | 容量と過負荷 | 拒否されたリクエストとワークロードの意味の不変性 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検査の中に記録している。
- モデル、トークナイザ、精度、カーネル、スケジューラ構成を固定する。
- 到着情報、プロンプト長、出力長、停止条件を公開する。
- 時間測定の前に、数値的挙動とリクエストの所有権を検証する。
- プリフィルとデコードの間、メモリ全体の使用量の最高水位を測定する。
- 完了したリクエスト、三種類すべてのレイテンシ指標、キャンセル、失敗を報告する。
- キャッシュ状態を明示し、サービス目標を揃えて、独立した実行を繰り返す。
一次資料が立証していること
Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al. · 2023 [1]
貢献。 ページ単位の割り当てと共有の機構は、キー・バリュー状態の管理を対象とする。
適用限界。 構成した浪費計算には、実際のアロケータに伴う複数のコストが含まれていない。
出典内の該当箇所。 PagedAttention論文、設計の説明。
Tri Dao, Daniel Y. Fu, Stefano Ermon et al. · 2022 [2]
貢献。 入出力を考慮した厳密な注意計算は、ブロックアルゴリズムによって大きな中間結果の実体化を回避する。
適用限界。 演算の厳密性は、普遍的なビット単位の一致や、密な算術計算の劣二次計算量を意味しない。
出典内の該当箇所。 FlashAttention論文、アルゴリズムと入出力解析。
Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al. · 2022 [3]
貢献。 反復単位のスケジューリングは、サービング層におけるTransformer推論の実行を対象とする。
適用限界。 スケジューラのスループット結果は、そのレイテンシ条件およびワークロード条件とともに評価しなければならない。
出典内の該当箇所。 Orca、設計とスケジューリングの説明。
本分析の限界
- GPUやサービングエンジンのベンチマークは実施していない。
- メモリの数値に含まれるのは、明示したキー・バリュー項または割り当て項のみである。
- オンラインsoftmaxの実装は、Pythonによる小規模な確認であり、FlashAttentionの実装や検証ではない。
- 選択した原論文は、その後のすべてのカーネル、アーキテクチャ、サービングシステムを網羅していない。
選択した三つの基礎的な一次資料に焦点を当て、独自の計算例を添えた解析的レビューである。2026までの文献を網羅的または体系的に調査したものではない。資料へのアクセスとバージョンに関する注記は、参考文献とともに記録する。
結論を変えうる問い
- 受け入れ制御器は、過剰な未使用の余裕を残さずに、プリフィル時のピークに備えてどのように資源を予約すべきか。
- 共有プレフィックスの所有権と資源回収は、数値カーネルとは独立に検査できるか。
- ページングのオーバーヘッドが末尾の浪費削減による利得を上回る条件を明らかにするのは、どのようなワークロード群か。
参考文献
- Woosuk Kwon, Zhuohan Li, Siyuan Zhuang et al.. Efficient Memory Management for Large Language Model Serving with PagedAttention. Proceedings of the 29th Symposium on Operating Systems Principles (2023). 10.1145/3600006.3613165.
- Tri Dao, Daniel Y. Fu, Stefano Ermon et al.. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. Advances in Neural Information Processing Systems 35 (2022). Primary source.
- Gyeong-In Yu, Joo Seong Jeong, Geon-Woo Kim et al.. Orca: A Distributed Serving System for Transformer-Based Generative Models. USENIX OSDI (2022). Primary source.
資料[1]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部を確認した。全文または補足資料の網羅的な監査ではない。
資料[2]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部を確認した。全文または補足資料の網羅的な監査ではない。
資料[3]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部を確認した。全文または補足資料の網羅的な監査ではない。
書誌情報の同定は、Crossrefおよび出版社、著者、機関の一次記録と照合した。以下の資料アクセスおよびバージョンに関する注記は、その範囲を記述するものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示する。解析的構成と提案した評価設計は、本記事に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示したモデルまたは有限の例から計算し、PythonとCSVを提供する。これらは、デプロイ済み製品の測定値でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読または学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示した小規模モデルを確認するものであり、引用したシステムの形式検証ではない。