
要旨
コンピュータシステムのベンチマークは観測を比較に関する主張へと変換するが、その過程の妥当性は実験設計に依存する。本レビューは、測定バイアス、厳密な性能評価、無作為化された実行時配置に関する研究を関連づけ、反復観測と独立した実験単位を区別する。階層的分散モデルにより、同一実行内の反復を増やしても実行間の不確実性を除去できない理由を示す。構成したワークロード混合の例により、各ワークロードでは高速なシステムでも、比較する混合比が異なれば低速に見えうることを示す。両図は解析的な例示であり、コンパイラやサービスの測定ではない。実行可能な付属資料では、分散計算、混合による逆転、幾何平均による高速化率の単位不変性を検査する。提案するプロトコルは、介入、母集団、反復の単位、除外規則、実用上の効果量を明示する。目的は、不明確な比較に狭い信頼区間を付けることではなく、適用範囲を擁護できる主張を得ることである。
1. 計時の前に主張を定める
ベンチマークは、明確に定義された実行の母集団に関する問いから始めるべきである。主張の対象は、単一マシン上の単一バイナリか、複数のマシンにまたがる将来のデプロイメントか、それともワークロード群か。対象ごとに必要な反復と標本抽出は異なる。介入も明確でなければならない。コンパイラのフラグを変更する際に、メモリ配置、入力順序、プロセスの存続期間も変更していては、そのフラグの効果を分離できない。精密な計時でも曖昧な介入は修復できない。要約統計量を選ぶ前に、推定対象を通常の言葉で述べる。例えば、到着分布と資源予算を固定した条件下での、完了したリクエストのレイテンシの変化である。これにより、収集した観測が意図した問いに実際に答えているかを判断できる。
2. 一次研究が警告すること
Mytkowiczらは、一見無害な実験条件がコンピュータシステムの測定にバイアスを生じさせうることを示している。KaliberaとJonesは、適切な階層で性能の変動と実験の反復を扱うための枠組みを構築している。Stabilizerは、無作為化された実行時配置を用いて、性能評価における配置依存の効果に対処する。これらの貢献は、それぞれ異なる安易な手法に疑問を投げかける。すなわち、設定の選択を無害だと仮定すること、あらゆる反復を同等と扱うこと、単一の好都合な配置から因果関係を推論することである。これらは、すべてのベンチマークが無効であることも、無作為化があらゆる交絡因子を解消することも意味しない。共通する方法論的価値は、変動の源を設計に組み込む点にある。参考文献には、アクセス可能なKaliberaとJonesの著者記録が訂正版原稿を明示していることも記載し、版の来歴を明確にしている。 [1], [2], [3]
3. 反復には階層がある
実行rには実行固有のオフセットがあり、その内部の各反復には追加のノイズがあるとする。反復を増やして平均すれば実行内成分は減少するが、新たな独立した実行オフセットが生まれるわけではない。単純な変量効果モデルでは、総平均の分散は、実行数で割った実行間項と、実行数と反復数の両方で割った実行内項を含む。プロセスの起動が一度だけなら、内部ループを何千回測定しても、同じ配置、熱履歴、ランタイム状態を共有している可能性がある。これらを何千もの独立したデプロイメントと扱えば、デプロイメント間の挙動に関する不確実性を過小評価する。適切な反復単位は主張に従うのであり、タイマーのサンプリング頻度に従うのではない。
4. 精度を制約する誤差の下限を可視化する
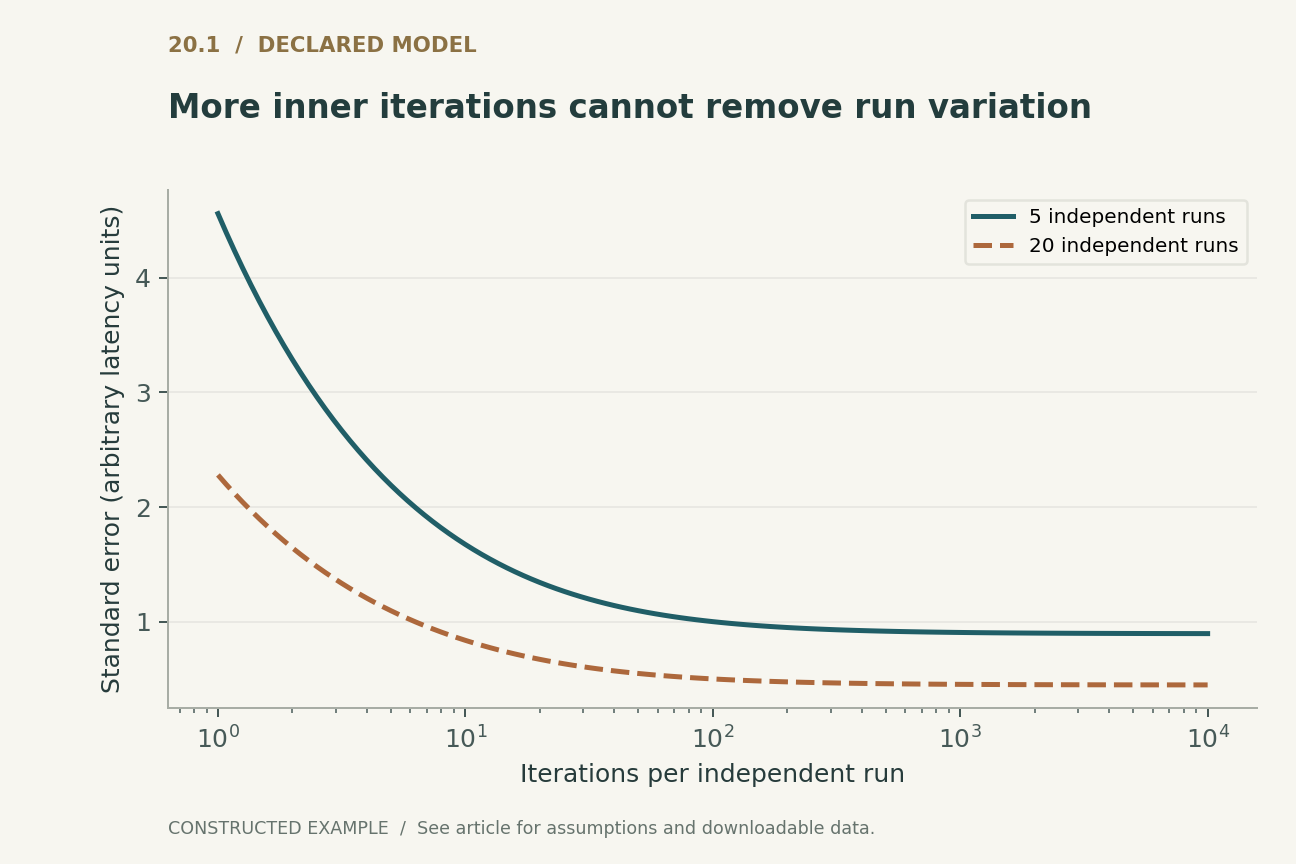
最初の図では、実行間標準偏差を任意のレイテンシ単位で二、実行内標準偏差を十に固定する。そのうえで、五回または二十回の独立した実行について反復数を増やす。標準誤差は、実行間項で決まる正の下限に近づく。これらの数値は意図的に構成したものであり、実システムからの推定値ではない。目的は、一度の起動内で反復を大幅に増やすよりも、独立した起動を追加する方が実験に有益となりうる理由を示すことである。実際の研究では、実行間の定常性と独立性が妥当かを確認しつつ、分散成分を推定するか、クラスタ構造を考慮した適切な分析を用いるべきである。誤った階層構造に基づいて計算した狭い区間は、対象母集団についての精度を確立しない。
5. ワークロードの混合が主要な結論を逆転させうる
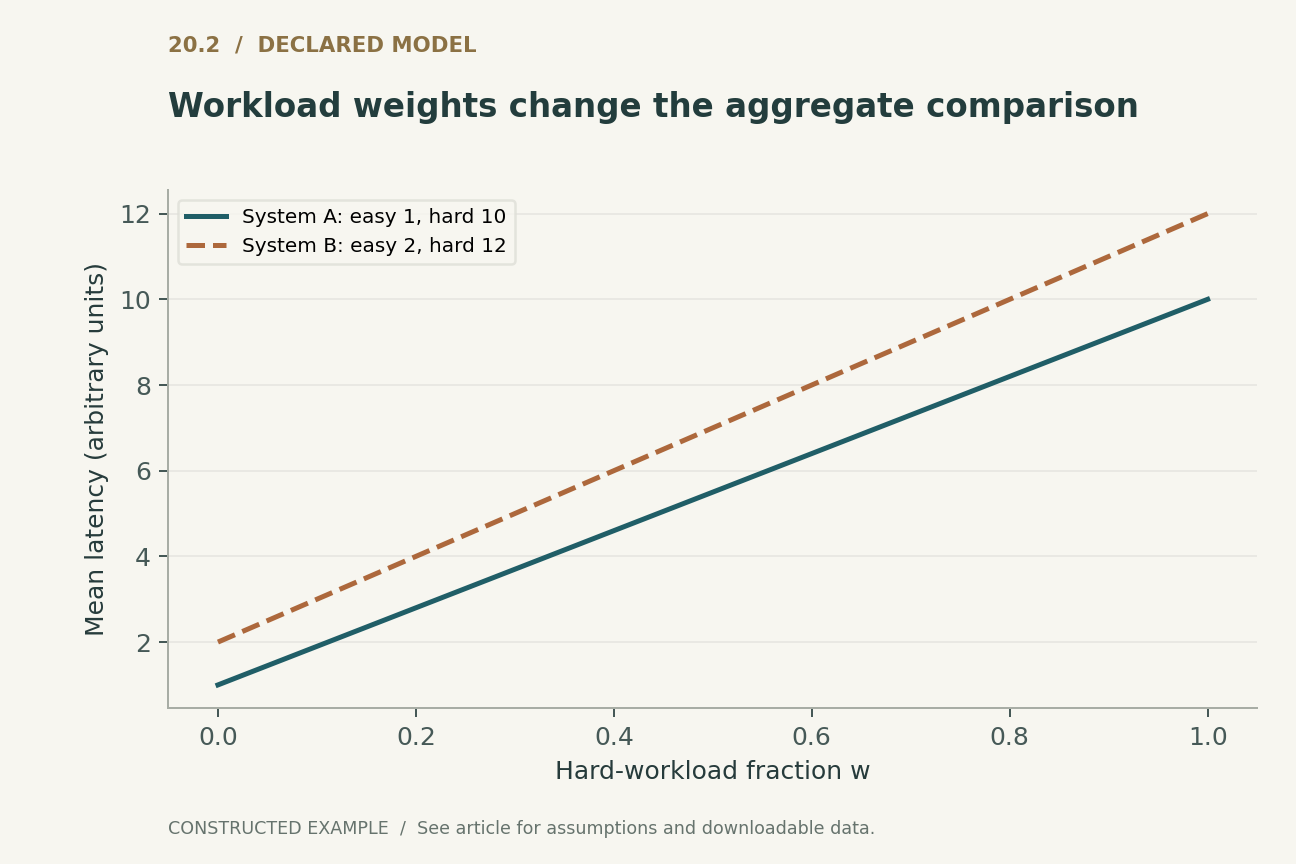
二つのワークロードクラスを考える。システムAは容易なクラスで一単位、困難なクラスで十単位を要し、システムBはそれぞれ二単位と十二単位を要する。Aはどちらのクラス内でも高速である。Aを困難な処理が九割の条件で測定すると、平均は9.1となる。Bを困難な処理が一割の条件で測定すると、平均は3.0となる。ワークロードが異なるため、集約した比較ではAが低速に見える。同じ半々の混合であれば、平均は5.5と7.0となる。これは構成した交絡の例であり、製品についての証拠ではない。集約した差を実装の効果と解釈する前に、ベンチマークがワークロード構成を報告し、比較を標準化または層別化しなければならない理由を示している。
6. 集約が問いを定義する
レイテンシの算術平均は、ワークロード別高速化率の幾何平均とは異なる問いに答える。後者は、各ワークロードを等重みとした場合、比の対数に等しい重みを与える。一方、総実行時間の比は、長時間を要するワークロードの影響を大きくする。どちらも自動的に正しいわけではない。選択は、対象が等重みのテストスイートか、デプロイメント時のワークロード分布か、総計算コストか、レイテンシに関するサービス目標かに依存する。読者が別の重みづけを再構成できるよう、各構成要素の結果を報告すべきである。単位の変更によって無次元の高速化率が変わるべきではないが、ワークロードの重みの変更によって変わることは正当である。実行可能な付属資料は前者の性質を検査し、本記事は後者の選択を単一のスコアに隠さず可視化する。
7. 無作為化と対応づけは特定の問題に対処する
実行順序の無作為化は、処置と時間変動する条件との関連を低減しうる。近接した実行やその他の条件を一致させた実行を対応づけると、対応づけの変数が関連性を持ち、事前に指定されている場合にはノイズを低減しうる。いずれの方法も独立性を保証せず、すべての持ち越し効果を除去するわけでもない。ウォームアップ済みのキャッシュ、コンパイル済みのランタイム、熱状態、共有されたバックグラウンドのワークロードは、処置をまたいで持続しうる。設計ではリセット手順を記述し、順序効果を検査すべきである。配置の無作為化は配置依存性の一類型に対処するが、ワークロードの選択や正しい計時範囲を代替しない。分析は、単に便利だから独立標本の式を適用するのではなく、実験で用いた割付とグループ化の構造に従わなければならない。
8. 失敗した実行も観測である
困難なリクエストでタイムアウトするサービスを、成功して完了した処理だけで評価するなら、その選択を説明しなければならない。失敗を除外すると、不安定なシステムが高速に見えることがある。同様に、結果を見た後で遅い実行を捨てると、デプロイメントで実際に遭遇する干渉そのものを取り除いてしまう可能性がある。観測可能な設定上の失敗に基づく除外基準を事前に定め、その規則と除外した観測数の両方を公開すべきである。再試行がサービス契約の一部であれば、それに伴う資源消費とエンドツーエンドの遅延を含める。ベンチマークは、主張が成功を条件とした成功処理に関するものか、投入されたワークロード全体に関するものかを報告すべきである。両者は異なる推定対象であり、区別のないレイテンシ値を共用すべきではない。
9. 付属資料が検査することと、検査できないこと
付録では、明示した階層モデルの共分散行列を構成して平均の分散を直接計算し、閉形式の式と比較する。また、二クラスのワークロードによる逆転を検査し、両システムの時間をある単位から別の単位へ換算しても、幾何平均による高速化率が変わらないことを確認する。こうした決定論的な検査は、代数や集約の誤りを発見しうる。しかし、実際のベンチマークデータの信頼区間を推定したり、ハードウェアの因果モデルの妥当性を検証したり、Stabilizerの有効性を確立したりするものではない。実際の評価には、独立したデータと設計に適した分析が必要である。図は、よくある推論の誤りに対する検査可能な反例であり、性能結果ではない。
10. 懐疑的な読解を可能にする報告
擁護可能な報告は、ワークロード生成器またはトレース、システム構成、計時範囲、実行の階層構造、無作為化、除外、分析コードを公開する。効果の不確実性とともに、その実用上の重要性を述べる。多数の構成を探索した場合は、探索的な選択と、新たな実行による確認的な比較を区別する。結論では、適用される母集団と、その結論が成り立たなくなる可能性の高い条件を明示する。このような報告により、控えめな結果が、劇的ではあっても脆弱な高速化より価値を持ちうる。基準は、あらゆる変動源が消失することではない。読者が、何を変更し、何を固定し、どのように不確実性を評価し、どの代替説明が残っているかを特定できることである。
ローカルで実行済み · 限定された範囲
共分散計算、ワークロードによる逆転、単位不変性
構成した統計量であり、経験的な信頼区間や製品性能の比較ではない。
6件のアサーションが成功した。 これらの検査が検証するのは提示した例であり、引用したシステムではない。
記録された検証証跡を調べる
{
  "variance": [
    {
      "runs": 2,
      "iterations": 3,
      "direct": 18.666666666666664,
      "formula": 18.666666666666668
    },
    {
      "runs": 5,
      "iterations": 4,
      "direct": 5.800000000000001,
      "formula": 5.8
    },
    {
      "runs": 10,
      "iterations": 2,
      "direct": 5.399999999999999,
      "formula": 5.4
    }
  ],
  "unmatched_means": [
    9.1,
    3.0
  ],
  "matched_means": [
    5.5,
    7.0
  ]
}明示された解析モデル
四つの式と明示的な仮定
(1) 分散がsigma_bの二乗である独立した実行効果Uと、分散がsigma_wの二乗である独立した実行内誤差。明示されたモデルであり、データへの当てはめではない。
(2) 記述した均衡階層構造における、各J回の反復を持つR回の独立した実行。
(3) 容易・困難なワークロードについて構成したレイテンシ値。wは困難なワークロードの割合であり、直接比較には一致させる必要がある。
(4) 正のワークロード別高速化率の等重み幾何平均。総時間の比とは異なる推定対象である。
構成した例 · 再現可能なデータ
定量的な論拠を調べる
これらの曲線は明示したモデルから計算したものであり、引用研究から得られた観測ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるのか
| 設計上の選択 | 解決する問い | 省略した場合の失敗形態 |
|---|---|---|
| 実験単位 | 何を独立した反復とみなすか | 疑似反復 |
| ワークロードの重み | 集約値がどの母集団を代表するか | 混合による交絡 |
| 計時範囲 | 結果指標にどの処理を含めるか | 隠れた準備処理や再試行 |
| 事前に明示した除外 | どの観測を分析に含めるか | 結果を見た後の選択 |
提案する検証プロトコル
これは評価設計の提案である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルについては、実行可能な検査に記載している。
- 測定前に、推定対象と実用上意味のある効果の閾値を記述する。
- 介入、ワークロードの重み、計時範囲を指定する。
- 独立した実行単位を選び、入れ子になった反復構造を記録する。
- 適切に無作為化または対応づけを行い、リセットと持ち越し効果を記録する。
- 失敗を保持し、事前に明示した除外基準だけを適用する。
- 構成要素ごとの結果、不確実性の評価方法、生データ、ワークロードの重みづけに対する感度を公開する。
一次資料が確立していること
Todd Mytkowicz, Amer Diwan, Matthias Hauswirth et al. · 2009 [1]
貢献。 一見無害な設定上の選択が、性能測定にバイアスを生じさせうる。
適用限界。 この結果は明示的な統制の必要性を示すものであり、すべてのベンチマークが誤りだという主張を支持するものではない。
出典の所在。 ASPLOS論文およびIBMの出版記録。
Tomas Kalibera, Richard Jones · 2013 [2]
貢献。 性能評価は、関連する反復階層での変動を考慮すべきである。
適用限界。 ここで用いるモデルは簡略化した解析的構成であり、当該論文の評価を再現したものではない。
出典の所在。 University of Kentにある著者訂正版原稿の記録。
Charlie Curtsinger, Emery D. Berger · 2013 [3]
貢献。 無作為化された実行時配置は、配置に依存する測定効果に対処しうる。
適用限界。 配置の無作為化は、ワークロードによる交絡やあらゆる変動源を除去するものではない。
出典の所在。 Stabilizer、その機構と実験上の枠組み。
本分析の限界
- 実システムのベンチマークは行っておらず、経験的な信頼区間も主張していない。
- 均衡した変量効果モデルは、いくつかの可能な依存関係と非定常性を扱わない。
- 二つのワークロードによる逆転は、意図的に構成した例である。
- 対象を絞った参考文献は、実験設計や因果推論の包括的な論述を代替しない。
選定した三つの基礎的な一次資料に焦点を当て、独自の計算例を含めた解析的レビューである。2026までの文献を網羅的または体系的に調査したものではない。出典へのアクセスと版に関する注記は参考文献に記録している。
結論を変えうる問い
- 現代の異種混在システムにおいて、デプロイメント間の性能を支配する分散成分は何か。
- ベンチマークスイートは、正当な対象となる複数のユーザー母集団を反映したワークロードの重みをどのように公開できるか。
- 探索的な調整と確認的な評価を区別できる報告形式は何か。
参考文献
- Todd Mytkowicz, Amer Diwan, Matthias Hauswirth et al.. Producing wrong data without doing anything obviously wrong!. Proceedings of the 14th international conference on Architectural support for programming languages and operating systems (2009). 10.1145/1508244.1508275.
- Tomas Kalibera, Richard Jones. Rigorous benchmarking in reasonable time. Proceedings of the 2013 international symposium on memory management (2013). 10.1145/2464157.2464160.
- Charlie Curtsinger, Emery D. Berger. STABILIZER: statistically sound performance evaluation. Proceedings of the eighteenth international conference on Architectural support for programming languages and operating systems (2013). 10.1145/2451116.2451141.
出典[1]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部。全文や補足資料の網羅的な監査ではない。
出典[2]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部。全文や補足資料の網羅的な監査ではない。
版に関する注記。 リンク先のUniversity of Kentの記録は、著者訂正版原稿であることを明示している。方法論の詳細にはその版を参照すること。
出典[3]へのアクセス。 一次記録、要旨、アクセス可能な本文の一部。全文や補足資料の網羅的な監査ではない。
書誌事項の同一性は、Crossrefならびに出版社、著者、機関の一次記録と照合した。以下のアクセスと版に関する注記は確認範囲を示すものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献には元の研究者を明示している。解析的構成と提案する評価設計は本記事に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。稼働中の製品の測定や、性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌への採録の記録はない。範囲を限定した実行可能な例は、記述した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。