
Resumen
Una elevada precisión predictiva no responde automáticamente a la pregunta «¿qué ocurriría si se modificara un factor?». Este artículo distingue entre distribuciones condicionales observacionales y distribuciones de intervención, deriva mediante ecuaciones estructurales explícitas cómo la confusión modifica las asociaciones y examina las condiciones del ajuste por puerta trasera, la identificación de representaciones y los cambios de distribución. Las figuras proceden de un modelo con un factor de confusión binario enumerable exhaustivamente, cuyas variables y probabilidades se exponen por completo; no se trata de un estudio de una población real ni de los efectos de una política.[1] Towards Causal Representation Learning[2] Invariant Risk Minimization[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
Traducción del resumen original en inglés
La inferencia causal requiere supuestos de identificación además de precisión predictiva. Distinguimos el condicionamiento observacional de la intervención y desarrollamos un modelo explícito con un factor de confusión binario. La asociación calculada y el efecto causal difieren pese a mantenerse fija la ecuación estructural. No se estima ningún efecto real de tratamiento ni se formula recomendación alguna de política; el ejemplo ilustra los supuestos y los riesgos de falta de identificación.
1. Las preguntas de predicción y de intervención utilizan distribuciones diferentes
La distribución observacional P(Y|X=x) describe al grupo en el que X toma un valor determinado en los datos ya observados; la distribución de intervención P(Y|do(X=x)) describe los resultados del sistema después de fijar X externamente. Ambas pueden diferir debido a causas comunes. Los grafos causales y las ecuaciones estructurales explicitan los supuestos, pero el grafo en sí no es una verdad obtenida automáticamente de un predictor de alto rendimiento. Es necesario especificar el significado de las variables, el orden temporal, los factores omitidos y las intervenciones admisibles; en particular, no debe suponerse que controlar estadísticamente variables arbitrarias siempre elimina el sesgo.[1] Towards Causal Representation Learning
2. Un modelo con un factor de confusión binario revela exactamente la diferencia
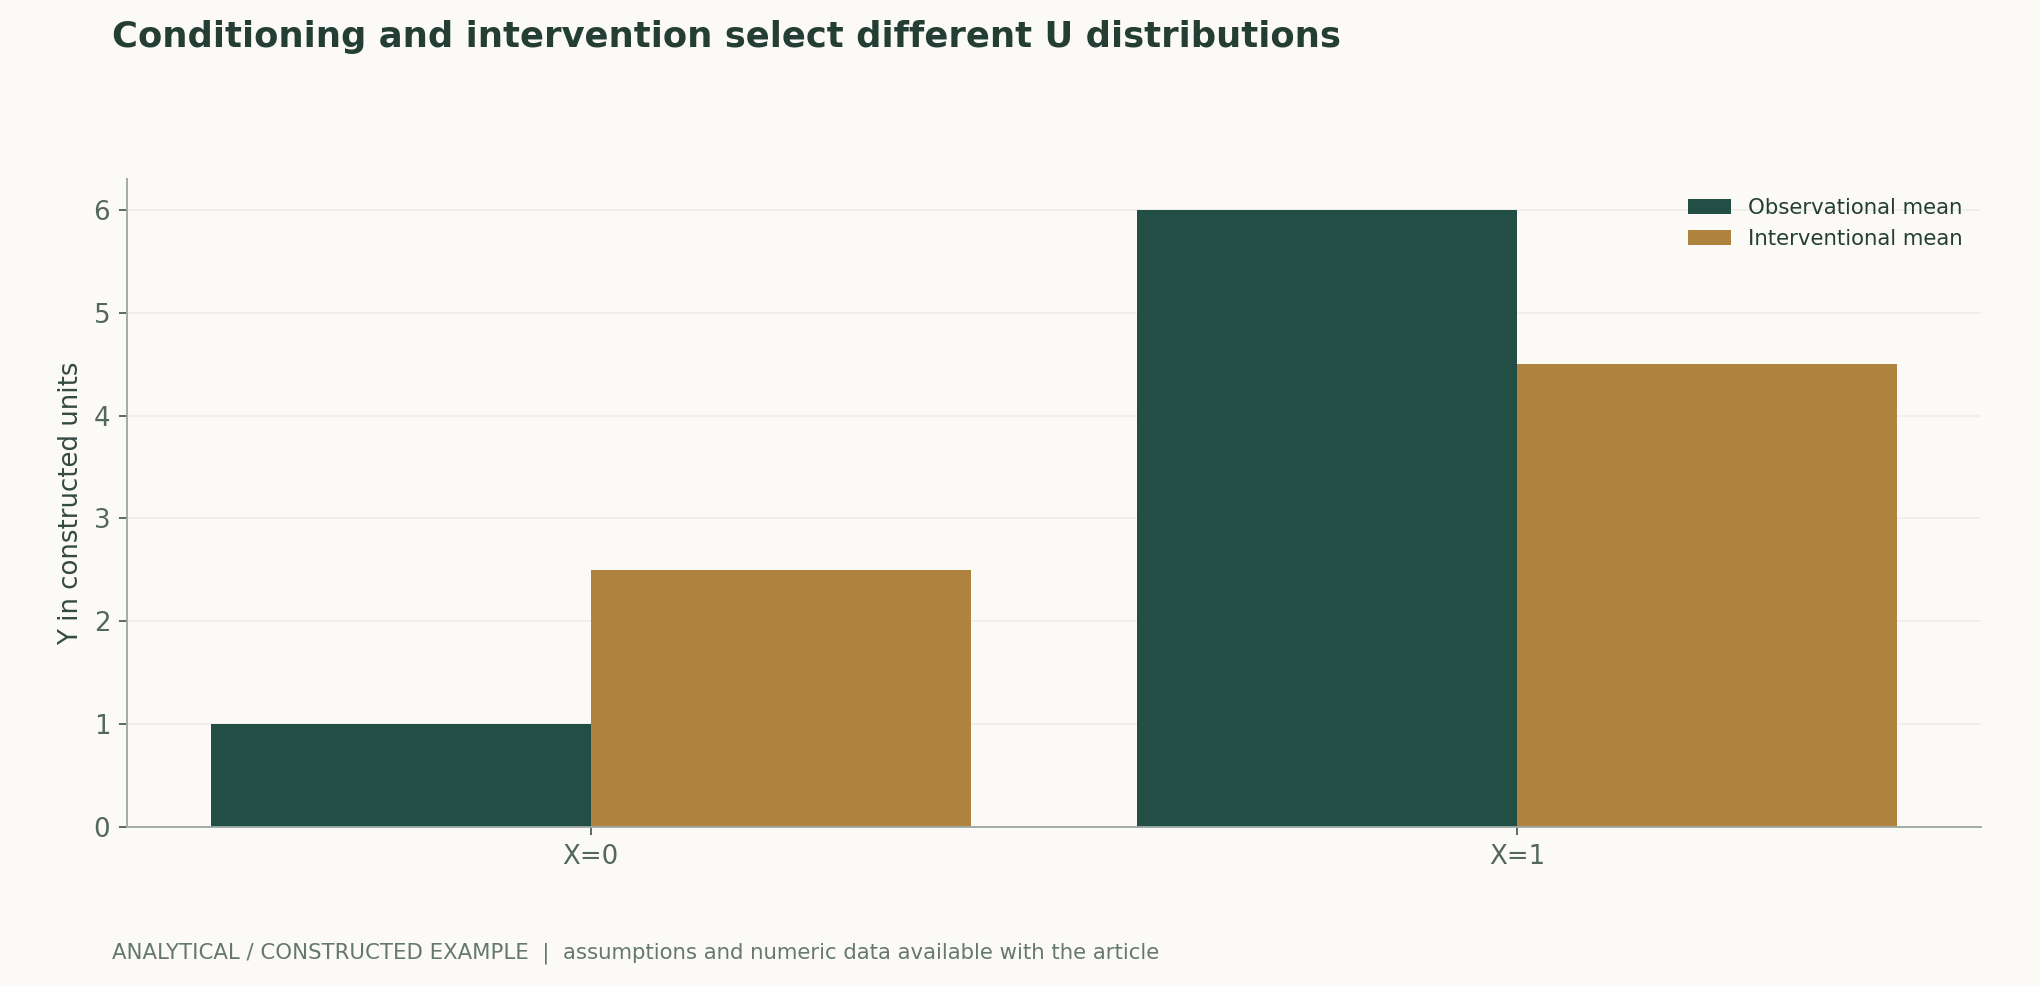
Sea U igual a 0 o 1 con la misma probabilidad, con P(X=1|U=1)=0.8 y P(X=1|U=0)=0.2, y sea el resultado Y=2X+5U. Entre quienes presentan X=1 en los datos observacionales, la proporción con U=1 es 0.8, mientras que entre quienes presentan X=0 es 0.2; por tanto, la diferencia de medias observacional es 2+5×0.6=5. Al intervenir sobre X se mantiene inalterada la distribución de U, y la diferencia de medias es solo 2. Aquí no hay error de muestreo: la discrepancia procede del mecanismo generador. En los datos reales también es necesario establecer si estas condiciones son creíbles.[1] Towards Causal Representation Learning
3. El ajuste por puerta trasera depende de condiciones contrastables y no contrastables
Si U satisface las condiciones de ajuste apropiadas, la media de intervención puede calcularse a partir de las medias condicionales ponderadas por la distribución poblacional P(U). También se requieren consistencia, soporte positivo dentro de los estratos pertinentes y una calidad de medición suficiente. Si un determinado grupo nunca ha recibido cierto tratamiento, la extrapolación del modelo no equivale a respaldo de los datos. Controlar una variable colisionadora o un mediador posterior al tratamiento también puede introducir nuevos sesgos o modificar el efecto objetivo. Los informes deben definir primero el estimando y después especificar el grafo y el conjunto de ajuste; las variables no deben seleccionarse mecánicamente según la intensidad de sus correlaciones.[1] Towards Causal Representation Learning
4. La identificación en el aprendizaje de representaciones exige estructura adicional
Comprimir observaciones de alta dimensión en variables latentes puede facilitar la modelización causal, pero una buena reconstrucción o la regularización de la independencia por sí solas suelen ser insuficientes para determinar de forma única los factores causales. La investigación sobre análisis de componentes independientes (ICA) no lineal y representaciones causales examina condiciones de identificación como las variables auxiliares y las restricciones estructurales. Asignar un nombre interpretable a una dimensión latente no la convierte automáticamente en un factor real sobre el que se pueda intervenir. Debe explicitarse qué variables son observables y cuáles no son identificables, evitando considerar los nombres asignados tras una rotación de la representación como un descubrimiento causal.[2] Invariant Risk Minimization[1] Towards Causal Representation Learning
5. La invariancia distributiva es un supuesto, no una respuesta universal
Las relaciones predictivas estables entre distintos entornos pueden aportar indicios, pero el número de entornos, los mecanismos de cambio y la confusión oculta influyen en las conclusiones. La investigación sobre cambios de distribución muestra que el aumento sencillo de datos, el preentrenamiento y la selección de modelos también afectan al rendimiento entre dominios. Por tanto, una precisión elevada entre entornos no demuestra por sí sola que se haya aprendido la estructura causal; deben diseñarse intervenciones o pruebas contrafactuales capaces de distinguir explicaciones rivales e indicarse qué cambios siguen fuera del soporte de los datos de entrenamiento.[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] Towards Causal Representation Learning
6. Las conclusiones confiables requieren análisis de sensibilidad y evidencia externa
Los estudios reales deben documentar la población objetivo, el tratamiento, el resultado, la ventana temporal, el mecanismo de datos faltantes y la justificación del ajuste, y contrastar los supuestos mediante controles negativos, análisis de sensibilidad o evidencia procedente de una aleatorización lícita. Cuando no sea posible la identificación, pueden comunicarse cotas o asociaciones; no debe imponerse un único valor causal. El modelo de este artículo es únicamente un contraejemplo didáctico: demuestra que la asociación y la intervención pueden diferir, no que una aplicación real presente un sesgo de la misma proporción, y no constituye consejo médico ni recomendación de política.[1] Towards Causal Representation Learning[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
Ecuaciones fundamentales y derivaciones
(1) Solo se cumple cuando U satisface condiciones como las de identificación y soporte; no es una identidad aplicable a cualquier variable de control.
LaTeX
\mathbb E[Y\mid do(X=x)]=\sum_u\mathbb E[Y\mid X=x,U=u]P(U=u)(2) Modelo estructural enteramente construido; U influye en X y la distribución de U permanece inalterada cuando se interviene sobre X.
LaTeX
Y=2X+5U,\quad P(U=1)=1/2(3) Calculado exactamente a partir de la tabla de probabilidades publicada, sin utilizar datos de una población real ni estimar efectos reales de tratamiento.
LaTeX
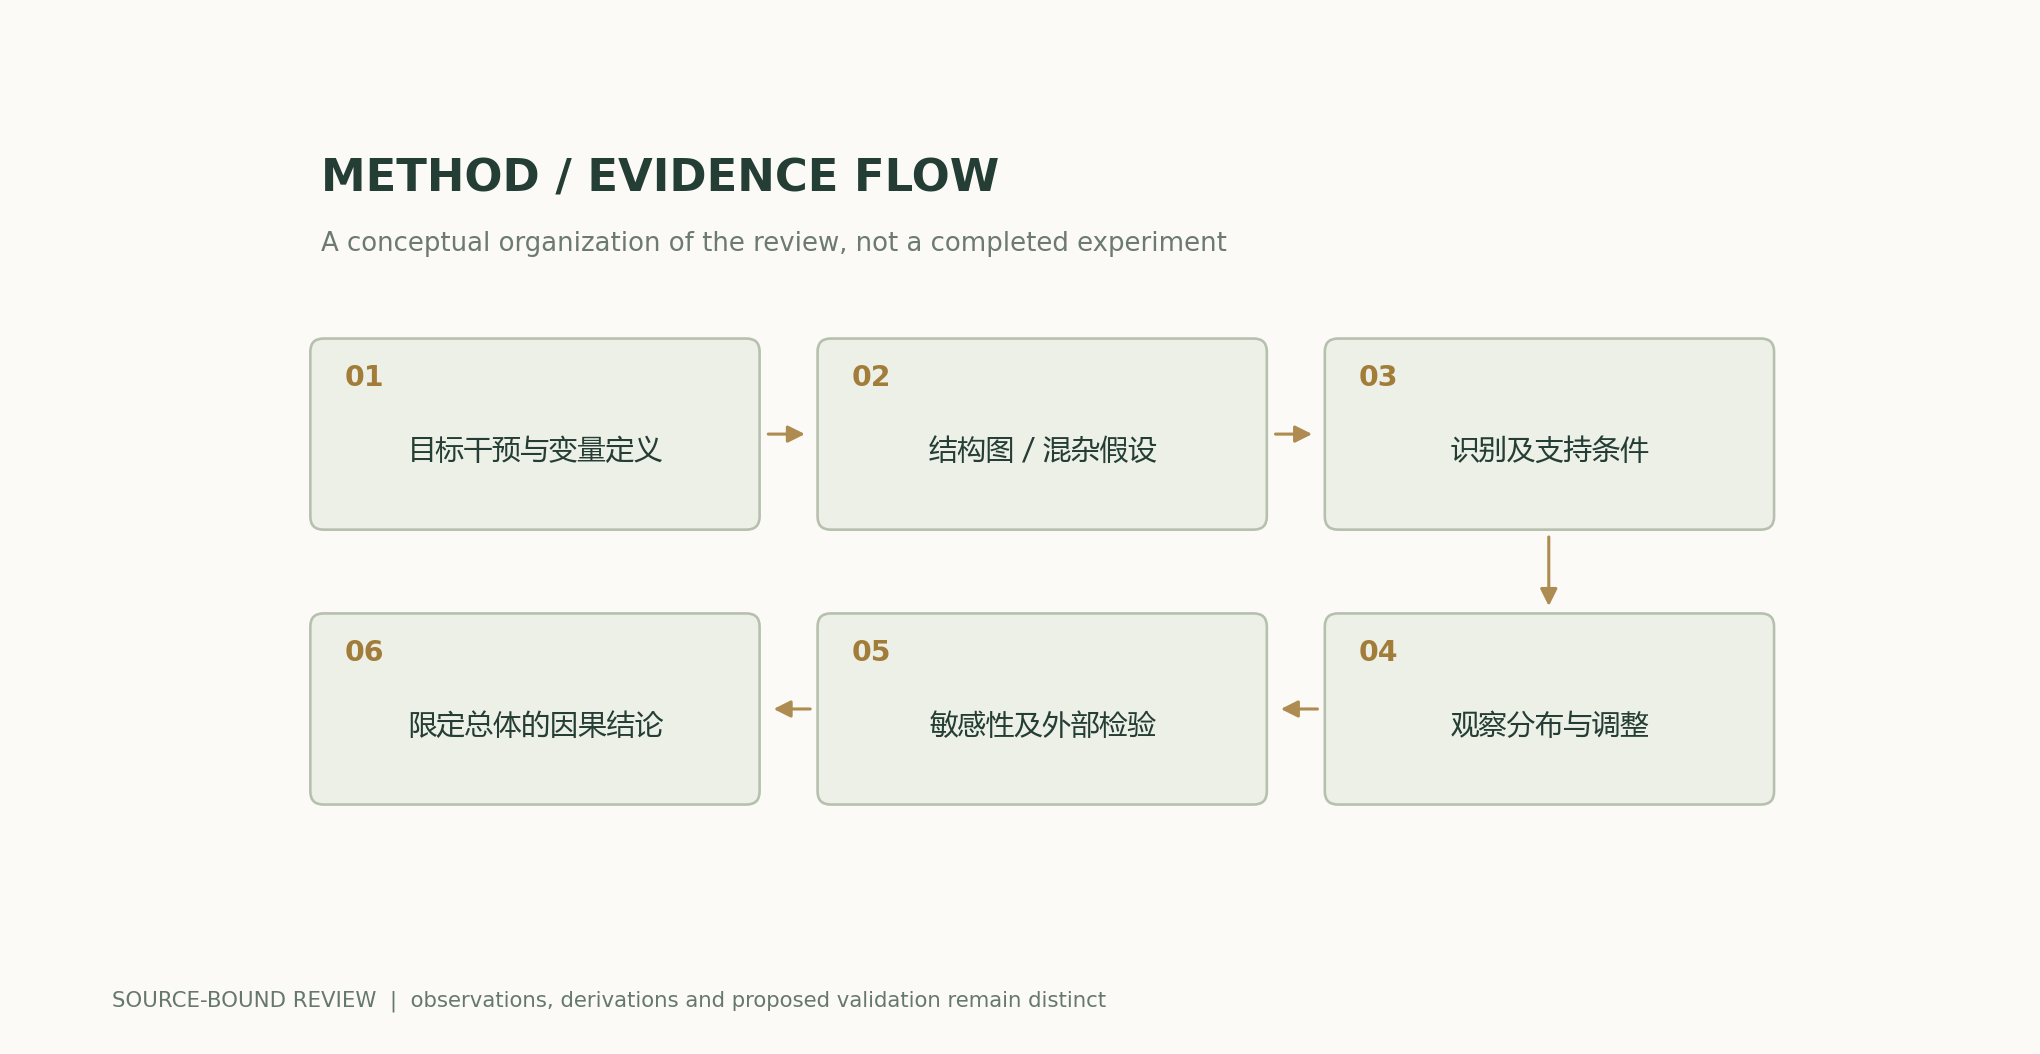
\Delta_{\mathrm{obs}}=5,\qquad\Delta_{\mathrm{do}}=2Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Las medias observacionales son 1 y 6, con una diferencia de 5; las medias de intervención son 2.5 y 4.5, con una diferencia de 2. La ponderación por puerta trasera recupera las medias de intervención utilizando la distribución poblacional de U, pero la posibilidad de ajustar en la realidad sigue requiriendo supuestos causales.
Comparación de métodos
| Método o juicio | Variables de control y medición | Condiciones de fallo e interpretación |
|---|---|---|
| Predicción observacional | Comunicar P(Y|X) y la fuente de datos | La precisión predictiva no identifica los efectos de intervención |
| Ajuste por puerta trasera | Presentar el grafo, el conjunto de ajuste y las condiciones de soporte | Un control incorrecto puede aumentar el sesgo |
| Representaciones latentes | Enumerar los supuestos de identificación y las soluciones equivalentes | Un nombre interpretable no equivale a una variable causal |
| Estabilidad entre dominios | Diseñar entornos y comparaciones controladas de explicaciones rivales | Una precisión estable no demuestra por sí sola causalidad |
Plan de verificación y experimentación
- Definir la población objetivo, el tratamiento, el resultado, el tiempo y el efecto que se desea estimar.
- Representar los supuestos causales y el orden temporal de las variables, y documentar los riesgos de confusión oculta.
- Comprobar el conjunto de ajuste, la consistencia, el soporte positivo, el error de medición y el mecanismo de datos faltantes.
- Verificar primero el estimador mediante simulaciones enumerables exhaustivamente y después analizar datos lícitos.
- Realizar análisis de sensibilidad, pruebas con controles negativos o pruebas de intervención externa, manteniendo las explicaciones rivales.
- Cuando no sea posible la identificación, comunicar explícitamente asociaciones o cotas, sin reformular los resultados predictivos como conclusiones causales.
Ámbito de aplicación y limitaciones
- El modelo y las probabilidades son enteramente construidos.
- No se ha estimado ningún efecto de intervención real.
- Los supuestos de identificación generalmente no pueden demostrarse solo con datos.
- La predicción entre dominios no demuestra automáticamente la estructura causal.
Correspondencia entre fuentes primarias y afirmaciones
- Towards Causal Representation LearningBernhard Schölkopf, Francesco Locatello, Stefan Bauer, Nan Rosemary Ke, Nal Kalchbrenner, Anirudh Goyal, Yoshua Bengio · 2021-02-22Abstract and sections on interventions, independent mechanisms and causal representations
- Invariant Risk Minimization, , , · 2019-07-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag coincide. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones publicadas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/causal-inference-ai/v1/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770