
要旨
予測精度が高くても、「ある要因を変えると何が起こるか」という問いに自動的に答えられるわけではない。本稿では、観察条件付き分布と介入分布を区別し、明示的な構造方程式において交絡が関連をどのように変えるかを導出するとともに、バックドア調整、表現の識別、分布変化に関する条件を論じる。掲載図は、変数と確率をすべて公開した、全状態を列挙可能な二値交絡因子モデルに基づくものであり、実際の集団や政策効果を対象とした研究ではない。[1] Towards Causal Representation Learning[2] Invariant Risk Minimization[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
原文の英語要旨の日本語訳
因果推論には、予測精度に加えて識別仮定が必要である。本稿では、観察による条件付けと介入を区別し、明示的な二値交絡因子モデルを詳しく検討する。構造方程式が固定されていても、計算される関連と因果効果は異なる。実際の処置効果を推定したり、政策提言を示したりするものではなく、この例は仮定と非識別のリスクを示すものである。
1. 予測問題と介入問題では異なる分布を用いる
観察分布P(Y|X=x)は、すでに生じたデータのうちXがある値をとる集団を記述する。一方、介入分布P(Y|do(X=x))は、Xを外部から設定した後のシステムの結果を記述する。共通原因によって両者は異なりうる。因果グラフと構造方程式は仮定を明示するが、グラフ自体が高性能な予測器から自動的に得られる真実なのではない。変数の意味、時間的順序、欠落した要因、許容される介入を説明する必要があり、とりわけ、任意の変数を統計的に調整すれば常にバイアスを除去できると考えてはならない。[1] Towards Causal Representation Learning
2. 二値交絡因子モデルにより差を厳密に明らかにできる
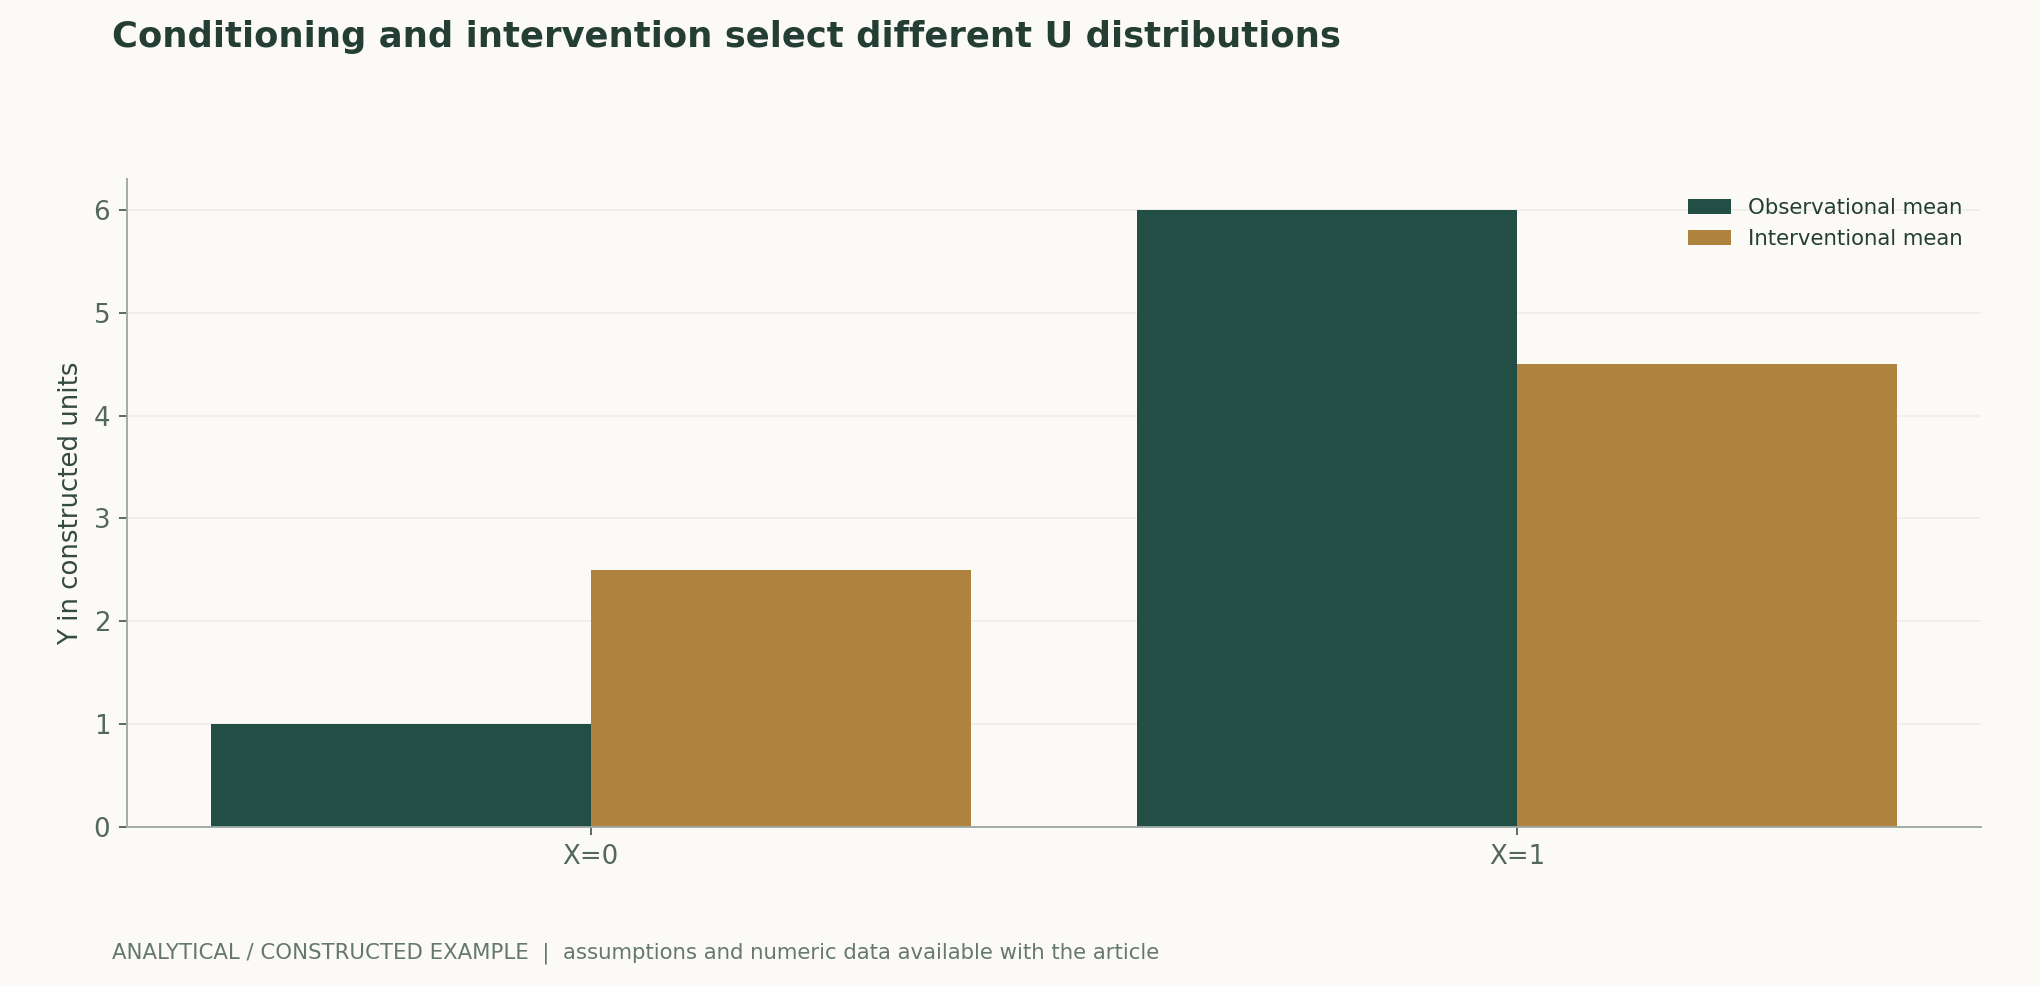
Uは0または1を等確率でとり、P(X=1|U=1)=0.8、P(X=1|U=0)=0.2とし、結果をY=2X+5Uとする。観察上X=1である者のうちU=1の割合は0.8であり、X=0である者では0.2であるため、観察平均の差は2+5×0.6=5となる。Xに介入する際にはUの分布を変えないため、平均の差は2にとどまる。ここには標本誤差はなく、差は生成機構に由来する。現実のデータでは、これらの条件が信頼できるかどうかも確かめる必要がある。[1] Towards Causal Representation Learning
3. バックドア調整は検証可能な条件と検証不可能な条件に依存する
Uが適切な調整条件を満たす場合、介入平均は母集団の分布P(U)で重み付けした条件付き平均から計算できる。さらに、一致性、該当する層内での正値性を満たすサポート、十分な測定品質も必要である。ある集団が特定の処置を一度も受けていない場合、モデルによる外挿はデータによる裏付けと同義ではない。コライダーや処置後の媒介変数を調整すると、新たなバイアスが生じたり、対象とする効果が変わったりする可能性もある。報告では、まず推定対象を定義し、その後にグラフと調整集合を示すべきであり、相関の強さに従って機械的に変数を選択してはならない。[1] Towards Causal Representation Learning
4. 表現学習における識別には追加の構造的要件がある
高次元の観察を潜在変数に圧縮することは因果モデリングに役立つ可能性があるが、良好な再構成や独立性の正則化だけでは、通常、因果要因を一意に定めるには不十分である。非線形ICAおよび因果表現の研究では、補助変数や構造的制約などの識別条件が論じられている。潜在次元に解釈可能な名前を付けても、それが自動的に介入可能な実在の要因になるわけではない。どの変数が観測可能で、どの変数が識別不可能なのかを明確にし、表現の回転後に付けた名称を因果発見とみなすことを避けるべきである。[2] Invariant Risk Minimization[1] Towards Causal Representation Learning
5. 分布不変性は仮定であり、万能の答えではない
異なる環境における安定した予測関係は手がかりとなりうるが、環境の数、変化の機構、隠れた交絡が結論に影響する。分布変化の研究では、単純なデータ拡張、事前学習、モデル選択もドメイン間の性能に影響することが示されている。したがって、環境をまたいで精度が高いことだけでは、因果構造を学習した証明にはならない。競合する説明を区別できる介入や反実仮想的検証を設計し、どの変化が依然として訓練データのサポートの範囲外にあるかを報告すべきである。[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] Towards Causal Representation Learning
6. 信頼できる結論には感度分析と外部の証拠が必要である
現実の研究では、対象母集団、処置、結果、時間枠、欠測機構、調整の根拠を記録し、負の対照、感度分析、または適法なランダム化による証拠を用いて仮定を検証すべきである。識別できない場合には、上下界や関連を報告することができ、単一の因果的な数値を無理に提示すべきではない。本稿のモデルは教育用の反例にすぎない。相関と介入が異なりうることを証明するものであり、現実の特定の応用に同じ比率のバイアスがあることを証明するものでも、医療上の助言や政策提言を構成するものでもない。[1] Towards Causal Representation Learning[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts
主要な数式と導出
(1) Uが識別やサポートなどの条件を満たす場合にのみ成立し、任意の調整変数に適用できる恒等式ではない。
LaTeX
\mathbb E[Y\mid do(X=x)]=\sum_u\mathbb E[Y\mid X=x,U=u]P(U=u)(2) 完全に人工的に構成した構造モデルである。XはUの影響を受け、Xに介入してもUの分布は変わらない。
LaTeX
Y=2X+5U,\quad P(U=1)=1/2(3) 公開した確率表から厳密に計算したものであり、実際の集団データの使用や実際の処置効果の推定は行っていない。
LaTeX
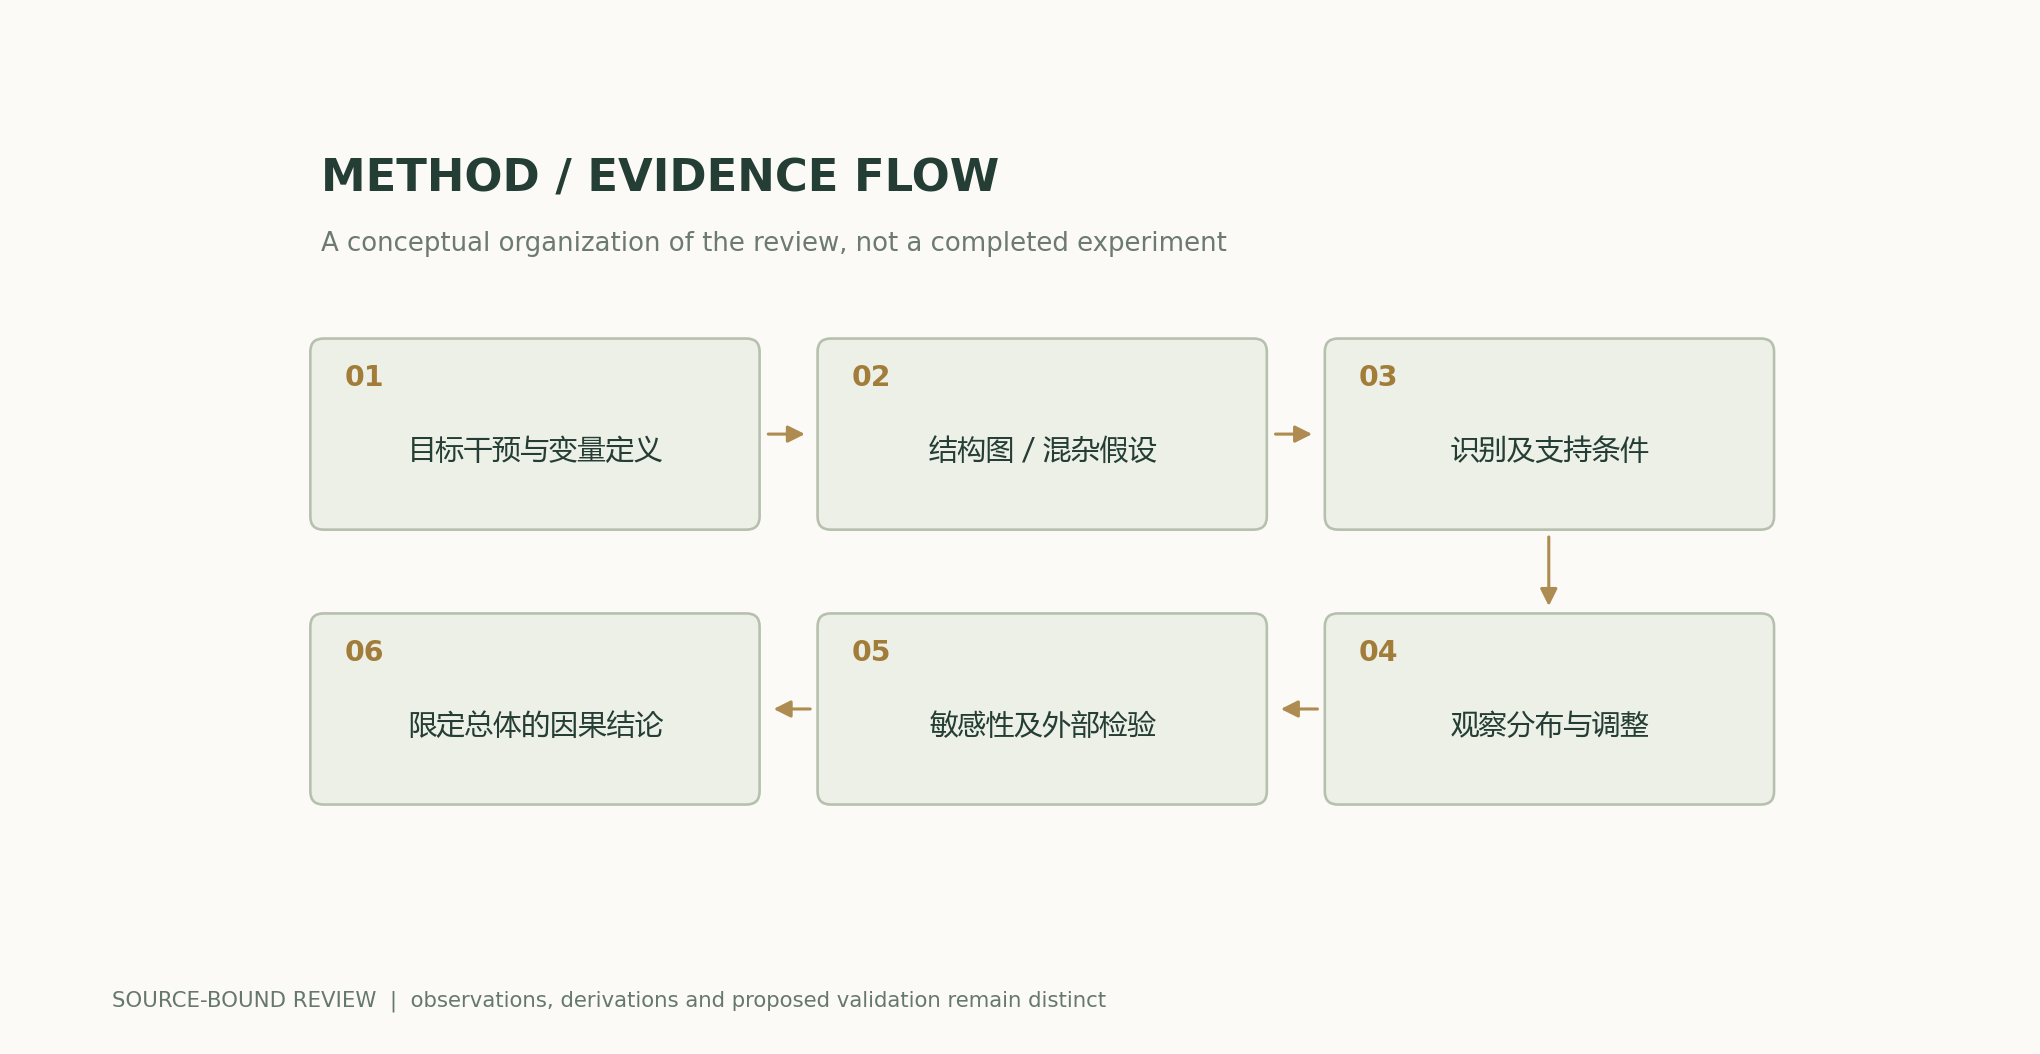
\Delta_{\mathrm{obs}}=5,\qquad\Delta_{\mathrm{do}}=2方法と証拠の検討手順
解析図と数値例
再計算可能な例題
観察平均は1と6で、その差は5である。介入平均は2.5と4.5で、その差は2である。バックドア重み付けは母集団におけるUの分布を用いて介入平均を復元するが、現実に調整可能かどうかには、なお因果仮定が必要である。
方法の比較
| 方法または判断 | 調整変数と測定 | 成立しなくなる条件とその解釈 |
|---|---|---|
| 観察に基づく予測 | P(Y|X)とデータの出所を報告する | 予測が正確でも介入効果は識別されない |
| バックドア調整 | グラフ、調整集合、サポート条件を示す | 誤った調整はバイアスを増大させうる |
| 潜在表現 | 識別仮定と同値な解を列挙する | 解釈可能な命名は因果変数であることを意味しない |
| ドメイン間の安定性 | 環境と、競合する説明を対照する比較を設計する | 安定した精度だけでは因果性は証明されない |
再検証と実験の計画
- 対象母集団、処置、結果、時間、および推定する効果を定義する。
- 因果仮定と変数の時間的順序を図示し、隠れた交絡のリスクを記録する。
- 調整集合、一致性、正値性を満たすサポート、測定誤差、欠測機構を確認する。
- まず全状態を列挙可能なシミュレーションで推定量を確認し、その後、適法なデータを用いて分析する。
- 感度分析、負の対照による検証、または外部の介入による検証を実施し、競合する説明を検討対象に残す。
- 識別できない場合には、関連または上下界を明示的に報告し、予測結果を因果的結論に書き換えない。
適用範囲と限界
- モデルと確率は完全に人工的に構成したものである。
- 実際の介入効果は一切推定していない。
- 識別仮定は通常、データだけでは証明できない。
- ドメインをまたぐ予測は、因果構造を自動的に証明するものではない。
一次資料と主張の対応
- Towards Causal Representation LearningBernhard Schölkopf, Francesco Locatello, Stefan Bauer, Nan Rosemary Ke, Nal Kalchbrenner, Anirudh Goyal, Yoshua Bengio · 2021-02-22Abstract and sections on interventions, independent mechanisms and causal representations
- Invariant Risk Minimization, , , · 2019-07-05Abstract; 原文方法、理论和实验章节见作者原始论文链接
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビューである。Codex(AI)が、列挙された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿についての独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、および科学図のデータは前版の内容を維持している。
概念的な表紙と科学的な図解は分離している。科学図は公開した数式と明示的な仮定から計算し、原論文の結果にはすべて帰属先を明記している。
著者、版、訂正の記録 · /guides/causal-inference-ai/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開と版の履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770