
الملخص
حجم النموذج ليس متغيرًا حرًا مستقلًا عن بيانات التدريب وميزانية الحوسبة. استنادًا إلى دراسات التحجيم القائمة، يصوغ هذا المقال التناسب بين عدد معاملات النموذج وعدد رموز التدريب بوصفه مسألة تحسين مقيد قابلة للاشتقاق، ويشرح كيف تغير الأسس التجريبية وتكرار البيانات وحالة التحسين ومتطلبات النشر النقطة المثلى. لا تعرض الرسوم التحليلية سوى سطح خسارة في ظل افتراضات صريحة، ولا تعامل الأسس المفترضة بوصفها قوانين أعاد هذا المقال ملاءمتها. تتطلب القرارات الموثوقة الاحتفاظ بمنحنيات التدريب الكاملة وبواقي الملاءمة والتحقق خارج المجال، لا مجرد عرض قيمة نهائية واحدة للخسارة.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
ترجمة الملخص الإنجليزي
يُتناول التحجيم الأمثل حسابيًا بوصفه تصميمًا تجريبيًا مقيدًا، لا وصفة عامة. ويؤدي نموذج خسارة قابل للفصل إلى قاعدة لتوزيع الموارد في ظل تقريب يفترض ثبات ميزانية حوسبة التدريب. يوضح هذا الاستعراض لماذا يمكن أن تؤدي إعادة استخدام الرموز وجودة البيانات وعدم يقين الملاءمة والطلب على الاستدلال إلى إزاحة النقطة المثلى عمليًا، ويحدد اختبارات على بيانات أو نقاط محجوزة لازمة للتمييز بين توزيع أفضل للموارد ومجموعة بيانات أفضل.
1. ما الذي تصفه قوانين التحجيم
درس Kaplan وزملاؤه، في إعدادات محددة للنمذجة اللغوية ذات الانحدار الذاتي، العلاقات التجريبية بين الخسارة وكل من المعاملات والبيانات ومقدار الحوسبة. هذه القوانين هي في المقام الأول ملاءمات ضمن نطاق الرصد، وليست قوانين تقضي بأن «الذكاء ينمو حتمًا وفق أسّ معين». كما أن انخفاض الإنتروبيا التقاطعية لا يستلزم مباشرةً استشهادات أكثر موثوقية، أو امتناعًا أنسب عن الإجابة، أو أهلية مهنية أقوى. ينبغي توضيح موضوع الملاءمة وأهداف التطبيق الفعلية كلٌّ على حدة.[1] Scaling Laws for Neural Language Models
2. كيف غيّر Chinchilla تقدير توزيع الموارد
قارن Hoffmann وزملاؤه بين أعداد مختلفة من المعاملات ورموز التدريب، واقترحوا أنه في ظل ميزانية حوسبة التدريب الثابتة وإعدادات التجربة لديهم، ينبغي زيادة الكميتين بنسب متساوية تقريبًا. استخدم نموذج Chinchilla الذي دُرّب فعليًا في الورقة نحو 700 وحدة من مئة مليون معامل و1.4 تريليون رمز تدريب. و«الأفضل» هنا مشروط بتدريب تلك الدراسة وتقييمها، ولا يعني وجود نسبة رموز إلى معاملات ثابتة إلى الأبد لجميع النماذج.[2] Training Compute-Optimal Large Language Models
3. قيد يسهل الخلط بشأنه
في نموذج الحوسبة التقريبي، يرمز N إلى حجم المعاملات، ويرمز D إلى رموز التدريب؛ وعندما تتضاعف كلتا الكميتين، تصبح الحوسبة الإجمالية نحو أربعة أمثالها. وإذا فُرض اصطناعيًا أن ينمو N وD بنسب متساوية ومتوازنة، فعندما تصبح الميزانية c أمثالها، تصبح كل منهماأمثال قيمتها الأصلية. هذا مثال حسابي، وليس قانونًا للتوزيع الأمثل. يثبت الشكل 2 في هذه النسخة ND=256، ويحلل توازن حدود الخسارة عند أسس تجريبية مختلفة؛ ويوضح الاشتقاق اللاحق أن التوزيع الأمثل لا يتطلب عمومًا أسسًا متساوية.[2] Training Compute-Optimal Large Language Models
4. عدد الرموز والمعلومات الفعالة ليسا الكمية نفسها
تستهلك البيانات المكررة الحوسبة أيضًا، لكنها لا تقدم بالضرورة مقدارًا مماثلًا من المعلومات الجديدة. وتغير اللغات المختلفة ونسبة الشيفرة البرمجية واستراتيجيات إزالة التكرار والترشيح بحسب الجودة توزيع التدريب. لذلك، لا يمكن لمجرد كون النموذج «قد قرأ رموزًا أكثر» أن يفسر وحده جميع جوانب أدائه في المهام اللاحقة. يوصي هذا المقال بتوثيق تركيب المتن ونسبة التكرار وفحوص تلوث التقييم، بحيث تُدرج مقادير الموارد وخصائص البيانات معًا في السجل التجريبي. هذه توصية منهجية، ولم تُقدَّر أي مجموعة تدريب غير منشورة.作者分析与复核建议 / Author analysis
5. مهام التعليمات تضيف محورًا آخر
تناولت أبحاث FLAN عوامل مثل مزيج المهام والحجم وبيانات سلسلة التفكير في الضبط الدقيق بالتعليمات، مبينةً وجود فضاء تصميم للتكييف السلوكي إلى جانب حجم التدريب المسبق. وقد يُظهر النموذج الأساسي نفسه أداءً مختلفًا باختلاف صياغة المهام وشكل الإشراف. لذلك، لا يمكن استبدال اختبارات اتباع التعليمات بمنحنيات خسارة التدريب، ولا استنتاج أن إعداد تدريب معين أمثل بالضرورة من نتيجة واحدة في لوحة ترتيب.[3] Scaling Instruction-Finetuned Language Models
6. الأمثل للتدريب ليس بالضرورة الأمثل لتقديم الخدمة
بالنسبة إلى نظام سيقدم خدمات الاستدلال مدة طويلة، تعتمد التكلفة الإجمالية أيضًا على عدد الطلبات وطول السياق وطول المخرجات والتخزين المؤقت وقيود زمن الاستجابة. قد يُدرَّب نموذج أصغر مدة أطول، لكنه يكون أقل تكلفة في كل عملية استدلال؛ وقد يظل استخدام نموذج أكبر مجديًا عندما يكون عدد الطلبات قليلًا. لا يقدم هذا المقال استنتاجات عن التكلفة لم تستند إلى قياسات، بل يوصي بإدراج تكلفة التدريب وتكلفة الاستدلال المتوقعة طوال دورة الحياة في جدول ميزانية واحد، ثم اختيار خطة قابلة للتحقق.作者分析与复核建议 / Author analysis
7. تصميم مقارنات قابلة للتحقق
ثبّتوا إصدار البيانات ومجموعات التقييم، واختاروا أحجامًا متعددة للمعاملات وميزانيات متعددة للرموز، وسجلوا خسارة التحقق ومقاييس المهام وفق أسلوب موحد لاحتساب الحوسبة. وينبغي عند المقارنة الاحتفاظ أيضًا بجدول معدل التعلم وحجم الدفعة واستراتيجية إيقاف التدريب؛ فإذا دُرّب النموذج الأصغر حتى التقارب وأُوقف الأكبر مبكرًا، فقد تكون المقارنة بين شروط تدريب مختلفة. يجب الإبلاغ عن نطاقات الاستقراء، بدلًا من التعامل مع المنحنى الملائم بوصفه قيمًا مرصودة عند جميع الأحجام.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
كيف ينبغي فهم الاختلافات بين الملاءمات
لا يعني توصل دراستين للتحجيم إلى توجهين مختلفين في توزيع الموارد أنه يمكن إعلان إحداهما خاطئة على نحو دائم بمعزل عن إعداداتها. فحجم النموذج وطول التدريب وجدول التحسين والبيانات وطريقة الملاءمة كلها تؤثر في الحدود الناتجة. ينبغي عند القراءة التحقق أولًا مما إذا كانت كل نقطة تمثل تشغيل تدريب فعليًا، أو تنبؤًا من الملاءمة، أو استقراءً بعيد المدى، ثم مقارنة الاستنتاجات المختلفة. ويتطلب الاستقراء عبر نطاقات واسعة جدًا صياغة أشد حذرًا من تلك المستخدمة ضمن نطاق الرصد الأصلي.作者分析与复核建议 / Author analysis
8. كيف تُشتق شروط الأمثلية في ظل ميزانية ثابتة
لنفترض أن الخسارة القابلة للخفض هي A N^(−α)+B D^(−β)، وأن تقريب الحوسبة الثابتة هو C=κND. بالتعويض عن D=C/(κN) والاشتقاق بالنسبة إلى log N، تتطلب النقطة المثلى تساوي المنفعتين الحديتين للجزأين، لا تساوي قيمتي الخسارة فيهما. ويعطي الحل أسّ تغير N مع C وهو β/(α+β)، وأسّ D وهو α/(α+β). لا تصح هذه النتيجة إلا ضمن النطاق الذي تنطبق فيه الصيغة القابلة للفصل وتقريب الحوسبة والأسس الملائمة. وهي تفسر لماذا قد تسفر التصاميم التجريبية المختلفة عن نسب مختلفة، وتبين أيضًا أن أي قيمة تجريبية ثابتة لـ«عدد الرموز لكل معامل» تحتاج إلى مجال انطباق محدد.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
9. كمية البيانات وكمية المعلومات الفعالة ليستا الإحداثي نفسه
يمكن لتكرار متن مرات عديدة أن يزيد عدد الرموز المعالجة D، لكنه لا يضمن زيادة مماثلة في المعلومات المستقلة. كما يغير التكرار الحفظ وضوضاء التحسين والتداخل بين التدريب والاختبار. توفر أبحاث إزالة التكرار أدلة فعلية على أثر هندسة البيانات في النتائج، لكن لا ينبغي الاستنتاج منها أن كل تكرار عديم القيمة: فأهداف التدريب متعدد الدورات وتعزيز المجالات النادرة وأخذ العينات وفق منهج متدرج تختلف. عند التحقق، يلزم إدراج عدد الرموز الأصلي والوثائق الفريدة وقواعد إزالة التكرار وعدد دورات التكرار ومزيج المجالات والتاريخ النهائي للبيانات معًا؛ فالملاءمة باستخدام العدد التراكمي للرموز وحده قد تُضمِّن اختلافات الجودة خطأً في أسس التحجيم.[4] Deduplicating Training Data Makes Language Models Bette[2] Training Compute-Optimal Large Language Models
10. الخسارة النهائية تمزج آثار الميزانية وحالة التحسين
إذا لم تقترب بعض النماذج بعد من المنطقة المستقرة لمرحلة تدريبها، فإن وصل خسائر نقاط النهاية مباشرةً بمنحنى يجعل نتائج الملاءمة متأثرة بجدولة معدل التعلم وحجم الدفعة وطول التدريب. وقد يكون النموذج الأقوى قد حصل فحسب على ميزانية أنسب لضبط المعاملات الفائقة. لذلك، ينبغي الاحتفاظ بمنحنيات تشمل نقاط تحقق متعددة، وتسجيل عمليات التشغيل الفاشلة وقواعد الاختيار، ومقارنة الإعدادات بعد ضبطها ضبطًا معقولًا. وعند الملاءمة، ينبغي الإبلاغ عن البواقي وعدم يقين المعاملات، واستخدام نقاط ميزانية لم تدخل في الملاءمة للتحقق من التنبؤات؛ ولا يجوز الادعاء بموثوقية الاستقراء استنادًا فقط إلى ارتفاع جودة الملاءمة على بيانات التدريب.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
11. قد تختلف أمثلية النشر عن أمثلية التدريب
الخطة التي تقتصر على تقليل خسارة التدريب لا تحتسب تكلفة عدد عمليات الاستدلال المستقبلية أو زمن الاستجابة أو ذاكرة المسرّع. وإذا كان النموذج نفسه سيُستدعى مرات كثيرة، فقد يكون استخدام نموذج أصغر وتدريبه مدة أطول أكثر فائدة من حيث تكلفة دورة الحياة الإجمالية؛ لكن نقطة التحول المحددة تعتمد على أطوال الطلبات الفعلية وحجم الدفعة والتكميم وعتاد تقديم الخدمة. كما يغير التعلم بالتعليمات في المراحل اللاحقة سلوك المهام، ولا تعني خسائر التدريب المسبق المتقاربة قابلية استخدام متساوية. ينبغي عند اتخاذ القرار إدراج تكلفة التدريب وتكلفة النشر الثابتة وتكلفة الاستدلال المتوقعة بوصفها أهدافًا صريحة، ثم توضيح مواضع قياس قيود الجودة.[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
المعادلات الأساسية والاشتقاقات
(1) يمثّل N عدد المعاملات، وD عدد الرموز المعالجة، وتُحدَّد A وB وα وβ بالملاءمة التجريبية؛ أما κ فهو معامل تقريب الحوسبة. المعاملات في الشكل افتراضات تحليلية معلنة، وليست قياسات جديدة.
LaTeX
L(N,D)=E+AN^{-\alpha}+BD^{-\beta},\qquad C=\kappa ND(2) يؤدي الاشتقاق بالنسبة إلى log N تحت قيد الميزانية إلى توازن المنفعتين الحديتين. ينبغي تمرير فترات الثقة للأسس إلى الإعدادات الموصى بها، بدلًا من الاحتفاظ بقيمة مثلى دقيقة واحدة فقط.
LaTeX
\alpha AN^{-\alpha}=\beta BD^{-\beta}\ \Longrightarrow\ N_\star\propto C^{\beta/(\alpha+\beta)},\quad D_\star\propto C^{\alpha/(\alpha+\beta)}(3) يمثّل R عدد الطلبات المستقبلية، وتمثّل ℓ وb شروط طول الطلب الفعلي وحجم الدفعة. هذا إطار لتحليل تكلفة دورة الحياة، وليس نموذج فوترة لأي مورّد.
LaTeX
C_{\rm total}=C_{\rm train}+R\,C_{\rm inference}(N,\ell,b)مسار المنهج والأدلة
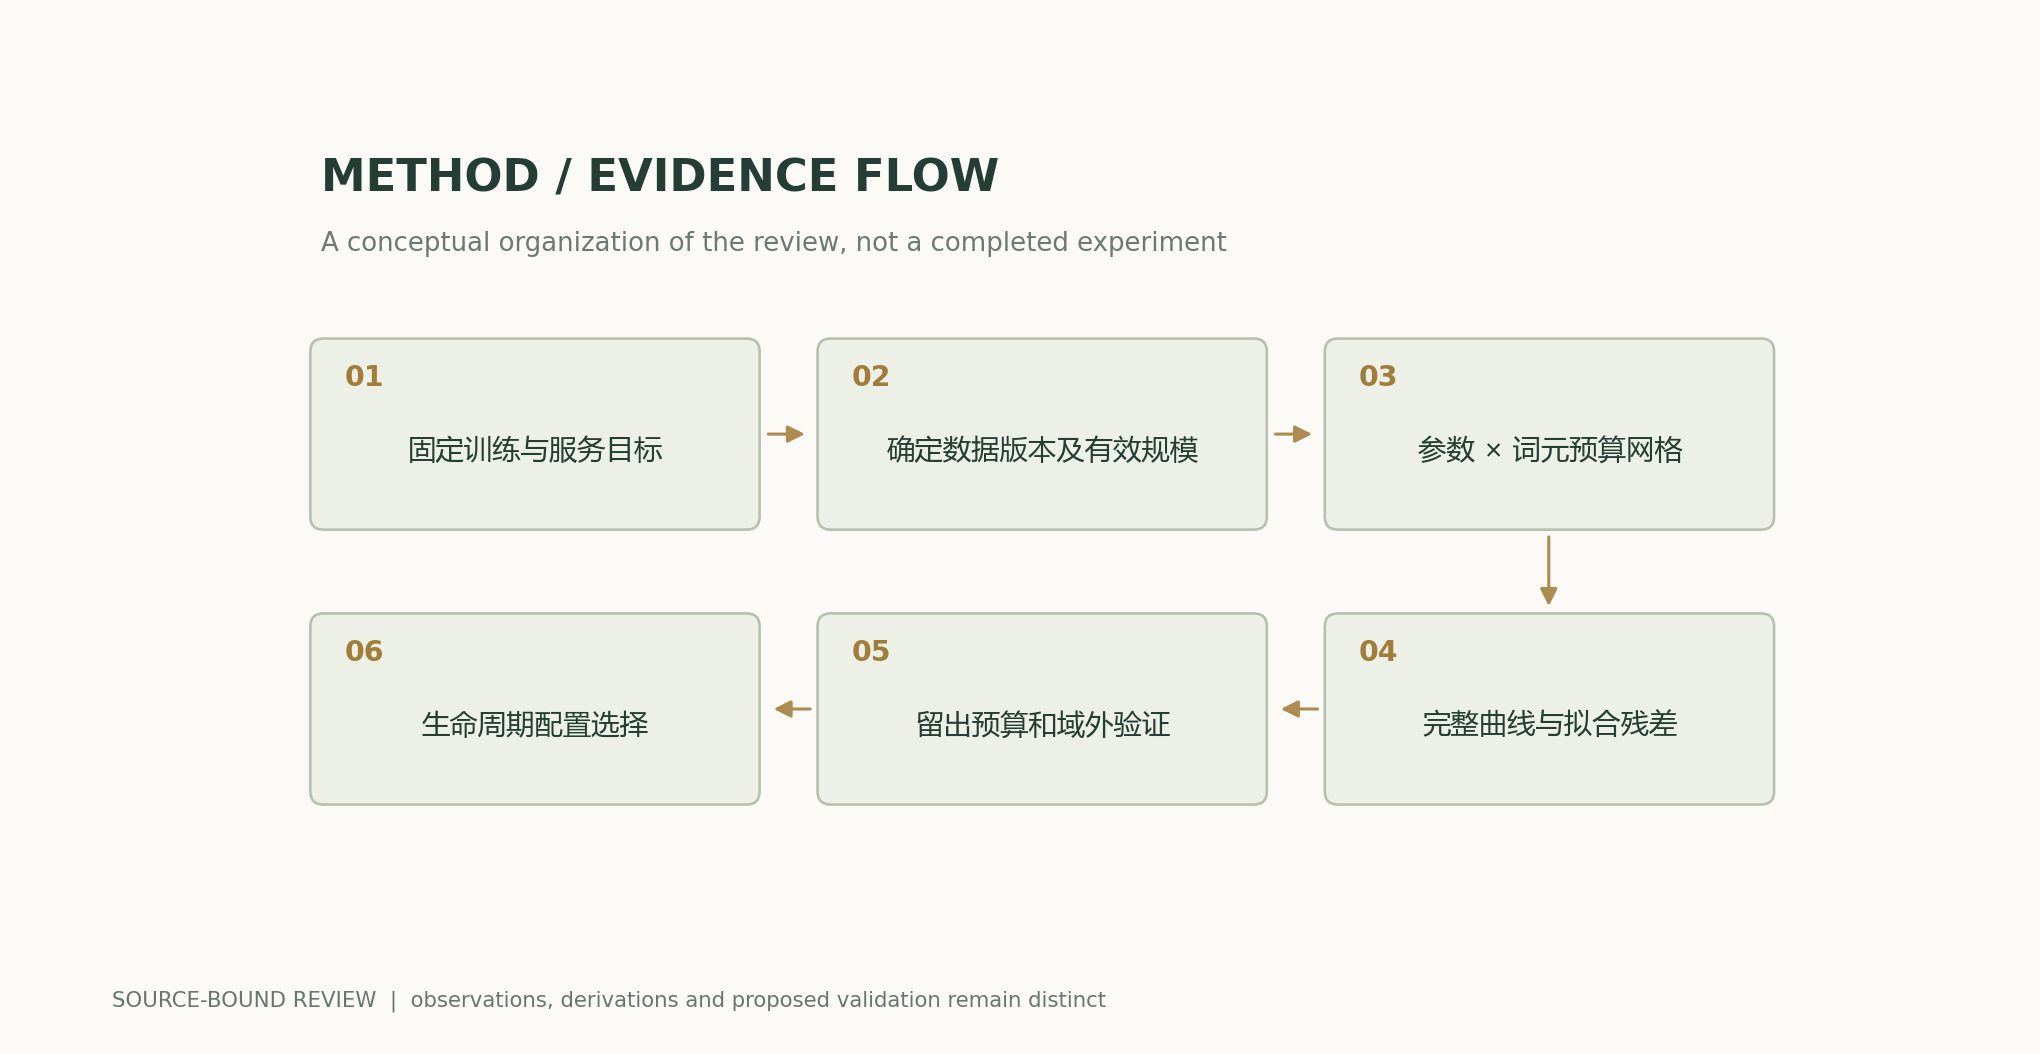
الرسوم التحليلية والأمثلة العددية
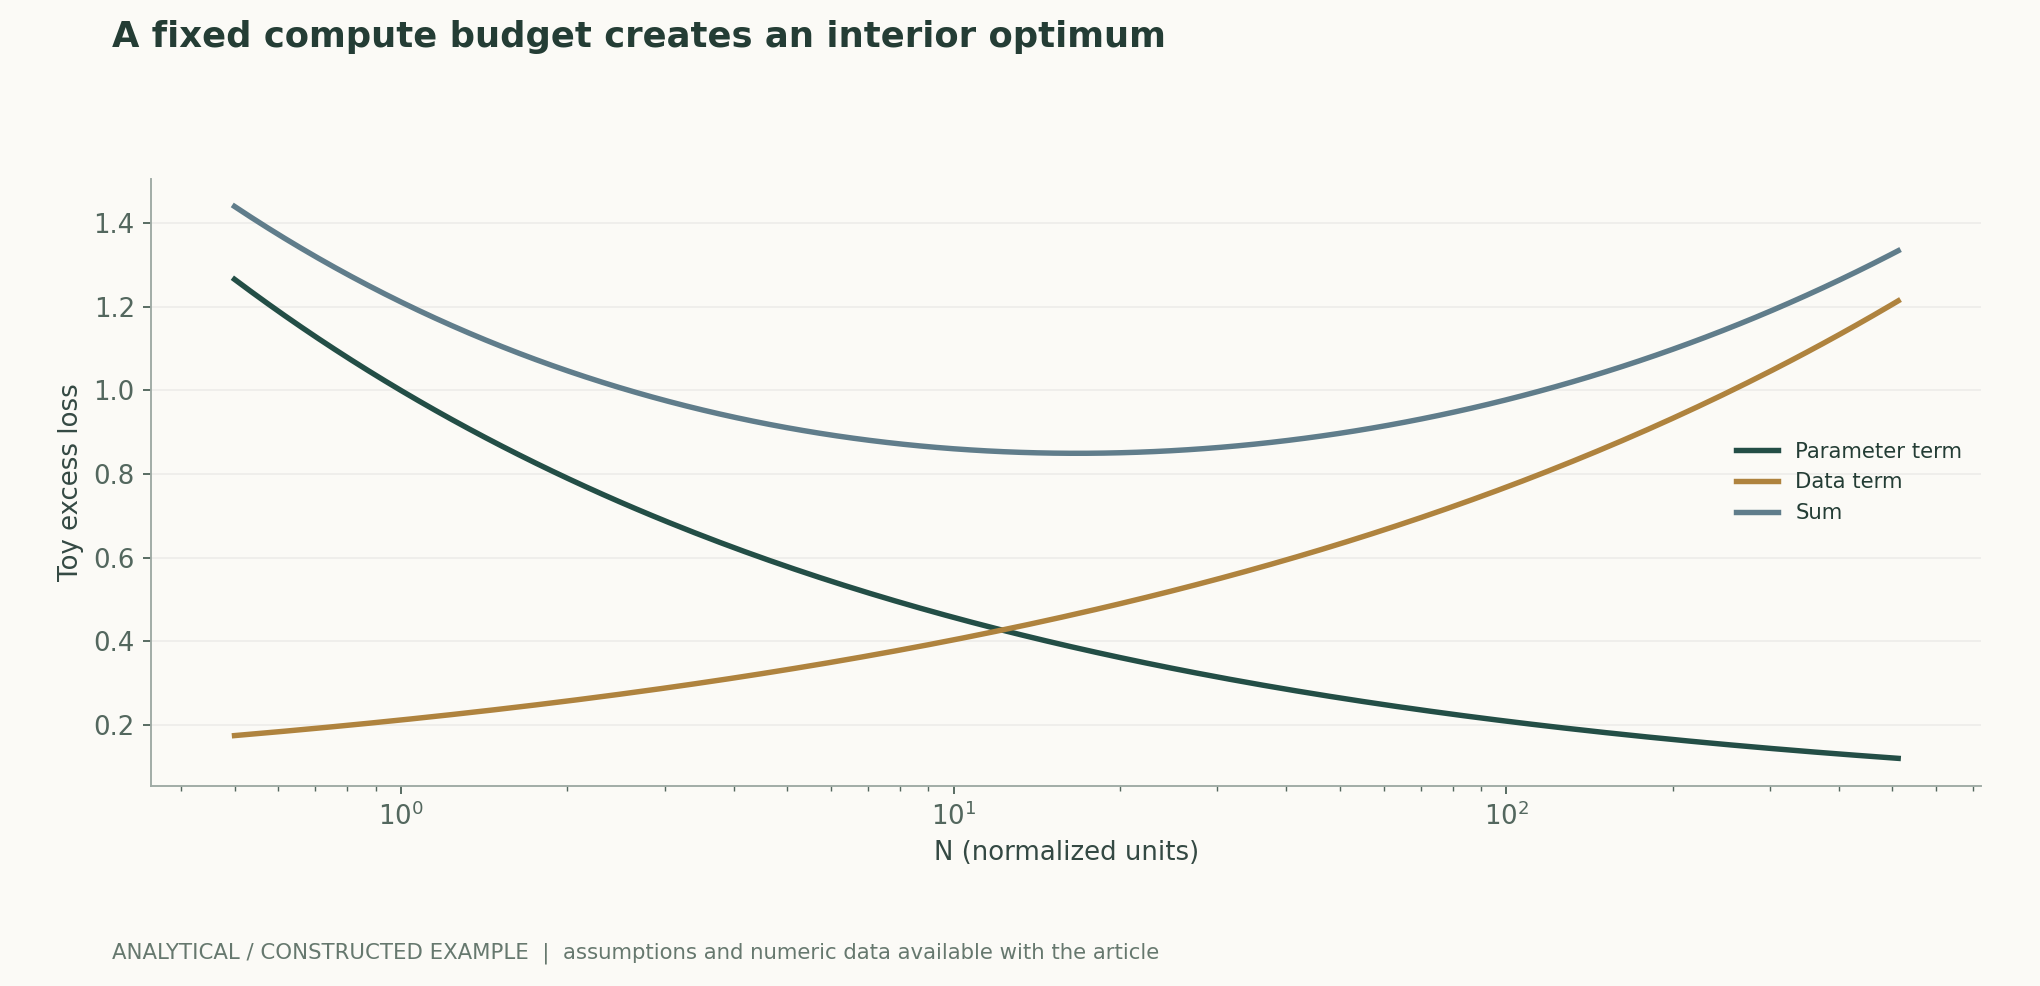
مثال محلول قابل لإعادة الحساب
بافتراض C=256 وα=0.34 وβ=0.28، وأن A=B=1، يعطي توازن المشتقات N بقيمة تقارب 16.734 وD بقيمة تقارب 15.298. هذه حسابات مطبَّعة، وليست وصفة تدريب أو معاملات ملائمة.
مقارنة الطرائق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| مسح أحجام المعاملات | تثبيت البيانات وقواعد الضبط، والاحتفاظ بمنحنيات التدريب الكاملة | اختلاف حالات التحسين قد يشوّه مقارنة الأحجام |
| مسح أعداد رموز التدريب | تسجيل المتن الفريد وعدد مرات التكرار ومزيج المجالات معًا | العدد التراكمي للرموز لا يساوي المعلومات المستقلة |
| ملاءمة أسس التحجيم | حجز نقاط من ميزانية الحوسبة، والإبلاغ عن البواقي وعدم اليقين | الملاءمة ضمن نطاق التدريب لا تضمن صحة الاستقراء بعيد المدى |
| اتخاذ القرار على مستوى دورة الحياة | إضافة أحمال عمل استدلال فعلية وقيود للجودة | الأمثل من حيث حوسبة التدريب ليس بالضرورة الأمثل من حيث تكلفة الخدمة |
خطة التحقق والتجارب
- تحديد أهداف الجودة ونطاق ميزانية الحوسبة المسموح به ومعايير الإخفاق المقبول مسبقًا، وعدم تغيير مقياس تحديد الفائز بعد الاطلاع على النتائج.
- تكوين شبكة تقاطعية تضم، على الأقل، عدة أحجام للمعاملات وميزانيات متعددة للرموز؛ وحفظ إصدار البيانات وقواعد إزالة التكرار وأوزان المزج والبذور العشوائية.
- استخدام قواعد ضبط واضحة وقابلة للتحقق للأحجام المختلفة، وتسجيل الحوسبة الإضافية للضبط، وعدم حذف عمليات التدريب الفاشلة من الميزانية.
- الاحتفاظ بنقاط التحقق الوسيطة أثناء التدريب، ومقارنة منحنيات الخسارة مقابل الحوسبة المستهلكة، والتمييز بين عدم التقارب ومحدودية السعة.
- حجز نقاط ميزانية وتقييمات خارج المجال لا تدخل في الملاءمة، وتقديم تحليل حساسية لاختيار النموذج.
- ثم إجراء قياسات استدلال محدودة النطاق باستخدام طلبات الخدمة المستهدفة، للتحقق مما إذا كانت توصيات التدريب لا تزال مناسبة في ظل قيود زمن الاستجابة وذاكرة المسرّع والتكلفة الإجمالية.
نطاق الانطباق والقيود
- كل من الخسارة القابلة للفصل وC=κND تقريب تحليلي.
- الأسس المفترضة في الشكل لا تمثل ملاءمة تجريبية أجراها هذا المقال.
- قد تؤدي تغييرات البيانات وخوارزمية التحسين والبنية إلى إبطال الاستقراء.
- لم تُضَف تجارب تدريب مسبق أو تقديرات لتكاليف تجارية.
مطابقة المصادر الأولية بالادعاءات
- Scaling Laws for Neural Language ModelsKaplan et al. · 2020-01-23v1; sections 1 and 6
- Training Compute-Optimal Large Language ModelsHoffmann et al. · 2022-03-29v1; section 3 and section 4
- Scaling Instruction-Finetuned Language ModelsChung et al. · 2022-10-20abstract; historical 2022 research
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المخطوطة
BibTeXRISCSL JSONTXTالمقال بصيغة JSON
المؤلف والإصدار والمصادر
استعراض بحثي بمساعدة الذكاء الاصطناعي؛ كتبه Codex (ذكاء اصطناعي) وأجرى اشتقاقاته التحليلية استنادًا إلى المراجع الأولية المدرجة. لا يتوفر في هذا الموقع سجل لمراجعة أقران مستقلة لهذا المقال أو لتجارب أصلية على النماذج.
مراجعة لأداء القارئ: تُعاد الاستفادة من الصفحات المقروءة أيضًا عندما يعيد طلب HEAD حديث الرمز 200 وتكون قيمة ETag مطابقة. يظل متن المقال والمعادلات والمصادر وبيانات الرسوم العلمية كما في الإصدار السابق.
يُفصل الغلاف المفاهيمي عن الرسوم العلمية؛ وتُحسب الرسوم العلمية من معادلات معلنة وافتراضات صريحة، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
سجل المؤلف والإصدارات والتصحيحات · /guides/compute-optimal-scaling/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770