
要旨
モデル規模は、学習データや計算予算から独立した自由な調整変数ではない。本稿は既存のスケーリング研究に基づき、モデルパラメータ数と学習トークン数の配分を、解析的に導出できる制約付き最適化問題として定式化する。そのうえで、経験的な指数、データの反復、最適化状態、デプロイ要件が最適点をどう変えるかを説明する。解析図は明示的な仮定の下での損失曲面のみを示し、仮定した指数を本稿で新たにフィッティングした法則として扱うものではない。信頼できる意思決定には、最終損失の数値だけを示すのではなく、完全な学習曲線、フィッティング残差、ドメイン外での検証を保存する必要がある。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
原文の英語要旨の日本語訳
計算最適なスケーリングを、普遍的な処方ではなく、制約付きの実験設計として扱う。分離可能な損失モデルから、学習計算量を固定する近似の下での配分則が得られる。本レビューは、トークンの再利用、データ品質、フィッティングの不確実性、推論需要が実用上の最適点を変え得る理由を説明し、配分の改善とデータセットの改善を区別するために必要なホールドアウト検証を明示する。
1. スケーリング則は何を記述するか
Kaplanらは、特定の自己回帰言語モデリング設定において、パラメータ数、データ量、計算量に伴う損失の変化の経験的関係を研究した。この種の法則は、まず観測範囲に対するフィッティングであり、「知能が必ず特定の指数に従って成長する」という法則ではない。また、交差エントロピーが低いことから、引用の信頼性、回答拒否の適切さ、専門的資格の高さを直接導くこともできない。フィッティングの対象と実際の応用目標は、それぞれ明示する必要がある。[1] Scaling Laws for Neural Language Models
2. Chinchillaが変えた資源配分の判断
Hoffmannらは、異なるパラメータ数と学習トークン数を比較し、同研究の固定された学習計算予算と実験設定の下では、両者をおおむね同じ割合で拡大すべきだと提案した。論文で実際に学習したChinchillaは、約700億パラメータと1.4兆学習トークンを用いた。ここでの「より優れる」は、その研究の学習と評価を条件とするものであり、すべてのモデルに永久不変のトークン数/パラメータ数比が存在することを意味しない。[2] Training Compute-Optimal Large Language Models
3. 混同しやすい制約
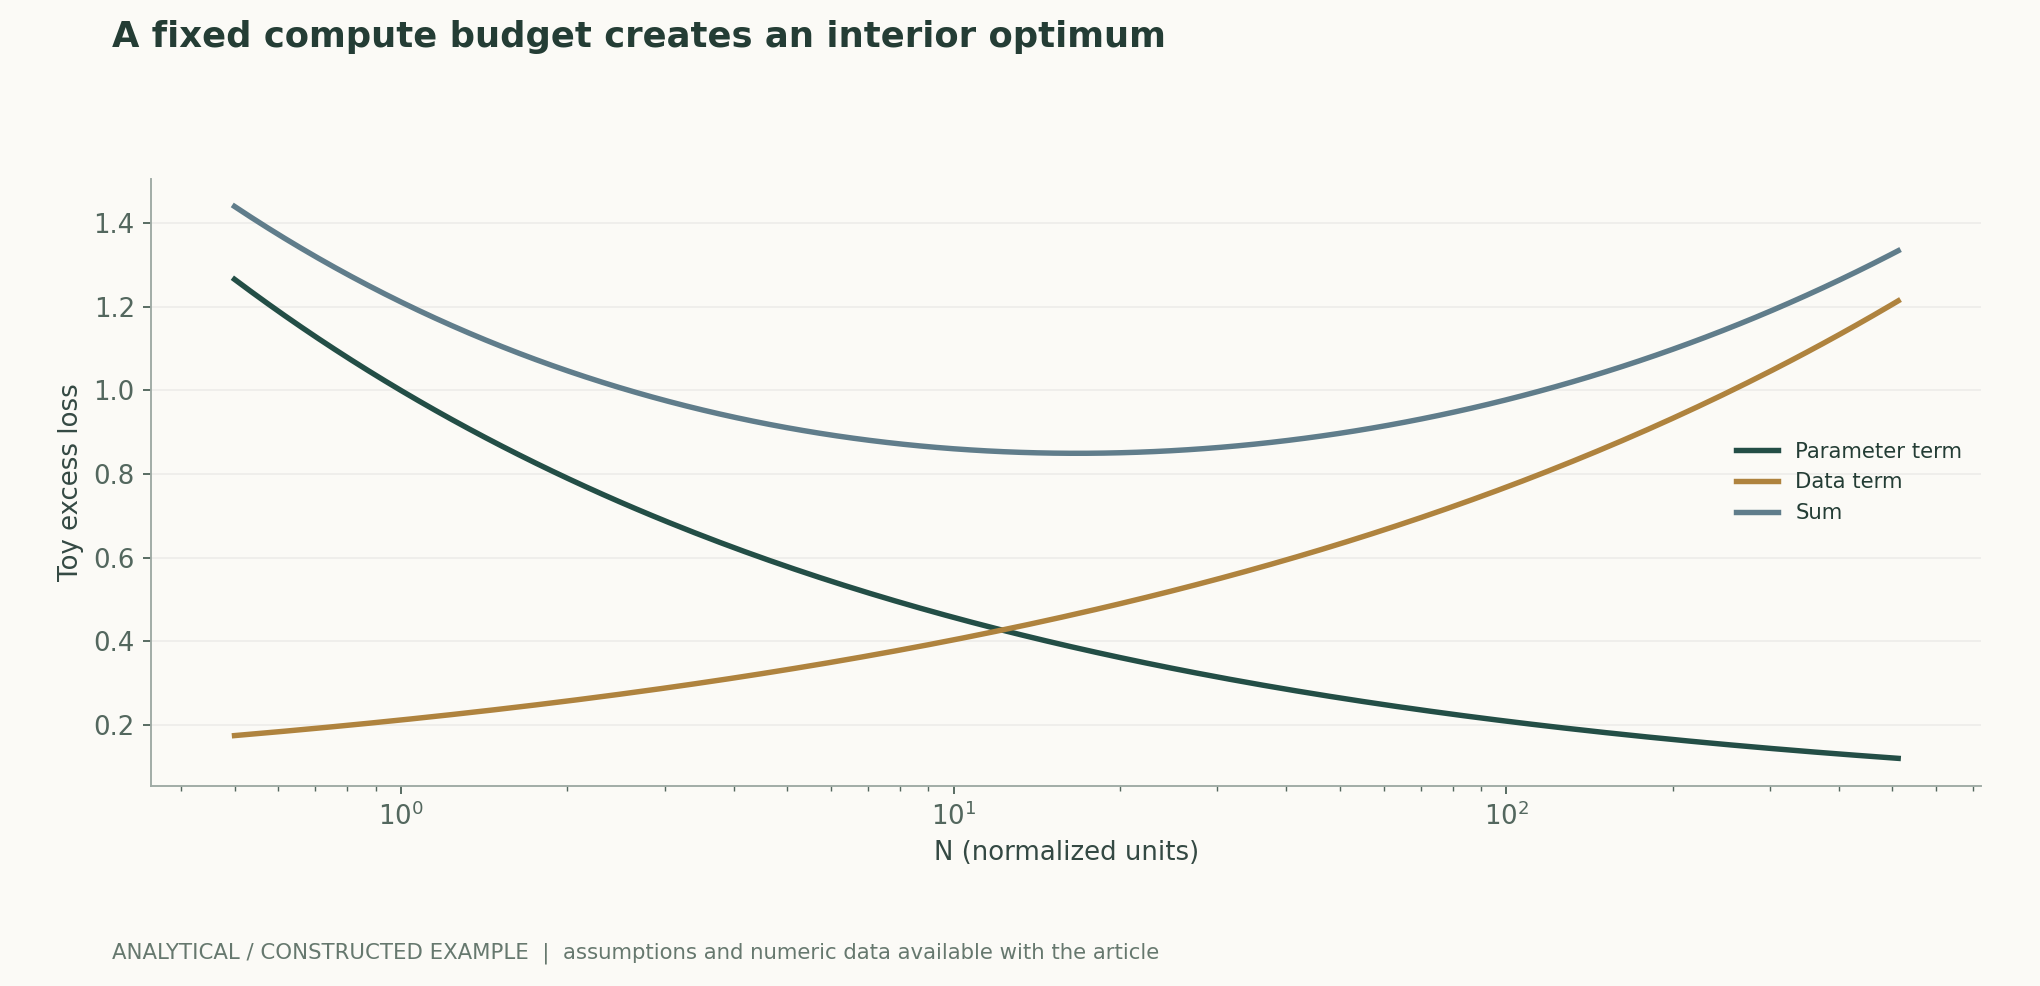
概算の計算モデルでは、Nはパラメータ規模、Dは学習トークン数を表す。両者をそれぞれ二倍にすると、総計算量は約四倍になる。NとDを均衡した同じ割合で増加させるという条件を人為的に課す場合、予算をc倍にすると、両者はいずれも倍になる。これは計数上の例であり、最適配分の法則ではない。本版の図2ではND=256を固定し、異なる経験的指数の下での損失項の均衡を分析する。後の導出では、最適配分には一般に同一の指数が必要ではないことを示す。[2] Training Compute-Optimal Large Language Models
4. トークン数と有効な情報量は同じ量ではない
反復されたデータも計算資源を消費するが、同量の新しい情報を提供するとは限らない。言語、コードの割合、重複除去戦略、品質フィルタリングの違いは、学習分布を変化させる。したがって、モデルが「より多くのトークンを読んだ」という事実だけでは、下流での性能のすべてを説明できない。本稿は、コーパス構成、反復率、評価汚染の検査を保存し、資源の量とデータの属性をともに実験記録へ含めることを推奨する。これは方法論上の提案であり、非公開の学習データセットを推定したものではない。作者分析与复核建议 / Author analysis
5. 指示タスクが導入する別の軸
FLANの研究は、指示ファインチューニングにおけるタスク混合、規模、思考連鎖データなどの要因を検討し、事前学習規模とは別に、振る舞いの適応に関する設計空間が存在することを示している。同じ基盤モデルでも、タスクの表現や教師信号の形式が異なれば、異なる性能を示し得る。したがって、学習損失曲線を指示追従テストの代わりにすることはできず、単一のリーダーボードの成績から、特定の学習設定が必ず最適であると逆算することもできない。[3] Scaling Instruction-Finetuned Language Models
6. 学習の最適性はサービス提供の最適性と一致しない
長期にわたり推論サービスを提供するシステムでは、総コストはリクエスト量、コンテキスト長、出力長、キャッシュ、レイテンシ制約にも依存する。小さいモデルは学習時間が長くても、推論一回当たりの費用が低い可能性がある。一方、大きいモデルも、リクエスト量が少ない場合には使用する価値があり得る。本稿は測定に基づかないコストの結論を示すのではなく、学習コストと想定ライフサイクル全体の推論コストを同じ予算表に記載したうえで、検証可能な案を選ぶことを推奨する。作者分析与复核建议 / Author analysis
7. 検証可能な比較設計
データの版と評価集合を固定し、複数のパラメータ数とトークン予算を選び、統一した計算量の算定基準で検証損失とタスク指標を記録する。比較時には、学習率スケジュール、バッチサイズ、学習停止戦略も併せて保存すべきである。小さいモデルだけを収束まで学習させ、大きいモデルを早期に停止させると、異なる学習条件を比較している可能性がある。フィッティング曲線をすべての規模での観測値として扱うのではなく、外挿範囲を報告する必要がある。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
フィッティング間の差異をどう理解すべきか
二つのスケーリング研究が異なる資源配分の傾向を示しても、いずれか一方を設定から切り離して永久に誤りだと断定できるわけではない。モデル規模、学習の長さ、最適化スケジュール、データ、フィッティング手法はいずれも、得られるフロンティアに影響する。読む際には、各点が実際の学習実行、フィッティングによる予測、遠距離の外挿のいずれなのかをまず確認し、その後に結論を比較すべきである。特に広い範囲への外挿には、元の観測範囲について述べる場合より慎重な表現が必要となる。作者分析与复核建议 / Author analysis
8. 固定予算下の最適条件をどう導くか
低減可能な損失をA N^(−α)+B D^(−β)とし、固定計算量の近似をC=κNDとする。D=C/(κN)を代入してlog Nで微分すると、最適点では両成分の損失値そのものではなく、限界的な改善量が等しくなる必要がある。解くと、Cに対するNの指数はβ/(α+β)、Dの指数はα/(α+β)となる。この結論が成立するのは、分離可能な形式、計算量近似、フィッティングされた指数がいずれも適用できる範囲に限られる。これは異なる実験設計から異なる配分が得られ得る理由を説明するとともに、「パラメータ当たりのトークン数」という固定的な経験則には、いずれも適用領域の指定が必要であることを示す。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
9. データ量と有効情報量は同じ座標ではない
コーパスを何度も反復すれば、処理済みトークン数Dは増えるが、それと同等の独立した情報の増加は保証されない。反復は、記憶、最適化ノイズ、学習・テスト間の重複も変化させる。重複除去研究は、データエンジニアリングが結果に影響する実際の証拠を提供するが、そこからすべての反復に価値がないと断定すべきではない。複数エポックの学習、希少ドメインの強化、カリキュラム型サンプリングでは目的が異なる。検証時には、元のトークン数、一意な文書、重複除去規則、反復回数、ドメイン混合、データの締切日を併記する必要がある。累積トークン数だけでフィッティングすると、品質差がスケーリング指数に誤って取り込まれる可能性がある。[4] Deduplicating Training Data Makes Language Models Bette[2] Training Compute-Optimal Large Language Models
10. 最終損失には予算と最適化状態の影響が混在する
一部のモデルがその学習段階における安定領域にまだ近づいていない場合、終点の損失を直接結んで曲線にすると、フィッティング結果は学習率スケジュール、バッチサイズ、学習の長さの影響を受ける。より高性能なモデルも、単により適切なハイパーパラメータ調整予算を与えられただけかもしれない。したがって、複数チェックポイントの曲線を保存し、失敗した実行と選択規則を記録し、妥当に調整した設定同士を比較すべきである。フィッティング時には残差とパラメータの不確実性を報告し、フィッティングに用いなかった予算点で予測を検証する必要がある。フィッティングデータに対する適合度が高いというだけで、外挿が信頼できると主張してはならない。[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
11. デプロイの最適点は学習の最適点からずれ得る
学習損失の最小化だけを目指す案は、将来の推論回数、レイテンシ、アクセラレータメモリのコストを考慮していない。同じモデルを大量に呼び出す場合、より小さいモデルをより長く学習させるほうが、ライフサイクル全体のコストで有利になる可能性がある。ただし、具体的な損益の逆転点は、実際のリクエスト長、バッチサイズ、量子化、サービス提供用ハードウェアに依存する。下流での指示学習もタスク上の振る舞いを変えるため、事前学習損失が近いことは同じ実用性を意味しない。意思決定では、学習コスト、固定デプロイコスト、予想推論コストを明示的な目的として列挙し、品質制約をどこで測定するのかを説明すべきである。[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
主要な数式と導出
(1) Nはパラメータ数、Dは処理したトークン数を表し、A、B、α、βは実験に基づいてフィッティングする。κは計算量近似の係数である。図の係数は明示された解析上の仮定であり、新たな測定値ではない。
LaTeX
L(N,D)=E+AN^{-\alpha}+BD^{-\beta},\qquad C=\kappa ND(2) 予算制約下でlog Nについて微分すると、限界的な改善量の均衡が得られる。精密な最適値を一つだけ残すのではなく、指数の信頼区間を推奨設定に伝播させるべきである。
LaTeX
\alpha AN^{-\alpha}=\beta BD^{-\beta}\ \Longrightarrow\ N_\star\propto C^{\beta/(\alpha+\beta)},\quad D_\star\propto C^{\alpha/(\alpha+\beta)}(3) Rは将来のリクエスト回数、ℓとbは実際のリクエスト長とバッチサイズの条件を表す。これはライフサイクルコストの分析枠組みであり、特定の事業者の課金モデルではない。
LaTeX
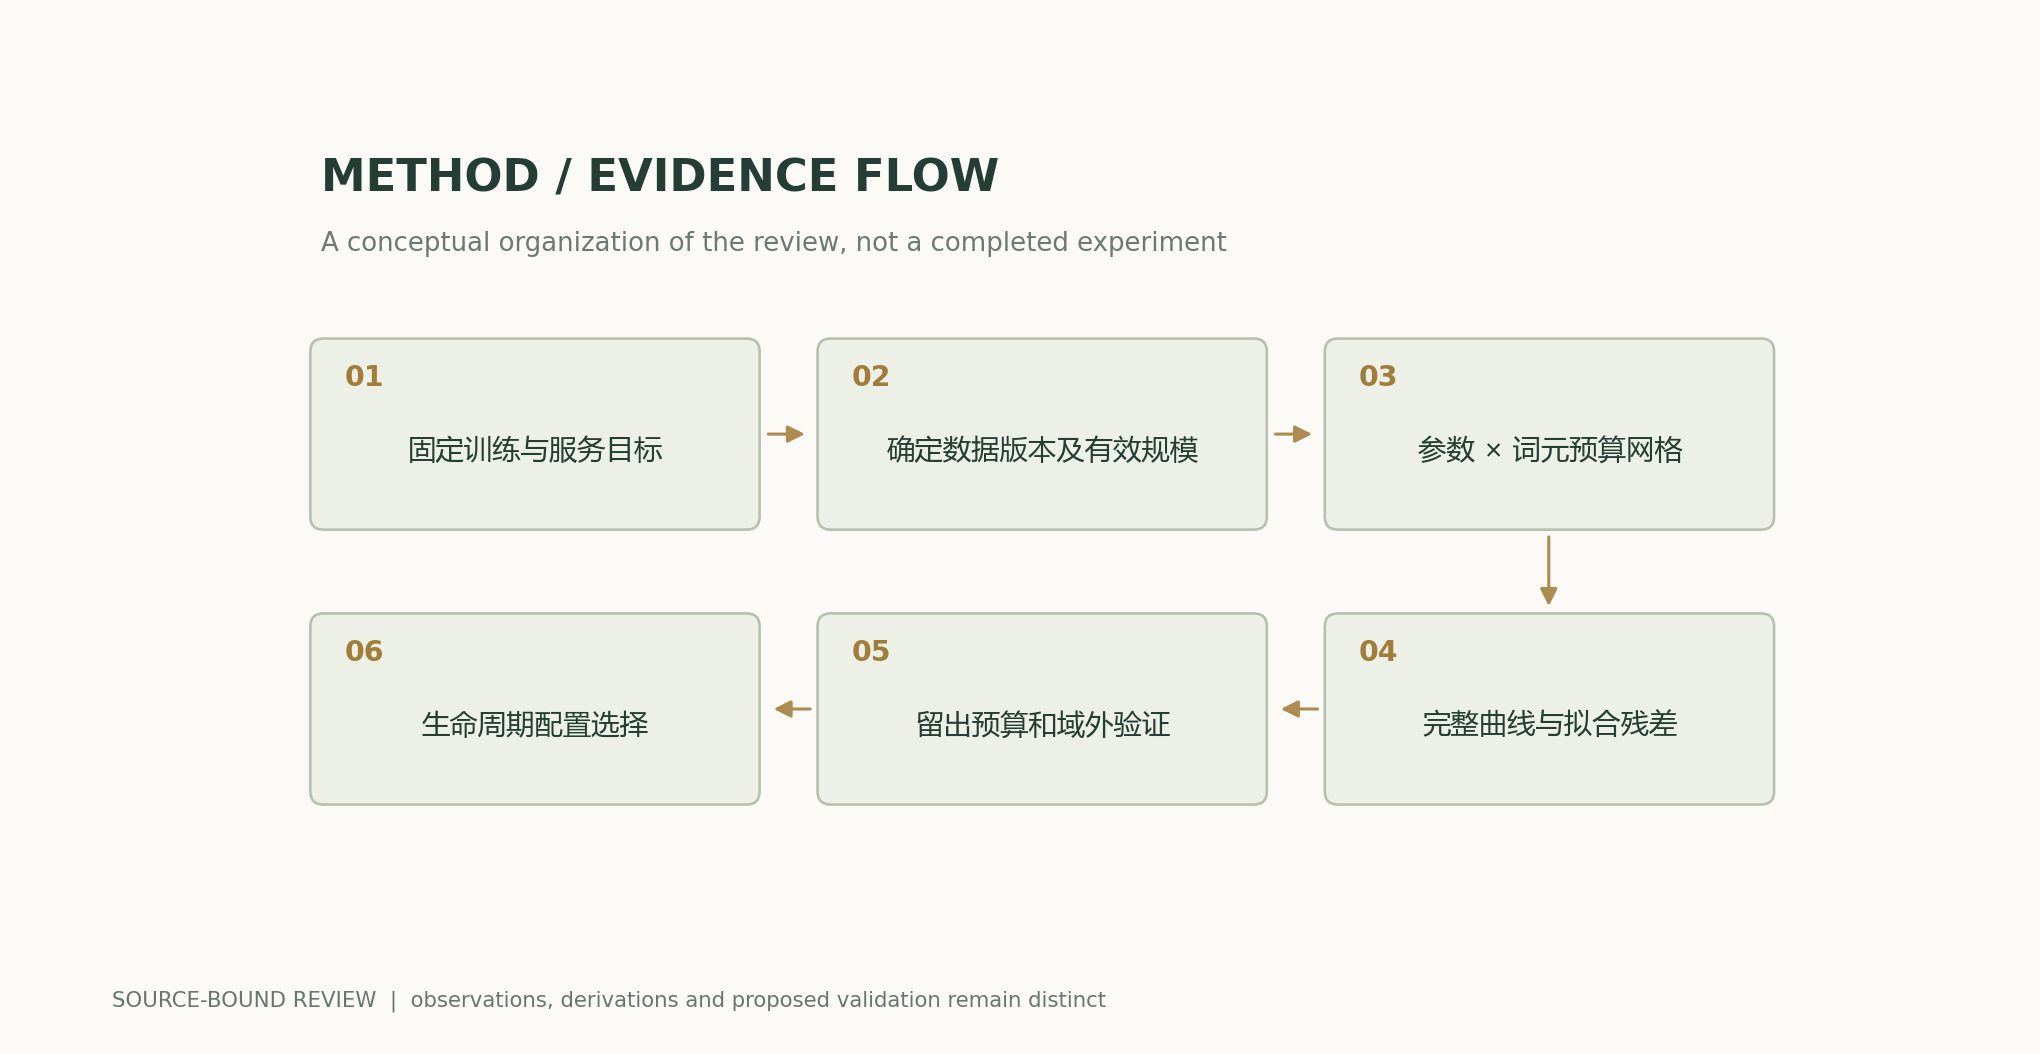
C_{\rm total}=C_{\rm train}+R\,C_{\rm inference}(N,\ell,b)手法とエビデンスの流れ
解析図と数値例
再計算可能な計算例
C=256、α=0.34、β=0.28、かつA=B=1を仮定すると、微分の均衡からNは約16.734、Dは約15.298となる。これらは正規化した計算であり、学習レシピやフィッティングされたパラメータではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 成立しない条件とその解釈 |
|---|---|---|
| パラメータ規模の走査 | データと調整規則を固定し、完全な学習曲線を保存する | 最適化状態の違いが規模間の比較を交絡させる |
| 学習トークン数の走査 | 一意なコーパス、反復回数、ドメイン混合を併せて記録する | 累積トークン数は独立した情報量と等しくない |
| スケーリング指数のフィッティング | 計算予算点をホールドアウトし、残差と不確実性を報告する | 学習範囲内のフィッティングは大幅な外挿を保証しない |
| ライフサイクルに関する意思決定 | 実際の推論ワークロードと品質制約を追加する | 学習計算量の最適性は、サービス提供コストの最適性とは限らない |
検証と実験の計画
- 品質目標、許容する計算予算の範囲、許容可能な失敗の基準を事前に定め、結果を観測した後で優劣を決める指標を変更しない。
- 少なくとも複数のパラメータ規模とトークン予算を組み合わせた格子を構成する。データの版、重複除去規則、混合重み、乱数シードを保存する。
- 規模ごとに明示的で検証可能な調整規則を用い、追加の調整計算量を記録する。失敗した学習を予算から除外してはならない。
- 学習途中のチェックポイントを保存し、消費計算量に対する損失曲線を比較して、未収束と容量制約を区別する。
- フィッティングに使わない予算点とドメイン外評価を確保し、モデル選択の感度分析を示す。
- 続いて、対象サービスのリクエストを用いた小規模な推論測定を行い、学習に関する推奨がレイテンシ、アクセラレータメモリ、総コストの制約下でも適切かを検証する。
適用範囲と限界
- 分離可能な損失とC=κNDは、いずれも解析上の近似である。
- 図で仮定した指数は、本稿による経験的フィッティングを表すものではない。
- データ、オプティマイザ、アーキテクチャの変更により、外挿が成り立たなくなる可能性がある。
- 新たな事前学習実験や商用コストの推定は行っていない。
一次資料と主張の対応
- Scaling Laws for Neural Language ModelsKaplan et al. · 2020-01-23v1; sections 1 and 6
- Training Compute-Optimal Large Language ModelsHoffmann et al. · 2022-03-29v1; section 3 and section 4
- Scaling Instruction-Finetuned Language ModelsChung et al. · 2022-10-20abstract; historical 2022 research
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿に対する独立した査読や独自のモデル実験の記録はない。
リーダー性能の改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前の版の内容を維持している。
概念的な表紙と科学図解を区別している。科学図は公開された数式と明示的な仮定から計算し、原著論文の結果にはすべて帰属を明記している。
著者、版、訂正の記録 · /guides/compute-optimal-scaling/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開と版の履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770