
Resumen
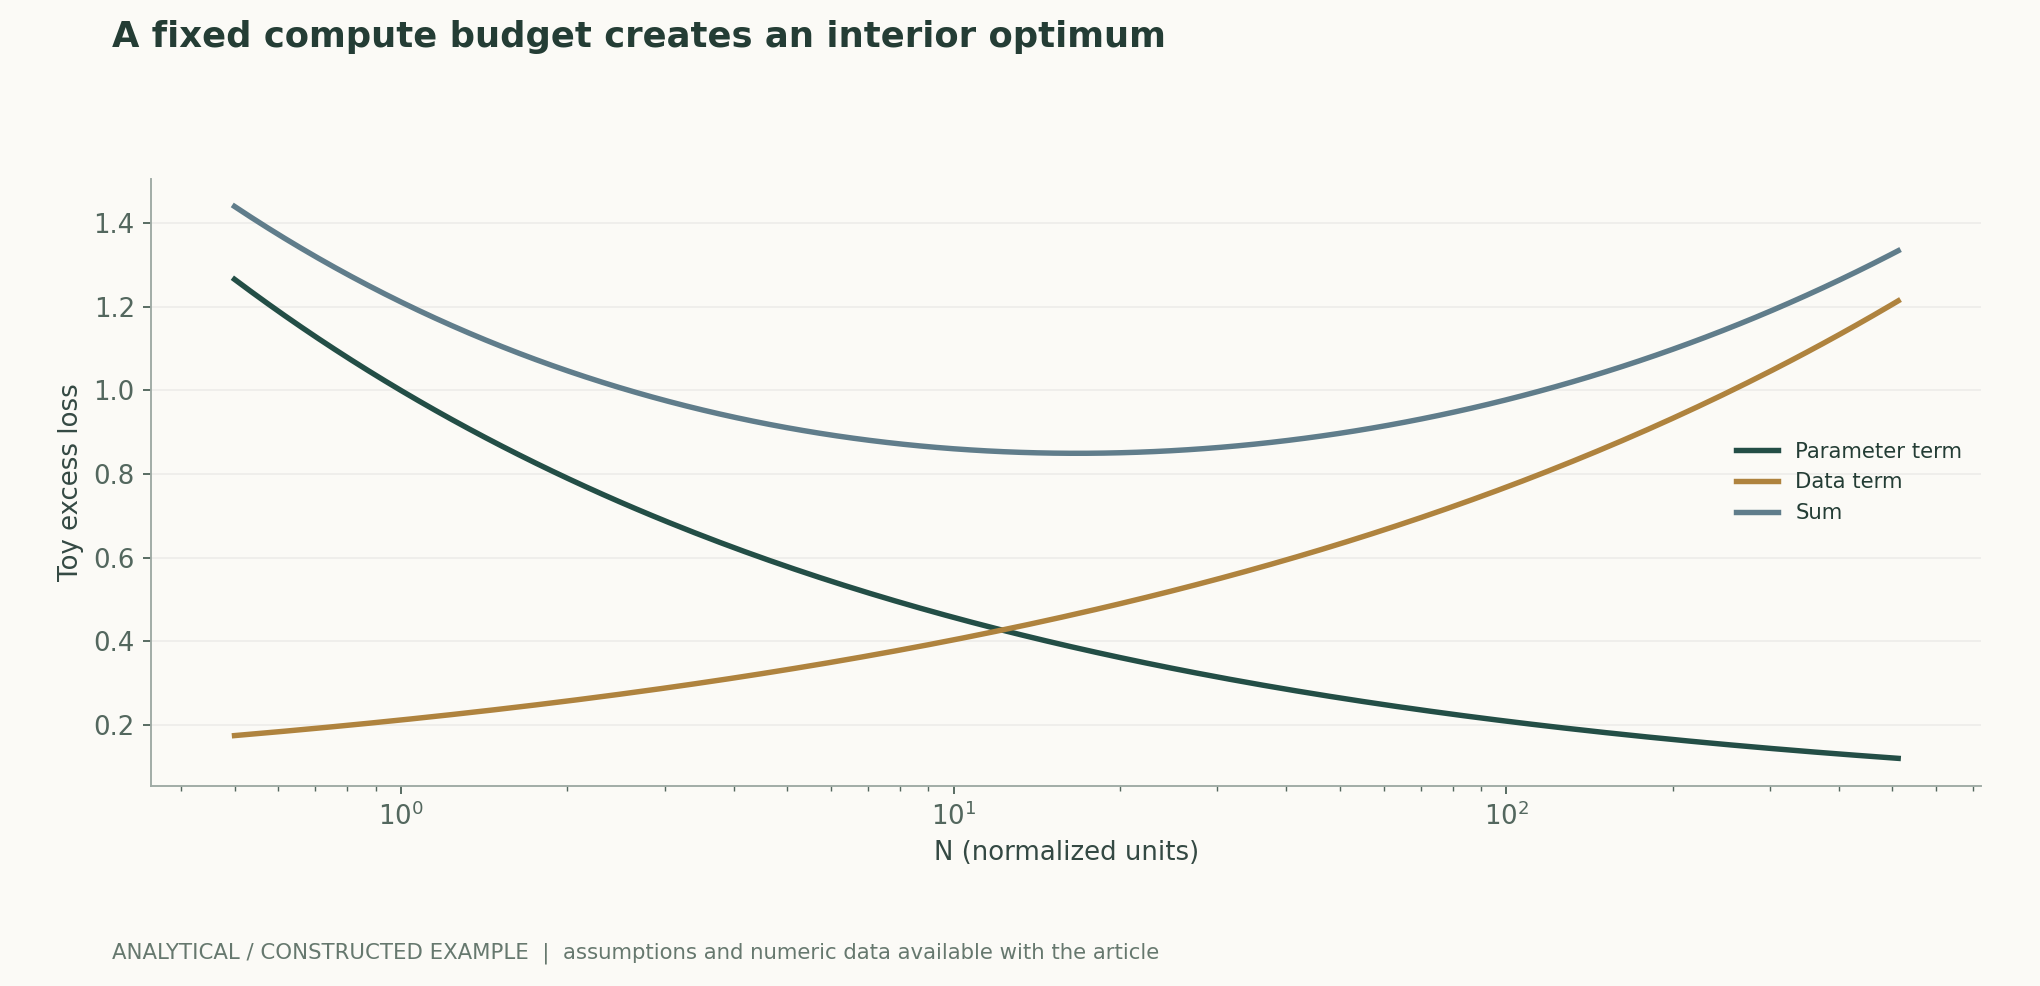
El tamaño del modelo no es un control libre independiente de los datos de entrenamiento y del presupuesto de cómputo. Sobre la base de los estudios de escalamiento existentes, este artículo formula la proporción entre parámetros del modelo y tokens de entrenamiento como un problema de optimización restringida susceptible de derivación analítica, y explica cómo los exponentes empíricos, la repetición de datos, el estado de optimización y los requisitos de despliegue modifican el óptimo. El gráfico analítico muestra únicamente una superficie de pérdida bajo supuestos explícitos; no presenta los exponentes supuestos como leyes reajustadas en este artículo. Las decisiones fiables requieren conservar las curvas completas de entrenamiento, los residuos del ajuste y la validación fuera del dominio, en lugar de mostrar únicamente una cifra de pérdida final.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
Traducción del resumen original en inglés
El escalamiento óptimo en cómputo se aborda como un diseño experimental restringido, en lugar de una receta universal. Un modelo de pérdida separable proporciona una regla de asignación bajo una aproximación de cómputo de entrenamiento fijo. La revisión explica por qué la reutilización de tokens, la calidad de los datos, la incertidumbre del ajuste y la demanda de inferencia pueden desplazar el óptimo práctico, y especifica las pruebas reservadas necesarias para distinguir una mejor asignación de un mejor conjunto de datos.
1. Qué describen las leyes de escalamiento
Kaplan y sus colaboradores estudiaron las relaciones empíricas de la pérdida con los parámetros, los datos y el cómputo en configuraciones específicas de modelado autorregresivo del lenguaje. Estas leyes son, ante todo, ajustes dentro del intervalo observado, no leyes según las cuales «la inteligencia necesariamente crece con cierto exponente». Una entropía cruzada menor tampoco permite deducir directamente citas más fiables, negativas a responder más adecuadas o una mayor cualificación profesional. El objeto del ajuste y los objetivos de la aplicación real deben especificarse por separado.[1] Scaling Laws for Neural Language Models
2. Chinchilla cambió los criterios de asignación de recursos
Hoffmann y sus colaboradores compararon distintos números de parámetros y tokens de entrenamiento, y propusieron que, con su presupuesto fijo de cómputo de entrenamiento y su configuración experimental, ambas cantidades deberían aumentar en proporciones aproximadamente iguales. El modelo Chinchilla entrenado efectivamente en el artículo utilizó unos 700 cientos de millones de parámetros y 1.4 billones de tokens de entrenamiento. Aquí, «mejor» está condicionado al entrenamiento y la evaluación de ese estudio; no implica que exista una proporción de tokens por parámetro eternamente fija para todos los modelos.[2] Training Compute-Optimal Large Language Models
3. Una restricción que suele confundirse
En el modelo aproximado de cómputo, N representa la escala de parámetros y D los tokens de entrenamiento; al duplicar ambos, el cómputo total se multiplica aproximadamente por cuatro. Si se impone artificialmente que N y D crezcan de manera equilibrada y en igual proporción, cuando el presupuesto se multiplica por c, ambos se multiplican por. Este es un ejemplo de cálculo, no una ley de asignación óptima. La figura 2 de esta versión fija ND=256 y analiza el equilibrio entre los términos de pérdida con distintos exponentes empíricos; la derivación posterior explica que la asignación óptima generalmente no exige exponentes iguales.[2] Training Compute-Optimal Large Language Models
4. El número de tokens y la información efectiva no son la misma magnitud
Los datos repetidos también consumen cómputo, pero no necesariamente aportan una cantidad equivalente de información nueva. Las diferencias de idioma, proporción de código, estrategias de deduplicación y filtrado de calidad modifican la distribución de entrenamiento. Por tanto, que un modelo «haya leído más tokens» no basta por sí solo para explicar todo su rendimiento posterior. Este artículo recomienda conservar la composición del corpus, las tasas de repetición y las comprobaciones de contaminación de la evaluación, de modo que tanto las cantidades de recursos como las propiedades de los datos figuren en el registro experimental. Se trata de una recomendación metodológica; no se ha estimado ningún conjunto de entrenamiento no divulgado.作者分析与复核建议 / Author analysis
5. Las tareas de instrucciones introducen otro eje
La investigación sobre FLAN examina factores como la mezcla de tareas, la escala y los datos de cadena de pensamiento en el ajuste fino con instrucciones, y muestra que existe un espacio de diseño para la adaptación conductual más allá de la escala del preentrenamiento. Un mismo modelo base puede rendir de forma distinta debido a diferencias en la formulación de las tareas y en el formato de supervisión. Por ello, las curvas de pérdida de entrenamiento no pueden sustituir las pruebas de seguimiento de instrucciones, ni una puntuación en una clasificación permite deducir que cierta configuración de entrenamiento sea necesariamente óptima.[3] Scaling Instruction-Finetuned Language Models
6. El entrenamiento óptimo no equivale al servicio óptimo
Para un sistema que prestará servicios de inferencia durante un período prolongado, el costo total también depende del volumen de solicitudes, la longitud del contexto, la longitud de las salidas, la caché y las restricciones de latencia. Un modelo más pequeño puede entrenarse durante más tiempo y, aun así, ser más barato por inferencia; un modelo más grande puede seguir siendo conveniente con un volumen reducido de solicitudes. Este artículo no ofrece conclusiones sobre costos sin mediciones, sino que recomienda incluir el costo de entrenamiento y el costo esperado de inferencia durante el ciclo de vida en una misma tabla presupuestaria, y después seleccionar un plan verificable.作者分析与复核建议 / Author analysis
7. Diseño de comparaciones verificables
Fijar la versión de los datos y los conjuntos de evaluación, elegir varios números de parámetros y presupuestos de tokens, y registrar la pérdida de validación y las métricas de las tareas con un criterio uniforme de contabilización del cómputo. Al comparar, también deben conservarse el programa de tasa de aprendizaje, el tamaño de lote y la estrategia de detención del entrenamiento; si solo se entrena el modelo pequeño hasta la convergencia y se detiene antes el grande, podrían estar comparándose condiciones de entrenamiento distintas. Deben declararse los intervalos de extrapolación, en lugar de tratar la curva ajustada como observaciones en todas las escalas.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
Cómo interpretar las diferencias entre ajustes
Que dos estudios de escalamiento sugieran tendencias distintas de asignación de recursos no significa que uno pueda declararse permanentemente erróneo al margen de su configuración. La escala del modelo, la duración del entrenamiento, el programa de optimización, los datos y el método de ajuste influyen en la frontera obtenida. Antes de comparar las conclusiones, debe comprobarse si cada punto corresponde a una ejecución real de entrenamiento, una predicción del ajuste o una extrapolación lejana. Los intervalos de extrapolación especialmente amplios requieren formulaciones más prudentes que el intervalo original de observación.作者分析与复核建议 / Author analysis
8. Cómo obtener las condiciones de optimalidad con un presupuesto fijo
Sea A N^(−α)+B D^(−β) la pérdida reducible, y C=κND la aproximación de cómputo fijo. Al sustituir D=C/(κN) y derivar respecto de log N, el óptimo exige que los beneficios marginales de ambos componentes sean iguales, no que sus valores de pérdida coincidan. La solución da β/(α+β) como exponente de N respecto de C, y α/(α+β) como exponente de D. Esta conclusión solo es válida dentro del ámbito en que sean aplicables la forma separable, la aproximación de cómputo y los exponentes ajustados. Explica por qué distintos diseños experimentales pueden producir proporciones diferentes, y también por qué cualquier regla empírica fija de «tokens por parámetro» necesita un dominio de aplicación.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
9. La cantidad de datos y la cantidad de información efectiva no son la misma coordenada
Repetir un corpus varias veces puede aumentar el número de tokens procesados D, pero no garantiza un aumento equivalente de información independiente. La repetición también modifica la memorización, el ruido de optimización y el solapamiento entre entrenamiento y prueba. Los estudios de deduplicación aportan evidencia real de que la ingeniería de datos afecta a los resultados, pero no debe concluirse por ello que toda repetición carezca de valor: el entrenamiento de múltiples épocas, el refuerzo de dominios poco frecuentes y el muestreo curricular persiguen objetivos distintos. La verificación exige enumerar conjuntamente los tokens originales, los documentos únicos, las reglas de deduplicación, el número de repeticiones, la mezcla de dominios y la fecha de corte de los datos; ajustar únicamente el número acumulado de tokens puede incorporar erróneamente las diferencias de calidad a los exponentes de escalamiento.[4] Deduplicating Training Data Makes Language Models Bette[2] Training Compute-Optimal Large Language Models
10. La pérdida final combina presupuesto y estado de optimización
Si algunos modelos todavía no se han acercado a una región estable de su etapa de entrenamiento, unir directamente las pérdidas finales en una curva hará que el ajuste dependa del programa de tasa de aprendizaje, el tamaño de lote y la duración del entrenamiento. Un modelo más potente también puede haber recibido simplemente un presupuesto de ajuste de hiperparámetros más adecuado. Por ello, deben conservarse curvas de múltiples puntos de control, registrarse las ejecuciones fallidas y las reglas de selección, y compararse configuraciones razonablemente ajustadas. Al realizar el ajuste, deben comunicarse los residuos y la incertidumbre de los parámetros, y validarse las predicciones con puntos presupuestarios excluidos del ajuste; una bondad de ajuste elevada en los datos de ajuste no basta para afirmar que la extrapolación sea fiable.[1] Scaling Laws for Neural Language Models[2] Training Compute-Optimal Large Language Models
11. El óptimo de despliegue puede diferir del óptimo de entrenamiento
Un plan que solo minimiza la pérdida de entrenamiento no contabiliza el costo del número futuro de inferencias, la latencia o la memoria del acelerador. Si el mismo modelo se invocará muchas veces, utilizar uno más pequeño y entrenarlo durante más tiempo puede resultar más favorable en términos de costo total del ciclo de vida; sin embargo, el punto de cruce concreto depende de la longitud real de las solicitudes, el tamaño de lote, la cuantización y el hardware de servicio. El aprendizaje posterior con instrucciones también modifica el comportamiento en las tareas, y pérdidas de preentrenamiento similares no implican la misma utilidad práctica. Al decidir, deben explicitarse como objetivos el costo de entrenamiento, el costo fijo de despliegue y el costo esperado de inferencia, y señalar después dónde se miden las restricciones de calidad.[2] Training Compute-Optimal Large Language Models[3] Scaling Instruction-Finetuned Language Models
Ecuaciones fundamentales y derivaciones
(1) N es el número de parámetros, D el número de tokens procesados, y A, B, α y β se ajustan experimentalmente; κ es el coeficiente de aproximación del cómputo. Los coeficientes de la figura son supuestos analíticos explícitos, no mediciones nuevas.
LaTeX
L(N,D)=E+AN^{-\alpha}+BD^{-\beta},\qquad C=\kappa ND(2) Derivar respecto de log N bajo la restricción presupuestaria permite obtener el equilibrio de beneficios marginales. Los intervalos de confianza de los exponentes deben propagarse a las configuraciones recomendadas, en lugar de conservar únicamente un óptimo preciso.
LaTeX
\alpha AN^{-\alpha}=\beta BD^{-\beta}\ \Longrightarrow\ N_\star\propto C^{\beta/(\alpha+\beta)},\quad D_\star\propto C^{\alpha/(\alpha+\beta)}(3) R es el número de solicitudes futuras, mientras que ℓ y b representan las condiciones reales de longitud de solicitud y tamaño de lote. Este es un marco analítico del costo del ciclo de vida, no el modelo de facturación de ningún proveedor.
LaTeX
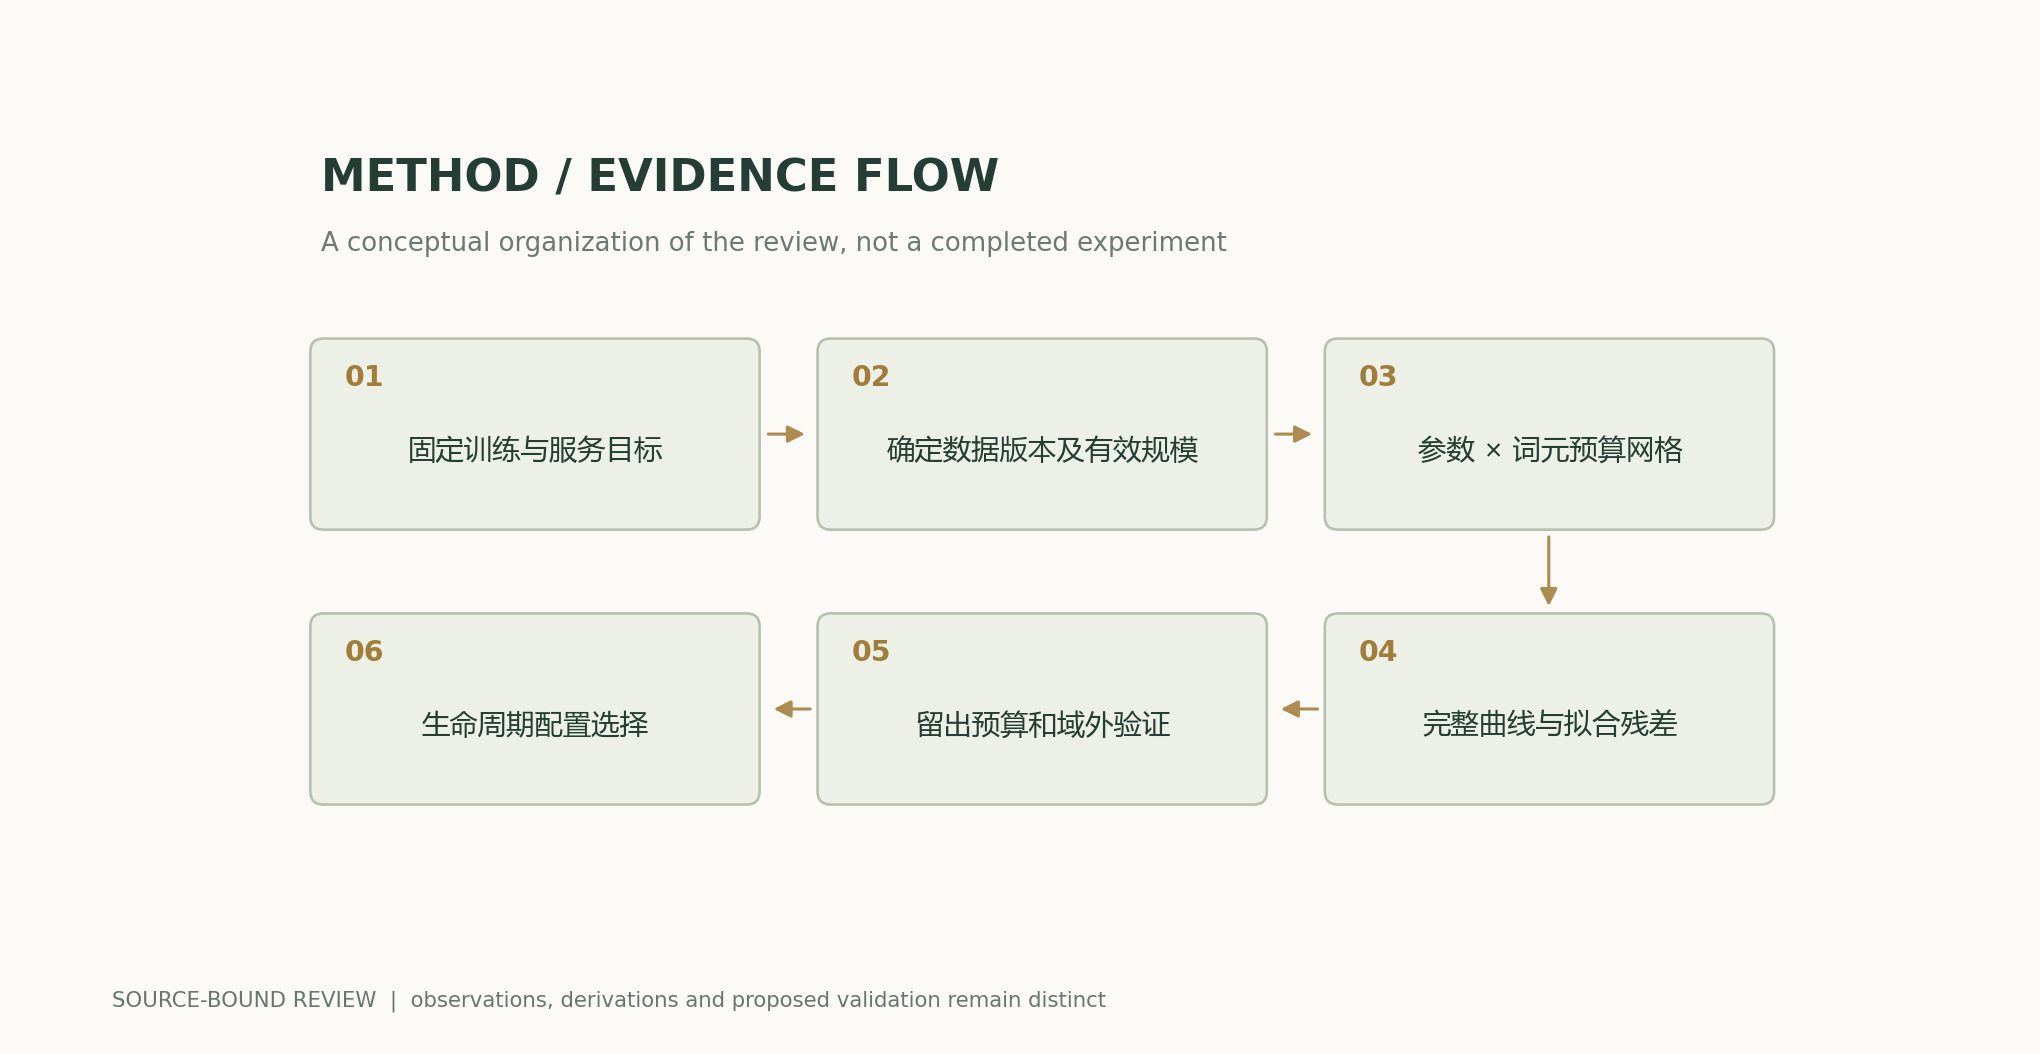
C_{\rm total}=C_{\rm train}+R\,C_{\rm inference}(N,\ell,b)Flujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Suponiendo C=256, α=0.34, β=0.28 y A=B=1, el equilibrio de las derivadas da N aproximadamente igual a 16.734 y D aproximadamente igual a 15.298. Son cálculos normalizados, no una receta de entrenamiento ni parámetros ajustados.
Comparación de métodos
| Método o criterio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Barrido de escalas de parámetros | Fijar los datos y las reglas de ajuste, y conservar las curvas completas de entrenamiento | Los distintos estados de optimización pueden distorsionar la comparación entre escalas |
| Barrido de tokens de entrenamiento | Registrar conjuntamente el corpus único, el número de repeticiones y la mezcla de dominios | Los tokens acumulados no equivalen a información independiente |
| Ajuste de exponentes de escalamiento | Reservar puntos del presupuesto de cómputo y comunicar los residuos y la incertidumbre | Un ajuste dentro del intervalo de entrenamiento no garantiza una extrapolación de largo alcance |
| Decisiones sobre el ciclo de vida | Añadir cargas reales de inferencia y restricciones de calidad | El óptimo de cómputo de entrenamiento no es necesariamente el óptimo de costo del servicio |
Plan de verificación y experimentación
- Definir de antemano los objetivos de calidad, el intervalo permitido de presupuesto de cómputo y los criterios de fallo aceptable; no cambiar la métrica que determina el ganador después de observar los resultados.
- Formar una cuadrícula cruzada con, al menos, varias escalas de parámetros y presupuestos de tokens; conservar la versión de los datos, las reglas de deduplicación, los pesos de mezcla y las semillas aleatorias.
- Utilizar reglas explícitas y verificables de ajuste para las distintas escalas, registrar el cómputo adicional de ajuste y no excluir del presupuesto los entrenamientos fallidos.
- Conservar los puntos de control intermedios del entrenamiento, comparar las curvas de pérdida frente a cómputo consumido y distinguir la falta de convergencia de las limitaciones de capacidad.
- Reservar puntos presupuestarios y evaluaciones fuera del dominio que no participen en el ajuste, y ofrecer un análisis de sensibilidad de la selección del modelo.
- Después, realizar mediciones de inferencia a pequeña escala con las solicitudes del servicio previsto para comprobar si la recomendación de entrenamiento sigue siendo adecuada bajo restricciones de latencia, memoria del acelerador y costo total.
Ámbito de aplicación y limitaciones
- Tanto la pérdida separable como C=κND son aproximaciones analíticas.
- Los exponentes supuestos en la figura no representan un ajuste empírico realizado en este artículo.
- Los cambios en los datos, el optimizador y la arquitectura pueden invalidar la extrapolación.
- No se aportan nuevos experimentos de preentrenamiento ni estimaciones de costos comerciales.
Correspondencia entre fuentes primarias y afirmaciones
- Scaling Laws for Neural Language ModelsKaplan et al. · 2020-01-23v1; sections 1 and 6
- Training Compute-Optimal Large Language ModelsHoffmann et al. · 2022-03-29v1; section 3 and section 4
- Scaling Instruction-Finetuned Language ModelsChung et al. · 2022-10-20abstract; historical 2022 research
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citación y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y la ETag no cambia. El cuerpo del texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de las figuras científicas; estas se calculan a partir de ecuaciones públicas y supuestos explícitos, y se indica la atribución de todos los resultados de los artículos originales.
Historial de autoría, versiones y correcciones · /guides/compute-optimal-scaling/v5/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770