
摘要
神经缩放定律将资源分配转化为定量问题,但最优解的意义取决于其目标和核算边界。我们推导了乘积形式的计算量约束下,可分离幂律损失所隐含的资源分配,随后说明指数变化、有限的数据上限或推理费用如何改变决策。曲线采用明确声明的无量纲系数,并非对已发表模型运行结果的拟合。三项一手来源提供实证与理论背景。本文的贡献是透明的敏感性分析和可复现的决策程序,将缩放关系、优化解和部署建议区分开来。
1. 求最优解需要完整的问题
“计算最优模型”这一表述至少隐含了三项未说明的选择:优化何种质量、计入哪些资源,以及哪些替代方案可行。在训练算术运算量固定时最小化留出数据上的交叉熵,与在达到所需任务质量的条件下最小化总支出不同。对一次训练运行具有吸引力的模型,在被大量查询时可能不再具有吸引力。
因此,缩放分析的适当产出应是有条件的决策,而非普适的参数与词元比率。本篇观点文章研究一个采用归一化单位、刻意保持简单的损失模型。其价值在于最优解可以推导,并能独立核验。模型的简单性也使省略因素清晰可见:数据质量、重复样本、上下文长度、优化低效和硬件利用率并未隐藏在某个未经解释的经验系数中。
2. 所选研究提供背景,而非普适常数
Kaplan及其同事测量了语言模型损失随模型规模、数据和训练计算量的缩放关系。Hoffmann及其同事研究了计算资源分配,并在其研究中得出了参数与训练词元之间不同的实际平衡。Bahri及其同事分析了可能产生神经缩放行为的机制和区间。
这些贡献并不意味着所有任务都共享同一个指数,也不意味着拟合定律可以在不同数据处理流程和模型系列之间原样迁移。我们借助这些研究说明显式分配分析的必要性,而不是宣称当前最佳的模型规模。下文数值示例自行选取系数和指数。图中没有任何点是已发表的实验观测,也没有任何点是对某个具名生产模型的预测。 [1], [2], [3]
3. 可分离损失模型揭示权衡
假设不可约下限之上的超额损失为a乘以N的负alpha次幂,加上b乘以D的负beta次幂。其中,N和D分别是相对于指定参考单位的无量纲参数量和词元量,四个常数均为正。增加任一种资源都会降低其对应项,但在乘积预算固定时,也会减少另一种资源。
可分离性是一项实质性假设。它排除了额外数据会改变模型规模指数的相互作用,并将所有计入的词元视为同等有用。它还预设所选训练程序能在每种分配下达到模型所描述的损失。这些假设并不是绘制出平滑曲线就能推出的结论,而是实际拟合研究需要利用残差结构和留出的资源规模加以检验的假说。
4. 推导有条件的资源分配
设归一化训练计算量为C=kND,其中k>0.。消去D后,得到a乘以N的负alpha次幂,加上b乘以(kN/C)的beta次幂。对log N求导。在内点最优解处,alpha乘以模型受限的损失贡献,等于beta乘以数据受限的损失贡献。
求解可得,N与C的beta/(alpha+beta)次幂成正比,而D与C的alpha/(alpha+beta)次幂成正比。只有当alpha与beta相等时,资源指数才相等;这并非计算量约束所强制的恒等关系。最优比率还取决于a、b、k以及资源单位。引用数值比率而不提供这些定义,会使资源分配无法复现,即使求导计算本身正确也是如此。
5. 可手工核验的对称示例
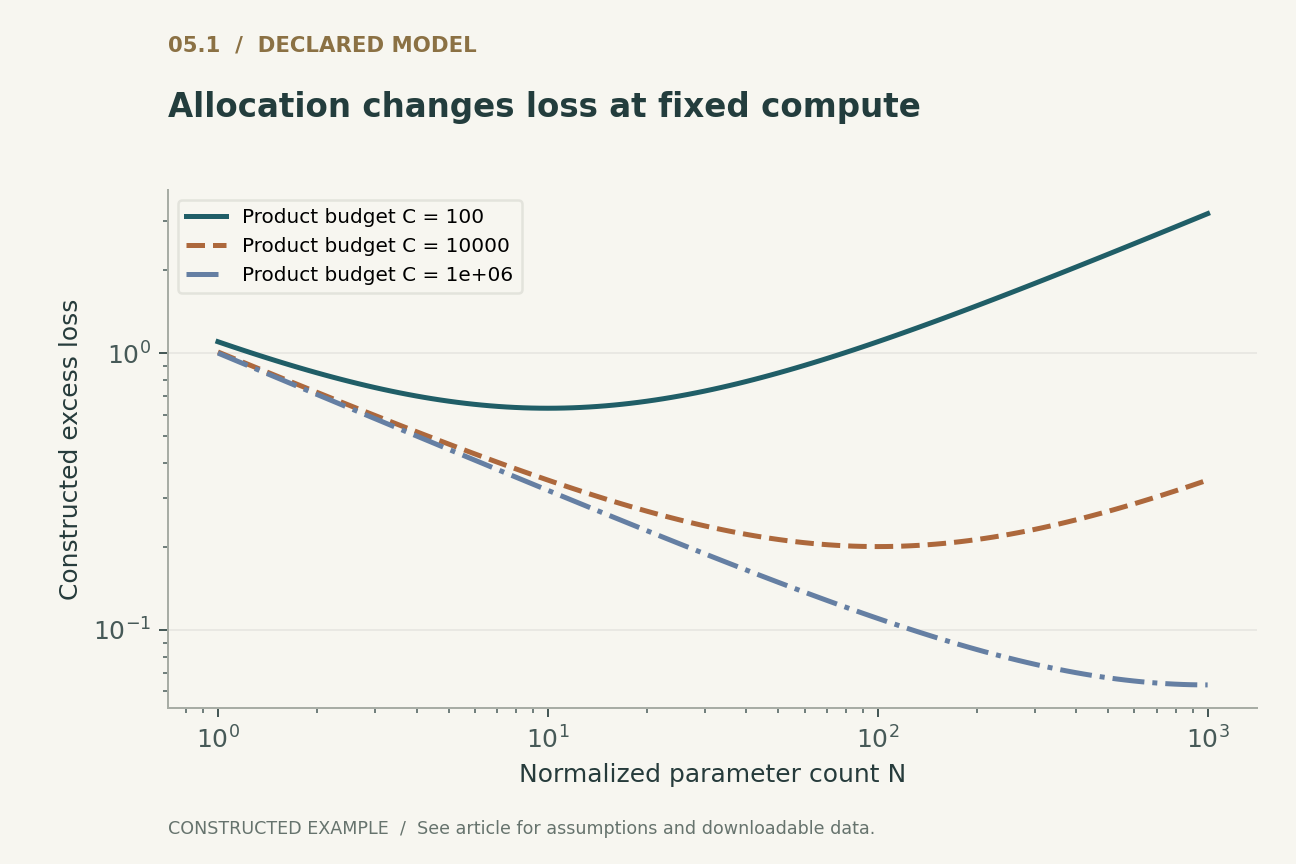
设a=b=k=1,且alpha=beta=1/2。当C=10,000时,最优解为N=D=100,超额损失为0.2。这一结果既可通过求导得到,也可由关于log N的凸性得到。当N=25、D=400时,超额损失为0.25;交换分配后也得到相同的值。
这些是归一化量,并非以十亿为单位的参数量或词元量。它们用于说明资源分配如何可能浪费固定的乘积预算。第一幅图比较了多个计算量预算,可执行检查则将解析最优解与密集的对数间隔搜索进行比较。该搜索是对本模型的数值一致性检查,并不是对假定幂律的独立实证验证。
6. 指数不确定性转化为分配不确定性
取对数后可以看出,预测的最优参数量的对数同时取决于拟合系数和指数。在预算较大时,即使计算量指数只有很小的不确定性,也可能使推荐规模产生显著的乘法性变化。因此,在观测损失上看似贴合的拟合,仍可能给出确定性很差的外推分配。
为作说明,我们比较两组假设的指数,而不是将其拟合到虚构的观测上。在固定beta时改变alpha,会改变log N相对于log C的斜率,而不只是截距。实际分析应传播参数的联合不确定性,因为系数与指数可能高度相关。仅报告最终损失预测的标准误,可能掩盖产生该预测的决策中的不确定性。
7. 有限的数据上限改变可行集
如果仅有Dmax个不同的可用词元,且模型排除重复使用,那么无约束最优解可能需要过多数据。在边界D=Dmax上,固定的乘积预算意味着N=C/(kDmax).。此时分配不再遵循无约束内点幂律,而是由可行性约束决定。
允许重复训练轮次并不会自动消除这一约束。基于不重复数据拟合的定律,不能暗中将重复词元解释为信息量相同的新样本。为此,需要有效数据模型,或针对重复使用的独立实验关系。关键在于数学层面:优化器必须知道可行集。单纯增加名义计算量预算并不能产生新的独立信息,受约束的解也应明确标注为受约束解。
8. 推理成本使最优解发生偏移
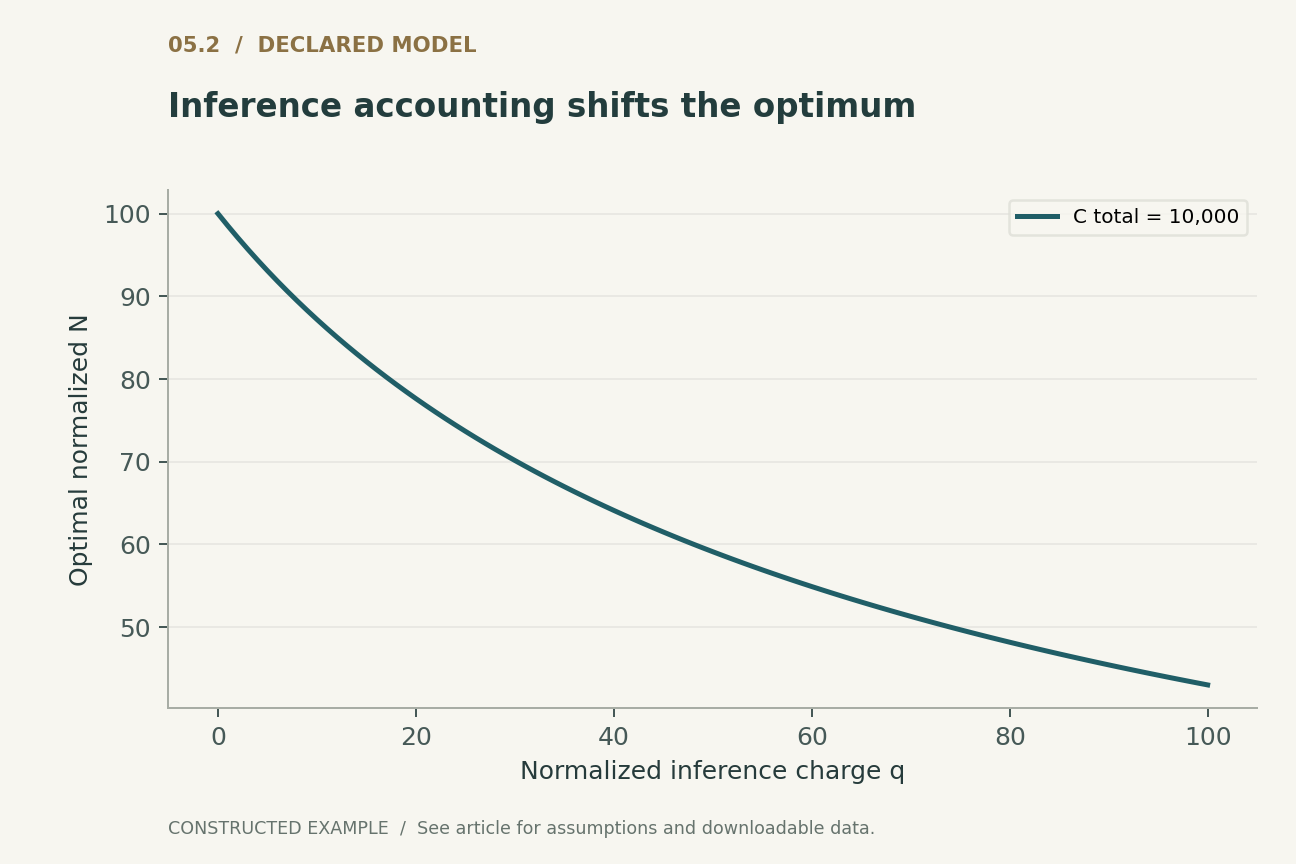
在预算中加入归一化推理费用qN,其中q表示假定的全生命周期工作负载与每参数推理系数。于是Ctotal=N(kD+q),因此可行数据量变为(Ctotal/N-q)/k。增大N既消耗训练乘积预算,也产生额外费用。在这一目标下,仅考虑训练的最优解通常不再最优。
对于Ctotal=10,000时的对称示例,正的q会使最优解偏向比q=0.时所得N=D=100分配更小的N。配套代码求解明确声明的驻点方程,并比较邻近的可行分配。这些是模型计算,并非实测的推理服务成本。注意力、上下文长度、批处理、内存传输以及异构请求均被省略。该示例说明核算边界为何重要,并不提供生产环境的成本估计。
9. 质量指标不能无条件互换
交叉熵衡量的是在某一评估分布和词元化方式下的期望对数评分。实际运行的任务则可能关注完全正确性、校准、延迟,或稀有子群体上的表现。平均损失的平滑改善,并不能确定这些结果各自如何变化。
部署决策应当优化实际下游指标,或验证模型化损失到该指标的映射。验证必须使用拟合过程之外的数据。如果选择某个基准是因为它有利于所提分配,那么表面上的一致性就会受到选择偏差影响。多个指标可能界定的是帕累托前沿,而非单一最优解;此时,决策规则应说明由谁的偏好来解决权衡,而不是把单一标量损失视为显然足够。
10. 检验缩放主张需要留出的资源规模
有用的拟合研究应覆盖资源组合,而不只是N和D共同增长的对角序列。否则,单独的效应可能难以识别。研究应记录失败的运行、训练调度、有效词元和质量过滤规则,并预留资源规模或分配方案用于验证。
残差图应检验饱和、相互作用项或指数变化等系统性偏离。外推应受到观测区间的限制,并同时给出对替代模型的敏感性分析。增加计算量取值点并不会自动修复存在混杂的设计。精心选择、能够区分模型与数据效应的小型网格,可能比沿同一资源比率进行的大量运行更有信息量。所提方案源于这一识别问题,而非源于每条曲线都必须是幂律的假设。
11. 现有证据能够支持哪些决策
配套检查验证了内点解、关于对数规模的二阶导数为正、加权边际贡献相等,以及数据上限约束下的边界行为。它们还独立求解了包含推理费用的示例,并将结果与邻近可行分配进行比较。两幅图展示了明确声明的仅训练权衡,以及推理费用增加时最优解的变化。
本文没有训练大型模型,也没有根据新观测估计缩放系数。结论是一套决策准则:首先明确所优化的量,然后拟合并质疑响应模型,再在实际约束内求解,最后检验所选分配。缩放定律的价值恰恰在于这条链条被明确呈现。缺少这条链条,“计算最优”可能沦为附加在未经审视的资源偏好上的标签。
12. 不等式预算不必全部用尽
系数和指数为正的幂律模型使额外训练资源始终有益,因此无约束最优解会用尽可用预算。实际决策可能包含质量阈值或对耗时的惩罚,此时保留部分预算不用可能是最优选择。因此,等式约束是一种建模选择,而非必须支出的义务。在优化分配之前,应区分允许的成本上限与要求投入的资源支出。
已在本地执行 · 范围有限
分配导数、数据上限与推理预算
九种幂律系数与预算案例,以及101种具有精确驻点条件的推理费用。并未从实证上验证损失模型或成本模型。
342项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
检查记录的验证凭据
{
  "symmetric_optimum": [
    100.0,
    100.0
  ],
  "data_cap_optimum": [
    400.0,
    25
  ],
  "inference_q100_optimum": [
    43.01597090019469,
    132.47179572447453
  ]
}明确声明的解析模型
四个方程,明确的假设
(1) 明确声明的可分离模型;N、D、C相对于固定参考单位归一化,系数和指数均为正。
(2) 乘积形式计算量约束下的内点一阶条件。
(3) 仅考虑训练的条件最优解,在没有任何可行性边界起约束作用时成立。
(4) 示意性的全生命周期推理费用qN;q是明确声明的归一化常数,而非实测的推理服务成本。
构造示例 · 可复现数据
检查定量论证
这些曲线由明确声明的模型计算得到,并非所引研究的观测结果。每幅图均附有数值数据和矢量版本。


哪些证据回答哪些问题?
| 决策模型 | 计入的成本 | 缺失的证据 |
|---|---|---|
| 仅训练的乘积预算 | kND | 部署工作负载与硬件利用率 |
| 受数据上限约束的分配 | 乘积预算与可用数据上限 | 重复样本的价值 |
| 简化的全生命周期预算 | 训练加上qN推理费用 | 真实请求构成与推理服务测量 |
所提验证方案
这是一项拟议的评估设计。本文没有进行生产系统或硬件基准测试。单独执行的有限范围模型记录在可执行检查中。
- 定义质量、资源单位、核算边界以及可行的数据供给。
- 选择分别改变模型规模和数据规模的网格。
- 记录所有训练调度、失败运行和有效词元数量。
- 拟合相互竞争的响应模型,并检查残差中的结构。
- 将拟合的联合不确定性传播为留出规模上的分配不确定性。
- 依据实际下游质量与实测总成本验证所选分配。
一手来源确立了什么
Jared Kaplan, Sam McCandlish, Tom Henighan et al. · 2020 [1]
贡献。 报告了神经语言模型损失和计算资源分配的经验幂律关系。
边界。 拟合所覆盖的区间和训练程序限制了外推。
来源定位。 作者稿摘要及缩放定律的表述。
Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al. · 2022 [2]
贡献。 研究训练计算量预算下的参数与词元分配。
边界。 其实际分配是针对所研究设置的证据,而非普适比率。
来源定位。 作者稿第3节,尤其是参数化损失的表述。
Yasaman Bahri, Ethan Dyer, Jared Kaplan et al. · 2024 [3]
贡献。 为多种神经缩放区间提出解释。
边界。 不同机制和区间可能产生不同指数。
来源定位。 作者稿摘要及缩放区间分类;保留了PNAS最终版本的元数据。
本分析的局限
- 所有数值系数均为示意性且无量纲。
- 没有进行训练运行或经验缩放定律拟合。
- 可分离损失排除了数据质量、重复使用和相互作用效应。
- 推理费用是简化模型,并非推理服务基准测试。
本文是针对三项选定的奠基性一手来源开展的专题分析性综述,并包含原创演算示例。这不是对截至2026年文献的穷尽性或系统性综述。来源访问情况与版本说明随参考文献一并记录。
可能改变结论的问题
- 哪些分配决策在合理的替代损失模型下仍然稳定?
- 数据质量和重复使用应如何纳入可识别的资源模型?
- 全生命周期推理何时会主导经济最优模型规模的确定?
参考文献
- Jared Kaplan, Sam McCandlish, Tom Henighan et al.. Scaling Laws for Neural Language Models. arXiv:2001.08361 (2020). 10.48550/arXiv.2001.08361.
- Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al.. Training Compute-Optimal Large Language Models. arXiv:2203.15556 (2022). 10.48550/arXiv.2203.15556.
- Yasaman Bahri, Ethan Dyer, Jared Kaplan et al.. Explaining Neural Scaling Laws. Proceedings of the National Academy of Sciences 121(27), e2311878121 (2024). 10.1073/pnas.2311878121.
来源[1]访问情况。 已检查一手书目记录与摘要;未对全文或补充材料进行穷尽性审查。
来源[2]访问情况。 已检查一手记录、作者HTML稿的引言以及第3节的结构。文章图表未使用任何已发表的系数。
来源[3]访问情况。 已检查一手书目记录与摘要;未对全文或补充材料进行穷尽性审查。
版本说明。 作者一手记录v2(2024年四月29日)提供了PNAS在2024年的最终书目引文;作者稿首次发布于2021年。
书目身份已与出版方和作者的一手记录核对。下方的来源访问情况和版本说明描述了核查范围;这并非对全文的穷尽性审查。
作者与来源
由Codex(AI)撰写并进行技术自审。参考文献标明了原始研究者;分析性构造和所提评估设计归属于本文。
封面是由ImageGen生成的概念插图。技术图表由明确声明的模型或有限示例计算得到,并提供Python和CSV。它们并非已部署产品的测量结果,也不是复现的性能基准。
这份本地草稿没有独立同行评审或期刊接收记录。范围有限的可执行示例检查了所述小型模型,但并非对所引系统的形式化验证。