
Resumen
Las leyes de escalamiento neuronal convierten la asignación de recursos en un problema cuantitativo, pero un óptimo solo tiene sentido en función de su objetivo y del perímetro de costes contabilizados. Derivamos la asignación que implica una pérdida separable de ley de potencia bajo una restricción de cómputo de tipo producto y mostramos después cómo cambian la decisión unos exponentes distintos, un límite superior finito de datos o un cargo por inferencia. Las curvas utilizan coeficientes adimensionales declarados y no son ajustes a ejecuciones de modelos publicadas. Tres fuentes primarias aportan contexto empírico y teórico. Nuestra contribución es un análisis de sensibilidad transparente y un procedimiento de decisión reproducible que distingue una relación de escalamiento, una solución de optimización y una recomendación de despliegue.
1. Un óptimo requiere una pregunta completa
La expresión «modelo óptimo en cómputo» deja sin especificar al menos tres elecciones: qué calidad se optimiza, qué recursos se contabilizan y qué alternativas son factibles. Minimizar la entropía cruzada en datos reservados con una cantidad fija de operaciones aritméticas de entrenamiento es distinto de minimizar el gasto total para una calidad requerida en la tarea. Un modelo atractivo para una ejecución de entrenamiento puede dejar de serlo cuando recibe muchas consultas.
Por tanto, el resultado apropiado de un análisis de escalamiento es una decisión condicional, no una proporción universal entre parámetros y tokens. Esta perspectiva estudia un modelo de pérdida deliberadamente sencillo en unidades normalizadas. Resulta útil porque su óptimo puede derivarse y comprobarse de forma independiente. Su sencillez también hace visibles las omisiones: la calidad de los datos, los ejemplos repetidos, la longitud del contexto, la ineficiencia de la optimización y la utilización del hardware no quedan ocultos en un coeficiente empírico sin explicar.
2. La investigación seleccionada aporta contexto, no una constante universal
Kaplan y sus colaboradores midieron el escalamiento de la pérdida de los modelos de lenguaje con el tamaño del modelo, los datos y el cómputo de entrenamiento. Hoffmann y sus colaboradores investigaron la asignación de cómputo y obtuvieron en su estudio un equilibrio práctico diferente entre parámetros y tokens de entrenamiento. Bahri y sus colaboradores analizaron mecanismos y regímenes capaces de producir comportamientos de escalamiento neuronal.
Estas contribuciones no implican que todas las tareas compartan un único exponente ni que una ley ajustada se transfiera sin cambios entre procesos de tratamiento de datos y familias de modelos. Las utilizamos para motivar un análisis explícito de asignación, no para declarar cuál es actualmente el mejor tamaño de modelo. Los ejemplos numéricos siguientes eligen sus propios coeficientes y exponentes. Ningún punto mostrado es una observación experimental publicada ni una predicción para un modelo de producción identificado por su nombre. [1], [2], [3]
3. Un modelo de pérdida separable revela el compromiso
Supongamos que la pérdida excedente por encima de un límite inferior irreducible es a por N elevado a menos alpha más b por D elevado a menos beta. Aquí, N y D son cantidades adimensionales de parámetros y tokens con respecto a unidades de referencia especificadas, y las cuatro constantes son positivas. Aumentar cualquiera de los recursos reduce su término correspondiente, pero, con un presupuesto de producto fijo, reduce el otro recurso.
La hipótesis de separabilidad es sustancial. Excluye interacciones en las que datos adicionales modifican el exponente del tamaño del modelo y trata todos los tokens contabilizados como igualmente útiles. También presupone que el procedimiento de entrenamiento elegido alcanza la pérdida modelada para cada asignación. Estas hipótesis no se deducen de una curva suave representada gráficamente. Son hipótesis que un estudio real de ajuste debería contrastar mediante la estructura de los residuos y escalas de recursos reservadas.
4. Derivación de la asignación condicional
Sea el cómputo de entrenamiento normalizado C=kND, con k>0. Al eliminar D queda a multiplicado por N elevado a menos alpha, más b multiplicado por (kN/C) elevado a beta. Derivamos con respecto a log N. En un óptimo interior, alpha por la contribución a la pérdida limitada por el modelo es igual a beta por la contribución limitada por los datos.
Al resolver, N resulta proporcional a C elevado a beta/(alpha+beta), mientras que D es proporcional a C elevado a alpha/(alpha+beta). Los exponentes de los recursos coinciden cuando alpha y beta son iguales; no se trata de una identidad impuesta por la restricción de cómputo. La proporción óptima también depende de a, b, k y de las unidades de los recursos. Citar una proporción numérica sin esas definiciones impide reproducir la asignación, aunque el cálculo de la derivada sea correcto.
5. Un ejemplo simétrico verificable a mano
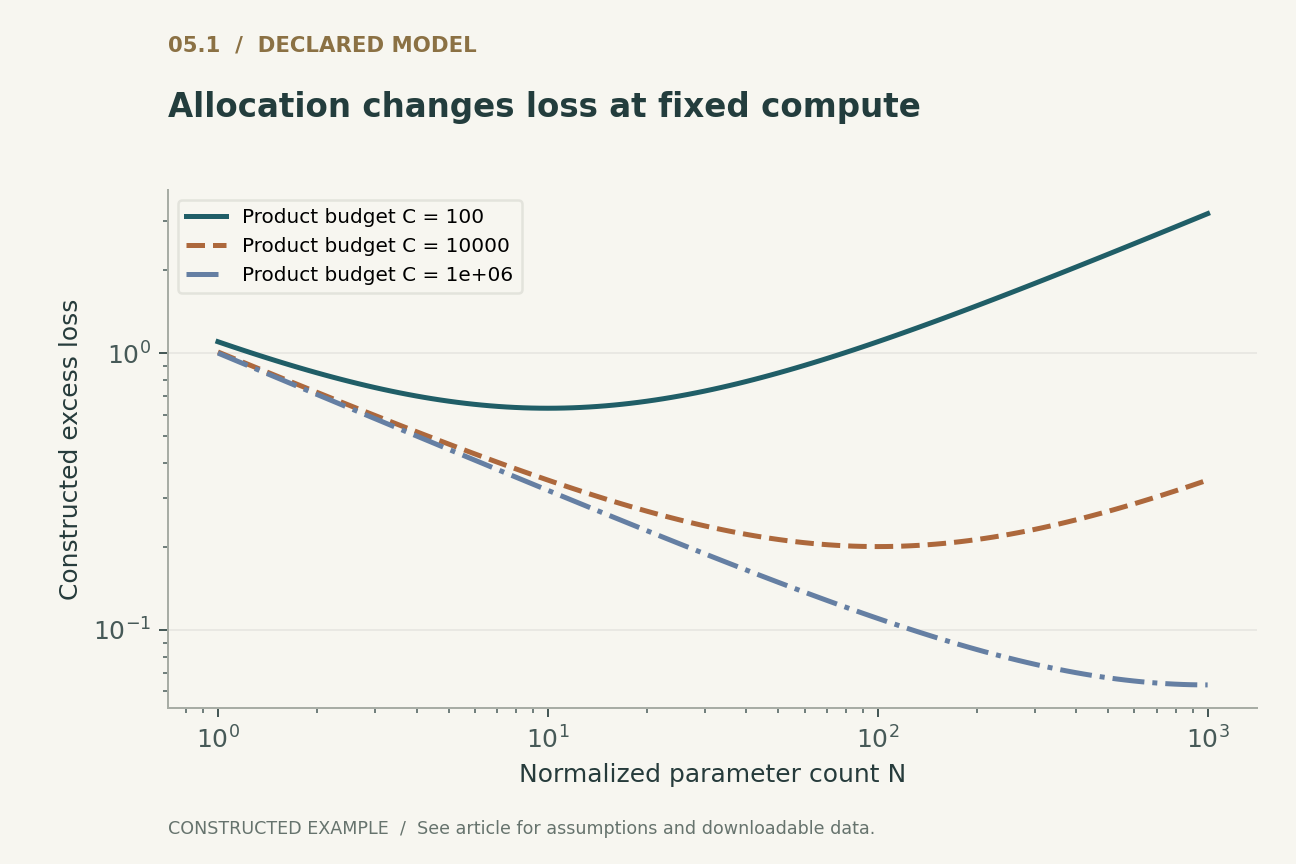
Fijemos a=b=k=1 y alpha=beta=1/2. Para C=10,000, el óptimo es N=D=100 y la pérdida excedente es 0.2. Esto se deduce tanto de la derivación como de la convexidad en log N. En N=25, D=400, la pérdida excedente es 0.25; se obtiene el mismo valor al invertir la asignación.
Estas son cantidades normalizadas, no miles de millones de parámetros o tokens. Su función es mostrar cómo una asignación puede desperdiciar un presupuesto de producto fijo. Nuestro primer gráfico compara varios presupuestos de cómputo, y la comprobación ejecutable compara el óptimo analítico con una búsqueda logarítmica densa. La búsqueda es una comprobación de coherencia numérica de este modelo, no una validación empírica independiente de la ley de potencia supuesta.
6. La incertidumbre en los exponentes se convierte en incertidumbre en la asignación
Al tomar logaritmos se observa que el logaritmo predicho del número óptimo de parámetros depende tanto de los coeficientes ajustados como de los exponentes. Con presupuestos grandes, incluso una pequeña incertidumbre en el exponente del cómputo puede producir un cambio multiplicativo considerable en el tamaño recomendado. Por tanto, un ajuste que parece aproximarse bien a las pérdidas observadas puede implicar una asignación extrapolada poco determinada.
Como ilustración, comparamos dos pares hipotéticos de exponentes en lugar de ajustarlos a observaciones inventadas. Cambiar alpha manteniendo beta fijo modifica la pendiente de log N frente a log C, no solo su ordenada en el origen. Un análisis real debería propagar la incertidumbre conjunta de los parámetros, porque los coeficientes y los exponentes pueden estar fuertemente correlacionados. Informar únicamente del error estándar de la predicción final de pérdida puede ocultar la incertidumbre de la decisión que la produjo.
7. Un límite superior finito de datos modifica el conjunto factible
Si solo se dispone de Dmax tokens distintos utilizables y el modelo excluye la repetición, el óptimo no restringido puede exigir demasiados datos. En la frontera D=Dmax, un presupuesto de producto fijo implica N=C/(kDmax). La asignación ya no sigue la ley de potencia interior no restringida. La determina una restricción de factibilidad.
Permitir épocas repetidas no elimina automáticamente esa restricción. Una ley ajustada a datos distintos no puede interpretar tácitamente los tokens repetidos como ejemplos nuevos igualmente informativos. Haría falta un modelo de datos efectivos o una relación experimental independiente para la repetición. Lo importante es matemático: un optimizador debe conocer el conjunto factible. Aumentar el presupuesto de cómputo anunciado no puede crear por sí solo nueva información independiente, y una solución restringida debe identificarse como tal.
8. Los costes de inferencia desplazan el óptimo
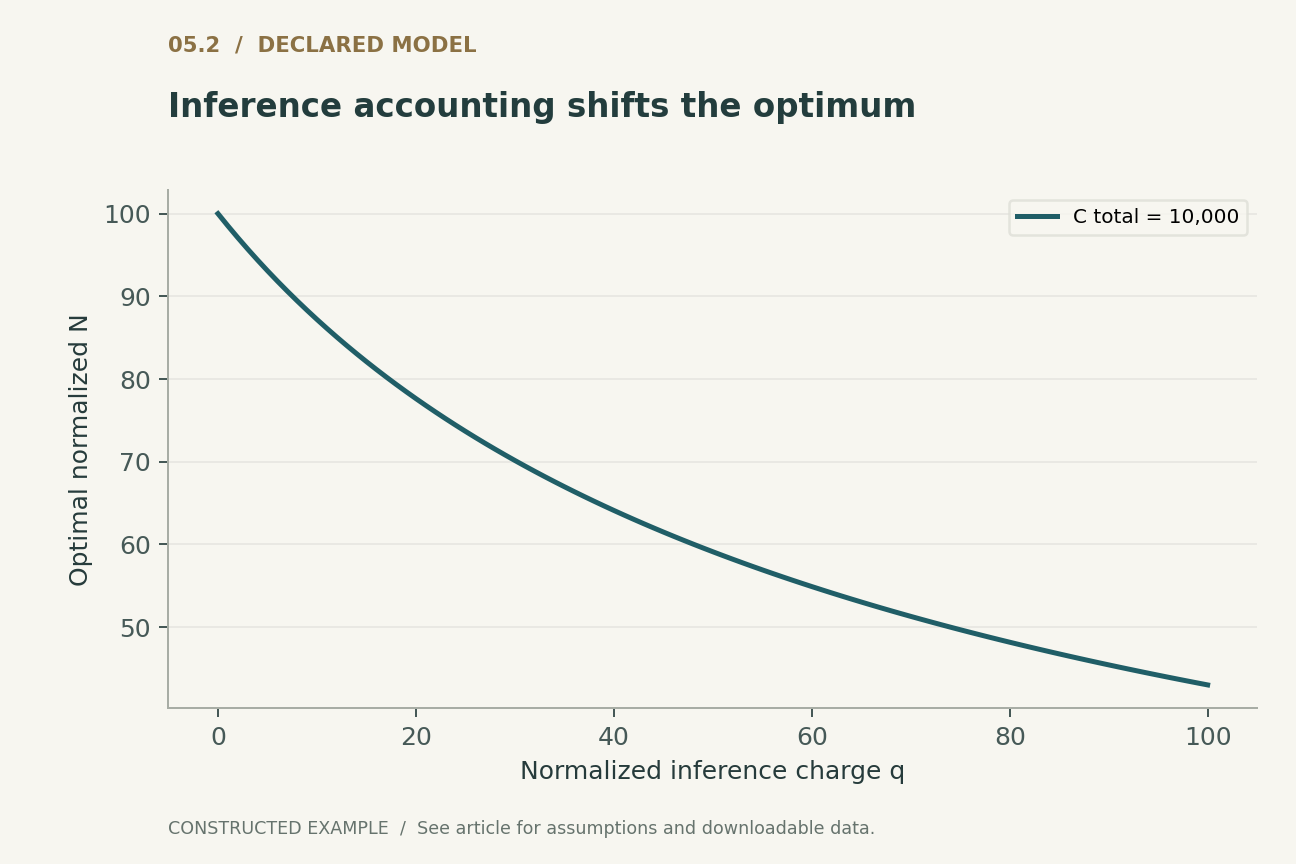
Añadamos al presupuesto un cargo normalizado de inferencia qN, donde q representa una carga de trabajo supuesta durante la vida útil y un coeficiente de inferencia por parámetro. Entonces Ctotal=N(kD+q), de modo que la cantidad factible de datos pasa a ser (Ctotal/N-q)/k. Aumentar N consume tanto presupuesto del producto de entrenamiento como un cargo adicional. Un óptimo que solo considera el entrenamiento generalmente deja de ser óptimo bajo este objetivo.
En el ejemplo simétrico con Ctotal=10,000, un q positivo desplaza el óptimo hacia un N menor que el de la asignación N=D=100 obtenida con q=0. El código adjunto resuelve la ecuación de estacionariedad declarada y compara asignaciones factibles cercanas. Son cálculos del modelo, no costes medidos del servicio de inferencia. Se omiten la atención, la longitud del contexto, el procesamiento por lotes, el tráfico de memoria y las solicitudes heterogéneas. El ejemplo muestra por qué importa el perímetro de contabilización; no proporciona una estimación de costes de producción.
9. Las métricas de calidad no son intercambiables sin consecuencias
La entropía cruzada mide una puntuación logarítmica esperada bajo una distribución de evaluación y una tokenización. En cambio, una tarea operativa puede centrarse en la corrección exacta, la calibración, la latencia o el rendimiento en un subgrupo poco frecuente. Una mejora suave de la pérdida media no determina el cambio en cada uno de esos resultados.
Una decisión de despliegue debe optimizar la métrica real de la tarea posterior o validar la correspondencia entre la pérdida modelada y esa métrica. La validación debe utilizar datos ajenos al proceso de ajuste. Si se elige un banco de pruebas porque favorece la asignación propuesta, la concordancia aparente está sujeta a sesgo de selección. Varias métricas pueden definir una frontera de Pareto en lugar de un único óptimo; en ese caso, la regla de decisión debe indicar de quién son las preferencias que resuelven el compromiso, en vez de dar por evidente que una única pérdida escalar es suficiente.
10. Evaluar una afirmación sobre escalamiento requiere escalas reservadas
Un estudio de ajuste útil abarca combinaciones de recursos, en lugar de limitarse a una secuencia diagonal en la que N y D crecen juntos. De lo contrario, los efectos separados pueden quedar mal identificados. Debe registrar las ejecuciones fallidas, los programas de entrenamiento, los tokens efectivos y los filtros de calidad, y reservar escalas de recursos o asignaciones para la validación.
Los gráficos de residuos deben comprobar desviaciones sistemáticas, como saturación, términos de interacción o exponentes cambiantes. La extrapolación debe limitarse según el régimen observado y acompañarse de un análisis de sensibilidad a modelos alternativos. Añadir puntos de cómputo no corrige automáticamente un diseño con efectos confundidos. Una pequeña cuadrícula bien elegida que separe los efectos del modelo y de los datos puede ser más informativa que muchas ejecuciones con una única proporción de recursos. El protocolo propuesto se deriva de este problema de identificación, no del supuesto de que toda curva deba ser una ley de potencia.
11. Qué puede decidirse con la evidencia actual
Las comprobaciones adjuntas verifican la solución interior, la positividad de la segunda derivada con respecto al logaritmo del tamaño, la igualdad de las contribuciones marginales ponderadas y el comportamiento en la frontera bajo un límite de datos. También resuelven de manera independiente el ejemplo que incluye la inferencia y comparan el resultado con asignaciones factibles cercanas. Las dos figuras muestran el compromiso declarado que solo considera el entrenamiento y cómo cambia el óptimo al aumentar el cargo por inferencia.
No se entrenó ningún modelo grande ni se estimaron coeficientes de escalamiento a partir de observaciones nuevas. La conclusión es una disciplina de decisión: primero identificar la cantidad que se optimiza; después, ajustar y someter a prueba el modelo de respuesta; luego, resolver dentro de las restricciones reales; y, finalmente, evaluar la asignación elegida. Una ley de escalamiento es valiosa precisamente cuando esta cadena es explícita. Sin ella, «óptimo en cómputo» puede convertirse en una etiqueta aplicada a una preferencia de recursos no examinada.
12. Un presupuesto expresado mediante una desigualdad no tiene por qué agotarse
El modelo de ley de potencia con coeficientes y exponentes positivos hace que los recursos de entrenamiento adicionales sean siempre beneficiosos, por lo que un óptimo no restringido utiliza todo el presupuesto disponible. Las decisiones reales pueden incluir un umbral de calidad o una penalización por el tiempo transcurrido, en cuyo caso puede ser óptimo dejar parte del presupuesto sin gastar. Por tanto, una restricción de igualdad es una elección de modelado, no una obligación de gasto. Antes de optimizar una asignación, hay que distinguir entre un coste máximo permitido y un gasto de recursos exigido.
Ejecutado localmente · Alcance acotado
Derivadas de la asignación, límite de datos y presupuesto de inferencia
Nueve casos de coeficientes y presupuestos de ley de potencia y 101 cargos por inferencia con condiciones exactas de estacionariedad. No valida empíricamente el modelo de pérdida ni el de costes.
Se superaron 342 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el registro probatorio
{
  "symmetric_optimum": [
    100.0,
    100.0
  ],
  "data_cap_optimum": [
    400.0,
    25
  ],
  "inference_q100_optimum": [
    43.01597090019469,
    132.47179572447453
  ]
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Modelo separable declarado; N, D y C normalizados respecto de unidades de referencia fijas, con coeficientes y exponentes positivos.
(2) Condición interior de primer orden bajo la restricción de cómputo de tipo producto.
(3) Óptimo condicional que solo considera el entrenamiento, válido cuando ninguna cota de factibilidad está activa.
(4) Cargo ilustrativo de inferencia durante la vida útil qN; q es una constante normalizada declarada, no un coste medido del servicio de inferencia.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Modelo de decisión | Costes incluidos | Evidencia faltante |
|---|---|---|
| Presupuesto de producto que solo considera el entrenamiento | kND | Carga de trabajo del despliegue y utilización del hardware |
| Asignación con límite de datos | Presupuesto de producto y límite de datos utilizables | Valor de los ejemplos repetidos |
| Presupuesto simplificado de vida útil | Entrenamiento más cargo de inferencia qN | Mezcla real de solicitudes y mediciones del servicio de inferencia |
Una propuesta de protocolo de validación
Este es un diseño de evaluación propuesto. No se realizó ningún banco de pruebas de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Definir la calidad, las unidades de recursos, el perímetro de contabilización y la disponibilidad factible de datos.
- Elegir una cuadrícula que varíe por separado el tamaño del modelo y el de los datos.
- Registrar todos los programas de entrenamiento, las ejecuciones fallidas y las cantidades de tokens efectivos.
- Ajustar modelos de respuesta alternativos e inspeccionar la estructura de los residuos.
- Propagar la incertidumbre conjunta del ajuste a la incertidumbre de la asignación en escalas reservadas.
- Validar la asignación seleccionada frente a la calidad real de las tareas posteriores y el coste total medido.
Qué establecen las fuentes primarias
Jared Kaplan, Sam McCandlish, Tom Henighan et al. · 2020 [1]
Contribución. Presenta relaciones empíricas de ley de potencia para las pérdidas de los modelos neuronales de lenguaje y la asignación de cómputo.
Límite. El régimen ajustado y el procedimiento de entrenamiento restringen la extrapolación.
Ubicación en la fuente. Resumen del manuscrito de los autores y formulación de la ley de escalamiento.
Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al. · 2022 [2]
Contribución. Estudia la asignación de parámetros y tokens bajo presupuestos de cómputo de entrenamiento.
Límite. Su asignación práctica constituye evidencia para el entorno estudiado, no una proporción universal.
Ubicación en la fuente. Sección 3 del manuscrito de los autores, especialmente la formulación paramétrica de la pérdida.
Yasaman Bahri, Ethan Dyer, Jared Kaplan et al. · 2024 [3]
Contribución. Desarrolla explicaciones para múltiples regímenes de escalamiento neuronal.
Límite. Distintos mecanismos y regímenes pueden producir exponentes diferentes.
Ubicación en la fuente. Resumen del manuscrito de los autores y taxonomía de regímenes de escalamiento; se conservan los metadatos finales de PNAS.
Límites de este análisis
- Todos los coeficientes numéricos son ilustrativos y adimensionales.
- No se realizó ninguna ejecución de entrenamiento ni ajuste empírico de una ley de escalamiento.
- La pérdida separable excluye la calidad de los datos, la repetición y los efectos de interacción.
- El cargo por inferencia es un modelo simplificado, no un banco de pruebas del servicio de inferencia.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos originales resueltos. No es una revisión exhaustiva ni sistemática de la bibliografía hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué decisiones de asignación permanecen estables bajo modelos alternativos plausibles de pérdida?
- ¿Cómo deben incorporarse la calidad de los datos y la repetición a un modelo de recursos identificable?
- ¿Cuándo domina la inferencia durante la vida útil la determinación del tamaño de modelo económicamente óptimo?
Referencias
- Jared Kaplan, Sam McCandlish, Tom Henighan et al.. Scaling Laws for Neural Language Models. arXiv:2001.08361 (2020). 10.48550/arXiv.2001.08361.
- Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al.. Training Compute-Optimal Large Language Models. arXiv:2203.15556 (2022). 10.48550/arXiv.2203.15556.
- Yasaman Bahri, Ethan Dyer, Jared Kaplan et al.. Explaining Neural Scaling Laws. Proceedings of the National Academy of Sciences 121(27), e2311878121 (2024). 10.1073/pnas.2311878121.
Acceso a la fuente [1]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Se inspeccionaron el registro primario, la introducción del manuscrito HTML de los autores y la estructura de la sección 3. En las figuras del artículo no se utiliza ningún coeficiente publicado.
Acceso a la fuente [3]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Nota de versión. El registro primario de los autores v2 (29 de abril de 2024) proporciona la referencia bibliográfica final de PNAS de 2024; el manuscrito de los autores se publicó inicialmente en 2021.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas siguientes sobre acceso a las fuentes y versiones describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos declarados; no constituyen una verificación formal de los sistemas citados.