
要旨
ニューラルスケーリング則は資源配分を定量的な問題にするが、最適解の意味は、その目的とコスト計上範囲に依存する。本稿では、積形式の計算量制約の下で、分離可能なべき乗則による損失から導かれる配分を求め、指数の変化、有限のデータ上限、または推論費用によって意思決定がどう変わるかを示す。曲線には明示した無次元係数を用いており、公表されたモデル実行結果への当てはめではない。三つの一次資料が実証的および理論的な文脈を提供する。本稿の貢献は、スケーリング関係、最適化の解、運用上の推奨を区別する、透明性のある感度分析と再現可能な意思決定手順である。
1. 最適解には完全に定式化された問いが必要である
「計算最適なモデル」という表現では、少なくとも三つの選択が明示されていない。どの品質を最適化するのか、どの資源を計上するのか、どの代替案が実行可能なのか、という選択である。訓練の算術演算量を固定して保留データ上の交差エントロピーを最小化することは、要求されるタスク品質の下で総支出を最小化することとは異なる。一回の訓練には魅力的なモデルでも、繰り返し多数の問い合わせを受ける場合には魅力的でなくなることがある。
したがって、スケーリング分析の適切な出力は、普遍的なパラメータ対トークン比ではなく、条件付きの意思決定である。本論考では、正規化単位による意図的に単純な損失モデルを検討する。このモデルは、最適解を導出し、独立に検証できる点で有用である。また、その単純さは省略事項も可視化する。データ品質、例の反復、コンテキスト長、最適化の非効率性、ハードウェア利用率が、説明のない経験的係数の中に隠されることはない。
2. 選定した研究が与えるのは文脈であり、普遍定数ではない
Kaplanらは、モデル規模、データ、訓練計算量に対する言語モデルの損失のスケーリングを測定した。Hoffmannらは計算資源の配分を検討し、その研究においてパラメータと訓練トークンの間に異なる実用的な均衡を得た。Bahriらは、ニューラルスケーリングの挙動を生みうる機構と領域を分析した。
これらの貢献は、すべてのタスクが単一の指数を共有することや、当てはめた法則がデータ処理パイプラインやモデル系列を越えてそのまま移転することを意味しない。本稿では、現在最良のモデル規模を宣言するためではなく、明示的な配分分析の動機づけとしてこれらを用いる。以下の数値例では独自の係数と指数を選ぶ。表示する点のいずれも公表された実験観測ではなく、特定の名称を持つ本番モデルの予測でもない。 [1], [2], [3]
3. 分離可能な損失モデルがトレードオフを明らかにする
不可約な下限を超える超過損失を、aとNの負のalpha乗の積に、bとDの負のbeta乗の積を加えたものと仮定する。ここでNとDは、指定した基準単位に対する無次元のパラメータ数とトークン数であり、四つの定数はすべて正である。どちらの資源を増やしても対応する項は減少するが、積形式の予算を固定すると他方の資源は減少する。
分離可能性の仮定は重要なものである。この仮定は、追加データがモデル規模の指数を変えるような相互作用を排除し、計数するすべてのトークンを同等に有用なものとして扱う。また、選択した訓練手順が各配分でモデル化された損失に到達することも前提としている。これらの仮定は、描かれた曲線が滑らかであることから導かれるものではない。実際の当てはめ研究において、残差の構造と検証用に保留した資源規模を用いて検証すべき仮説である。
4. 条件付き配分の導出
正規化された訓練計算量をC=kNDとし、k>0.とする。Dを消去すると、aとNの負のalpha乗の積に、bと(kN/C)のbeta乗の積を加えた式が残る。log Nに関して微分する。内点最適解では、モデルによって制限される損失寄与にalphaを掛けたものが、データによって制限される寄与にbetaを掛けたものと等しくなる。
これを解くと、NはCのbeta/(alpha+beta)乗に比例し、DはCのalpha/(alpha+beta)乗に比例する。資源の指数が等しくなるのはalphaとbetaが等しい場合であり、計算量制約によって課される恒等関係ではない。最適な比率はa、b、k、および資源の単位にも依存する。これらの定義なしに数値的な比率を引用すると、微分計算自体が正しくても、配分を再現することはできない。
5. 手計算で検証できる対称な例
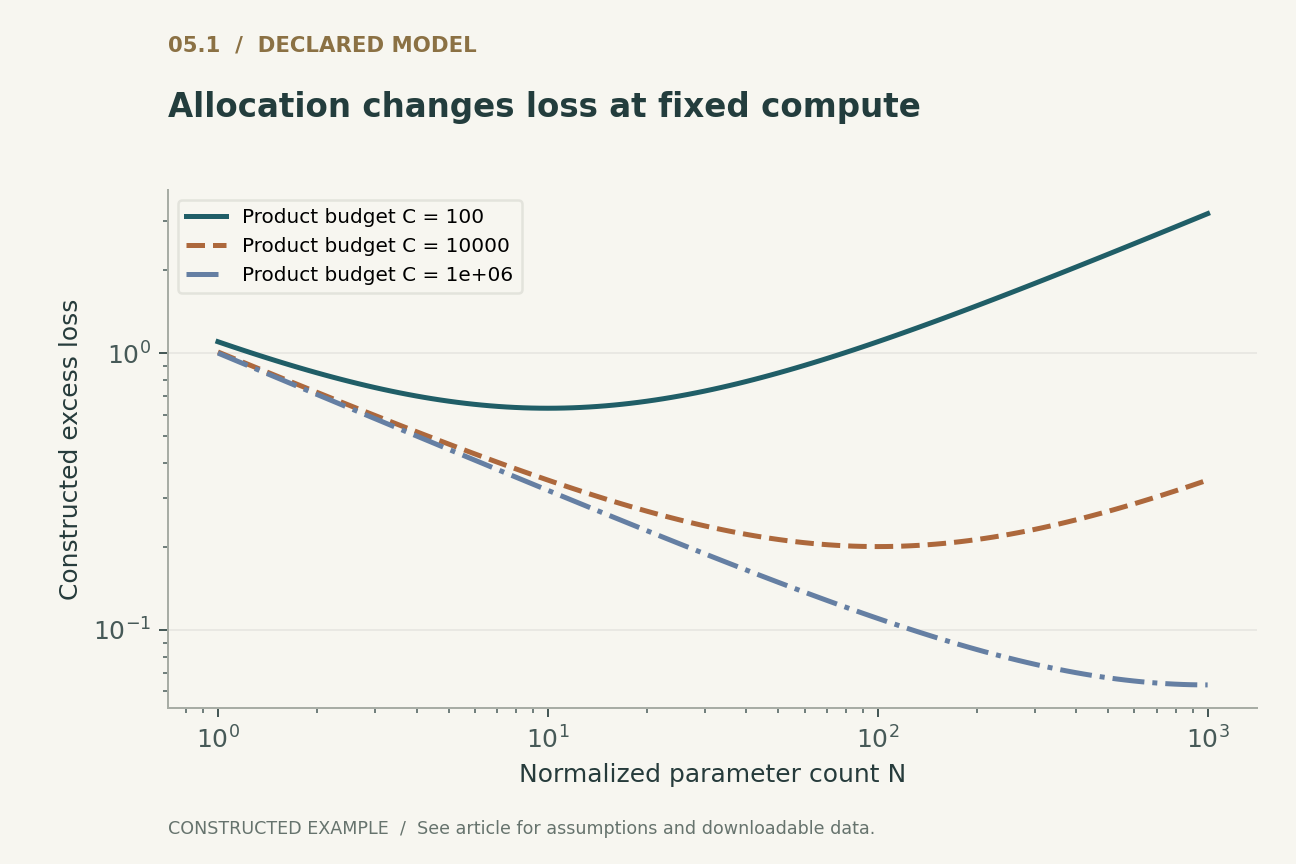
a=b=k=1、alpha=beta=1/2とする。C=10,000の場合、最適解はN=D=100であり、超過損失は0.2となる。これは微分とlog Nに関する凸性の双方から導かれる。N=25、D=400では超過損失は0.25であり、配分を逆にしても同じ値になる。
これらは正規化された量であり、十億単位のパラメータ数やトークン数ではない。その役割は、配分によって積形式の固定予算がいかに浪費されうるかを示すことである。最初の図では複数の計算量予算を比較し、実行可能な検証では解析的最適解を密な対数間隔の探索と比較する。この探索は本モデルの数値的整合性の検証であり、仮定したべき乗則の独立した実証的検証ではない。
6. 指数の不確実性は配分の不確実性となる
対数を取ると、予測される最適パラメータ数の対数は、当てはめた係数と指数の両方に依存することが分かる。予算が大きい場合、計算量に対する指数のわずかな不確実性でも、推奨規模に大きな乗法的変化を生じさせうる。したがって、観測された損失によく一致して見える当てはめでも、外挿した配分は十分に定まらない可能性がある。
説明のため、架空の観測値に当てはめるのではなく、仮想的な二組の指数を比較する。betaを固定してalphaを変えると、log Cに対するlog Nの切片だけでなく傾きも変わる。係数と指数は強く相関しうるため、実際の分析ではパラメータの同時不確実性を伝播させるべきである。最終的な損失予測の標準誤差だけを報告すると、その予測を生み出した意思決定の不確実性が隠される可能性がある。
7. 有限のデータ上限は実行可能集合を変える
利用可能な重複のないトークンがDmaxしかなく、モデルが反復を除外する場合、無制約最適解は過剰なデータを要求しうる。境界D=Dmax上では、積形式の固定予算からN=C/(kDmax).が導かれる。配分はもはや無制約の内点べき乗則には従わず、実行可能性の制約によって定まる。
エポックの反復を許しても、この制約が自動的に取り除かれるわけではない。重複のないデータに当てはめた法則で、反復トークンを同等の情報を持つ新しい例と暗黙に解釈することはできない。有効データのモデル、または反復に関する別個の実験的関係が必要になる。重要なのは数学的な点であり、最適化器は実行可能集合を把握していなければならない。公称の計算量予算を増やすだけでは、新しい独立した情報は生まれず、制約付きの解はそのように明示すべきである。
8. 推論コストは最適解を移動させる
予算に正規化された推論費用qNを追加する。qは、想定した生涯ワークロードとパラメータ当たりの推論係数を表す。するとCtotal=N(kD+q)となり、実行可能なデータ量は(Ctotal/N-q)/kとなる。Nの増加は、訓練の積形式予算と追加費用の両方を消費する。この目的の下では、訓練のみの最適解は一般に最適でなくなる。
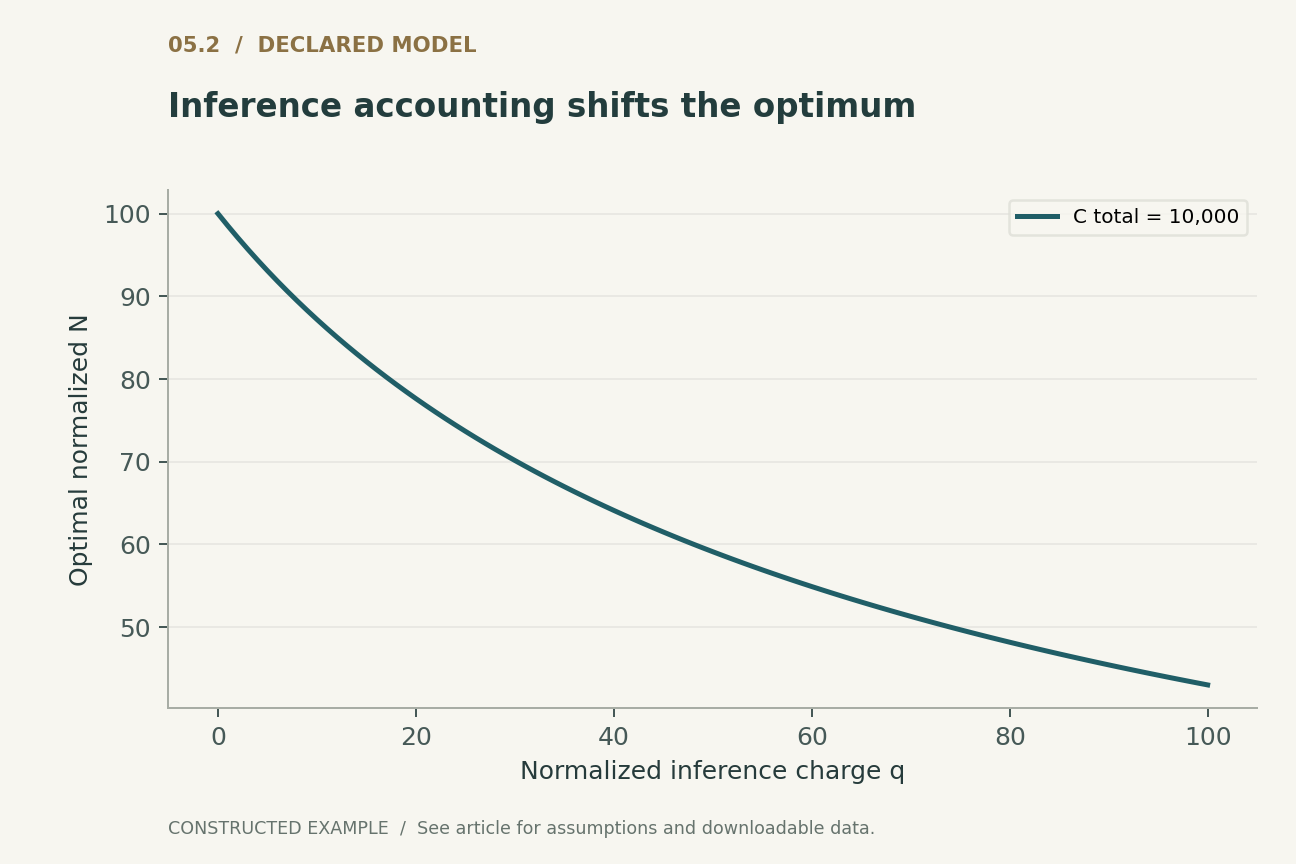
Ctotal=10,000における対称な例では、正のqによって、最適解はq=0.で得られるN=D=100の配分よりも小さいNへ移る。付属コードは明示した停留条件の方程式を解き、近傍の実行可能な配分と比較する。これらはモデル計算であり、推論サービスの実測コストではない。注意機構、コンテキスト長、バッチ処理、メモリ転送、および異種のリクエストは省略している。この例はコスト計上範囲の重要性を示すが、本番環境のコスト推定値を提供するものではない。
9. 品質指標を無条件に置き換えることはできない
交差エントロピーは、評価分布とトークン化の下での期待対数スコアを測定する。一方、運用上のタスクでは、厳密な正答性、較正、レイテンシ、またはまれな部分集団での性能が重要な場合がある。平均損失の滑らかな改善から、これら各結果の変化を特定することはできない。
運用に関する意思決定では、実際の下流指標を最適化するか、モデル化された損失からその指標への対応関係を検証すべきである。検証には当てはめ過程の外にあるデータを用いなければならない。提案した配分に有利であることを理由にベンチマークを選ぶと、見かけ上の一致は選択バイアスの影響を受ける。複数の指標が単一の最適解ではなくパレートフロンティアを定めることもある。その場合、意思決定規則は、単一のスカラー損失で自明に十分だとみなすのではなく、誰の選好によってトレードオフを解決するのかを明示すべきである。
10. スケーリングに関する主張の検証には保留した規模が必要である
有用な当てはめ研究は、NとDが同時に増加する対角方向の系列だけでなく、資源の組合せを網羅する。それをしなければ、個々の効果の識別が不十分になりうる。失敗した実行、訓練スケジュール、有効トークン、品質フィルタを記録し、資源規模または配分を検証用に保留すべきである。
残差プロットでは、飽和、相互作用項、指数の変化などの系統的な逸脱を検証すべきである。外挿は観測された領域に基づいて範囲を限定し、代替モデルに対する感度を併記すべきである。計算量の測定点を増やしても、交絡のある設計が自動的に修復されるわけではない。モデルとデータの効果を分離するよう慎重に選んだ小規模な格子の方が、単一の資源比率に沿った多数の実行より有益な場合がある。提案するプロトコルは、すべての曲線がべき乗則であるはずだという仮定ではなく、この識別問題に由来する。
11. 現在の証拠から何を決定できるか
付属の検証では、内点解、対数規模に関する二階微分の正値性、重み付き限界寄与の等価性、およびデータ上限下での境界挙動を確認する。また、推論を含む例を独立に解き、その結果を近傍の実行可能な配分と比較する。二つの図は、明示した訓練のみのトレードオフと、推論費用の増加に伴う最適解の変化を示す。
大規模モデルの訓練は行っておらず、新しい観測からスケーリング係数を推定してもいない。結論は意思決定の規律である。まず最適化する量を特定し、次に応答モデルを当てはめてその妥当性を吟味し、実際の制約内で解を求め、最後に選んだ配分を検証する。スケーリング則が有用なのは、まさにこの連鎖が明示されているときである。それがなければ、「計算最適」は吟味されていない資源選好に付けられるラベルになりうる。
12. 不等式で与えられた予算は使い切る必要がない
係数と指数が正のべき乗則モデルでは、追加の訓練資源は常に有益であるため、無制約最適解は利用可能な予算を使い切る。実際の意思決定には品質閾値や経過時間へのペナルティが含まれる場合があり、その場合は予算を残すことが最適になりうる。したがって、等式制約はモデル化上の選択であって、支出の義務ではない。配分を最適化する前に、許容されるコストの上限と、要求される資源支出を区別すべきである。
ローカルで実行済み · 限定された範囲
配分の導関数、データ上限、推論予算
べき乗則の係数と予算に関する九つのケース、および厳密な停留条件を伴う101通りの推論費用。損失モデルやコストモデルを実証的に検証するものではない。
342件のアサーションに合格。 これらの検証は、提示した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認
{
  "symmetric_optimum": [
    100.0,
    100.0
  ],
  "data_cap_optimum": [
    400.0,
    25
  ],
  "inference_q100_optimum": [
    43.01597090019469,
    132.47179572447453
  ]
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式、明示的な仮定
(1) 明示された分離可能モデル。N、D、Cは固定した基準単位で正規化され、係数と指数は正である。
(2) 積形式の計算量制約下での内点の一階条件。
(3) 実行可能性の境界がいずれも有効でない場合に成立する、訓練のみの条件付き最適解。
(4) 例示的な生涯推論費用qN。qは明示した正規化定数であり、推論サービスの実測コストではない。
構成した例 · 再現可能なデータ
定量的な議論を確認
これらの曲線は明示したモデルから計算したものであり、引用した研究の観測値ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるのか
| 意思決定モデル | 含まれるコスト | 不足する証拠 |
|---|---|---|
| 訓練のみの積形式予算 | kND | 運用時のワークロードとハードウェア利用率 |
| データ上限付き配分 | 積形式予算と利用可能データの上限 | 反復された例の価値 |
| 簡略化した生涯予算 | 訓練に推論費用qNを加えたもの | 実際のリクエスト構成と推論サービスの測定値 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限範囲のモデルは、実行可能な検証に記録している。
- 品質、資源の単位、コスト計上範囲、および実行可能なデータ供給量を定義する。
- モデル規模とデータ規模を別々に変化させる格子を選ぶ。
- すべての訓練スケジュール、失敗した実行、有効トークン数を記録する。
- 競合する応答モデルを当てはめ、残差にある構造を調べる。
- 当てはめの同時不確実性を、保留した規模での配分の不確実性へ伝播させる。
- 選択した配分を、実際の下流品質と実測した総コストに照らして検証する。
一次資料が明らかにしていること
Jared Kaplan, Sam McCandlish, Tom Henighan et al. · 2020 [1]
貢献。 ニューラル言語モデルの損失と計算資源配分について、実証的なべき乗則の関係を報告している。
適用範囲。 当てはめの対象領域と訓練手順が外挿を制約する。
出典内の該当箇所。 著者原稿の要旨とスケーリング則の定式化。
Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al. · 2022 [2]
貢献。 訓練計算量予算の下でのパラメータとトークンの配分を研究している。
適用範囲。 その実用的な配分は、研究対象の設定についての証拠であり、普遍的な比率ではない。
出典内の該当箇所。 著者原稿の第3節、特にパラメトリックな損失の定式化。
Yasaman Bahri, Ethan Dyer, Jared Kaplan et al. · 2024 [3]
貢献。 複数のニューラルスケーリング領域に対する説明を展開している。
適用範囲。 異なる機構と領域は、異なる指数を生みうる。
出典内の該当箇所。 著者原稿の要旨とスケーリング領域の分類。PNASの最終メタデータを保持している。
本分析の限界
- すべての数値係数は例示用であり、無次元である。
- 訓練の実行やスケーリング則の実証的な当てはめは行っていない。
- 分離可能な損失は、データ品質、反復、および相互作用の効果を除外している。
- 推論費用は簡略化したモデルであり、推論サービスのベンチマークではない。
選定した三つの基礎的一次資料を対象とする、独自の計算例を伴った焦点を絞った分析的レビューである。2026年までの文献を網羅するレビューや系統的レビューではない。資料へのアクセスと版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 妥当な代替損失モデルの下でも安定している配分判断はどれか。
- データ品質と反復を、識別可能な資源モデルにどう組み込むべきか。
- 生涯推論は、どのような場合に経済的に最適なモデル規模の決定を支配するのか。
参考文献
- Jared Kaplan, Sam McCandlish, Tom Henighan et al.. Scaling Laws for Neural Language Models. arXiv:2001.08361 (2020). 10.48550/arXiv.2001.08361.
- Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch et al.. Training Compute-Optimal Large Language Models. arXiv:2203.15556 (2022). 10.48550/arXiv.2203.15556.
- Yasaman Bahri, Ethan Dyer, Jared Kaplan et al.. Explaining Neural Scaling Laws. Proceedings of the National Academy of Sciences 121(27), e2311878121 (2024). 10.1073/pnas.2311878121.
出典[1]へのアクセス。 一次書誌記録と要旨を確認した。全文や補足資料の網羅的監査は行っていない。
出典[2]へのアクセス。 一次記録、著者によるHTML原稿の序論、および第3節の構成を確認した。本稿の図には公表された係数を使用していない。
出典[3]へのアクセス。 一次書誌記録と要旨を確認した。全文や補足資料の網羅的監査は行っていない。
版に関する注記。 著者の一次記録v2(2024年四月29日)は、PNASの2024年の最終書誌参照を提供する。著者原稿の初回公開は2021年である。
書誌情報の同一性は、出版社および著者の一次記録と照合した。以下の資料アクセスおよび版に関する注記は確認範囲を示すものであり、全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示する。解析的構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。運用中の製品の測定値や、性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。