
要旨
対照表現学習は、観測間の関係を学習目標へと変換する。その関係自体が、すでに実質的なモデリング上の仮定である。データ拡張方策は消去してよい区別を選び、負例サンプリングは残すべき区別を決める。本分析的レビューは、SimCLR、超球面上のアラインメントと一様性、対照予測符号化を三つの主要な拠り所とする。ペアの一致とラベル情報を分離する二値破損の構成を展開し、有限の対照目的関数における温度依存の圧力を導出し、偽負例、射影ヘッド、転移について統制された評価を規定する。掲載したすべての曲線は、明示した小規模モデルから計算される。本稿の主張は、対照学習の成功はビュー生成過程と下流で必要とされる情報に照らして記述しなければならないということである。学習損失の低さも、埋め込みの良好な広がりも、それだけでは表現が適切な情報を保持していることを示さない。
1. 目的は損失関数より前に始まる
学習器は、意味的類似性という抽象的なカテゴリーを観測するわけではない。観測するのは、データ拡張プログラム、時間的関係、対応付けデータベース、またはアノテーション過程によって生成されたペアである。エンコーダを最適化する前に、それらのペアがどの関係を近似することを意図しているのかを決める必要がある。二つの切り抜きは、同じ物体、一つの場面内の異なる物体、あるいは意図したラベルについて何も示さない微小なテクスチャを描いているかもしれない。これらは正例ペアとしての管理上は同一でも、統計的な意味は異なる。
本稿では、ビュー生成分布をモデル仕様の一部として扱う。中心的な問いは、将来のタスクに必要な情報がその分布を経ても残存し、学習済み表現から引き続き復元可能であるかどうかである。表現が失敗するのは、ビューが情報を破壊したためかもしれず、最適化が情報を捨てたためかもしれず、下流のデコーダが情報を抽出できないためかもしれない。これらは別個の失敗機構であり、それぞれ異なる測定と対策を必要とする。
2. SimCLRが明らかにしたこと
ChenらはSimCLRを導入し、特定の視覚学習パイプラインにおいて、データ拡張の組み合わせ、非線形射影ヘッド、学習規模を検討した。そのアブレーション研究は、対照目的関数を取り巻く実装上の選択が、測定される転移性能に実質的な影響を及ぼすことを示している。同論文は、選択したデータ拡張があらゆる有用なラベルを保持することも、あるベンチマークでの改善がタスクに依存しない情報保証となることも示していない。
ここで用いる概念的な区別は、エンコーダ表現と、対照損失が作用する射影後の座標との区別である。原論文はこの区別を実証的に調べる動機を与えるが、以下の反例と診断は本稿独自の構成である。報告済みのSimCLRの正解率は一切再現しておらず、付随する図の測定値としても用いていない。 [1]
3. 適用範囲を明示した幾何学的視点
WangとIsolaは、正例ペアのアラインメントと、超球面上の正規化された表現の一様性を分析している。その研究は、有用な幾何学的分解と対照目的関数の漸近解析を提供する。しかし、一様性を意味的妥当性の定義にするものではない。分布は無関係な識別子を符号化しながら球面を覆うことができ、タスクに関連する表現は、タスク自体が単純であるために制限された部分集合を占めることがある。
適用範囲は重要である。正規化が幾何を規定し、正例ペアの確率法則がアラインメントを規定し、周辺分布が広げられる母集団を規定する。これらの診断を、正規化されていない埋め込み、変化するサンプリング分布、または著しく不均衡なタスクに適用する場合には、その変更を明示する必要がある。本稿ではこの枠組みを分析の視点として用い、普遍的な十分性定理としては用いない。 [2]
4. 予測と情報量の限界
対照予測符号化は、予測的な潜在表現と負例サンプリング目的関数を用いる。その解析は、その構成で用いるサンプリング仮定の下で、母集団レベルの対照目的関数を相互情報量の下界に結び付ける。負例をキュー、フィルタリング済みインデックス、またはクラス依存のサンプラーから取得する場合、これらの仮定が重要になる。
その界が対象とするのは、指定された確率変数間の情報であって、自動的に下流ラベルに関する情報となるわけではない。さらに、有限の候補集合は、候補識別問題から構成される推定値の規模を制限する。以下の二値例はCPCの実験とは独立している。この例は、ある手法が抽象的に情報を最大化すると述べるよりも、確率変数を特定する方が有益である理由を示すよう設計されている。 [3]
5. 二ビットの反例
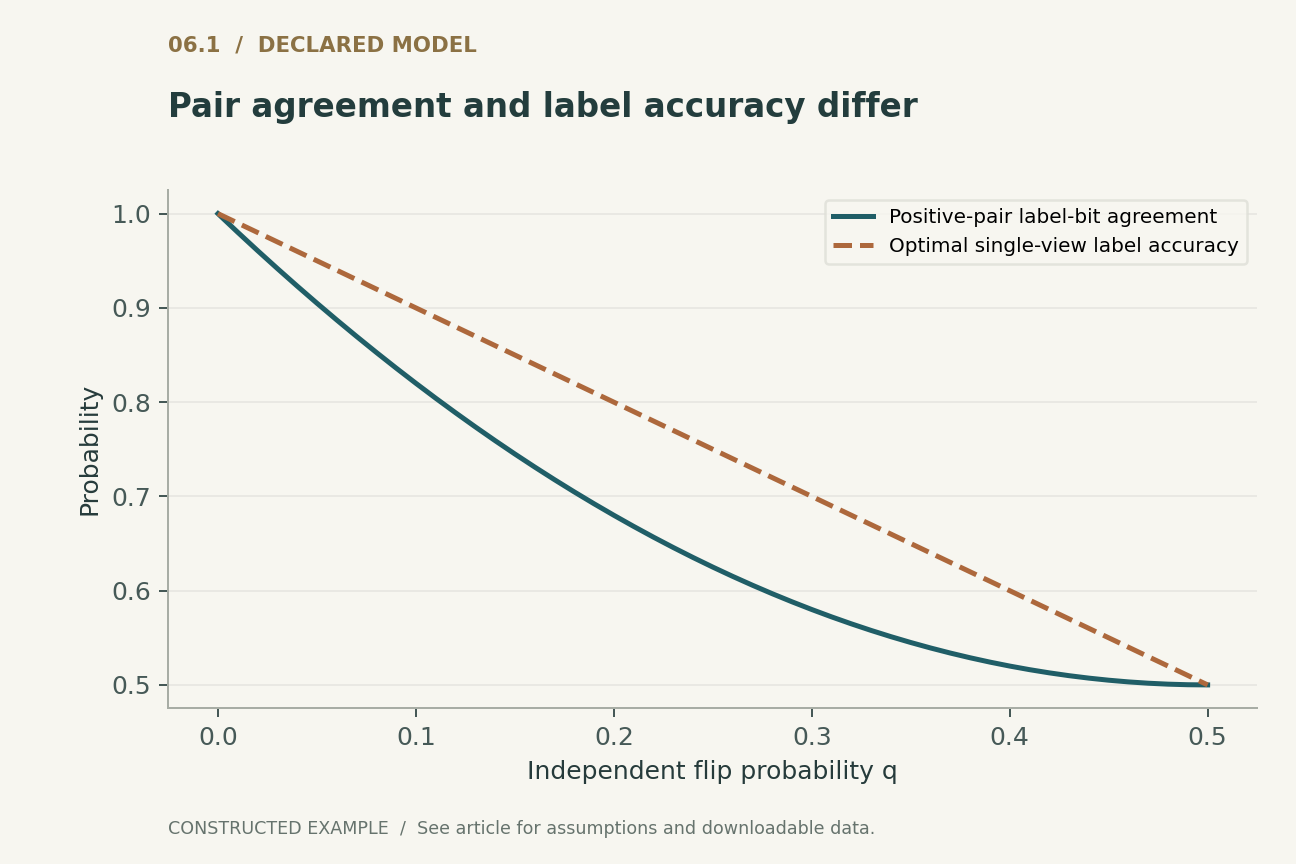
観測が、独立な二つの公平なビット、すなわち目的とするラベルYと安定した攪乱変数Sを含むとする。ビューはSを保持する一方、確率qでYを独立に反転させる。qの範囲はゼロから二分の一までとする。したがって、同じ観測の二つのビューは攪乱変数を完全に共有する一方、ラベル由来のビットは、一からqと一引くqの積の二倍を引いた確率で一致する。破損したラベルビット一つからYを予測する際の最良の正解率は、一引くqである。
qが二分の一に等しいとき、破損したビットはYから独立である。そのビューだけを見る表現には、理想的なデコーダと無制限の学習例があっても、偶然を超えてYを復元する手段がない。一方、Sに基づく表現は、正例ペア間で完全に整列できる。この有限例は、現実のデータ拡張が二値通信路であると主張するものではなく、学習では逆転できない情報損失を切り出したものである。パネル1は、ペアの一致を保持されたラベル正解率と取り違えないよう、二つの異なる確率を描いている。
6. 正解率が崩れる前に情報は滑らかに失われうる
同じ公平な二値通信路では、Yとその破損した観測との相互情報量は、一から二値エントロピーを引いた値となる。最適な分類正解率は線形に低下するが、情報量の曲線は非線形である。この違いは、表現が閾値処理された単一のラベルではなく、複数の下流の意思決定や較正された確率推定を支えることを期待される場合に重要となる。
qが四分の一に等しいとき、単一ビューの最適正解率は四分の三であるのに対し、保持される情報量は約0.189ビットにすぎない。この厳密な通信路計算は、ニューラルネットワークの相互情報量の推定ではない。エンコーダを導入する以前から、異なる要約統計量は異なる問いに答えることを示している。したがって実証的な調査では、対象ラベルの分布、予測損失、そして評価対象が単一ビュー、複数の独立したビュー、元の破損していない入力のいずれであるかを報告すべきである。二つのビューを組み合わせることは利用可能な証拠を変えうるため、比較条件を暗黙に変えてはならない。
7. 温度はどの誤りが支配的になるかを変える
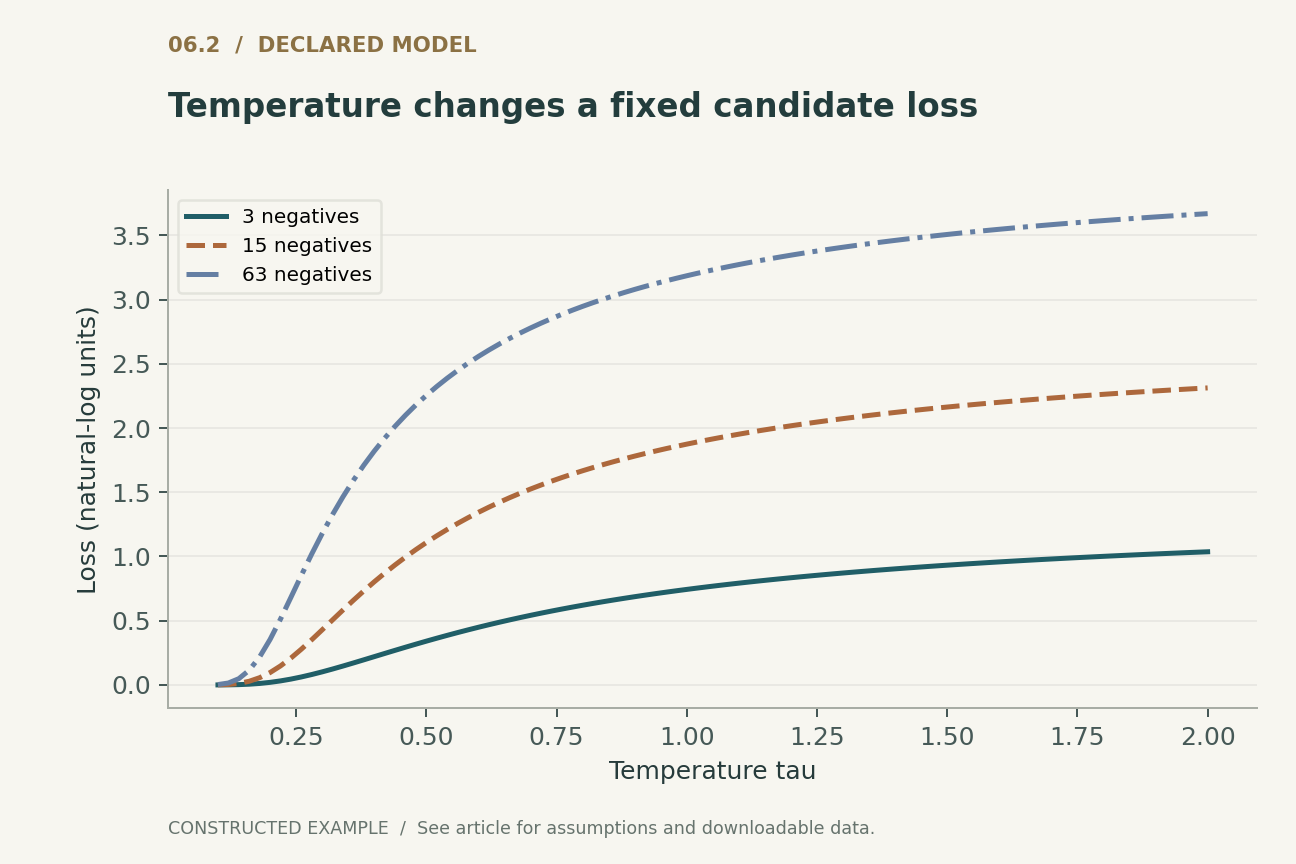
意図的に単純化した候補集合を考える。正例の類似度一つが一であり、K個の負例の類似度はすべてゼロである。損失は、一にKと負の一を温度で割った値の指数関数との積を加えた値の対数となる。パネル2は、三つの有限な負例数についてこの式を評価している。これは目的関数値の計算であり、模擬的な学習曲線ではない。
正例の類似度で損失を微分すると、そのsoftmax確率から一を引き、温度で割った値が得られる。したがって、温度を下げると候補重みの分布と微分値の尺度の両方が変わる。すでに存在する区別を鋭くすることはできるが、類似度の高い負例が意味的に偽負例であるかどうかは判定できない。温度を比較する際には、学習率の調整と数値安定性を統制する必要がある。そうしなければ、表現の見かけ上の改善の一部が最適化の効果である可能性がある。すべての候補のロジットを同じ定数だけずらしても確率は変化しない。これは付随する実行可能コードで確認される基本的な不変性である。
8. 負例の増加はタスクを変えうる
負例サンプラーは、対応しない観測についての仮説である。意図したクラス分布が不均衡な場合、バッチを大きくすると、アンカーと有用なクラスを共有する例の数が増える可能性がある。それらをすべて同程度に望ましくない近傍として扱うと、後段の分類器がまとめたいと考えるクラスの内部で分離を促す可能性がある。
これは負例が多いほど有害であることの証明ではない。インスタンスの同一性は有用な構造を含みうるし、十分に柔軟な表現はインスタンスとクラスの両方の情報を保持できる。要点は、候補数と候補の意味を別々に変化させるべきだということである。統制実験では、候補数を固定して意味的衝突率を変え、次に衝突過程を固定して候補数を変えるべきである。バッチサイズだけを報告すると、最適化器のノイズ、正規化統計量、計算量を含む複数の介入が混在する。負例数は計数上の値であり、サンプリング過程が規定されて初めて科学的説明となる。
9. 射影ヘッドは有用な区別を隠しうる
エンコーダがラベル座標と攪乱座標の両方を保持し、射影ヘッドがラベル座標を捨てるとする。対照損失が見るのは射影だけであるが、ヘッドの前に接続された分類器は依然としてラベルを復元できる。逆の構成も可能である。射影後の有用な区別が、制約された線形プローブにとって条件の悪い上流表現と共存することもありうる。
したがって、プローブは接続層、正規化、正則化、学習予算を明示しなければならない。弱いプローブは保持された情報を過小評価しうる一方、非常に柔軟なプローブは、その表現から情報を抽出することが高コストであるという事実を隠しうる。適切な比較は、想定する運用に依存する。実際の利用側が小規模な線形モデルであれば、線形アクセス可能性は直接的な意味を持つ。利用側が大規模ネットワークをファインチューニングするなら、それは別の問いに答える。単一のスカラー転移スコアで両方の設定を公正に代表することはできず、テストラベルを確認した後で層を選ぶと、追加の選択バイアスが生じる。
10. 不変性はユースケースを条件とすべきである
色を除去するデータ拡張は、形状分類タスクには有益である一方、色で表される物質状態を対象とするタスクには有害となりうる。どちらのタスクも、そのデータ拡張を本質的に良いもの、あるいは悪いものにするわけではない。擁護可能な記述は条件付きである。すなわち、この変換は、この取得過程の下で、この対象を保持することを意図している、という記述である。
したがって、有用な監査では、各不変性に対して想定される対抗タスクを組み合わせる。切り抜きは計数と小物体の有無に対して、時間的近接性は急速に変化する事象に対して、色の変化は色彩内容を持つラベルに対して検証すべきである。これらは提案する診断カテゴリーであり、特定のモデルについて主張する結果ではない。対抗タスクが製品の対象範囲外であれば、その失敗を隠すよりも、除外を文書化する方が有益である。対象範囲内であれば、複数のビューを保持する、タスクを考慮したデータ拡張を用いる、あるいは不変成分と同変成分を分けた表現を学習することができる。そのような選択は単純さと情報保持をトレードオフし、表現と意思決定の両方の水準で評価すべきである。
11. 原因を切り分ける評価
提案する評価は、目的変数と攪乱変数が既知である明示的な生成玩具システムから始め、次に変換を監査できる実データセットへ進む。玩具システムは厳密なベイズ限界を提供し、実データセットは現実的な関連性を提供する。どちらも他方の代わりにはならない。モデルは、データへの曝露量と最適化予算を揃え、可能な場合にはデータ拡張の乱数を対応させて比較すべきである。
必要な測定は三つある。正例ペアのアラインメント、周辺分布の幾何、事前に規定したタスクでの下流リスクである。第四の測定では、データ拡張による除去が許容された情報を検証する。これにより、一つの診断における改善が暗黙に普遍的な主張へ昇格することを防ぐ。信頼区間は、単一の実行内で相関した例を独立した実行として扱うのではなく、独立した学習シードとデータサンプリングを反映すべきである。提供する実行可能プログラムが検証するのは、有限通信路の確率、目的関数の不変性、構成した反例のみである。SimCLRの学習もImageNetベンチマークの再現も行わない。
12. 表現の契約
説得力のある対照学習の主張は、何を正例とするか、負例をどのように抽出するか、どこから表現を読み出すか、どの意思決定を支える必要があるかを述べる。この四つの宣言により、結果は反証可能になる。また、失敗への対処も可能になる。情報が破壊されるならビュー生成過程を、情報の保持が系統的に抑制されるなら目的関数を、保持された情報にアクセスできないならデコーダを変更すればよい。
二値例が示すのは限定的な不可能性である。観測に存在しない情報は、その観測の決定論的エンコーダによって復元できない。幾何と温度の分析も、同様に限定された診断を示す。これらを組み合わせることで、事前タスクの目的を一般的理解の主張へ変えることなく、転移実験を規律を持って解釈する方法が得られる。今後の研究では、ビュー分布の変化の下で、表現が明示的に名付けられた複数の区別を保持するかどうかを検証すべきである。これは、埋め込みが単に整然と見えるかどうかを問うよりも、強く有用な研究課題である。
ローカルで実行済み · 限定された範囲
二値ビューの情報、攪乱変数による反例、対照目的関数の不変性
有限二値通信路の列挙と、固定候補の損失検証。対照エンコーダの学習は行わない。
202件のアサーションが成功した。 これらの検証が妥当性を確認するのは提供した例であり、引用したシステムではない。
記録された検証証跡を確認
{
  "q": 0.25,
  "pair_agreement": 0.625,
  "bayes_accuracy": 0.75,
  "q_half_label_accuracy": 0.5,
  "nuisance_alignment": 1,
  "negative_counts": [
    3,
    15,
    63
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全体を読む
明示した解析モデル
四つの方程式と明示的な仮定
(1) 正例一つ、負例K個、実数値の類似度、温度tau > 0による有限候補損失。
(2) この微分は候補の類似度を固定した場合に成り立つ。右辺の特殊例からパネル2を生成する。これは学習軌跡ではない。
(3) Yは公平なビットであり、各Vは範囲[0,1/2]内の確率qでYを独立に反転させる。正解率は単一ビューに関するものである。
(4) 相互情報量は、明示した二元対称通信路についてビット単位で表し、0 log 0をゼロと定義する。
構成した例 · 再現可能なデータ
定量的な議論を確認
これらの曲線は明示したモデルから計算したものであり、引用した研究の観測結果ではない。各図には数値データとベクトル版を付している。


どの証拠がどの問いに答えるのか
| 診断 | 明らかにできること | 未検証のまま残ること |
|---|---|---|
| 正例のアラインメント | 指定したビューの確率法則の下での一致 | タスクに関連する区別の保持 |
| 一様性 | 選択した幾何と周辺分布の下での被覆 | 符号化された情報の意味的な同一性 |
| 線形プローブ | 指定した線形学習器にとってのアクセス可能性 | 任意の下流手続きにとっての利用可能性 |
| 有限対照損失 | サンプラーの下での候補識別 | 普遍的な転移、または偽負例の不在 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証に記載している。
- 二ビット通信路を列挙し、各データ拡張がどの変数を保持するかを記録する。
- 調整に先立ち、下流タスク、対抗タスク、プローブの接続層を事前に規定する。
- 温度と負例数を、意味的衝突確率とは別に変化させる。
- 学習データへの曝露量を揃え、最適化予算を対称的に調整する。
- アラインメント、周辺分布の幾何、下流リスク、独立シード間の不確実性を併せて報告する。
- ビュー生成コードと、不変性が有用な情報を破壊する例を公開する。
一次資料が明らかにしていること
Ting Chen, Simon Kornblith, Mohammad Norouzi et al. · 2020 [1]
貢献。 SimCLRでは、データ拡張、射影ヘッド、学習規模の選択が評価されている。
適用範囲。 報告された比較は、論文の学習設定と評価設定に関するものである。
資料内の該当箇所。 要旨、および枠組みとアブレーションの節。
Tongzhou Wang, Phillip Isola · 2020 [2]
貢献。 アラインメントと一様性は、正規化表現の幾何と漸近解析を提供する。
適用範囲。 それらの仮定は、タスクに依存しない意味的十分性を含意しない。
資料内の該当箇所。 要旨、およびアラインメントと一様性の定義。
Aaron van den Oord, Yazhe Li, Oriol Vinyals · 2018 [3]
貢献。 CPCは、潜在空間での予測を負例サンプリングによる情報目的関数に結び付ける。
適用範囲。 サンプリング仮定と確率変数が何であるかによって、情報の解釈が決まる。
資料内の該当箇所。 第2節と情報量の界に関する議論。
本分析の限界
- 二値構成は情報に関する有限の反例であり、現実的な画像分布ではない。
- 候補損失の曲線は類似度を固定しており、学習済みネットワークの正解率を予測できない。
- 三つの基礎的資料は、すべての対照手法を対象とした体系的サーベイを構成するものではない。
- ニューラルネットワークの学習、ベンチマークの追試、独立した査読は実施していない。
選定した三つの基礎的一次資料に焦点を当て、独自の計算例を添えた分析的レビューである。2026年までの文献を網羅的または体系的に調査したものではない。資料へのアクセスと版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- データ拡張方策は、各タスクのラベルなしに、明示された複数の下流の区別を保持できるか。
- カテゴリーがデータを分割せず重なり合う場合、偽負例率をどのように推定すべきか。
- 下流の計算予算を固定したとき、どの層別診断がアクセス可能性を予測するか。
参考文献
- Ting Chen, Simon Kornblith, Mohammad Norouzi et al.. A Simple Framework for Contrastive Learning of Visual Representations. Proceedings of the 37th International Conference on Machine Learning (2020). Primary source.
- Tongzhou Wang, Phillip Isola. Understanding Contrastive Representation Learning through Alignment and Uniformity on the Hypersphere. Proceedings of the 37th International Conference on Machine Learning (2020). Primary source.
- Aaron van den Oord, Yazhe Li, Oriol Vinyals. Representation Learning with Contrastive Predictive Coding. arXiv (2018). 10.48550/arXiv.1807.03748.
資料[1]へのアクセス。 一次論文のPDF本文と一次書誌情報ページを確認した。
資料[2]へのアクセス。 一次論文のPDF本文と一次書誌情報ページを確認した。
資料[3]へのアクセス。 一次論文のPDF本文と一次書誌情報ページを確認した。
版に関する注記。 初出は2018年。参照したPDFは、2019年一月22日付のarXiv v2である。この項目はプレプリントを引用しており、会議論文として出版されたと主張するものではない。
書誌上の同定は、出版社と著者の一次記録と照合した。以下の資料アクセスおよび版に関する注記が確認範囲を示しており、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を示し、分析的構成と提案する評価設計は本稿に帰属する。
カバーはImageGenによる概念的なイラストである。技術的な図は、明示したモデルまたは有限例から計算しており、PythonとCSVを提供している。運用中の製品の測定値でも、性能ベンチマークの再現結果でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。