
Resumen
El aprendizaje contrastivo de representaciones convierte una relación entre observaciones en un objetivo de aprendizaje. Esa relación ya constituye un supuesto sustantivo de modelado: una política de aumento de datos selecciona qué distinciones pueden borrarse, mientras que el muestreo de negativos decide cuáles deben permanecer. Esta revisión analítica utiliza como tres referencias principales SimCLR, la alineación y uniformidad hiperesféricas y la codificación predictiva contrastiva. Desarrolla una construcción de corrupción binaria que separa la concordancia entre pares de la información sobre la etiqueta, deriva la presión dependiente de la temperatura de un objetivo contrastivo finito y especifica evaluaciones controladas de falsos negativos, cabezas de proyección y transferencia. Todas las curvas trazadas se calculan a partir de pequeños modelos declarados. El argumento es que el éxito contrastivo debe describirse en relación con un proceso generador de vistas y un requisito de información para tareas posteriores; ni una pérdida de entrenamiento baja ni una distribución bien extendida de las representaciones vectoriales establecen por sí solas que la representación retenga la información adecuada.
1. El objetivo comienza antes de la pérdida
Un sistema de aprendizaje no observa una categoría abstracta llamada similitud semántica. Observa pares producidos por un programa de aumento de datos, una relación temporal, una base de datos de correspondencias o un proceso de anotación. Antes de optimizar un codificador, hay que decidir qué relación se pretende que aproximen esos pares. Dos recortes pueden mostrar el mismo objeto, objetos distintos de una escena o una textura diminuta que nada dice sobre la etiqueta prevista. Estos casos se registran de manera idéntica como pares positivos, pero tienen significados estadísticos diferentes.
Este artículo considera la distribución de generación de vistas parte de la especificación del modelo. Su pregunta central es si la información que necesita una tarea futura sobrevive a esa distribución y sigue siendo recuperable a partir de la representación entrenada. Una representación puede fallar porque la vista destruyó la información, porque la optimización la descartó o porque el decodificador posterior no puede extraerla. Son mecanismos de fallo distintos que requieren mediciones separadas y soluciones diferentes.
2. Qué establece SimCLR
Chen y sus colegas presentan SimCLR y examinan la composición de aumentos, una cabeza de proyección no lineal y la escala de entrenamiento en un flujo de aprendizaje visual concreto. Sus estudios de ablación establecen que las decisiones de implementación en torno a un objetivo contrastivo afectan sustancialmente a su rendimiento de transferencia medido. El artículo no establece que un aumento elegido preserve todas las etiquetas útiles ni que una mejora en un banco de pruebas sea una garantía de información independiente de la tarea.
La distinción conceptual utilizada aquí es entre la representación del codificador y las coordenadas proyectadas sobre las que actúa la pérdida contrastiva. El artículo original motiva el examen empírico de esta distinción; los contraejemplos y diagnósticos que siguen son construcciones propias del presente artículo. No se reproduce ninguna exactitud publicada de SimCLR ni se utiliza como medición en las figuras adjuntas. [1]
3. Una perspectiva geométrica con un dominio explícito
Wang e Isola analizan la alineación de pares positivos y la uniformidad de representaciones normalizadas sobre una hiperesfera. Su trabajo aporta una descomposición geométrica útil y un análisis asintótico de los objetivos contrastivos. No convierte la uniformidad en una definición de adecuación semántica. Una distribución puede cubrir una esfera mientras codifica un identificador irrelevante, y una representación pertinente para una tarea puede ocupar un subconjunto restringido porque la tarea misma es sencilla.
El alcance importa: la normalización especifica la geometría, la ley de los pares positivos especifica la alineación y la distribución marginal especifica la población que se dispersa. Aplicar estos diagnósticos a una representación vectorial no normalizada, a una distribución de muestreo cambiante o a una tarea muy desequilibrada exige explicitar esos cambios. Utilizamos su marco como perspectiva de análisis, no como teorema universal de suficiencia. [2]
4. Predicción y cotas de información
La codificación predictiva contrastiva utiliza representaciones latentes predictivas y un objetivo de muestreo de negativos. Su análisis conecta un objetivo contrastivo poblacional con una cota inferior de la información mutua bajo los supuestos de muestreo empleados en esa construcción. Esos supuestos importan cuando los negativos se extraen de una cola, un índice filtrado o un muestreador dependiente de la clase.
La cota se refiere a la información entre las variables aleatorias especificadas, no automáticamente a la información sobre una etiqueta de una tarea posterior. Además, un conjunto finito de candidatos limita la magnitud de una estimación construida a partir del problema de identificación del candidato. El siguiente ejemplo binario es independiente de los experimentos de CPC. Está diseñado para mostrar por qué identificar las variables aleatorias resulta más informativo que afirmar, en abstracto, que un método maximiza información. [3]
5. Un contraejemplo de dos bits
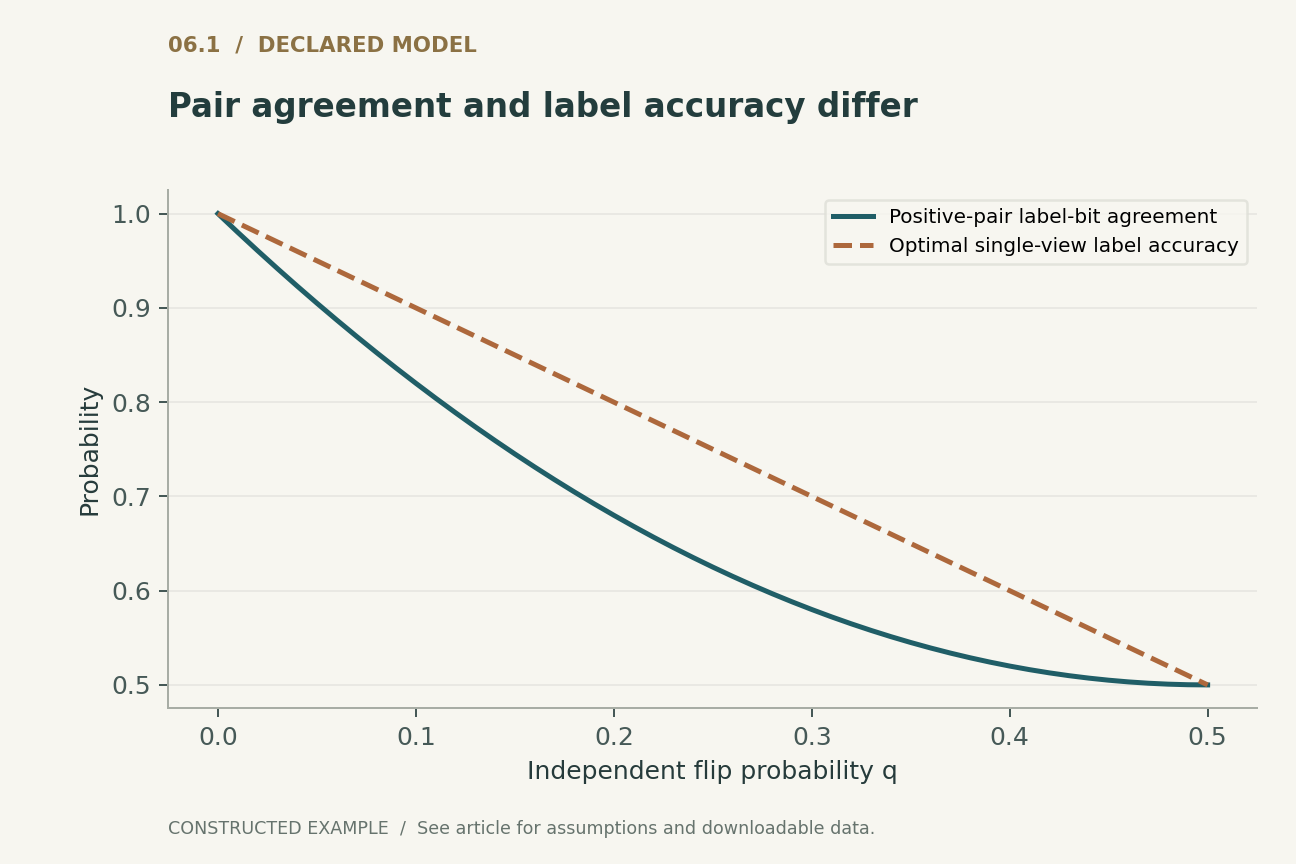
Sea una observación que contiene dos bits independientes y equiprobables: una etiqueta deseada Y y una variable de perturbación estable S. Una vista preserva S, pero invierte Y de forma independiente con probabilidad q, donde q varía de cero a un medio. Por tanto, dos vistas de la misma observación comparten exactamente la variable de perturbación, mientras que sus bits derivados de la etiqueta coinciden con probabilidad uno menos dos veces q por uno menos q. La mejor predicción de Y a partir de un único bit de etiqueta corrompido tiene una exactitud de uno menos q.
Cuando q es igual a un medio, el bit corrompido es independiente de Y. Cualquier representación que solo vea esa vista carece de una vía para recuperar Y por encima del azar, incluso con un decodificador ideal y ejemplos de entrenamiento ilimitados. Entretanto, una representación basada en S puede alinearse perfectamente entre pares positivos. El ejemplo finito no afirma que los aumentos reales sean canales binarios; aísla una pérdida de información que el entrenamiento no puede revertir. El panel 1 representa las dos probabilidades distintas para evitar que la concordancia entre pares se confunda con la exactitud conservada de la etiqueta.
6. La información puede desaparecer gradualmente antes de que se desplome la exactitud
Para el mismo canal binario equiprobable, la información mutua entre Y y su observación corrompida es uno menos la entropía binaria. La curva de información es no lineal, aunque la exactitud de clasificación óptima disminuya linealmente. Esta diferencia importa cuando se espera que una representación sustente varias decisiones posteriores o estimaciones de probabilidad calibradas, en lugar de una sola etiqueta obtenida mediante un umbral.
Cuando q es igual a un cuarto, la exactitud óptima con una sola vista es de tres cuartos, mientras que la información retenida es de solo unos 0.189 bits. Este cálculo exacto del canal no es una estimación de la información mutua de una red neuronal. Indica que distintos estadísticos de resumen responden a preguntas diferentes incluso antes de introducir un codificador. Por ello, una investigación empírica debería informar de la distribución de la etiqueta objetivo, la pérdida de predicción y si la evaluación se refiere a una vista, a varias vistas independientes o a la entrada original sin corromper. Combinar dos vistas puede modificar la evidencia disponible y no debe cambiar tácitamente la comparación.
7. La temperatura cambia qué errores predominan
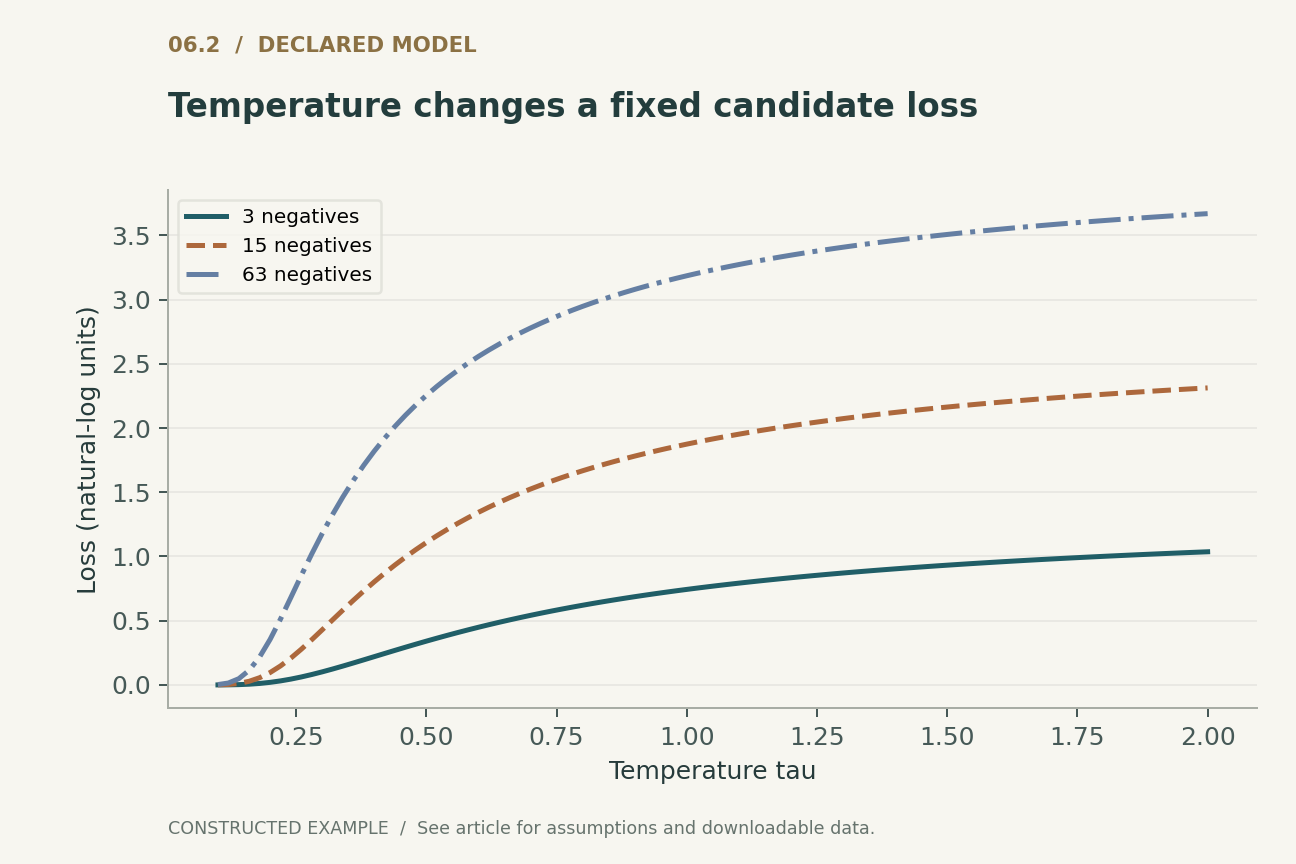
Considérese un conjunto de candidatos deliberadamente sencillo: una similitud positiva es igual a uno y cada una de las K similitudes negativas es igual a cero. La pérdida es el logaritmo de uno más K por la exponencial de menos uno dividido por la temperatura. El panel 2 evalúa esta expresión para tres cantidades finitas de negativos. Se trata de un cálculo del valor del objetivo, no de una curva de entrenamiento simulada.
Al derivar la pérdida respecto de la similitud positiva se obtiene su probabilidad softmax menos uno, dividida por la temperatura. Por tanto, una temperatura menor cambia tanto la distribución de los pesos de los candidatos como la escala de la derivada. Puede acentuar distinciones ya presentes; no puede identificar si un negativo muy similar es semánticamente un falso negativo. Al comparar temperaturas, deben controlarse el ajuste de la tasa de aprendizaje y la estabilidad numérica. De lo contrario, una aparente mejora de la representación puede ser, en parte, un efecto de la optimización. Desplazar todos los logits de los candidatos por la misma constante deja las probabilidades sin cambios, un invariante básico comprobado por el material ejecutable complementario.
8. Más negativos pueden cambiar la tarea
Un muestreador de negativos es una hipótesis sobre observaciones que no se corresponden. Si la distribución de clases prevista está desequilibrada, los lotes mayores pueden incrementar el número de ejemplos que comparten una clase útil con un ancla. Tratar a todos ellos como vecinos igualmente indeseables puede favorecer la separación dentro de una clase que un clasificador posterior preferiría agrupar.
Esto no demuestra que más negativos sean perjudiciales. La identidad de las instancias puede contener estructura útil, y una representación suficientemente flexible puede preservar información tanto de la instancia como de la clase. La cuestión es que la cantidad de candidatos y su significado deben variarse por separado. Un experimento controlado debería fijar la cantidad de candidatos mientras modifica las tasas de colisión semántica, y después fijar el proceso de colisión mientras modifica la cantidad. Informar solo del tamaño del lote combina varias intervenciones, entre ellas el ruido del optimizador, las estadísticas de normalización y el cómputo. La cantidad de negativos es una cifra contable; solo se convierte en una explicación científica después de especificar el proceso de muestreo.
9. Una cabeza de proyección puede ocultar una distinción útil
Supóngase que un codificador conserva tanto una coordenada de etiqueta como una coordenada de perturbación, mientras que su cabeza de proyección descarta la coordenada de etiqueta. La pérdida contrastiva solo ve la proyección, pero un clasificador conectado antes de la cabeza aún podría recuperar la etiqueta. La disposición opuesta también es posible: una distinción útil en la proyección puede coexistir con una representación previa mal condicionada para una sonda lineal restringida.
En consecuencia, una sonda debe identificar su capa de conexión, normalización, regularización y presupuesto de entrenamiento. Una sonda débil puede subestimar la información retenida; una muy flexible puede ocultar que la representación hace costosa la extracción de información. La comparación pertinente depende del despliegue previsto. Si el consumidor real es un pequeño modelo lineal, la accesibilidad lineal tiene relevancia directa. Si el consumidor realizará un ajuste fino de una red grande, se responde a otra pregunta. Una única puntuación escalar de transferencia no puede representar justamente ambos escenarios, y seleccionar una capa después de inspeccionar las etiquetas de prueba introduce un sesgo de selección adicional.
10. La invariancia debe estar condicionada al caso de uso
Un aumento que elimina el color puede ayudar a una tarea de clasificación de formas y perjudicar una tarea cuyo objetivo sea un estado de un material expresado mediante el color. Ninguna de las dos tareas hace que el aumento sea intrínsecamente bueno o malo. La afirmación defendible es condicional: esta transformación pretende preservar este objetivo bajo este proceso de adquisición.
Por ello, una auditoría útil asocia cada invariancia con una posible contratarea. El recorte debería ponerse a prueba frente al conteo y la presencia de objetos pequeños; la proximidad temporal, frente a eventos que cambian rápidamente; y los cambios de color, frente a etiquetas con contenido cromático. Son categorías diagnósticas propuestas, no resultados atribuidos a un modelo concreto. Si una contratarea queda fuera del alcance del producto, documentar esa exclusión es más informativo que ocultar su fallo. Si está dentro del alcance, se pueden conservar varias vistas, utilizar aumentos que tengan en cuenta la tarea o entrenar una representación con componentes invariantes y equivariantes separados. Tales decisiones intercambian simplicidad por preservación de información y deberían evaluarse tanto en el nivel de la representación como en el de la decisión.
11. Una evaluación que separa las causas
La evaluación propuesta comienza con un sistema generativo de juguete explícito en el que se conocen las variables deseadas y las de perturbación, y después pasa a un conjunto de datos real cuyas transformaciones puedan auditarse. El sistema de juguete ofrece límites bayesianos exactos; el conjunto de datos real ofrece pertinencia. Ninguno sustituye al otro. Los modelos deberían compararse con una exposición a los datos y un presupuesto de optimización equiparados, emparejando la aleatoriedad del aumento cuando sea posible.
Se necesitan tres mediciones: alineación de pares positivos, geometría marginal y riesgo posterior en tareas preespecificadas. Una cuarta medición examina la información que se permitió eliminar al aumento. Esto evita que una mejora en un diagnóstico se eleve tácitamente a afirmación universal. Los intervalos de confianza deberían reflejar semillas de entrenamiento independientes y el muestreo de datos, en vez de tratar ejemplos correlacionados de una ejecución como ejecuciones independientes. El ejecutable suministrado solo comprueba probabilidades de canales finitos, invariantes del objetivo y el contraejemplo construido. No entrena SimCLR ni reproduce un banco de pruebas de ImageNet.
12. El contrato de la representación
Una afirmación convincente sobre aprendizaje contrastivo declara qué cuenta como positivo, cómo se extraen los negativos, dónde se lee la representación y qué decisiones debe sustentar. Estas cuatro declaraciones hacen que un resultado sea falsable. También permiten actuar ante el fallo: cambiar el proceso de vistas cuando se destruye información, el objetivo cuando se desincentiva sistemáticamente la información o el decodificador cuando la información retenida resulta inaccesible.
El ejemplo binario establece una imposibilidad de alcance limitado: la información ausente de la observación no puede recuperarse mediante un codificador determinista de esa observación. Los análisis geométricos y de temperatura establecen diagnósticos igualmente acotados. Juntos proporcionan una manera rigurosa de interpretar experimentos de transferencia sin convertir un objetivo auxiliar en una afirmación de comprensión general. Los trabajos futuros deberían comprobar si una representación preserva un conjunto de distinciones explícitamente nombradas ante cambios en la distribución de vistas. Esa es una pregunta de investigación más sólida y útil que preguntar si sus representaciones vectoriales simplemente parecen bien organizadas.
Ejecutado localmente · Alcance acotado
Información de vistas binarias, contraejemplo de perturbación e invariantes contrastivos
Enumeración de un canal binario finito y comprobaciones de pérdida con candidatos fijos; no se entrena ningún codificador contrastivo.
Se superaron 202 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testimonio registrado
{
  "q": 0.25,
  "pair_agreement": 0.625,
  "bayes_accuracy": 0.75,
  "q_half_label_accuracy": 0.5,
  "nuisance_alignment": 1,
  "negative_counts": [
    3,
    15,
    63
  ]
}
Ejecutor del ejemplo · Cargador del modelo · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Pérdida finita de candidatos con un positivo, K negativos, similitudes de valor real y temperatura tau > 0.
(2) La derivada es válida con similitudes de candidatos fijas. El caso especial de la derecha genera el panel 2; no es una trayectoria de entrenamiento.
(3) Y es un bit equiprobable; cada V invierte Y de forma independiente con probabilidad q en [0,1/2]. La exactitud se refiere a una sola vista.
(4) La información mutua se expresa en bits para el canal binario simétrico declarado, definiendo 0 log 0 como cero.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Diagnóstico | Qué puede establecer | Qué queda sin comprobar |
|---|---|---|
| Alineación positiva | Concordancia bajo la ley de vistas especificada | Preservación de distinciones pertinentes para la tarea |
| Uniformidad | Cobertura bajo una geometría y una distribución marginal elegidas | Identidad semántica de la información codificada |
| Sonda lineal | Accesibilidad para el sistema de aprendizaje lineal especificado | Disponibilidad para procedimientos posteriores arbitrarios |
| Pérdida contrastiva finita | Discriminación de candidatos bajo el muestreador | Transferencia universal o ausencia de falsos negativos |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ningún banco de pruebas de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Enumerar el canal de dos bits y registrar qué variables preserva cada aumento.
- Preespecificar las tareas posteriores, las contratareas y las capas de conexión de las sondas antes del ajuste.
- Variar la temperatura y la cantidad de negativos por separado de la probabilidad de colisión semántica.
- Equiparar la exposición a los datos de entrenamiento y ajustar simétricamente los presupuestos de optimización.
- Informar conjuntamente de la alineación, la geometría marginal, el riesgo posterior y la incertidumbre entre semillas independientes.
- Publicar el código de generación de vistas y ejemplos en los que la invariancia destruye información útil.
Qué establecen las fuentes primarias
Ting Chen, Simon Kornblith, Mohammad Norouzi et al. · 2020 [1]
Contribución. En SimCLR se evalúan las decisiones sobre aumento, cabeza de proyección y escala de entrenamiento.
Límite. Las comparaciones publicadas se refieren a las condiciones de entrenamiento y evaluación del artículo.
Localización en la fuente. Resumen y secciones sobre el marco y los estudios de ablación.
Tongzhou Wang, Phillip Isola · 2020 [2]
Contribución. La alineación y la uniformidad proporcionan una geometría de representaciones normalizadas y un análisis asintótico.
Límite. Los supuestos no implican suficiencia semántica independiente de la tarea.
Localización en la fuente. Resumen y definiciones de alineación y uniformidad.
Aaron van den Oord, Yazhe Li, Oriol Vinyals · 2018 [3]
Contribución. CPC conecta la predicción en el espacio latente con un objetivo de información basado en el muestreo de negativos.
Límite. Los supuestos de muestreo y la identidad de las variables aleatorias determinan la interpretación de la información.
Localización en la fuente. Sección 2 y discusión sobre la cota de información.
Límites de este análisis
- La construcción binaria es un contraejemplo finito sobre información, no una distribución de imágenes realista.
- Las curvas de pérdida de candidatos mantienen fijas las similitudes y no pueden predecir la exactitud de una red entrenada.
- Tres fuentes fundacionales no constituyen una revisión sistemática de todos los métodos contrastivos.
- No se realizó entrenamiento neuronal, replicación de bancos de pruebas ni revisión por pares independiente.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso y versión de las fuentes se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Puede una política de aumento preservar un conjunto declarado de distinciones para tareas posteriores sin etiquetas para cada tarea?
- ¿Cómo deberían estimarse las tasas de falsos negativos cuando las categorías se solapan en vez de particionar los datos?
- ¿Qué diagnósticos por capa predicen la accesibilidad bajo un presupuesto fijo de cómputo posterior?
Referencias
- Ting Chen, Simon Kornblith, Mohammad Norouzi et al.. A Simple Framework for Contrastive Learning of Visual Representations. Proceedings of the 37th International Conference on Machine Learning (2020). Primary source.
- Tongzhou Wang, Phillip Isola. Understanding Contrastive Representation Learning through Alignment and Uniformity on the Hypersphere. Proceedings of the 37th International Conference on Machine Learning (2020). Primary source.
- Aaron van den Oord, Yazhe Li, Oriol Vinyals. Representation Learning with Contrastive Predictive Coding. arXiv (2018). 10.48550/arXiv.1807.03748.
Acceso a la fuente [1]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Acceso a la fuente [2]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Acceso a la fuente [3]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota de versión. Publicado inicialmente en 2018; el PDF consultado es arXiv v2, fechado el 22 de enero de 2019. Esta entrada cita la prepublicación, sin afirmar que sea una publicación de congreso.
Las identidades bibliográficas se contrastaron con registros primarios de editoriales y autores. Las notas de acceso y versión de las fuentes que aparecen a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se suministran Python y CSV. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.