
Resumen
La reconstrucción enmascarada es una forma potente de extraer una señal de entrenamiento de observaciones sin etiquetar, pero su criterio de éxito debe interpretarse con cuidado. Esta revisión conecta los autocodificadores de eliminación de ruido, los autocodificadores enmascarados y el modelado de imágenes mediante tokens discretos con dos construcciones exactas. Un problema gaussiano de predicción condicional separa el bajo error de reconstrucción de la información sobre la tarea. Un problema de enmascaramiento de bits repetidos cuantifica cuándo deja de estar disponible una característica semántica que, de otro modo, sería perfectamente informativa. El análisis distingue la calidad del codificador de la capacidad del decodificador, la representación del objetivo de la representación de la entrada, y la reducción del cómputo de la preservación de información. Propone pruebas controladas que manipulan de manera independiente la geometría de las máscaras, la predictibilidad de factores ajenos a la tarea y la redundancia semántica. Las figuras técnicas representan las distribuciones analíticas declaradas, no resultados nuevos de MAE o BEiT. La afirmación resultante es condicional: la reconstrucción constituye evidencia de que un modelo predice el objetivo seleccionado a partir de su contexto visible; se requieren experimentos adicionales para establecer qué implica esa capacidad para una decisión posterior.
1. Una tarea de predicción con varias decisiones ocultas
Reconstruir una imagen parece una sola tarea, pero su significado depende de varias decisiones. ¿Qué coordenadas se ocultan? ¿El objetivo es la intensidad bruta, la intensidad normalizada, un token discreto o una representación de un modelo docente? ¿El decodificador ve únicamente la salida del codificador, o también información espacial y sobre el enmascaramiento? ¿Qué errores son costosos? Cada decisión cambia el predictor óptimo y, por tanto, lo que una pérdida baja permite establecer.
El objeto de análisis útil es un problema de predicción condicional: inferir un objetivo ausente a partir de la información explícitamente disponible para el predictor. Esta formulación hace visibles la fuga de información, la incertidumbre irreducible y los atajos basados en factores ajenos a la tarea. También evita una inferencia injustificada de reconstrucciones visualmente plausibles a comprensión semántica. Un modelo puede recuperar una textura ausente porque los píxeles próximos comparten estadísticas locales y, aun así, ser incapaz de responder una pregunta sobre el objeto. A la inversa, una representación útil para la clasificación no tiene por qué preservar la intensidad precisa de cada píxel.
2. La eliminación de ruido como antecedente esclarecedor
Vincent y sus colegas entrenan autocodificadores de eliminación de ruido para recuperar una entrada intacta a partir de una versión corrompida y utilizan las representaciones resultantes en arquitecturas profundas. La fuente establece la corrupción y recuperación como principio de aprendizaje de representaciones y lo evalúa en las pruebas de referencia de clasificación del artículo. No afirma que todos los procesos de corrupción produzcan la misma representación ni que la reconstrucción por sí sola demuestre adecuación semántica.
La herencia conceptual pertinente es que ocultar información deliberadamente puede impedir una solución trivial de identidad. Que impida todos los atajos depende de la distribución de corrupción y de la arquitectura. Los ejemplos gaussianos y de enmascaramiento desarrollados aquí son construcciones analíticas independientes, no reproducciones de los experimentos, conjuntos de datos o implementaciones de redes de aquel artículo. [1]
3. Qué cambia el diseño del autocodificador enmascarado
He y sus colegas introducen un autocodificador enmascarado asimétrico en el que el codificador procesa los parches visibles de la imagen y un decodificador ligero reconstruye los píxeles, con los tokens de máscara introducidos en el decodificador. Su estudio demuestra la eficacia de un enmascaramiento considerable dentro de la configuración de preentrenamiento visual evaluada.
Para esta revisión, la separación arquitectónica importante es que retirar los tokens enmascarados del codificador cambia su carga computacional, mientras que reconstruirlos define el objetivo de aprendizaje. Son efectos relacionados, pero distintos. La proporción de enmascaramiento del artículo es una elección empírica de diseño, no un óptimo universal para cualquier distribución de imágenes o tarea posterior. El cálculo del número de tokens que aparece más adelante aísla deliberadamente un término de la atención; no reproduce las aceleraciones medidas en el artículo. [2]
4. Un objetivo puede contener un segundo modelo
BEiT predice tokens visuales discretos a partir de parches de imagen corrompidos. Bao y sus colegas convierten así la representación del objetivo en un componente explícito del preentrenamiento, en lugar de exigir la predicción de píxeles brutos. La fuente inspeccionada es la prepublicación revisada de los autores, y la bibliografía registra esa versión.
Este diseño cambia la tarea estadística: un tokenizador determina qué variaciones comparten un objetivo y qué diferencias siguen siendo distinguibles. Un modelo estudiante exitoso puede heredar abstracciones útiles de esa construcción del objetivo, pero también puede heredar sus omisiones. El mismo problema surgiría con una representación continua de un modelo docente. El análisis de este artículo trata sobre información y diseño de objetivos; no se replica ninguna receta de entrenamiento ni puntuación de referencia de BEiT. Tratar la predicción de tokens y la reconstrucción de píxeles como pérdidas equivalentes ocultaría una intervención experimental central. [3]
5. Qué identifica realmente el error cuadrático de reconstrucción
Para un objetivo escalar ausente X y un contexto visible V, el predictor óptimo bajo error cuadrático es la media condicional de X dado V. El riesgo se descompone en la varianza condicional más la desviación cuadrática respecto de esa media. Esta identidad elemental distingue la incertidumbre que ningún predictor puede eliminar del error causado por el modelo elegido.
Si dos compleciones igualmente plausibles tienen intensidades opuestas, la media condicional puede situarse entre ellas y no parecerse a ninguna. Por tanto, una reconstrucción suave puede ser una solución apropiada bajo error cuadrático, en lugar de indicar un optimizador deficiente. A la inversa, una compleción nítida seleccionada por otro objetivo puede resultar convincente y, aun así, ser incorrecta para el objetivo realizado. La evaluación correcta responde a la decisión prevista: intensidad esperada, distribución calibrada, una compleción plausible o preservación de una variable posterior. Comparar estos objetivos con un único juicio visual genera una ambigüedad que una mayor capacidad del modelo no puede resolver. El programa complementario finito comprueba la descomposición algebraica del exceso de riesgo para varias correlaciones y predictores lineales deliberadamente mal especificados.
6. Un atajo gaussiano exacto
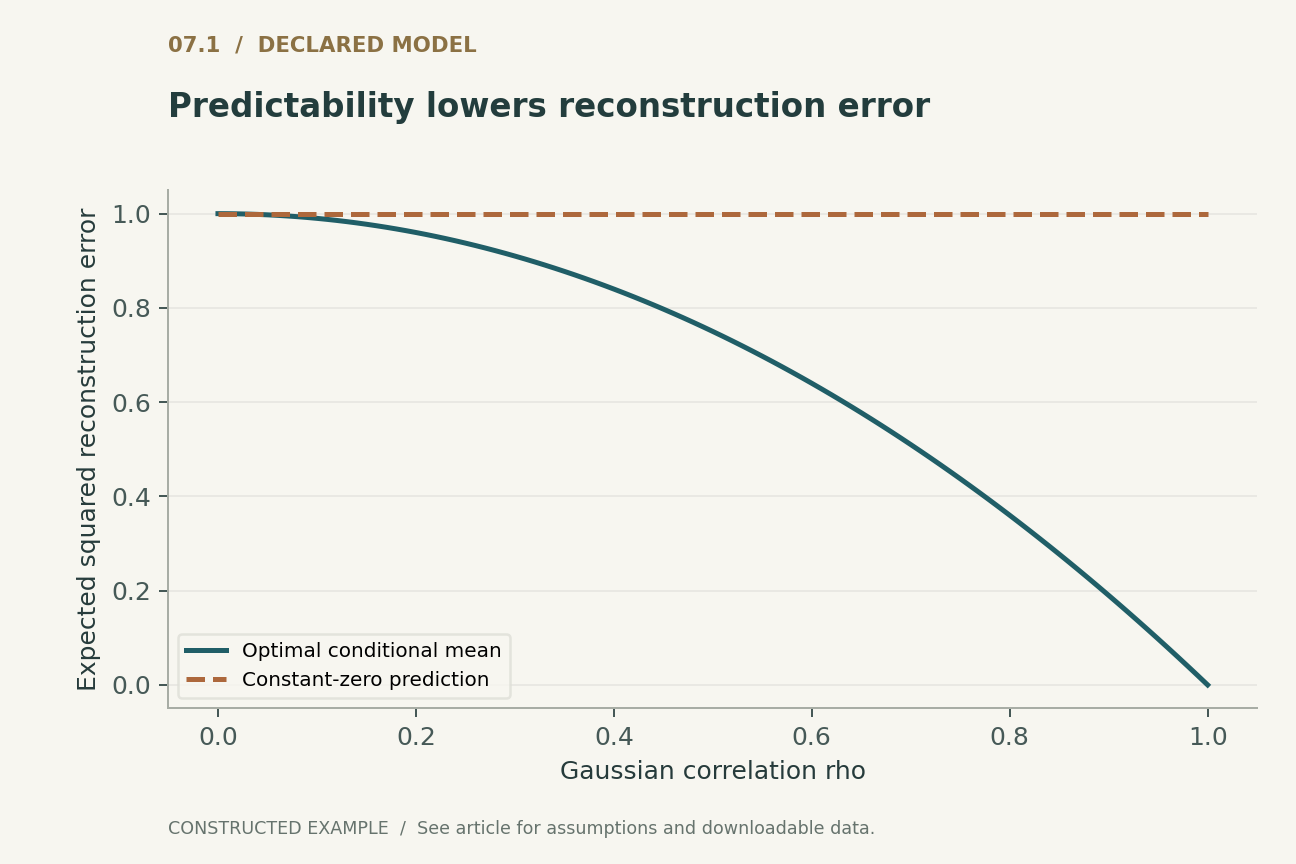
Sean X y V conjuntamente gaussianos, con media cero, varianza unitaria y correlación rho. La predicción condicional de X a partir de V es rho por V, con error cuadrático medio igual a uno menos rho al cuadrado. El panel 1 representa este error irreducible y lo compara con un predictor constante cuyo error se mantiene en uno. A medida que la correlación se aproxima a uno, el problema de reconstrucción se vuelve fácil.
Añádase ahora al estado no observado un bit semántico independiente y equiprobable Y, asegurando que ni X ni V dependan de Y. La predicción perfecta de X no proporciona información sobre Y. Este es un contraejemplo deliberadamente estricto, no un modelo de toda la semántica visual: refuta la implicación universal de la calidad de reconstrucción a la información sobre la tarea. Para afirmar que existe transferencia semántica, debe demostrarse una dependencia real entre la señal de entrenamiento y el objetivo, o medirse directamente la decisión posterior. Sustituir un bit independiente por uno débilmente correlacionado vuelve cuantitativa la conclusión, sin eliminar la distinción.
7. El enmascaramiento puede borrar la única evidencia útil
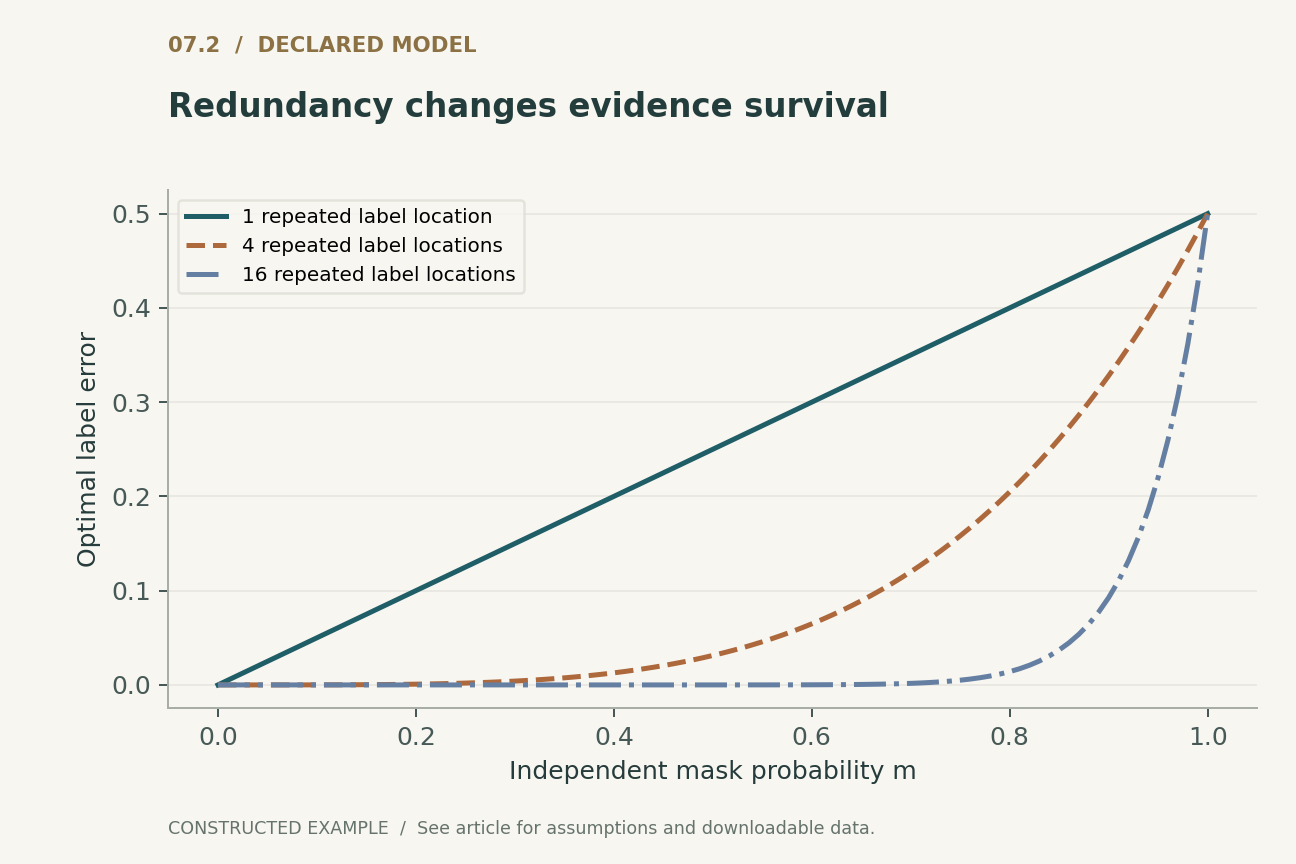
Considérese otra construcción en la que un bit de etiqueta equiprobable se copia en r posiciones observables distintas. Cada posición se enmascara de manera independiente con probabilidad m. Si al menos una copia permanece visible, la etiqueta puede decodificarse perfectamente. Si desaparecen todas las copias, la observación visible no contiene información sobre la etiqueta y la clasificación óptima debe adivinar. Al promediar estos casos se obtiene un error de Bayes igual a la mitad de m elevada a r.
El panel 2 compara una, cuatro y dieciséis copias. Estas curvas cuantifican la redundancia bajo enmascaramiento independiente, no el comportamiento de ningún modelo de visión entrenado. Con una probabilidad de enmascaramiento de un medio, cuatro copias reducen el error inevitable a un treintaidosavo. Con una copia, es de un cuarto. Por tanto, la misma fracción global de enmascaramiento puede inducir supervisiones radicalmente diferentes según cómo se distribuya la información sobre la tarea. Las proporciones de enmascaramiento deben discutirse junto con la redundancia semántica y la organización espacial, y no tratarse como constantes transferibles que garantizan una tarea de aprendizaje de dificultad adecuada.
8. Las máscaras correlacionadas cambian el cálculo
La fórmula del bit repetido depende de un enmascaramiento independiente. Si todas las copias están dentro de una región eliminada por una máscara de bloque, sus pérdidas pueden estar perfectamente correlacionadas: la probabilidad de perder todas las copias puede ser igual a la probabilidad de eliminar la región, en lugar de su potencia de exponente r. Una gran ventaja numérica de la redundancia desaparece cuando la máscara acopla las posiciones redundantes.
Esta observación sugiere una comparación controlada entre máscaras de parches independientes y máscaras espacialmente contiguas, igualando el área visible esperada. Igualar solo el recuento medio es insuficiente; la distribución conjunta de visibilidad cambia qué relaciones son observables. El mismo problema aparece cuando la evidencia importante se encuentra cerca de un límite de recorte o dentro de un motivo visual repetido. Una evaluación útil registra la distribución de la evidencia visible sobre la tarea, idealmente mediante un diagnóstico sintético con factores causales conocidos antes de interpretar un conjunto de datos real. La comparación propuesta no presupone que una familia de máscaras vaya a ganar; identifica el mecanismo que debe medirse para explicar un resultado.
9. El ahorro de cómputo exige declarar el denominador
Si un codificador procesa N tokens y retiene una fracción determinista de uno menos m, el número de puntuaciones de atención por pares pasa de N al cuadrado a N al cuadrado multiplicado por el cuadrado de la cantidad uno menos m. Esta es una comparación del número de operaciones para ese término, suponiendo divisibilidad y una atención idéntica en todo lo demás. No es una predicción de la velocidad de ejecución medida según el tiempo transcurrido.
Las capas de proyección, los bloques de propagación hacia delante, el decodificador, el movimiento de datos, el trabajo del optimizador y el relleno pueden escalar de forma diferente. Si las máscaras se muestrean de manera independiente y el número de elementos visibles es aleatorio, la esperanza de su cuadrado también incluye un término de varianza. Una afirmación sobre cómputo debe indicar si utiliza un número fijo de elementos visibles, una aproximación mediante el recuento esperado o una traza de ejecución real. En este artículo, la expresión de atención se limita deliberadamente a un experimento mental de recuento fijo, mientras que el cálculo de información del bit repetido utiliza enmascaramiento de Bernoulli independiente. Son modelos distintos. Mantener explícitos sus supuestos impide que una expresión algebraica conveniente se convierta en una afirmación engañosa sobre sistemas.
10. La potencia del decodificador puede desplazar la carga
Un decodificador potente puede explotar la regularidad espacial o una distribución previa aprendida incluso cuando el codificador solo expone información gruesa. Un decodificador débil puede obligar al codificador a hacer accesibles distinciones útiles, pero también puede limitar la reconstrucción sin mejorar la transferencia. El tamaño de la arquitectura, por sí solo, no garantiza ninguna de las dos direcciones.
Un diagnóstico debe variar la capacidad del decodificador manteniendo fijos el codificador, la información visible y el presupuesto de entrenamiento. Después debe medir las tareas posteriores mediante un mecanismo de lectura explícitamente especificado. Si mejora la reconstrucción mientras la transferencia se estanca, la mejora puede corresponder al decodificador o al modelado del objetivo, en lugar de a una representación ampliamente mejor. Si mejora la transferencia mientras empeora el error de píxeles, la métrica del objetivo puede estar destacando detalles ajenos al objetivo posterior. Estos resultados no son contradicciones. Revelan que las dos mediciones se refieren a cómputos distintos. Un experimento que descarta el decodificador después del preentrenamiento debe evaluar directamente el codificador conservado, en lugar de presentar la calidad del sistema conjunto descartado como su resultado final.
11. Una auditoría semántica controlada
Una auditoría propuesta debe introducir controles independientes de la predictibilidad de la textura local y de la estructura global relevante para la tarea. La construcción gaussiana comprueba exactamente el primer principio; la del bit repetido comprueba exactamente la pérdida de evidencia. Un conjunto de datos sintético mayor podría combinar fondos texturizados con objetos cuyas etiquetas dependan de relaciones entre partes separadas, permitiendo manipular de forma independiente la geometría de las máscaras y la pérdida del objetivo.
La evaluación con imágenes reales debe probar después tareas elegidas antes de inspeccionar los resultados de los modelos. El error de reconstrucción, la calibración de las predicciones del contenido ausente y el riesgo posterior deben comunicarse por separado. Un modelo de sondeo debe declarar sus datos de entrenamiento y su capacidad; el ajuste fino completo es una intervención distinta del uso de una representación congelada. Las ejecuciones repetidas de entrenamiento deben ser la unidad para evaluar la incertidumbre de optimización. Los ejemplos ejecutables proporcionados no realizan entrenamiento neuronal y no pueden establecer con qué frecuencia aparece un atajo concreto en la práctica. Su propósito es hacer falsables los mecanismos propuestos y poner de manifiesto qué mediciones adicionales serían necesarias.
12. Una afirmación defendible sobre la reconstrucción
La reconstrucción adquiere valor científico cuando el objetivo, el proceso de visibilidad, el acceso del decodificador y la pérdida se especifican conjuntamente. La afirmación resultante puede ser sólida: el sistema predice con precisión un objetivo condicional definido, o aprende una representación que se transfiere a decisiones declaradas bajo un protocolo especificado. La afirmación se debilita cuando un objetivo sustituto se rebautiza silenciosamente como comprensión.
Los ejemplos desarrollados muestran dos límites. Una predicción condicional fácil puede coexistir con la ausencia total de una variable semántica, y un enmascaramiento agresivo puede eliminar toda la evidencia necesaria para una decisión. Ninguno de estos límites invalida el preentrenamiento enmascarado. Explican por qué su éxito empírico exige una interpretación cuidadosa y por qué sigue siendo necesaria la evaluación de transferencia. Un siguiente paso productivo sería informar auditorías de preservación de información junto con las curvas de reconstrucción, especialmente en tareas cuyas características decisivas ocupan regiones pequeñas o inusuales. Esto convertiría la selección de máscaras, de una receta heredada, en un supuesto medible sobre lo que la representación debe retener.
Ejecutado localmente · Alcance acotado
Riesgo condicional gaussiano y enumeración exhaustiva de máscaras de etiqueta
Álgebra de segundos momentos y máscaras exhaustivas para hasta ocho bits repetidos; no se entrena ningún modelo de reconstrucción de imágenes.
1191 aserciones superadas. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testimonio registrado
{
  "gaussian_rho": 0.6,
  "optimal_mse": 0.64,
  "copies": 4,
  "mask_probability": 0.5,
  "label_error": 0.03125,
  "enumerated_copy_counts": [
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ]
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Descomposición del riesgo para un escalar X de cuadrado integrable y un predictor medible g con riesgo finito.
(2) Ejemplo gaussiano conjunto para |rho| <= 1; los extremos se entienden como límites gaussianos degenerados.
(3) Etiqueta equiprobable repetida en r posiciones visibles, enmascaradas de forma independiente con probabilidad m; no hay otra evidencia sobre la etiqueta.
(4) Número fijo de tokens visibles, no enmascaramiento de Bernoulli; solo compara recuentos de pares de puntuaciones de atención densa, excluyendo el decodificador y otros trabajos.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Elección | Qué cambia directamente | Medición separada necesaria |
|---|---|---|
| Error cuadrático de píxeles | Objetivo de media condicional | Transferencia semántica e incertidumbre |
| Predicción de tokens discretos | Distinciones definidas por el tokenizador | Omisiones del objetivo y procedencia del tokenizador |
| Máscaras de parches independientes | Distribución conjunta de visibilidad | Supervivencia de la evidencia y correlaciones entre máscaras |
| Solo tokens visibles en el codificador | Número de operaciones del codificador | Latencia de extremo a extremo y calidad de la representación conservada |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Especificar los objetivos ausentes, las entradas del decodificador, la distribución de máscaras y las etiquetas posteriores.
- Verificar de forma independiente las identidades de riesgo condicional gaussiano y los errores de Bayes del bit repetido.
- Igualar el área visible esperada al variar entre enmascaramiento independiente y contiguo.
- Manipular la predictibilidad de factores ajenos a la tarea por separado de la redundancia semántica.
- Variar la capacidad del decodificador y evaluar el codificador congelado con modelos de sondeo preespecificados.
- Informar la reconstrucción, la transferencia, la contabilidad del cómputo y la incertidumbre como resultados distintos.
Qué establecen las fuentes primarias
Pascal Vincent, Hugo Larochelle, Yoshua Bengio et al. · 2008 [1]
Contribución. La reconstrucción a partir de entradas corrompidas se utiliza para aprender representaciones e inicializar arquitecturas profundas.
Límite. Sus experimentos no establecen la utilidad universal de corrupciones arbitrarias.
Localización en la fuente. Secciones sobre el principio de entrenamiento y los experimentos.
Kaiming He, Xinlei Chen, Saining Xie et al. · 2022 [2]
Contribución. MAE separa un codificador de parches visibles de un decodificador de reconstrucción.
Límite. Las proporciones de enmascaramiento y la eficiencia medida son específicas de la configuración evaluada.
Localización en la fuente. Resumen y descripción de la arquitectura.
Hangbo Bao, Li Dong, Songhao Piao et al. · 2021 [3]
Contribución. BEiT predice objetivos visuales discretos a partir de parches de imagen corrompidos.
Límite. El tokenizador del objetivo forma parte del método; esta revisión inspecciona la prepublicación revisada.
Localización en la fuente. Resumen y descripción del modelado de imágenes enmascaradas.
Límites de este análisis
- Los modelos exactos aíslan límites lógicos, no estadísticas realistas de imágenes.
- El error cuadrático es solo uno de los objetivos de reconstrucción; las pérdidas perceptuales y de verosimilitud requieren análisis separados.
- No se reprodujo ninguna prueba de referencia de MAE, BEiT ni de autocodificadores de eliminación de ruido.
- Las etiquetas semánticas y su relevancia siguen siendo definiciones de la tarea, no cantidades identificadas por una pérdida de reconstrucción sin etiquetas.
Una revisión analítica focalizada de tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Pueden seleccionarse políticas de enmascaramiento a partir de un criterio medible de supervivencia de la evidencia para varias tareas posteriores?
- ¿Cuánta transferencia útil procede del codificador frente a la estructura aportada por el objetivo de reconstrucción?
- ¿Qué evaluaciones distinguen la incertidumbre calibrada sobre el contenido ausente de las compleciones meramente plausibles?
Referencias
- Pascal Vincent, Hugo Larochelle, Yoshua Bengio et al.. Extracting and Composing Robust Features with Denoising Autoencoders. Proceedings of the 25th International Conference on Machine Learning (2008). 10.1145/1390156.1390294.
- Kaiming He, Xinlei Chen, Saining Xie et al.. Masked Autoencoders Are Scalable Vision Learners. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (2022). Primary source.
- Hangbo Bao, Li Dong, Songhao Piao et al.. BEiT: BERT Pre-Training of Image Transformers. arXiv (2021). 10.48550/arXiv.2106.08254.
Acceso a la fuente [1]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota sobre la versión. Se inspeccionó el PDF alojado por el autor en Toronto; el espejo de Montreal denegó el acceso automatizado.
Acceso a la fuente [2]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Acceso a la fuente [3]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota sobre la versión. Esta bibliografía cita el identificador de la prepublicación de 2021. El PDF y la página de acceso inspeccionados corresponden a la revisión v2, fechada el 3 de septiembre de 2022; no se presupone identidad con una versión de congreso.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas sobre acceso a las fuentes y versiones que aparecen a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni reproducciones de pruebas de referencia de rendimiento.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.