
Resumen
A veces se describe a los transformadores de visión como arquitecturas sin sesgo inductivo. Esta revisión sustituye esa descripción por un inventario explícito de dónde se introducen las restricciones: proyección de parches, codificación de posición, conectividad de la atención, jerarquía y supervisión del profesor. ViT, DeiT y Swin proporcionan tres referentes arquitectónicos principales. El artículo desarrolla una prueba de rango y nulidad para la compresión irreversible de parches, una identidad de equivariancia ante permutaciones para la atención basada únicamente en el contenido y una comparación transparente del número de operaciones entre la atención global y la atención con ventanas fijas. Estas construcciones separan la posibilidad representacional, la preferencia estadística y el coste de ejecución. Los experimentos propuestos distinguen los cambios en la arquitectura de los cambios en los datos de entrenamiento y la supervisión. Las figuras son recuentos analíticos y ejemplos de álgebra lineal, no mediciones de hardware ni evaluaciones de referencia de clasificación de imágenes replicadas. La conclusión central es que una comparación defendible debe especificar la información y las simetrías que cada proceso conserva, descarta o aprende de los datos, en lugar de tratar la atención como la ausencia de estructura previa.
1. El sesgo es una propiedad de todo el proceso
Un sesgo inductivo es una preferencia entre posibles relaciones de entrada y salida que surge de la arquitectura, los datos, la optimización o la supervisión. Una red que procesa una cuadrícula fija de parches ya adopta una representación de la imagen. Un modelo entrenado con aumentos espaciales de datos adquiere preferencias adicionales aunque su capa de atención sea algebraicamente flexible. Un profesor preentrenado puede aportar aún más estructura.
Por tanto, la pregunta científica pertinente no es si un transformador de visión tiene sesgo, sino dónde se implementa un sesgo concreto y cómo afecta a la tarea prevista. Las restricciones estructurales pueden facilitar el aprendizaje de una regla útil o excluir una distinción que la tarea necesita. Las preferencias derivadas de los datos pueden adaptarse a una distribución de entrenamiento rica o heredar una regularidad espuria. Este artículo separa tres cuestiones que suelen confundirse: qué funciones son representables, cuáles favorece el aprendizaje y cuánto cuesta calcularlas.
2. ViT como referente arquitectónico
Dosovitskiy y sus colegas aplican un transformador a una secuencia de parches de imagen incrustados linealmente, con incrustaciones de posición y una configuración de clasificación. Su artículo evalúa el preentrenamiento a gran escala y la transferencia, y demuestra que este diseño puede ofrecer un rendimiento sólido en las condiciones descritas. No demuestra que la estructura de la imagen haya desaparecido del proceso ni que la escala de los datos de entrenamiento sea irrelevante.
La construcción examinada aquí es la interfaz de parche a token. Una vez que un parche se ha convertido en su incrustación, todo el cálculo posterior depende de la información conservada en esa interfaz. El cálculo del rango que se presenta más adelante es un diagnóstico independiente de este paso mediante álgebra lineal. No supone afirmar que las configuraciones reales de ViT de la fuente compriman necesariamente los parches por debajo de su dimensión. [1]
3. DeiT cambia el planteamiento de la supervisión
Touvron y sus colegas estudian el entrenamiento de transformadores eficiente en el uso de datos e introducen un token de destilación mediante el cual un alumno aprende de un profesor. El registro de la editorial original describe un entrenamiento competitivo que utiliza ImageNet y una estrategia de profesor y alumno específica de la arquitectura.
La distinción pertinente es que la forma arquitectónica de un alumno no describe por completo su supervisión. Un profesor convolucional puede influir en un transformador mediante sus objetivos sin incorporar capas convolucionales al alumno desplegado. Esto no hace ilegítima la destilación; significa que una comparación sobre el sesgo inductivo debe tener en cuenta al profesor y su historial de entrenamiento. Esta revisión no reproduce la receta de optimización ni los resultados numéricos de referencia de la fuente. Utiliza el diseño de profesor y alumno como un motivo concreto para rastrear fuentes de conocimiento más allá del grafo del alumno. [2]
4. Swin hace explícita la localidad
Liu y sus colegas organizan la atención dentro de ventanas locales, desplazan la partición en ventanas entre bloques y utilizan una jerarquía que modifica la resolución espacial. La prepublicación de los autores explica cómo esto permite la comunicación entre ventanas mientras controla el coste de la atención. Su afirmación sobre el escalado computacional supone un tamaño de ventana fijo cuando aumenta la resolución de la imagen.
Por tanto, la localidad no se ha eliminado; se ha incorporado al diseño del patrón de comunicación. Una partición desplazada puede conectar regiones que estaban separadas en un bloque anterior, pero no convierte un bloque en equivalente a una atención global sin restricciones. Los recuentos de operaciones de este artículo aíslan los pares candidatos de consulta y clave. No reproducen las cifras de referencia de la fuente ni estiman la latencia real del acelerador. La distinción entre conectividad y tiempo efectivo de ejecución es esencial para interpretar las curvas resultantes. [3]
5. La proyección de parches tiene un límite informativo preciso
Se aplana un parche de P por P píxeles con C canales en D coordenadas, donde D es igual al cuadrado de P multiplicado por C. Una incrustación lineal de anchura d transforma esas coordenadas mediante una matriz. Si d es menor que D, el teorema de rango y nulidad garantiza un núcleo no trivial incluso cuando la matriz tiene rango máximo. Dos parches cuya diferencia es un vector del núcleo producen el mismo token.
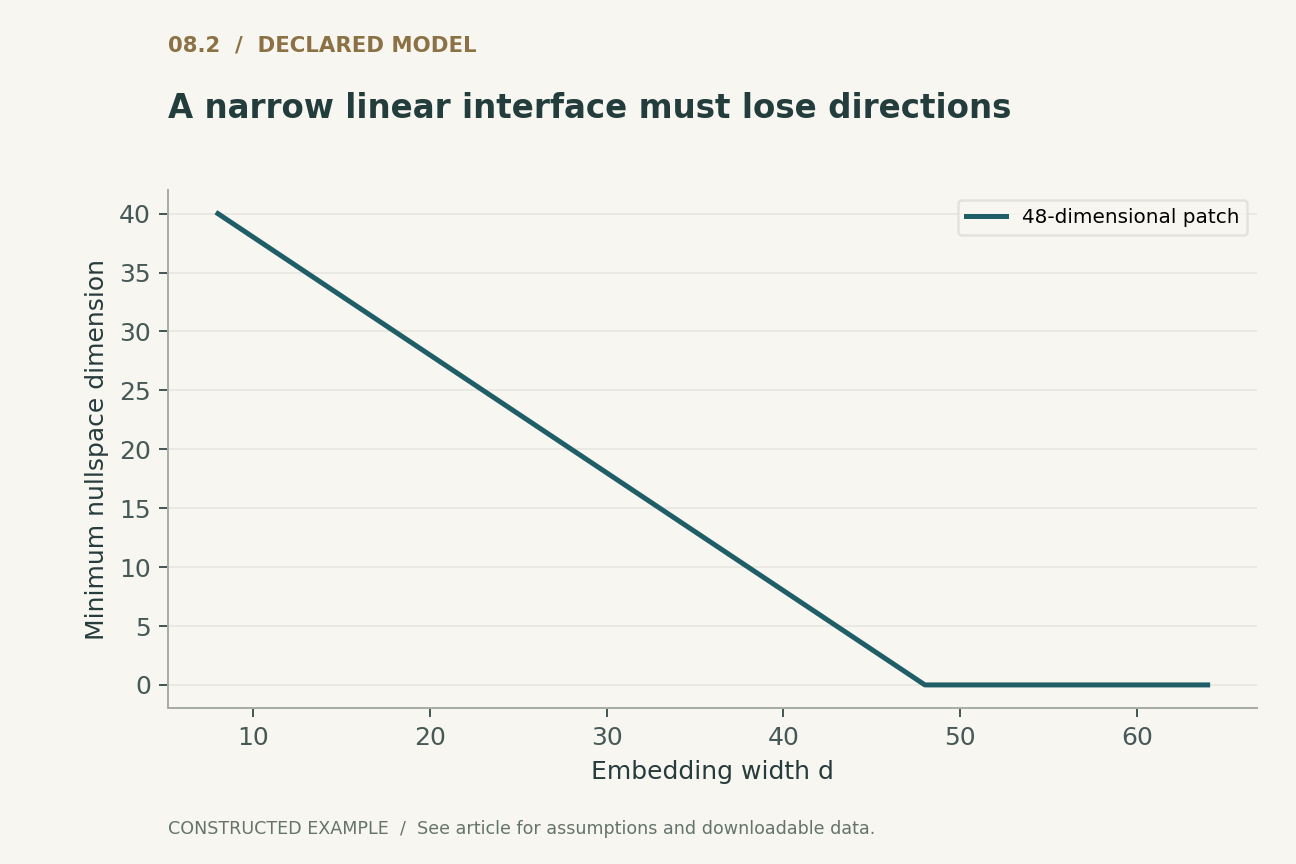
Ninguna red determinista posterior puede distinguir esos dos parches únicamente a partir de ese token. Se trata de una imposibilidad de la interfaz, no del entrenamiento de la atención. No implica que las direcciones perdidas sean relevantes para un conjunto de datos dado, ni que todas las incrustaciones prácticas de parches sean compresivas. El panel 2 muestra la dimensión mínima del núcleo para un parche declarado de dimensión 48 a medida que varía la anchura. El ejemplo ejecutable construye directamente una colisión y comprueba que las incrustaciones son idénticas. Un estudio arquitectónico riguroso debería preguntar si la variación eliminada por la proyección es irrelevante para las etiquetas previstas o contiene características infrecuentes pero decisivas.
6. El tamaño del parche equilibra los recuentos y la granularidad
Para una imagen cuadrada de lado H divisible por el lado P del parche, el número de parches es el cuadrado del cociente entre H y P. Aumentar el tamaño del parche modifica, por tanto, tanto el número de tokens como la dimensionalidad bruta de cada parche. Estos efectos no deben describirse como un único control de eficiencia.
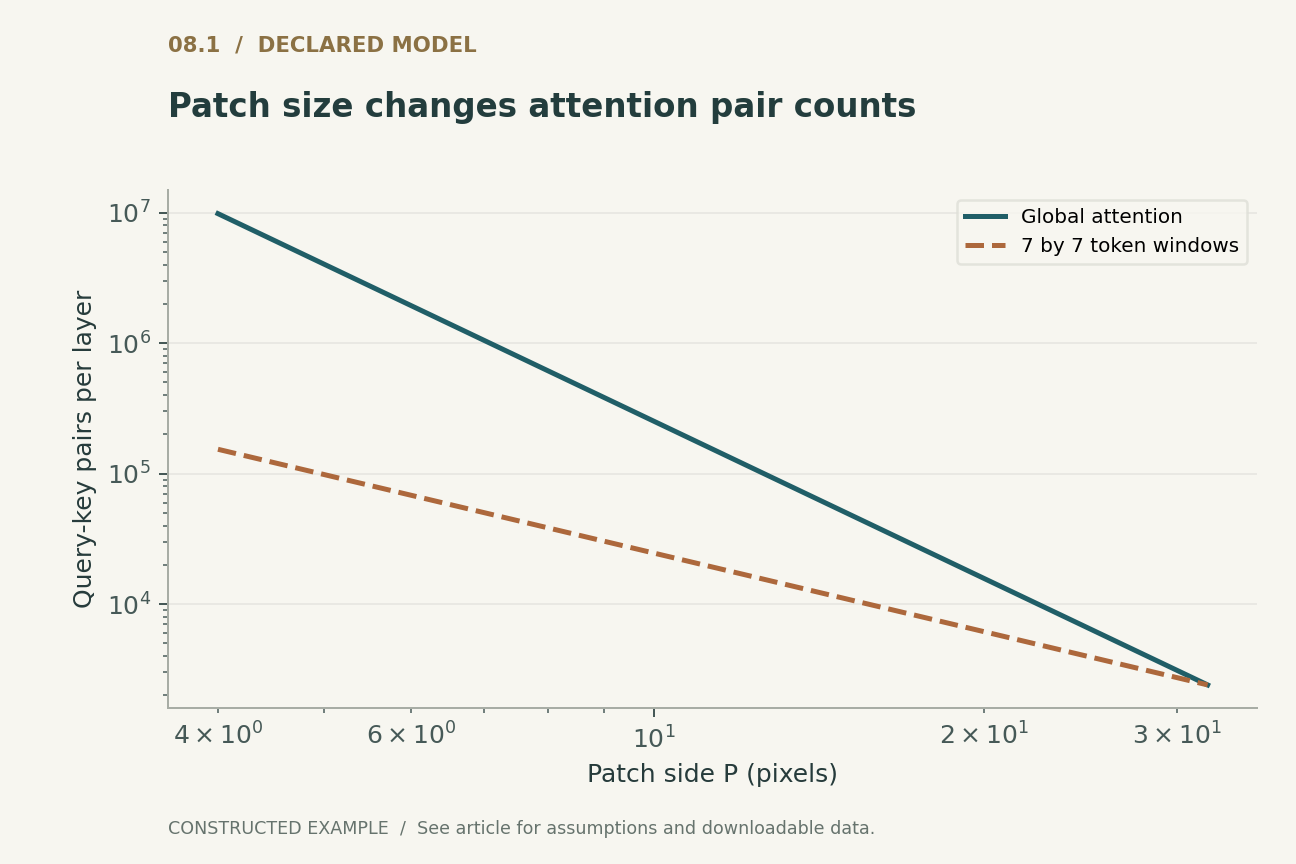
Con H igual a 224, el panel 1 compara los recuentos de pares para parches de cuatro, ocho, dieciséis y treinta y dos píxeles de lado. El término de atención global utiliza todos los pares de tokens. La comparación con ventanas utiliza como máximo cuarenta y nueve claves por consulta e iguala a la atención global cuando toda la cuadrícula de siete por siete tokens cabe en una sola ventana. Son recuentos exactos de candidatos bajo la partición especificada, excluidos los tokens de clase, el relleno y otras capas. Una cuadrícula de parches más gruesa reduce el número de puntuaciones de atención, pero puede trasladar a la incrustación la responsabilidad de conservar los detalles finos. Que esos detalles sobrevivan depende de la anchura de la proyección y de los pesos aprendidos, no únicamente del número de tokens.
7. La atención basada únicamente en el contenido respeta las permutaciones de tokens
Sea una matriz de tokens permutada por una matriz de permutación. Si las consultas, las claves y los valores se calculan mediante aplicaciones lineales compartidas por filas y no hay ningún término dependiente de la posición, la salida de la atención se permuta de la misma manera. La softmax por filas respeta la permutación correspondiente de filas y columnas de la matriz de puntuaciones. La identidad puede comprobarse directamente con matrices pequeñas.
Esta equivariancia se refiere a reordenar tokens completos, no a traslaciones arbitrarias de píxeles ni a rotaciones de una imagen. Una permutación de parches modifica la disposición visual mientras conserva el multiconjunto de contenidos de los tokens. Una lectura invariante ante permutaciones de la atención basada únicamente en el contenido no puede distinguir disposiciones que solo difieran mediante una permutación de ese tipo. Las señales de posición espacial rompen intencionadamente esa simetría concreta y permiten al modelo utilizar la disposición. Calificar esta ruptura de simetría como un detalle de implementación pasa por alto su función. Determina qué distinciones puede expresar el modelo y cuáles deben proporcionarse mediante una convención externa de coordenadas.
8. Las señales de posición incorporan supuestos sobre las coordenadas
Las incrustaciones de posición absoluta asocian identificadores aprendidos a posiciones concretas. Los términos de posición relativa describen relaciones entre posiciones. Ambos proporcionan información espacial, pero no tienen por qué comportarse de la misma manera cuando cambia la resolución, se recorta una imagen o se desplaza el sistema de coordenadas.
Un experimento de cambio de resolución debe declarar cómo se interpolan o se transforman de otro modo los parámetros de posición. La operación puede introducir un comportamiento que no se aprendió directamente en las nuevas ubicaciones. Un experimento de traslación debe distinguir entre trasladar la escena subyacente y modificar su alineación con los parches: un pequeño desplazamiento de píxeles puede mover contenido a través de los límites de los parches aunque su identidad semántica no cambie. Las identidades exactas de permutación de tokens no implican equivariancia exacta ante esas operaciones sobre píxeles. El ejemplo finito complementario demuestra que una señal de posición absoluta sin permutar puede romper la equivariancia ante permutaciones basada únicamente en el contenido, mientras que permutar conjuntamente el contenido y la posición restaura la identidad algebraica. Es una comprobación matemática de la interfaz, no una afirmación de que una estrategia de posición sea universalmente preferible.
9. La profundidad de comunicación debe medirse explícitamente
Una capa de atención global permite que cada token pondere directamente todos los demás, aunque los pesos aprendidos aún pueden dificultar una comunicación útil. Una capa con ventanas restringe el conjunto de interacciones inmediatas posibles. Alternar las particiones amplía la alcanzabilidad a medida que aumenta la profundidad, y una jerarquía cambia el significado de un token al fusionar regiones.
La alcanzabilidad es una condición necesaria para algunos cálculos, no una prueba de que el cálculo se aprenda o sea estable. Un experimento puede distinguir estos conceptos creando tareas cuyas etiquetas requieran una relación conocida entre regiones distantes y variando la separación mientras mantiene fijas las estadísticas visuales locales. Debería informar del número de capas necesarias para que la información viaje bajo la máscara real, en lugar de basarse en el nombre de una arquitectura. Los tokens globales adicionales o las rutas entre ventanas deben incluirse en el grafo. Este diagnóstico comprobaría si un supuesto beneficio de largo alcance se deriva de la comunicación accesible o de otras diferencias en los datos y la optimización.
10. Una comparación justa tiene varios presupuestos
Igualar el número de parámetros no iguala el cómputo de entrenamiento, la exposición a los datos, la memoria de activaciones ni la supervisión del profesor. Igualar el tiempo transcurrido en un acelerador no iguala el número de actualizaciones de optimización. Comparar arquitecturas sin registrar estas distinciones puede convertir una ventaja de recursos en una explicación arquitectónica.
Una evaluación útil debería publicar, al menos, el número de parámetros del alumno, la exposición a tokens de imagen, las operaciones de entrenamiento según una convención de cómputo declarada, los pasos del optimizador y los profesores externos o los datos de preentrenamiento. Si el hardware forma parte de la afirmación, deben comunicarse el rendimiento efectivo de procesamiento y la memoria por separado de los recuentos analíticos. Deben utilizarse la misma partición de datos y la misma política de aumento al probar una intervención arquitectónica, salvo que el propósito sea explícitamente comparar procesos completos. Las comparaciones de procesos completos son valiosas, pero su interpretación es distinta: identifican qué conjunto funciona dentro de un margen de recursos, no qué mecanismo aislado causó la mejora. Esta distinción es especialmente importante cuando uno de los conjuntos ha heredado información mediante destilación.
11. Una escala de verificación para modelos visuales
La evaluación propuesta comienza con pruebas exactas de la interfaz: colisiones del núcleo, identidades de permutación de tokens y alcanzabilidad de las máscaras de atención. Estas pruebas son económicas y precisan las afirmaciones arquitectónicas. El siguiente nivel utiliza tareas visuales controladas con variables pertinentes e irrelevantes conocidas, lo que permite variar de manera independiente la alineación de los parches, la escala y la posición.
Solo entonces deberían utilizarse evaluaciones de referencia con imágenes naturales para valorar la relevancia práctica. Sus resultados deberían incluir subgrupos preespecificados, múltiples semillas de entrenamiento y una política clara de ajuste con datos de validación. Un error medio bajo puede coexistir con fallos en objetos pequeños o disposiciones espaciales inusuales. A la inversa, un fallo sintético puede referirse a una distinción ausente del ámbito de despliegue. Ambos hechos deben documentarse. El código complementario comprueba únicamente el álgebra finita y los recuentos de pares; no entrena un transformador, no perfila una GPU ni replica de manera independiente los tres sistemas citados. Los límites de cada nivel de evidencia permanecen separados.
12. De los eslóganes a las afirmaciones arquitectónicas
La mejor manera de describir una arquitectura de visión es mediante la información que conserva, las transformaciones que respeta y la comunicación que permite con un coste dado. La proyección de parches, las señales de posición, la estructura de ventanas y los objetivos del profesor contribuyen a esa descripción. Sus efectos no tienen por qué clasificarse como universalmente beneficiosos o perjudiciales.
El análisis produce tres afirmaciones refutables: una interfaz lineal compresiva de parches hace indistinguibles algunas entradas distintas; la atención basada únicamente en el contenido es equivariante ante la permutación de tokens bajo aplicaciones compartidas; y las ventanas de tamaño fijo modifican cómo escala el número de pares candidatos con el número de tokens. Estas afirmaciones son exactas bajo sus supuestos. Si alguna de ellas mejora una tarea real de reconocimiento sigue siendo una cuestión empírica. Informar de ambos niveles proporciona a los lectores una explicación más sólida que declarar que un modelo tiene más o menos sesgo. También orienta el diseño: conservar las distinciones relevantes, restringir las transformaciones que la tarea justifique y asignar cómputo a las relaciones que la decisión requiere realmente.
Ejecutado localmente · Alcance acotado
Colisión de parches, todas las permutaciones de tres tokens y recuentos analíticos de atención
Álgebra finita de atención entre tokens y recuentos de operaciones especificados; sin evaluaciones de referencia de imágenes ni perfilado de aceleradores.
Se superaron 71 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "patch_input": [
    1.0,
    2.0,
    3.0,
    4.0
  ],
  "collision_input": [
    1.0,
    2.0,
    4.0,
    3.0
  ],
  "shared_embedding": [
    1.0,
    2.0
  ],
  "fixed_position_defect": 2.177542430560174,
  "global_pairs_at_P16": 38416
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Dimensión del parche aplanado D, anchura de la incrustación d; la cota inferior se aplica a una aplicación lineal sin canales auxiliares.
(2) La matriz de permutación Pi actúa sobre las filas de tokens; proyecciones compartidas y ausencia de términos dependientes de la posición que queden sin transformar.
(3) Recuentos de pares de consulta y clave para cuadrículas de imagen divisibles, ventanas de w por w tokens, sin tokens de clase ni relleno.
(4) El panel 2 utiliza un parche RGB hipotético de 4 por 4 (48 coordenadas); no es una afirmación sobre las dimensiones de las configuraciones publicadas de ViT.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Decisión de diseño | Efecto estructural | Afirmación que requiere evidencia adicional |
|---|---|---|
| Proyección lineal de parches | Puede hacer indistinguibles parches distintos mediante un núcleo | Si las direcciones perdidas importan para el objetivo |
| Incrustaciones de posición | Hacen accesible la disposición espacial | Generalización a condiciones de coordenadas no vistas |
| Ventanas locales o desplazadas | Restringen la comunicación inmediata | Uso aprendido de dependencias de largo alcance |
| Destilación | Añade supervisión procedente del profesor | Atribución de las mejoras únicamente a la arquitectura del alumno |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna evaluación de referencia de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Comprobar la dimensión del parche, el rango de la incrustación y ejemplos explícitos de colisión.
- Verificar las identidades de permutación de tokens con y sin señales de posición.
- Calcular la alcanzabilidad de las máscaras de atención y los recuentos de pares bajo reglas de relleno declaradas.
- Construir tareas controladas variando la escala de los objetos, la alineación de los parches y las relaciones de largo alcance.
- Comparar con exposición a datos y cómputo igualados, registrando los profesores y la procedencia del preentrenamiento.
- Informar del rendimiento con imágenes naturales por separado del álgebra exacta, el coste analítico y el comportamiento medido del hardware.
Qué establecen las fuentes primarias
Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov et al. · 2021 [1]
Contribución. ViT aplica un transformador a parches de imagen incrustados y estudia el preentrenamiento y la transferencia.
Límite. Sus resultados empíricos dependen de las condiciones especificadas de datos y optimización.
Ubicación en la fuente. Descripción del modelo y resumen.
Hugo Touvron, Matthieu Cord, Matthijs Douze et al. · 2021 [2]
Contribución. DeiT introduce un token de destilación entre profesor y alumno en el entrenamiento de transformadores de imágenes eficiente en el uso de datos.
Límite. La supervisión del profesor forma parte de la comparación; no se reimplementaron todos los detalles del entrenamiento.
Ubicación en la fuente. Resumen de la editorial original.
Ze Liu, Yutong Lin, Yue Cao et al. · 2021 [3]
Contribución. Swin combina atención con ventanas, particiones desplazadas y representaciones jerárquicas.
Límite. El escalado lineal supone un tamaño de ventana fijo; la versión inspeccionada es la prepublicación de los autores.
Ubicación en la fuente. Resumen y descripción general de la arquitectura.
Límites de este análisis
- El teorema de rango y nulidad indica qué colisiones deben existir, no si las imágenes naturales ocupan esas direcciones.
- Los recuentos de pares excluyen las proyecciones, las capas de propagación hacia delante, los movimientos de memoria y los efectos del hardware.
- Tres arquitecturas fundacionales no abarcan todos los diseños posteriores de transformadores de visión.
- Estas comprobaciones finitas no reproducen ningún resultado publicado de exactitud ni de tiempo real transcurrido.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué variaciones relevantes para la tarea se pierden de manera sistemática en la interfaz de parches antes de que comience la atención?
- ¿Puede predecirse la generalización de coordenadas a partir de un contrato explícito de transformación de posiciones?
- ¿Cómo debe compararse la eficiencia arquitectónica cuando difieren la supervisión del profesor y la exposición a los datos?
Referencias
- Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov et al.. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. International Conference on Learning Representations (2021). Primary source.
- Hugo Touvron, Matthieu Cord, Matthijs Douze et al.. Training data-efficient image transformers & distillation through attention. Proceedings of the 38th International Conference on Machine Learning (2021). Primary source.
- Ze Liu, Yutong Lin, Yue Cao et al.. Swin Transformer: Hierarchical Vision Transformer using Shifted Windows. arXiv (2021). 10.48550/arXiv.2103.14030.
Acceso a la fuente [1]. Se inspeccionaron el texto PDF del artículo original y su página bibliográfica original.
Nota de versión. Se consultó el artículo de ICLR 2021 como arXiv v2, revisado el 3 de junio de 2021; la primera publicación en arXiv fue en 2020.
Acceso a la fuente [2]. Se inspeccionaron la página de la editorial original, el resumen y la bibliografía completa; no se reimplementa la receta detallada de entrenamiento.
Acceso a la fuente [3]. Se inspeccionaron el texto PDF del artículo original y su página bibliográfica original.
Nota de versión. Se inspeccionó la prepublicación de los autores v2. La solicitud del HTML de la conferencia en CVF devolvió 403, por lo que este registro cita explícitamente la versión de arXiv.
Las identidades bibliográficas se contrastaron con los registros de las editoriales originales y de los autores. Las notas siguientes sobre acceso a las fuentes y versiones describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni evaluaciones de rendimiento reproducidas.
Este borrador local no tiene registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos especificados; no constituyen una verificación formal de los sistemas citados.