
要旨
視覚Transformerは、帰納バイアスを持たないアーキテクチャと説明されることがある。本レビューでは、その説明を、制約がどこに導入されるかの明示的な整理に置き換える。対象は、パッチ射影、位置符号化、注意の接続性、階層構造、教師モデルによる教師信号である。ViT、DeiT、Swinを主要な三つのアーキテクチャ上の基準とする。本稿では、不可逆なパッチ圧縮に対する階数・退化次数の検査、内容のみに基づく注意の置換同変性の恒等式、そして大域的注意と固定ウィンドウ注意の透明性のある演算数比較を展開する。これらの構成は、表現可能性、統計的選好、実行コストを区別する。提案する実験は、アーキテクチャの変更と、学習データおよび教師信号の変更を区別する。図は解析的な個数計算と線形代数の例であり、ハードウェア測定でも、画像分類ベンチマークの追試でもない。中心的な結論は、妥当な比較では、注意を事前構造の欠如とみなすのではなく、各パイプラインが保持し、捨て、あるいはデータから学習する情報と対称性を明示すべきだということである。
1. バイアスはパイプライン全体の性質である
帰納バイアスとは、可能な入出力関係の間にある選好であり、アーキテクチャ、データ、最適化、または教師信号から生じる。固定されたパッチ格子を処理するネットワークは、すでに画像の特定の表現を採用している。空間的なデータ拡張を用いて学習したモデルは、その注意層が代数的に柔軟であっても、追加的な選好を獲得する。事前学習済みの教師モデルは、さらに構造を与えうる。
したがって、科学的に重要な問いは、視覚Transformerにバイアスがあるかどうかではなく、ある特定のバイアスがどこに実装され、意図した課題にどう影響するかである。構造的制約は、有用な規則を学習しやすくすることも、課題に必要な区別を排除することもある。データに基づく選好は、豊かな学習分布に適応することも、見せかけの規則性を引き継ぐこともある。本稿では、混同されがちな三つの問題、すなわち、どの関数が表現可能か、どの関数が学習によって優先されるか、その計算がどれほど高コストかを分離する。
2. アーキテクチャ上の基準としてのViT
Dosovitskiyらは、線形に埋め込んだ画像パッチの系列に、位置埋め込みと分類の設定を加えてTransformerを適用する。彼らの論文は大規模事前学習と転移を評価し、報告された条件のもとで、この設計が優れた性能を発揮しうることを示している。画像構造がパイプラインから消えたことや、学習データの規模が無関係であることを示したわけではない。
ここで検討する構成は、パッチからトークンへのインターフェースである。パッチが埋め込みに写像されると、それ以降のすべての計算は、このインターフェースで保持された情報に依存する。以下の階数計算は、この段階に対する独立した線形代数的診断である。元論文の実際のViT構成が、必ずパッチを元の次元より低い次元に圧縮しているという主張ではない。 [1]
3. DeiTは教師信号の捉え方を変える
Touvronらはデータ効率の高いTransformer学習を研究し、生徒モデルが教師モデルから学ぶための蒸留トークンを導入する。一次出版元の記録は、ImageNetとアーキテクチャ固有の教師・生徒戦略を用いた、競争力のある学習を説明している。
重要な区別は、生徒モデルのアーキテクチャ上の形式だけでは、その教師信号を完全には記述できないことである。畳み込み型の教師モデルは、配備される生徒モデルに畳み込み層を置かずとも、自らが与える教師信号を通じてTransformerに影響を及ぼしうる。これは蒸留が不当だという意味ではなく、帰納バイアスを比較する際には、教師モデルとその学習履歴を考慮しなければならないという意味である。本レビューは、元論文の最適化手順やベンチマークの数値結果を再現しない。教師・生徒設計を、生徒モデルのグラフを超えて知識源を追跡すべき具体的理由として用いる。 [2]
4. Swinは局所性を明示する
Liuらは、局所ウィンドウ内に注意を組織し、ブロック間でウィンドウ分割をシフトさせ、空間解像度を変化させる階層構造を用いる。著者プレプリントは、これにより注意のコストを制御しつつウィンドウ間通信を可能にする仕組みを説明している。その計算量のスケーリングに関する記述は、画像解像度が増す際にウィンドウサイズが固定されることを仮定している。
したがって、局所性は排除されていない。通信パターンに組み込まれている。シフトした分割は、前のブロックでは分離していた領域を接続できるが、一つのブロックを無制限の大域的注意と等価にするわけではない。本稿の演算数計算は、候補となるクエリ・キー対を切り出して扱う。元論文のベンチマーク値を再現するものでも、アクセラレータの実際のレイテンシを推定するものでもない。得られる曲線を解釈するうえで、接続性と実際の実行時間の区別は不可欠である。 [3]
5. パッチ射影には厳密な情報境界がある
Cチャネルを持つP掛けるP画素のパッチをD個の座標に平坦化する。ここでDはPの二乗にCを掛けた値である。幅dの線形埋め込みは、行列を通じてそれらの座標を写像する。dがDより小さい場合、行列が最大階数であっても、階数・退化次数定理により非自明な零空間が保証される。差が零空間のベクトルである二つのパッチは、同じトークンを生成する。
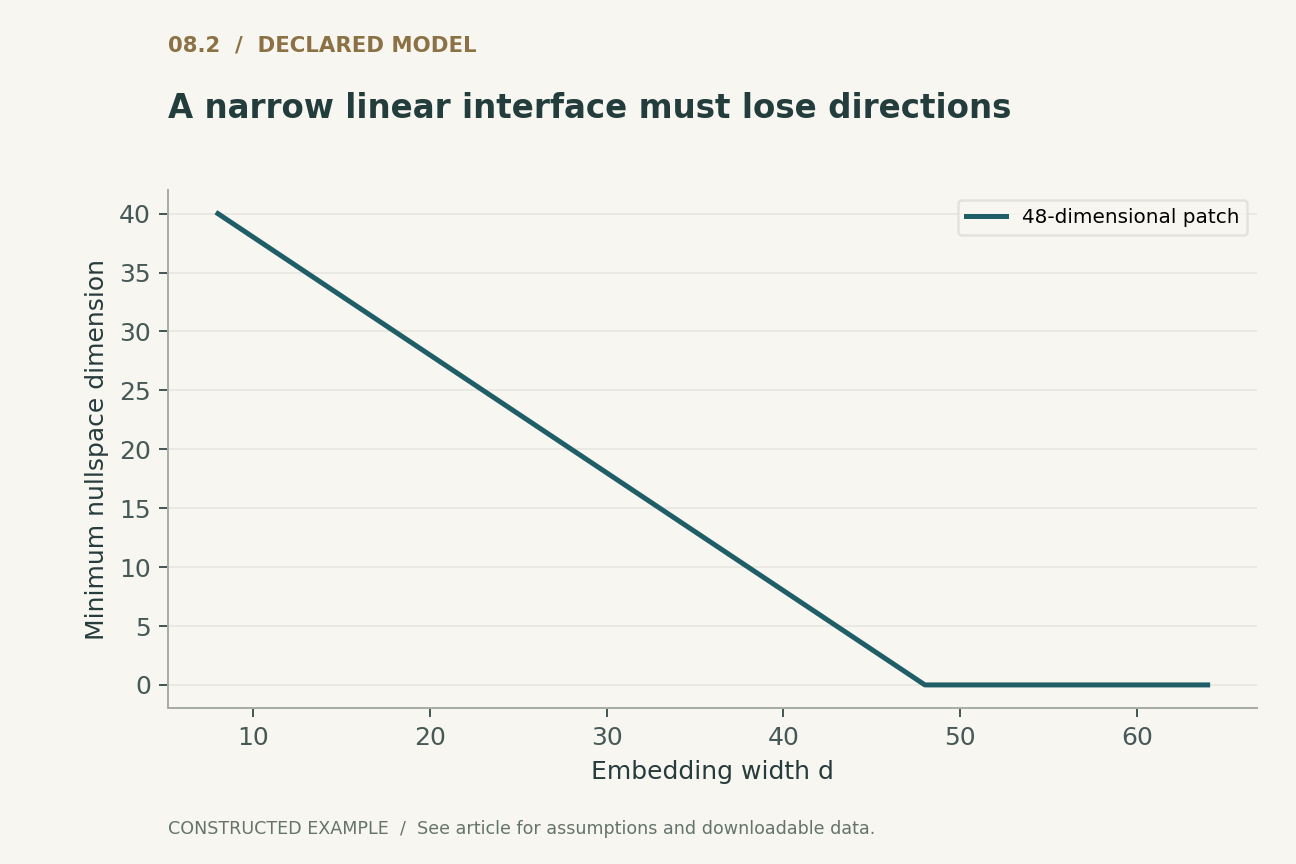
後段のいかなる決定論的ネットワークも、そのトークンだけから二つのパッチを区別することはできない。これはインターフェースに関する不可能性であり、注意の学習に関するものではない。失われた方向が特定のデータセットで重要だという意味でも、実用的なパッチ埋め込みがすべて圧縮的だという意味でもない。パネル2は、次元を48と明示したパッチについて、幅の変化に伴う零空間次元の最小値を示す。実行可能な例では、衝突を直接構成し、埋め込みが同一であることを確認する。健全なアーキテクチャ研究では、射影によって除去された変動が意図したラベルに無関係なのか、それとも稀だが決定的な特徴を含むのかを問うべきである。
6. パッチサイズは個数と粒度をトレードオフする
一辺Hの正方形画像で、Hがパッチの一辺Pで割り切れる場合、パッチ数はHをPで割った値の二乗である。したがって、パッチサイズを大きくすると、トークン数と各パッチの生の次元数の両方が変わる。これらの効果を、単一の効率調整つまみとして説明すべきではない。
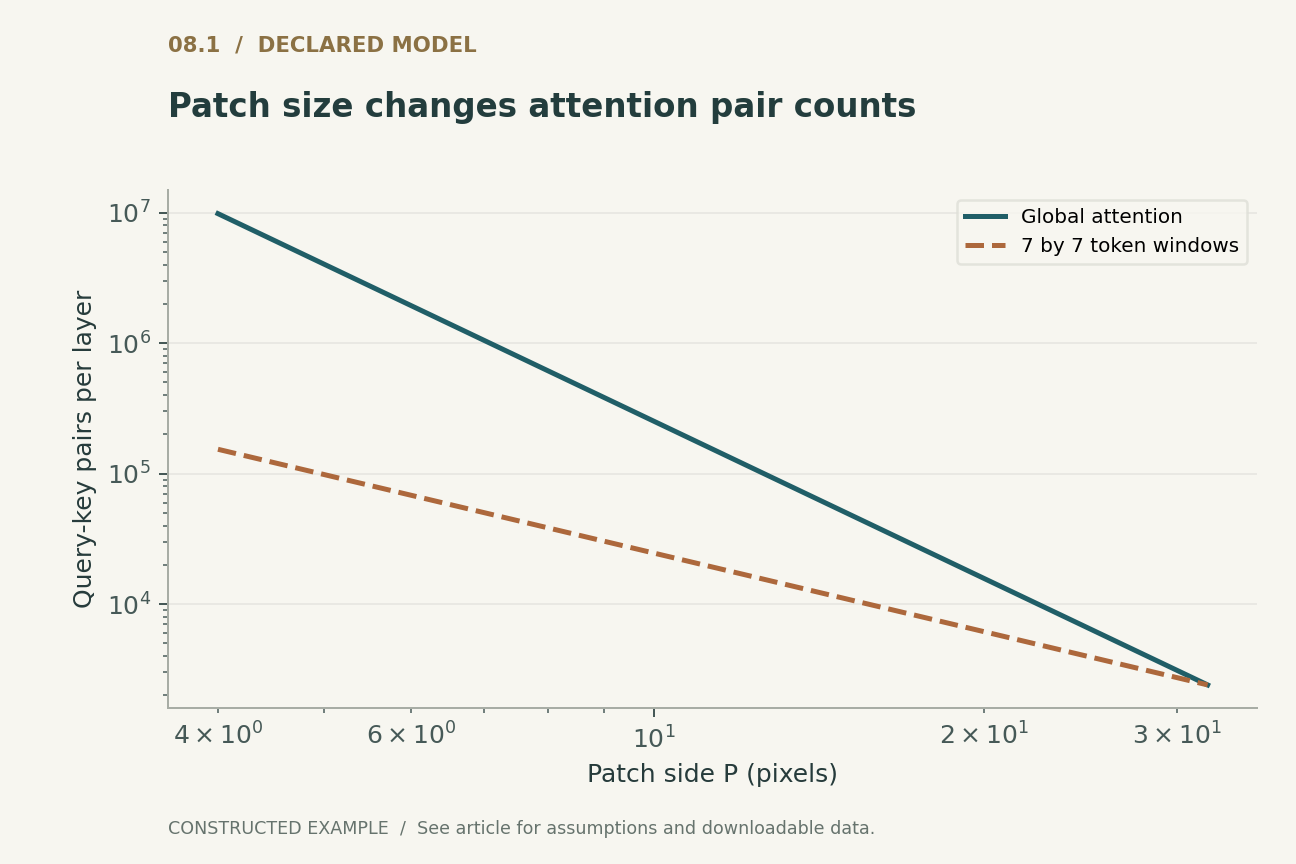
Hを224としたとき、パネル1は、一辺が四、八、十六、三十二画素のパッチについて対の数を比較する。大域的注意の項は、すべてのトークン対を用いる。ウィンドウ型の比較では、一つのクエリ当たり最大四十九個のキーを用い、七掛ける七のトークン格子全体が一つのウィンドウに収まると大域的注意と等しくなる。これらは、明示した分割のもとでの厳密な候補数であり、クラストークン、パディング、その他の層を除外している。より粗いパッチ格子は注意スコア数を減らすが、微細な情報を保持する負担を埋め込みへ移す可能性がある。その情報が残るかどうかは、トークン数だけでなく、射影幅と学習された重みに依存する。
7. 内容のみに基づく注意はトークンの置換に整合する
トークン行列を置換行列によって置換するとする。クエリ、キー、バリューを各行に共通の線形写像で計算し、位置に依存する項が存在しなければ、注意の出力も同じように置換される。行ごとのsoftmaxは、スコア行列の対応する行と列の置換に整合する。この恒等式は小さな行列で直接確認できる。
この同変性が対象とするのは、トークン全体の並べ替えであり、画像の任意の画素平行移動や回転ではない。パッチの置換は、トークン内容の多重集合を保ちながら視覚的配置を変える。内容のみに基づく注意からの置換不変な読み出しは、このような置換だけによって異なる配置を区別できない。空間的な位置信号は、その特定の対称性を意図的に破り、モデルが配置を利用できるようにする。この対称性の破れを実装上の細部と呼ぶことは、その機能的役割を見落とす。それは、モデルがどの区別を表現でき、どの区別を外部の座標規約から与える必要があるかを決定する。
8. 位置信号は座標に関する仮定を担う
絶対位置埋め込みは、特定のスロットに学習済みの識別子を付与する。相対位置項は、位置間の関係を記述する。どちらも空間情報を与えるが、解像度の変化、画像の切り抜き、座標系のシフトに対して、同じ挙動を示すとは限らない。
解像度変更の実験では、位置パラメータをどのように補間するか、あるいは別の方法で写像するかを明示しなければならない。その操作は、新たな位置で直接学習されていない挙動を導入しうる。平行移動の実験では、元のシーンの平行移動と、パッチに対する位置合わせの変更を区別しなければならない。小さな画素シフトでも、意味的な同一性が変わらないまま、内容がパッチ境界を越えて移動しうる。トークン置換の厳密な恒等式は、こうした画素操作に対する厳密な同変性を意味しない。付属の有限的な例は、置換していない絶対位置信号が内容のみに基づく置換同変性を破りうる一方、内容と位置を同時に置換すると代数的恒等式が回復することを示す。これはインターフェースの数学的検査であり、ある位置戦略が普遍的に望ましいという主張ではない。
9. 通信に必要な深さは明示的に測定すべきである
大域的注意層では、各トークンが他のすべてのトークンに直接重みを付けられるが、学習された重みによって有用な通信が困難になることは依然としてありうる。ウィンドウ型の層は、可能な即時相互作用の集合を制限する。分割を交互に変えると、深さに伴って到達可能性が広がり、階層構造は領域の統合に伴ってトークンの意味を変える。
到達可能性は、一部の計算にとって必要条件であり、その計算が学習されることや安定であることの証明ではない。遠く離れた領域間の既知の関係をラベルが必要とする課題を作り、局所的な視覚統計量を固定したまま距離を変えることで、実験はこれらの概念を区別できる。アーキテクチャ名に頼るのではなく、実際のマスクのもとで情報の伝播に必要な層数を報告すべきである。追加の大域的トークンやウィンドウ間経路も、グラフに含めなければならない。このような診断は、主張される長距離の利点が、利用可能な通信に由来するのか、それともデータや最適化における他の違いに由来するのかを検査する。
10. 公平な比較には複数の予算がある
パラメータ数を揃えても、学習計算量、データへの曝露量、活性値メモリ、教師モデルによる教師信号が揃うわけではない。一つのアクセラレータ上で経過時間を揃えても、最適化更新回数は揃わない。これらの違いを記録せずにアーキテクチャを比較すると、資源面の優位性をアーキテクチャ上の説明へとすり替えてしまう可能性がある。
有用な評価では、少なくとも、生徒モデルのパラメータ数、画像トークンへの曝露量、明示した計数規約に基づく学習演算数、オプティマイザのステップ数、外部の教師モデルまたは事前学習データを公開すべきである。ハードウェアが主張の一部である場合、実際のスループットとメモリを解析的な個数計算とは別に報告する。アーキテクチャへの介入を検査する際は、完全なパイプラインの比較を明示的な目的とする場合を除き、同じデータ分割とデータ拡張方針を用いるべきである。完全なパイプラインの比較は有益だが、その解釈は異なる。それが明らかにするのは、一定の資源枠内でどの組合せが機能するかであり、どの単独の機構が改善を引き起こしたかではない。この区別は、一方の組合せが蒸留を通じて情報を受け継いでいる場合に特に重要である。
11. 視覚モデルのための段階的検証
提案する評価は、零空間による衝突、トークン置換の恒等式、注意マスクの到達可能性という、インターフェースの厳密な検査から始まる。これらの検査は低コストであり、アーキテクチャに関する主張を精密にする。次の段階では、関連する変数と無関係な変数が既知の統制された視覚課題を用い、パッチの位置合わせ、スケール、位置の変化を独立に操作できるようにする。
その後に初めて、実用上の重要性を評価するために自然画像ベンチマークを用いるべきである。その結果には、事前に指定した部分集団、複数の学習シード、検証データでの調整に関する明確な方針を含めるべきである。平均誤差が低くても、小さな物体や通常とは異なる空間配置での失敗は併存しうる。逆に、合成課題での失敗は、配備範囲には存在しない区別に関するものかもしれない。両方の事実を記録すべきである。付属コードが検査するのは有限的な代数と対の数だけであり、Transformerの学習、GPUのプロファイリング、引用した三つのシステムの独立した追試は行わない。各証拠水準の境界は区別されたままである。
12. 標語からアーキテクチャに関する主張へ
視覚アーキテクチャは、保持する情報、整合する変換、一定のコストで可能にする通信によって記述するのが最も適切である。パッチ射影、位置信号、ウィンドウ構造、教師モデルが与える教師信号は、それぞれその記述に寄与する。それらの効果を、普遍的に有益または有害と分類する必要はない。
この分析から、反証可能な三つの命題が得られる。圧縮的な線形パッチインターフェースは、異なる入力の一部を同一視する。内容のみに基づく注意は、共通の写像のもとでトークン置換に対して同変である。固定サイズのウィンドウは、トークン数に対する候補ペア数のスケーリングを変える。これらの命題は、その仮定のもとで厳密である。そのいずれかが実際の認識課題を改善するかどうかは、依然として実証的な問題である。両方の水準を報告することは、あるモデルのバイアスが多いか少ないかと宣言するよりも強い説明を読者に与える。また、重要な区別を保持し、課題が正当化する変換を制約し、判断が実際に必要とする関係に計算を配分するという設計指針にもなる。
ローカルで実行済み · 限定された範囲
パッチの衝突、三トークンの全置換、解析的な注意の個数計算
有限的なトークン注意の代数と、指定された演算数。画像ベンチマークやアクセラレータのプロファイリングは含まない。
71件のアサーションが成功した。 これらの検査が検証するのは提示した例であり、引用したシステムではない。
記録された証拠例を確認
{
  "patch_input": [
    1.0,
    2.0,
    3.0,
    4.0
  ],
  "collision_input": [
    1.0,
    2.0,
    4.0,
    3.0
  ],
  "shared_embedding": [
    1.0,
    2.0
  ],
  "fixed_position_defect": 2.177542430560174,
  "global_pairs_at_P16": 38416
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検査結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 平坦化したパッチの次元はD、埋め込み幅はd。下限は、補助情報経路のない線形写像に適用される。
(2) 置換行列Piはトークンの行に作用する。射影は共通であり、変換されずに残る位置依存項はない。
(3) 割り切れる画像格子と、w掛けるwトークンのウィンドウに対するクエリ・キー対の数。クラストークンとパディングは含まない。
(4) パネル2は、仮想的な4掛ける4のRGBパッチ(48座標)を用いる。公表されたViT構成の次元に関する主張ではない。
構成した例 · 再現可能なデータ
定量的な論証を確認
これらの曲線は、明示したモデルから計算される。引用した研究の観測結果ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 設計上の選択 | 構造的効果 | 追加の証拠が必要な主張 |
|---|---|---|
| 線形パッチ射影 | 零空間を通じて異なるパッチを同一視しうる | 失われた方向が目標にとって重要かどうか |
| 位置埋め込み | 空間配置を利用可能にする | 未見の座標条件への汎化 |
| 局所ウィンドウまたはシフトウィンドウ | 即時の通信を制約する | 長距離依存関係の利用の学習 |
| 蒸留 | 教師モデル由来の教師信号を追加する | 改善を生徒モデルのアーキテクチャだけに帰属させること |
提案する検証プロトコル
これは提案段階の評価設計である。実運用システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検査の節に記録している。
- パッチ次元、埋め込みの階数、明示的な衝突例を検査する。
- 位置信号がある場合とない場合のトークン置換の恒等式を検証する。
- 明示したパディング規則のもとで、注意マスクの到達可能性と対の数を計算する。
- 物体のスケール、パッチの位置合わせ、長距離関係を変化させる統制課題を構築する。
- 教師モデルと事前学習の来歴を記録しつつ、データ曝露量と計算量を揃えて比較する。
- 自然画像での性能を、厳密な代数、解析的コスト、測定されたハードウェア挙動とは別に報告する。
一次資料が明らかにしていること
Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov et al. · 2021 [1]
貢献。 ViTは埋め込まれた画像パッチにTransformerを適用し、事前学習と転移を研究する。
適用限界。 その実証結果は、指定されたデータと最適化の条件に依存する。
資料内の該当箇所。 モデルの説明と要旨。
Hugo Touvron, Matthieu Cord, Matthijs Douze et al. · 2021 [2]
貢献。 DeiTは、データ効率の高い画像Transformer学習に、教師・生徒間の蒸留トークンを導入する。
適用限界。 教師モデルによる教師信号も比較の一部である。学習の全詳細は再実装していない。
資料内の該当箇所。 一次出版元の要旨。
Ze Liu, Yutong Lin, Yue Cao et al. · 2021 [3]
貢献。 Swinは、ウィンドウ型注意、シフトした分割、階層的表現を組み合わせる。
適用限界。 線形スケーリングは固定ウィンドウサイズを仮定する。確認した版は著者プレプリントである。
資料内の該当箇所。 要旨とアーキテクチャの概要。
本分析の限界
- 階数・退化次数定理が示すのは、どの衝突が必ず存在するかであり、自然画像がそれらの方向を占めるかどうかではない。
- 対の数には、射影、フィードフォワード層、メモリ転送、ハードウェアの効果を含めない。
- 三つの基礎的アーキテクチャは、その後の視覚Transformer設計を網羅しない。
- これらの有限的検査は、公表された精度や実経過時間の結果をいずれも再現していない。
選定した三つの基礎的一次資料に焦点を絞った解析的レビューであり、独自の計算例を含む。2026までの文献を網羅した、あるいは体系的に調査したものではない。資料へのアクセスと版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 注意が始まる前のパッチインターフェースで、一貫して失われる課題関連の変動は何か。
- 明示的な位置変換の契約から、座標に関する汎化を予測できるか。
- 教師モデルによる教師信号とデータ曝露量が異なる場合、アーキテクチャの効率をどのように比較すべきか。
参考文献
- Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov et al.. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. International Conference on Learning Representations (2021). Primary source.
- Hugo Touvron, Matthieu Cord, Matthijs Douze et al.. Training data-efficient image transformers & distillation through attention. Proceedings of the 38th International Conference on Machine Learning (2021). Primary source.
- Ze Liu, Yutong Lin, Yue Cao et al.. Swin Transformer: Hierarchical Vision Transformer using Shifted Windows. arXiv (2021). 10.48550/arXiv.2103.14030.
資料[1]へのアクセス。 原論文のPDF本文と一次書誌ページを確認した。
版に関する注記。 ICLR 2021論文をarXiv v2として参照した。同版の改訂日は2021年六月3日であり、arXivへの初回投稿は2020年である。
資料[2]へのアクセス。 一次出版元のページ、要旨、参考文献全体を確認した。詳細な学習手順は再実装していない。
資料[3]へのアクセス。 原論文のPDF本文と一次書誌ページを確認した。
版に関する注記。 著者プレプリントv2を確認した。CVFの会議HTMLへのリクエストは403を返したため、この記録ではarXiv版を明示的に引用する。
書誌上の同一性は、一次出版元および著者の記録と照合した。以下の資料アクセスと版に関する注記は、その範囲を記述するものであり、全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示し、解析的構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的イラストである。技術図は、明示したモデルまたは有限的な例から計算され、PythonとCSVを提供している。配備済み製品の測定でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示した小規模モデルを検査するものであり、引用したシステムの形式的検証ではない。