
要旨
マスク付き再構成は、ラベルのない観測から訓練信号を取り出す強力な方法であるが、その成功基準は慎重に解釈しなければならない。本総説は、ノイズ除去オートエンコーダ、マスク付きオートエンコーダ、離散トークンによる画像モデリングを、二つの厳密な構成例に結び付ける。ガウス分布の条件付き予測問題は、低い再構成誤差と課題情報を切り分ける。反復ビットのマスキング問題は、本来なら完全に情報を与える意味的特徴が、いつ利用不能になるかを定量化する。本分析は、エンコーダの質とデコーダの容量、標的表現と入力表現、計算量の削減と情報の保存を区別する。また、マスクの幾何形状、課題と無関係な変動の予測可能性、意味的冗長性を独立に操作する統制試験を提案する。技術的な図は明示された解析的分布を描いたものであり、MAEやBEiTの新たな結果ではない。得られる主張は条件付きである。再構成は、モデルが可視コンテキストから選択された標的を予測することの証拠であり、その能力が下流の判断に何を意味するかを確立するには、追加の実験が必要である。
1. 複数の隠れた選択を伴う予測課題
画像の再構成は一つの課題のように聞こえるが、その意味は複数の決定に依存する。どの座標を隠すのか。標的は生の強度、正規化された強度、離散トークン、それとも教師表現なのか。デコーダが見るのはエンコーダの出力だけか、それとも追加の空間情報やマスキング情報も含むのか。どの誤りに大きなコストを課すのか。それぞれの決定が最適予測器を変え、したがって低い損失によって何を確立できるかも変える。
有用な分析対象は、予測器に明示的に利用可能な情報から欠損標的を推論する、条件付き予測問題である。この定式化によって、情報漏洩、不可約な不確実性、課題と無関係な変動を利用するショートカットが明らかになる。また、視覚的にもっともらしい再構成から意味理解へと飛躍する、正当化されない推論も避けられる。モデルは、近傍画素が局所統計を共有しているために欠損したテクスチャを復元できても、その物体についての問いには答えられない場合がある。逆に、分類に有用な表現は、すべての画素の正確な強度を保存する必要はない。
2. 示唆に富む先行原理としてのノイズ除去
Vincentらは、破損した入力から破損前の入力を復元するようにノイズ除去オートエンコーダを訓練し、得られた表現を深層アーキテクチャで用いている。この資料は、破損と復元を表現学習の原理として確立し、同論文の分類ベンチマークで評価している。あらゆる破損過程が同じ表現を生むとも、再構成だけで意味的な適切性が証明されるとも主張していない。
ここで重要な概念的継承は、情報を意図的に伏せることで、自明な恒等写像による解を防げるという点である。あらゆるショートカットを防げるかどうかは、破損の分布とアーキテクチャに依存する。ここで展開するガウス分布とマスキングの例は独立した解析的構成であり、同論文の実験、データセット、ネットワーク実装の再現ではない。 [1]
3. マスク付きオートエンコーダの設計は何を変えるのか
Heらは、エンコーダが可視画像パッチを処理し、軽量デコーダが画素を再構成する非対称なマスク付きオートエンコーダを導入した。マスクトークンはデコーダで導入される。同研究は、評価対象とした視覚事前学習の設定において、高い割合のマスキングが有効であることを示している。
本総説にとって重要なアーキテクチャ上の切り分けは、マスクされたトークンをエンコーダから除くことが計算負荷を変える一方、それらを再構成することが学習標的を定めるという点である。両者は関連するが、異なる効果である。同論文のマスキング率は実証的な設計上の選択であり、あらゆる画像分布や下流課題に対する普遍的な最適値ではない。後述のトークン数の計算は、アテンションの一つの項を意図的に切り出したものであり、同論文で測定された高速化を再現するものではない。 [2]
4. 標的には別のモデルが含まれうる
BEiTは、破損した画像パッチから離散的な視覚トークンを予測する。これによってBaoらは、生の画素の予測を要求するのではなく、標的表現を事前学習の明示的な構成要素としている。確認した資料は著者らの改訂版プレプリントであり、参考文献にはその版を記録している。
この設計は統計的課題を変える。トークナイザは、どの変動が同じ標的を共有し、どの差異が区別可能なまま残るかを決定する。学習に成功した生徒モデルは、その標的の構成から有用な抽象を受け継ぐ可能性があるが、そこで欠落したものも受け継ぎうる。同じ問題は、連続的な教師表現でも生じる。本分析が扱うのは情報と目的関数の設計であり、BEiTの訓練手順やベンチマークスコアを再現するものではない。トークン予測と画素再構成を等価な損失として扱えば、中心的な実験介入を見えなくしてしまう。 [3]
5. 二乗再構成誤差が実際に同定するもの
欠損したスカラー標的Xと可視コンテキストVに対し、二乗誤差の下での最適予測器は、Vを与えたときのXの条件付き平均である。リスクは、条件付き分散と、その平均からの偏差の二乗に分解される。この初等的な恒等式は、いかなる予測器にも除去できない不確実性と、選択したモデルによって生じる誤差を区別する。
同程度にもっともらしい二つの補完が互いに反対の強度を持つ場合、条件付き平均はその中間に位置し、どちらにも似ない可能性がある。したがって、滑らかな再構成は、最適化器の性能が低い証拠ではなく、二乗誤差に対して適切な解である場合がある。逆に、別の目的関数によって選ばれた鮮明な補完は、見た目には説得的でも、実現した標的に対しては誤っている可能性がある。正しい評価は、期待強度、較正された分布、もっともらしい一つの補完、あるいは下流変数の保存という、意図された判断に従う。これらの目的を単一の視覚的判断で比較すると、モデル容量を増やしても解消できない曖昧さが生じる。付属の有限検証プログラムは、複数の相関と、意図的に誤指定した線形予測器について、超過リスクの代数的分解を確認する。
6. 厳密なガウス型ショートカット
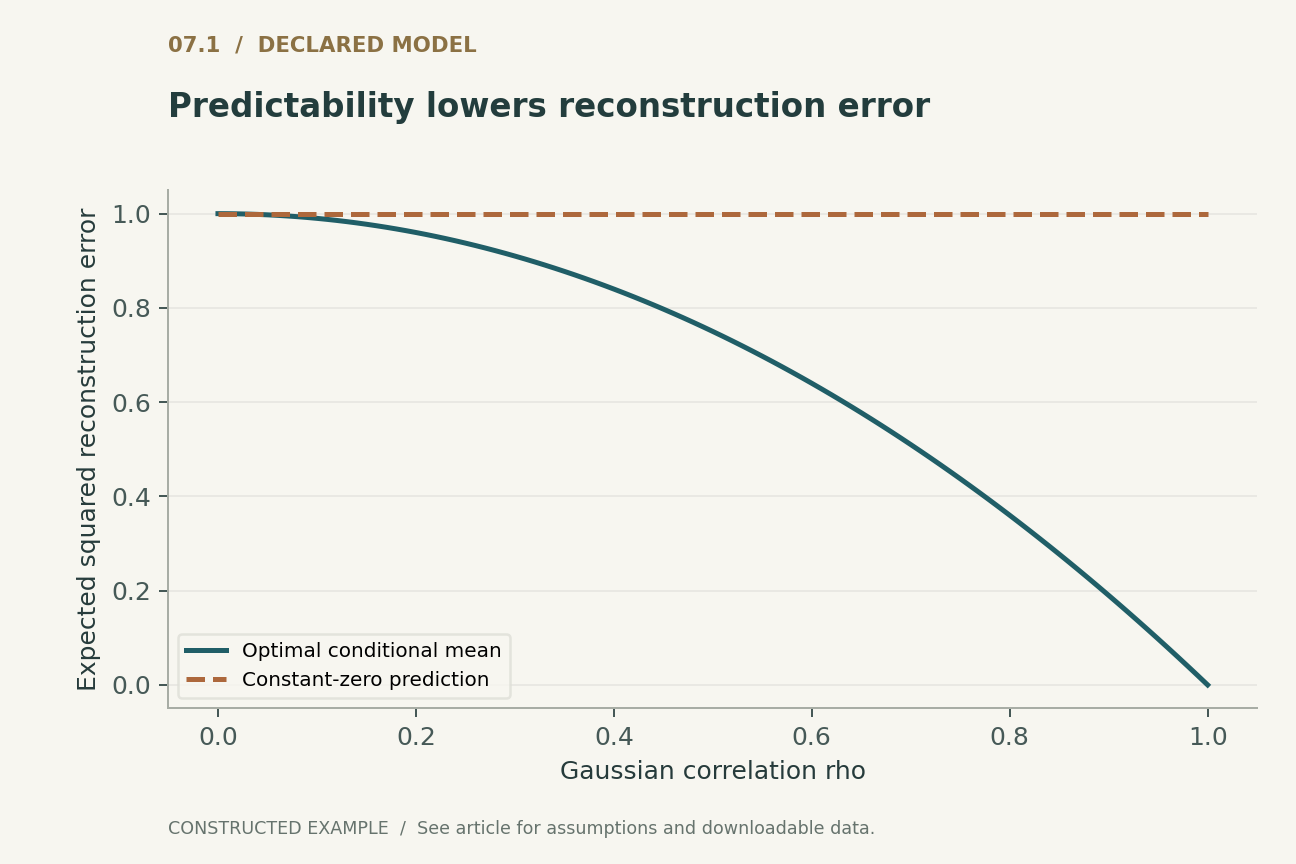
XとVを、平均ゼロ、単位分散、相関rhoの同時ガウス分布に従う変数とする。VからのXの条件付き予測はrhoとVの積であり、平均二乗誤差は一からrhoの二乗を引いた値となる。パネル1は、この不可約誤差を描き、誤差が一のままである定数予測器と比較する。相関が一に近づくにつれて、再構成問題は容易になる。
次に、観測されない状態に、独立で等確率の意味ビットYを追加し、XもVもYに依存しないようにする。Xを完全に予測しても、Yに関する情報は一切得られない。これは意図的に厳格な反例であり、視覚的意味全般のモデルではない。再構成の質から課題情報が得られるという普遍的な含意を否定するものである。意味的転移を主張するには、訓練信号と標的の間に実際の依存関係があることを示すか、下流の判断を直接測定しなければならない。独立したビットを弱く相関するビットに置き換えると、結論は定量的なものになるが、この区別はなくならない。
7. マスキングは唯一の有用な証拠を消しうる
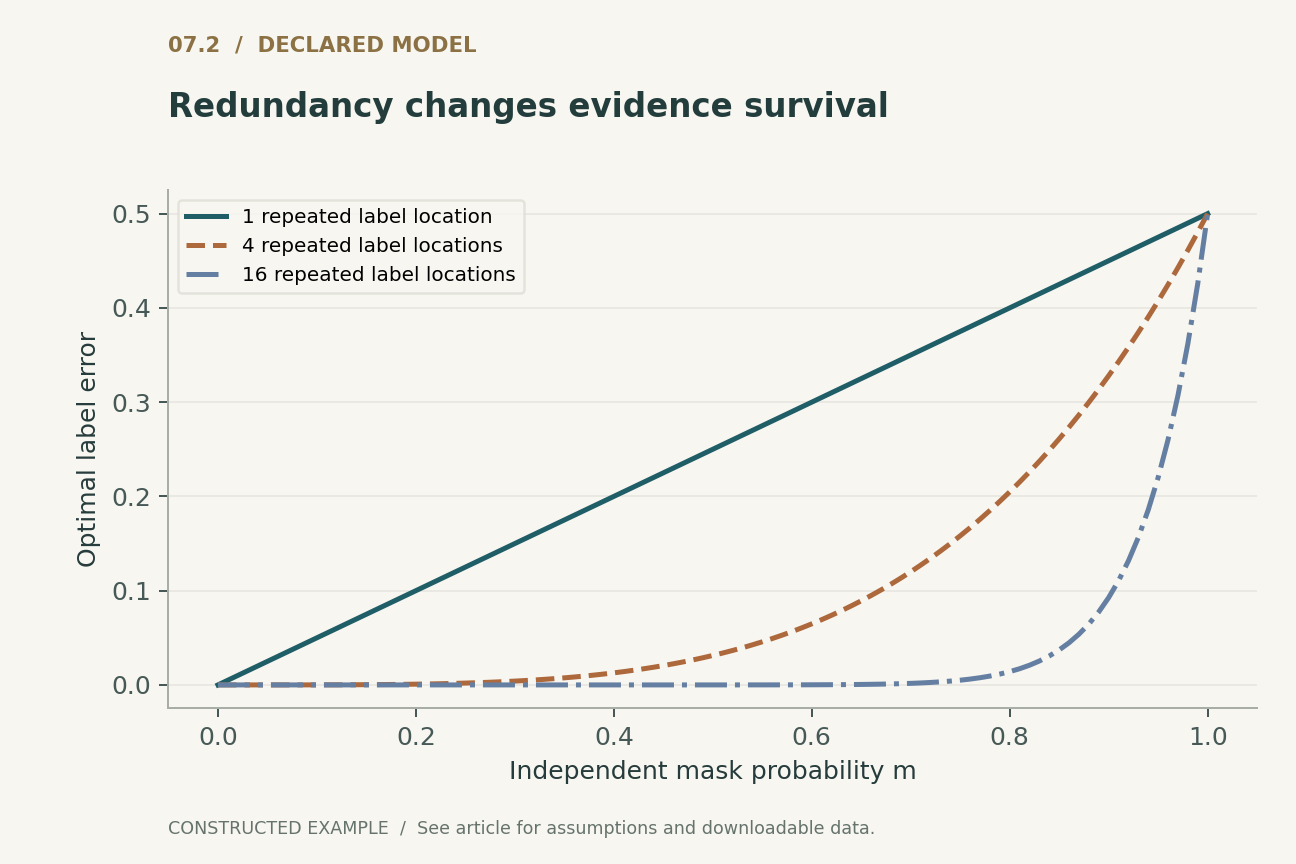
別の構成として、等確率のラベルビットを、互いに異なるr個の観測可能な位置に複製する場合を考える。各位置は確率mで独立にマスクされる。少なくとも一つのコピーが可視のまま残れば、ラベルは完全に復号できる。すべてのコピーが消えると、可視観測にはラベル情報がなく、最適な分類でも推測するほかない。これらの場合を平均すると、ベイズ誤りはmのr乗の半分に等しくなる。
パネル2は、一つ、四つ、十六のコピーを比較する。これらの曲線は、独立マスキングの下での冗長性を定量化したものであり、訓練済み視覚モデルの振る舞いを表すものではない。マスキング確率が二分の一のとき、四つのコピーは不可避の誤りを三十二分の一まで減らす。コピーが一つなら四分の一である。したがって、同じ全体的なマスキング率であっても、課題情報の分布の仕方によって、根本的に異なる教師信号を生みうる。マスキング率は、適切な難度の学習課題を保証する、どこにでも適用可能な定数として扱うのではなく、意味的冗長性や空間的構成と併せて論じるべきである。
8. 相関するマスクは計算を変える
反復ビットの式は、独立したマスキングに依存する。すべてのコピーが、ブロックマスクで除去される一つの領域内にある場合、それらの消失は完全に相関しうる。すなわち、全コピーを失う確率は、領域の除去確率のr乗ではなく、その除去確率自体に等しくなりうる。マスクが冗長な位置を連動させると、冗長性による大きな数値上の利点は失われる。
この観察は、期待可視面積を一致させたうえで、独立したパッチマスクと空間的に連続したマスクを比較する統制実験を示唆する。平均個数だけを一致させても不十分であり、可視性の同時分布によって、どの関係が観測可能かが変わる。同じ問題は、重要な証拠がクロップ境界の近くや反復する視覚的モチーフの内部にある場合にも生じる。有用な評価は、可視の課題証拠の分布を記録するものであり、実データセットを解釈する前に、既知の因果要因を持つ合成診断課題を使うことが望ましい。この比較案は、特定のマスク系統が優位になると仮定するものではなく、結果を説明するために測定すべき機構を特定するものである。
9. 計算量の削減には分母の明示が必要である
エンコーダがN個のトークンを処理し、一からmを引いた一定の割合を保持する場合、対ごとのアテンションスコア数は、Nの二乗から、Nの二乗に「一からmを引いた値」の二乗を掛けた値へと変化する。これは、割り切れることと、それ以外のアテンション条件が同一であることを仮定した、当該項の演算数の比較である。実時間での速度予測ではない。
射影層、フィードフォワードブロック、デコーダ、データ移動、最適化器の処理、パディングは、それぞれ異なるスケーリングを示しうる。マスクを独立にサンプリングし、可視個数が確率変数となる場合、その二乗の期待値には分散項も含まれる。計算量について主張する際は、固定された可視個数、期待個数による近似、実際の実行トレースのどれを用いるかを明示しなければならない。本稿では、アテンションの式を意図的に固定個数の思考実験に限定する一方、反復ビットの情報計算には独立ベルヌーイマスキングを用いる。これらは別々のモデルである。仮定を明示し続けることで、便利な代数式が、システムについての誤解を招く主張になることを防げる。
10. デコーダの強さは負担の所在を変えうる
強力なデコーダは、エンコーダが粗い情報しか提示しない場合でも、空間的規則性や学習された事前分布を利用しうる。弱いデコーダは、有用な区別を利用可能にするようエンコーダに迫る可能性があるが、転移を改善せずに再構成を制限する可能性もある。いずれの方向も、アーキテクチャの規模だけでは保証されない。
診断では、エンコーダ、可視情報、訓練予算を固定したまま、デコーダ容量を変えるべきである。そのうえで、明示的に定めた読み出しを用いて下流課題を測定すべきである。再構成が改善しても転移が停滞するなら、その改善は広く優れた表現ではなく、デコーダや標的モデリングに由来する可能性がある。画素誤差が悪化しても転移が改善するなら、標的の評価指標が下流の目的外にある細部を重視している可能性がある。これらの結果は矛盾ではない。二つの測定が異なる計算を対象としていることを示している。事前学習後にデコーダを破棄する実験は、破棄される結合システムの質を最終結果として述べるのではなく、保持されるエンコーダを直接評価すべきである。
11. 条件を統制した意味情報の監査
提案する監査では、局所テクスチャの予測可能性と、課題に関連する大域的構造を独立に制御する仕組みを導入すべきである。ガウス分布の構成は前者の原理を厳密に確認し、反復ビットの構成は証拠の消失を厳密に確認する。より大きな合成データセットでは、テクスチャのある背景と、離れた部分間の関係によってラベルが決まる物体を組み合わせることで、マスクの幾何形状と標的損失を独立に操作できるだろう。
その後の実画像評価では、モデルの結果を見る前に選んだ課題を試験すべきである。再構成誤差、欠損内容の予測の較正、下流リスクは分けて報告する必要がある。プローブは訓練データと容量を明示しなければならず、全面的なファインチューニングは、凍結表現を用いることとは異なる介入である。最適化の不確実性を評価する単位は、反復した訓練実行とすべきである。提供する実行可能な例ではニューラルネットワークの訓練を行っておらず、特定のショートカットが実際にどの程度の頻度で現れるかを確立することはできない。その目的は、提案した機構を反証可能にし、どのような追加測定が必要かを明らかにすることである。
12. 正当化可能な再構成についての主張
再構成が科学的に有益になるのは、標的、可視性を生む過程、デコーダがアクセスできる情報、損失をまとめて指定したときである。その結果、システムが定義された条件付き標的を正確に予測する、あるいは明示されたプロトコルの下で、明示された判断へ転移する表現を学習する、という強い主張が可能になる。代理目的を暗黙に理解と呼び替えると、その主張は弱くなる。
具体的に検討した例は、二つの境界を示す。容易な条件付き予測は、意味変数の完全な不在と両立しうる。また、強いマスキングは、判断に必要な証拠をすべて取り除きうる。いずれの境界も、マスク付き事前学習を無効にするものではない。それらは、実証的成功を慎重に解釈する必要がある理由と、転移評価が依然として必要な理由を説明する。生産的な次の一歩は、とくに決定的特徴が小さな領域や通常とは異なる領域を占める課題について、再構成曲線と併せて情報保存の監査を報告することである。これにより、マスク選択は、受け継がれた手順から、表現が何を保持すべきかについての測定可能な仮定へと変わる。
ローカルで実行済み · 範囲を限定
ガウス条件付きリスクとラベルのマスクの全列挙
二次モーメントの代数と、最大八つの反復ビットについてのマスクの全列挙。画像再構成モデルの訓練は行っていない。
1191件のアサーションを通過。 これらの検証が妥当性を確認するのは、提供する例であり、引用したシステムではない。
記録された検証証跡を確認
{
  "gaussian_rho": 0.6,
  "optimal_mse": 0.64,
  "copies": 4,
  "mask_probability": 0.5,
  "label_error": 0.03125,
  "enumerated_copy_counts": [
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ]
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式、明示的な仮定
(1) 二乗可積分なスカラーXと、有限リスクを持つ可測予測器gに対するリスク分解。
(2) |rho| <= 1における同時ガウス分布の例。端点は退化ガウス分布への極限として解釈する。
(3) 等確率のラベルをr個の可視位置に反復し、それぞれを確率mで独立にマスクする。ほかにラベルの証拠はない。
(4) 可視トークン数は固定であり、ベルヌーイマスキングではない。密なアテンションスコアの対の数のみを比較し、デコーダやその他の処理は除外する。
構成した例 · 再現可能なデータ
定量的な論証を確認
これらの曲線は、明示したモデルから計算したものである。引用した研究における観測ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 選択 | 直接変わるもの | 別途必要な測定 |
|---|---|---|
| 画素二乗誤差 | 条件付き平均という標的 | 意味的転移と不確実性 |
| 離散トークン予測 | トークナイザが定める区別 | 標的における欠落とトークナイザの来歴 |
| 独立したパッチマスク | 可視性の同時分布 | 証拠の残存とマスクの相関 |
| エンコーダには可視トークンのみを入力 | エンコーダの演算数 | エンドツーエンドのレイテンシと保持される表現の質 |
検証プロトコルの提案
これは提案する評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証に記録している。
- 欠損標的、デコーダ入力、マスク分布、下流ラベルを指定する。
- ガウス条件付きリスクの恒等式と、反復ビットのベイズ誤りを独立に検証する。
- 期待可視面積を一致させたまま、独立マスキングと連続領域マスキングを変える。
- 課題と無関係な変動の予測可能性を、意味的冗長性とは別に操作する。
- デコーダ容量を変え、事前に指定したプローブで凍結エンコーダを評価する。
- 再構成、転移、計算量の内訳、不確実性を、別々の結果として報告する。
一次資料が確立していること
Pascal Vincent, Hugo Larochelle, Yoshua Bengio et al. · 2008 [1]
貢献。 破損入力からの再構成を用いて表現を学習し、深層アーキテクチャを初期化する。
境界。 その実験は、任意の破損が普遍的に有用であることを確立してはいない。
資料内の該当箇所。 訓練原理と実験の節。
Kaiming He, Xinlei Chen, Saining Xie et al. · 2022 [2]
貢献。 MAEは、可視パッチのエンコーダと再構成デコーダを分離する。
境界。 マスク率と測定された効率は、評価された設定に固有である。
資料内の該当箇所。 要旨とアーキテクチャの記述。
Hangbo Bao, Li Dong, Songhao Piao et al. · 2021 [3]
貢献。 BEiTは、破損した画像パッチから離散的な視覚標的を予測する。
境界。 標的トークナイザは手法の一部である。本総説では改訂版プレプリントを確認している。
資料内の該当箇所。 要旨とマスク付き画像モデリングの記述。
本分析の限界
- 厳密なモデルは、現実的な画像統計ではなく、論理的境界を切り出すものである。
- 二乗誤差は再構成目的の一つにすぎず、知覚損失と尤度損失には別個の分析が必要である。
- MAE、BEiT、ノイズ除去オートエンコーダのベンチマークは再現していない。
- 意味ラベルとその関連性は、あくまで課題の定義であり、ラベルなし再構成損失によって同定される量ではない。
選択した三つの基礎的一次資料に焦点を絞った解析的総説であり、独自の具体例を含む。2026年までの文献を網羅した、あるいは系統的に調査したものではない。資料へのアクセスと版についての注記は、参考文献とともに記録している。
結論を変えうる問い
- 複数の下流課題について、測定可能な証拠残存基準からマスキング方策を選択できるか。
- 有用な転移のうち、どの程度がエンコーダに由来し、どの程度が再構成標的の供給する構造に由来するのか。
- 欠損内容について較正された不確実性と、単にもっともらしい補完とを区別する評価は何か。
参考文献
- Pascal Vincent, Hugo Larochelle, Yoshua Bengio et al.. Extracting and Composing Robust Features with Denoising Autoencoders. Proceedings of the 25th International Conference on Machine Learning (2008). 10.1145/1390156.1390294.
- Kaiming He, Xinlei Chen, Saining Xie et al.. Masked Autoencoders Are Scalable Vision Learners. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (2022). Primary source.
- Hangbo Bao, Li Dong, Songhao Piao et al.. BEiT: BERT Pre-Training of Image Transformers. arXiv (2021). 10.48550/arXiv.2106.08254.
資料[1]へのアクセス。 一次論文のPDF本文と、一次書誌情報の掲載ページを確認した。
版についての注記。 著者がトロントで公開しているPDFを確認した。モントリオールのミラーは自動アクセスを拒否した。
資料[2]へのアクセス。 一次論文のPDF本文と、一次書誌情報の掲載ページを確認した。
資料[3]へのアクセス。 一次論文のPDF本文と、一次書誌情報の掲載ページを確認した。
版についての注記。 この参考文献一覧は、2021年のプレプリント識別子を引用している。確認したPDFおよび掲載ページは、2022年九月3日付の改訂版v2である。会議版と同一であるとは仮定しない。
書誌上の同一性は、出版社と著者の一次記録に照らして確認した。以下の資料アクセスと版に関する注記は確認範囲を示すものであり、全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己査読を行った。参考文献は原研究の研究者を明示している。解析的構成と提案した評価設計は本稿に帰属する。
表紙はImageGenによる概念イラストである。技術的な図は、明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。これらは、導入済み製品の測定や、性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌での採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。