
Resumen
Las redes residuales y las ecuaciones diferenciales neuronales conectan las representaciones aprendidas con la dinámica numérica. La analogía solo resulta productiva cuando se especifican explícitamente la profundidad de capas, el horizonte de integración, el tamaño de paso y la compartición de parámetros. Derivamos ejemplos escalares de estabilidad y error de discretización, y después utilizamos un sistema bidimensional no normal para mostrar por qué los valores propios estables no descartan la amplificación transitoria. Una selección de trabajos primarios sobre aprendizaje residual, arquitecturas estables y ecuaciones diferenciales ordinarias neuronales fundamenta la discusión. El material numérico complementario comprueba la evolución hacia delante y la sensibilidad en pequeños sistemas declarados; no se reproduce ninguna evaluación de referencia de clasificación de imágenes ni de ODE neuronales. Esta perspectiva defiende que, siempre que se interprete la profundidad como tiempo, se comunique evidencia sobre el solucionador y los gradientes junto con la calidad predictiva.
1. La profundidad y el tiempo no son automáticamente lo mismo
Un bloque residual añade un incremento aprendido a su entrada. Llamar a ese incremento un campo vectorial discretizado es una interpretación que introduce decisiones adicionales: un tamaño de paso, un intervalo temporal y una regla que conecte los parámetros entre capas. Una secuencia arbitraria de bloques parametrizados de forma independiente no se convierte en una discretización convergente simplemente porque cada bloque contenga una conexión de atajo identidad.
Dos comparaciones habituales responden a preguntas distintas. Mantener fijo el tamaño de paso mientras se añaden capas alarga el horizonte efectivo. Mantener fijo el horizonte mientras se añaden capas reduce el tamaño de paso. La primera cambia cuánto tiempo evoluciona un proceso dinámico; la segunda puede refinar la aproximación a un proceso fijo. Si el campo vectorial aprendido también cambia con la profundidad, ninguna comparación aísla la resolución numérica. Toda afirmación de que una mayor profundidad mejora la estabilidad debería identificar cuál de estos experimentos describe.
2. La investigación primaria respalda una conexión prudente
He y sus colaboradores desarrollaron el aprendizaje residual para facilitar la optimización de redes profundas de reconocimiento de imágenes. Haber y Ruthotto conectaron el diseño de redes con la estabilidad y con formulaciones dinámicas bien planteadas. Chen y sus colaboradores parametrizaron dinámicas continuas del estado oculto y entrenaron a través de soluciones de ODE. En conjunto, estos trabajos motivan estudiar la propagación hacia delante como un estado que evoluciona.
La analogía no implica que toda ResNet sea un solucionador de ODE con un límite continuo significativo, ni que una ODE estable produzca una discretización estable para cualquier tamaño de paso. Utilizamos tres sistemas pequeños para separar estas cuestiones. Sus parámetros se eligen deliberadamente para permitir un análisis exacto. Las curvas se generan a partir de las ecuaciones indicadas, en lugar de copiarse de las figuras de rendimiento de los artículos. [1], [2], [3]
3. Un sistema continuo estable puede tener una actualización inestable
Considérese dh/dt=-lambda h con lambda>0. La solución exacta multiplica el estado inicial por exp(-lambda T), de modo que las perturbaciones decaen en cualquier horizonte positivo. En cambio, Euler explícito multiplica por 1-lambda Delta en cada paso. Su valor absoluto debe ser inferior a uno para que las actualizaciones repetidas sean contractivas.
Cuando lambda Delta=2, el multiplicador es -1: el estado alterna sin decaer. Por encima de dos, su magnitud crece aunque la ecuación continua sea estable. Por tanto, una vía residual de identidad no garantiza automáticamente una propagación estable; el incremento aprendido debe considerarse junto con su escala. El ejemplo también distingue la oscilación de la divergencia: los multiplicadores entre -1 y cero alternan de signo mientras su magnitud sigue decayendo. Observar únicamente valores ocultos alternantes no demuestra inestabilidad numérica.
4. Refinar la discretización con un horizonte fijo cambia el error de aproximación
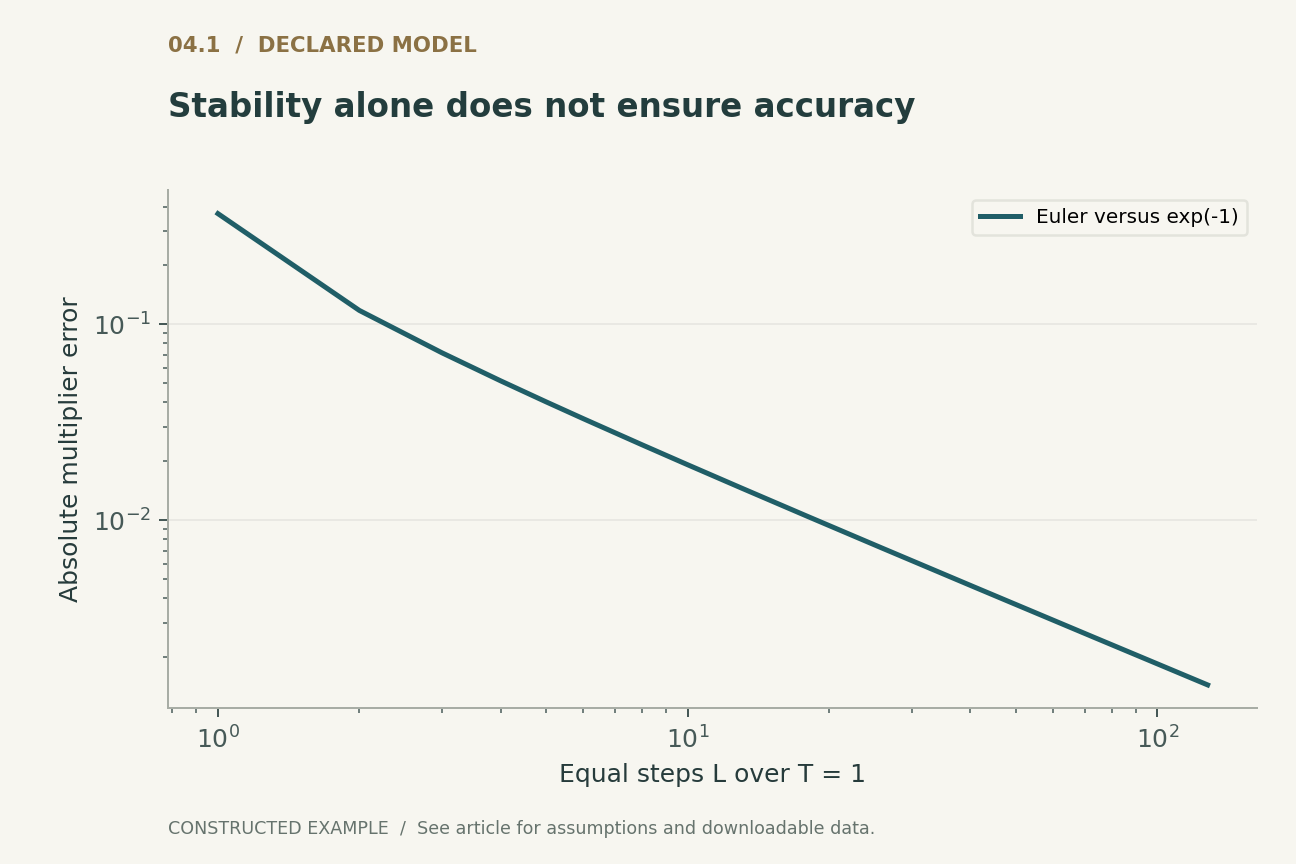
Fijemos lambda=1 y T=1. Con L pasos iguales, Euler explícito da (1-1/L) elevado a L, mientras que el multiplicador exacto es exp(-1). Para L=1, el estado numérico es cero, una pérdida completa del valor exacto no nulo. Para valores mayores de L, el multiplicador numérico se aproxima al exacto desde abajo.
El ejemplo de un solo paso es contractivo, pero inexacto. Muestra por qué la estabilidad y la precisión no deben reducirse a una misma prueba. Un modelo también puede aprender adaptándose a una discretización particular, por lo que cambiar su solucionador después del entrenamiento puede alterar la función representada, incluso si el nuevo solucionador es más preciso para el campo vectorial congelado. Una comparación rigurosa distingue el error de discretización de una dinámica fija de la calidad predictiva obtenida después de entrenar cada arquitectura por separado.
5. La sensibilidad hacia delante es un producto de aplicaciones locales
Para una actualización residual diferenciable, el jacobiano de entrada a salida es un producto de matrices I+Delta J_l a lo largo de la trayectoria. Acotar la norma de cada matriz proporciona una cota superior de la amplificación total, pero esa cota puede ser muy holgada. Los jacobianos locales pueden rotar direcciones, y los productos sucesivos pueden reforzar o cancelar la amplificación.
El gradiente hacia atrás utiliza productos transpuestos de las mismas derivadas locales, por lo que el comportamiento de las perturbaciones hacia delante y la sensibilidad inversa están estrechamente relacionados. Sin embargo, una pérdida escalar puede seleccionar solo un subconjunto de direcciones sensibles. Un gradiente observado pequeño para una pérdida no certifica que toda la aplicación de representación esté bien condicionada. Entre los diagnósticos útiles se encuentran las perturbaciones direccionales, los valores singulares en casos abordables y las comparaciones entre horizontes, en lugar de considerar únicamente la magnitud del gradiente final de entrenamiento.
6. Los valores propios estables pueden ocultar crecimiento transitorio
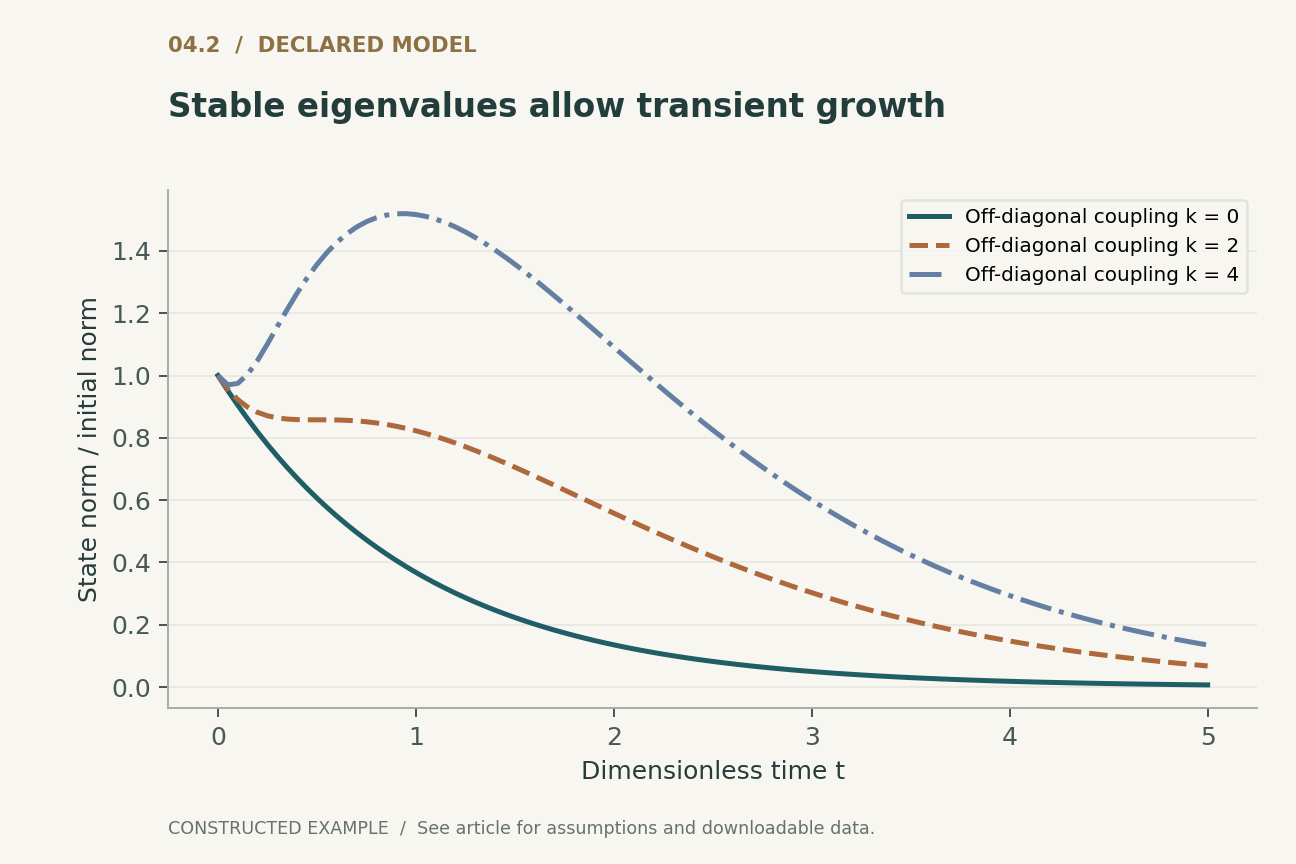
Tomemos A=[[-1,k],[0,-1]] en un sistema lineal continuo. Ambos valores propios son iguales a -1 para cualquier k, pero exp(tA)=exp(-t)[[1,kt],[0,1]]. Partiendo de (0,1), la norma del estado es exp(-t) sqrt(1+k al cuadrado por t al cuadrado). Para k=4, la norma en t=1 supera su valor inicial, aunque finalmente decae.
El mecanismo es una transferencia entre coordenadas antes de que domine la disipación. No contradice la estabilidad asintótica. Es un contraejemplo al uso exclusivo de los signos de los valores propios como garantía frente a la amplificación en un horizonte finito en un sistema no normal. Nuestra segunda figura compara varios valores de k. Sus unidades son la magnitud normalizada del estado y el tiempo adimensional; no estima la sensibilidad de una red entrenada.
7. Las restricciones de estabilidad también limitan la familia de funciones
Restringir un campo vectorial para mejorar la sensibilidad cambia las transformaciones que puede representar. Una contracción puede fusionar representaciones cercanas y suprimir distinciones necesarias para una tarea. A la inversa, una expansión sin restricciones puede ser útil para separar clases, pero puede amplificar el error de entrada. El comportamiento deseado depende de qué direcciones transportan señal y cuáles transportan factores irrelevantes.
Un objetivo de diseño significativo podría preservar las distancias dentro de los subespacios pertinentes para la tarea y amortiguar las demás, pero esos subespacios suelen desconocerse antes del aprendizaje. Por tanto, las cotas uniformes de estabilidad pueden ser conservadoras. La pregunta científica adecuada se refiere al equilibrio entre una respuesta especificada a las perturbaciones y un objetivo predictivo especificado, no a si la arquitectura más contractiva es siempre la mejor. Nuestros ejemplos establecen posibilidades numéricas; no pueden elegir ese equilibrio para una aplicación.
8. El solucionador forma parte del modelo evaluado
Un solucionador adaptativo de ODE elige los puntos de evaluación mediante estimaciones de error y tolerancias. El cálculo que efectivamente realiza puede depender de la entrada y del campo vectorial aprendido. Informar únicamente de una cantidad nominal de capas omite entonces tanto el esfuerzo computacional como la precisión numérica. Una evaluación reproducible debería registrar la familia del solucionador, las tolerancias, el tipo de datos dtype, el horizonte y los recuentos observados de evaluaciones de la función.
El manuscrito de Neural ODE consultado incluye una corrección posterior de una figura de evaluaciones de la función. Esa nota de versión se conserva en esta colección, y aquí no se utiliza ninguna cifra de rendimiento de la figura. La enseñanza más general es que el coste del solucionador debe medirse a partir de la implementación y la versión exactas que se evalúan. Una descripción conceptual de profundidad continua no elimina del predictor real las decisiones sobre precisión finita o flujo de control. [3]
9. La concordancia de los gradientes merece su propia comprobación
Diferenciar un cálculo discretizado y discretizar una ecuación de sensibilidad continua son operaciones relacionadas, pero no tienen por qué producir resultados idénticos con tolerancias finitas. Incluso para la aplicación escalar de Euler, con estado inicial h0=1, la derivada respecto de lambda es -T por (1-lambda T/L) elevado a L-1, mientras que la derivada continua exacta es -T exp(-lambda T). Ambas son correctas para sus respectivas aplicaciones hacia delante.
Por tanto, una comprobación mediante diferencias finitas debe comparar un gradiente con el mismo cálculo hacia delante, no con un solucionador diferente tratado tácitamente como referencia verdadera. Las discontinuidades del solucionador causadas por decisiones adaptativas de paso pueden complicar esa comprobación. Para un diagnóstico controlado, se debe comenzar con dinámicas suaves de paso fijo y añadir después la adaptatividad explícitamente. Hay que informar tanto de las discrepancias predictivas como de las discrepancias de las derivadas al variar las tolerancias, porque una salida precisa por sí sola no establece necesariamente la precisión del gradiente de entrenamiento.
10. Qué establece el material complementario
Los ejemplos ejecutables comparan las potencias de Euler con actualizaciones repetidas directas, verifican la solución escalar continua y muestran el régimen inestable de tamaños de paso. También evalúan la exponencial de la matriz no normal en forma cerrada y comprueban la derivada de pasos finitos frente a diferencias centrales. Son pequeñas pruebas de consistencia numérica con respuestas matemáticas conocidas.
Un experimento neuronal propuesto añadiría campos no lineales aprendidos, múltiples inicializaciones, tareas predictivas reservadas para evaluación y mediciones del coste computacional. Debería conservar los fallos e indicar si un cambio de solucionador se realizó antes o después del entrenamiento. La conclusión defendible del presente trabajo es más limitada: la estructura residual proporciona un lenguaje útil para la dinámica, pero la estabilidad numérica, la sensibilidad transitoria, el error de aproximación y la expresividad para la tarea requieren cada uno evidencia propia. Ninguno se desprende únicamente de dibujar una conexión de atajo identidad.
11. La invertibilidad es otra propiedad independiente
Para la actualización escalar de Euler, lambda Delta=1 lleva cualquier entrada a cero en un solo paso. La aplicación es máximamente contractiva, pero no invertible. En cambio, el flujo escalar exacto en tiempo finito tiene un multiplicador no nulo y es invertible, aunque su inversa puede amplificar gravemente el error numérico cuando la dinámica hacia delante es muy contractiva.
Este ejemplo distingue la invertibilidad matemática de la reconstrucción estable. Un flujo continuo puede tener una inversa única en aritmética exacta mientras que la integración hacia atrás se vuelve sensible a errores de redondeo o aproximación. Si un método de entrenamiento depende de reconstruir estados anteriores, una comprobación útil compara los estados reconstruidos con los estados almacenados de la evolución hacia delante en todo el intervalo de tolerancias declarado. Observar simplemente que el solucionador hacia atrás termina correctamente no demuestra que la trayectoria reconstruida coincida con la que produjo la pérdida.
12. Compare horizontes antes de comparar cantidades de capas
Una red con el doble de bloques residuales puede utilizar el mismo tamaño de paso sobre el doble de horizonte, la mitad del tamaño de paso sobre el horizonte original, o una secuencia aprendida de forma independiente sin un campo fijo. Estas alternativas tienen soluciones de referencia distintas. Un estudio de ablación reproducible debería registrar la comparación pretendida e incluir un control con el campo congelado; de lo contrario, una afirmación de refinamiento numérico podría estar midiendo en realidad una transformación distinta o un presupuesto de parámetros diferente.
Ejecutado localmente · Alcance limitado
Estabilidad discreta, sensibilidad y crecimiento transitorio
24 casos escalares de Euler con sensibilidades calculadas por recurrencia y diferencias finitas, además de ejemplos explícitos de inestabilidad, no invertibilidad y no normalidad. No es una evaluación de referencia de redes residuales.
Se superaron 51 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testimonio registrado
{
  "general_initial_state": 1.7,
  "non_normal_norm_t1_k4": 1.5168057934430552
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Actualización residual interpretada con tamaño de paso y horizonte explícitos; un límite continuo exige supuestos adicionales de regularidad y consistencia de parámetros.
(2) Decaimiento escalar y Euler explícito; la contracción no equivale a la precisión de aproximación.
(3) Producto ordenado de jacobianos a lo largo de la trayectoria calculada; el orden importa para las matrices.
(4) Ejemplo no normal resoluble exactamente, con valores propios estables y posible amplificación transitoria.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Propiedad | Una comprobación adecuada | Un sustituto engañoso |
|---|---|---|
| Estabilidad discreta | Análisis del tamaño de paso y del jacobiano | Solo valores propios estables del sistema continuo |
| Precisión de aproximación | Refinamiento con campo fijo frente a una referencia | Una actualización contractiva |
| Consistencia del gradiente | Diferencias finitas del mismo cálculo hacia delante | Una pérdida de entrenamiento pequeña |
| Reconstrucción | Comparar estados almacenados y reconstruidos | Terminación correcta del solucionador inverso |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna evaluación de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Declarar si la profundidad cambia el horizonte, la resolución o el campo aprendido.
- Reproducir ejemplos escalares de tamaños de paso estables, marginales e inestables.
- Comprobar las sensibilidades hacia delante utilizando varias direcciones y horizontes finitos.
- Comparar los gradientes con la misma discretización hacia delante.
- Registrar el solucionador, dtype, las tolerancias, las versiones y las evaluaciones de la función.
- Evaluar la calidad predictiva y el coste computacional mediante comparaciones con entrenamiento por separado y con el campo congelado.
Qué establecen las fuentes primarias
Kaiming He, Xiangyu Zhang, Shaoqing Ren et al. · 2015 [1]
Contribución. Introduce el aprendizaje residual para redes profundas de reconocimiento de imágenes.
Límite. El éxito empírico no certifica la estabilidad de todas las actualizaciones residuales.
Localización en la fuente. Resumen del manuscrito de los autores y formulación del aprendizaje residual; la página de CVF no estuvo disponible durante esta comprobación.
Eldad Haber, Lars Ruthotto · 2017 [2]
Contribución. Utiliza la estabilidad dinámica para orientar el diseño de arquitecturas de redes profundas.
Límite. Las restricciones de estabilidad también limitan las transformaciones admisibles.
Localización en la fuente. Resumen del manuscrito de los autores y formulación de sistemas dinámicos.
Ricky T. Q. Chen, Yulia Rubanova, Jesse Bettencourt et al. · 2018 [3]
Contribución. Introduce dinámicas aprendidas de profundidad continua y la diferenciación a través de soluciones de ODE.
Límite. Las tolerancias finitas, el comportamiento del solucionador y la reconstrucción de trayectorias siguen siendo pertinentes.
Localización en la fuente. Secciones 1, 2 y 6; la versión v6 de arXiv consultada señala la corrección de una figura de evaluaciones de la función.
Límites de este análisis
- Los ejemplos son sistemas lineales de dimensión finita, no redes residuales entrenadas.
- La sensibilidad en forma cerrada no cuantifica la robustez de un clasificador realista.
- No se reprodujo ninguna evaluación de referencia del rendimiento de solucionadores o hardware.
- Las conclusiones sobre profundidad infinita o tiempo continuo exigen supuestos que van más allá de una conexión residual.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto a la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué métrica de sensibilidad en horizonte finito predice mejor los fallos de entrenamiento en dinámicas aprendidas no normales?
- ¿Qué proporción del cambio predictivo tras refinar el solucionador refleja una dependencia de la discretización adquirida durante el entrenamiento?
- ¿Puede un modelo preservar las distinciones pertinentes para la tarea mientras impone cotas útiles de estabilidad direccional?
Referencias
- Kaiming He, Xiangyu Zhang, Shaoqing Ren et al.. Deep Residual Learning for Image Recognition. arXiv:1512.03385 (2015). 10.48550/arXiv.1512.03385.
- Eldad Haber, Lars Ruthotto. Stable Architectures for Deep Neural Networks. arXiv:1705.03341 (2017). 10.48550/arXiv.1705.03341.
- Ricky T. Q. Chen, Yulia Rubanova, Jesse Bettencourt et al.. Neural Ordinary Differential Equations. arXiv:1806.07366 (2018). 10.48550/arXiv.1806.07366.
Acceso a la fuente [1]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Nota de versión. Se cita explícitamente el informe técnico de los autores de 2015. La página editorial de CVPR 2016 devolvió HTTP 403 durante esta comprobación; no se afirma haber accedido al texto editorial completo.
Acceso a la fuente [2]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Nota de versión. Registro presentado por primera vez en 2017; se inspeccionó v3 (16 de febrero de 2019). El registro enlaza el DOI de la publicación en Inverse Problems 10.1088/1361-6420/aa9a90; esta entrada identifica el manuscrito de los autores.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y la introducción, la ecuación y la estructura de limitaciones del HTML de los autores; no se reprodujo por completo el rendimiento del solucionador.
Nota de versión. Presentado por primera vez en 2018; se inspeccionó v6, fechada el 9 de octubre de 2026, que informa de una corrección de los recuentos de evaluaciones de la función en la figura 3c y de correcciones de erratas. No se reproduce ningún recuento empírico de esa figura.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas de acceso a las fuentes y versiones que aparecen a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y revisado técnicamente por el propio Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni evaluaciones de referencia de rendimiento reproducidas.
Este borrador local no cuenta con un registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance limitado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.