
Resumen
La normalización es más que una conveniencia numérica. Sus ejes de reducción definen una transformación de la información, su constante estabilizadora limita la invariancia exacta de escala y sus estadísticas de entrenamiento pueden acoplar las predicciones entre ejemplos. Comparamos la normalización por lotes y la normalización por capas mediante construcciones explícitas de dos ejemplos y de dimensión finita. Un cálculo del jacobiano separa una dirección de la media que se elimina de una dirección radial que se suprime, mientras que un contraejemplo muestra cómo cambia el valor normalizado por lotes de una muestra cuando cambian sus acompañantes. La discusión utiliza trabajos fundacionales sobre normalización como referentes históricos y técnicos, y después desarrolla un análisis algebraico reproducible de forma independiente en lugar de repetir afirmaciones sobre pruebas de rendimiento. El resultado es un marco práctico para diagnosticar las elecciones de normalización sin atribuir toda mejora del entrenamiento a una única explicación causal.
1. Una capa de normalización es una especificación
Para especificar una normalización, se deben indicar la forma del tensor, los ejes de reducción, la convención de varianza, la constante estabilizadora, los parámetros afines y el comportamiento durante el entrenamiento frente a la inferencia. Una fórmula expresada únicamente como restar la media y dividir por la desviación estándar omite la mayor parte de esa especificación. Dos implementaciones pueden compartir la fórmula y, aun así, representar funciones distintas porque promedian sobre coordenadas diferentes.
Esto importa tanto científica como operativamente. Un eje que abarca varios ejemplos introduce dependencia respecto de la composición del lote; un eje dentro de un ejemplo no introduce esa dependencia concreta. Una normalización puede borrar un desplazamiento común irrelevante para la tarea, o borrar uno que contenga la información objetivo. Por tanto, la pregunta pertinente no es si la normalización resulta beneficiosa en general, sino qué transformaciones deben dejar inalterada una representación y qué información debe seguir siendo recuperable.
2. Las afirmaciones históricas deben seguir siendo distinguibles
Ioffe y Szegedy introdujeron la normalización por lotes y la motivaron mediante los cambios en las distribuciones de las activaciones internas. Ba, Kiros y Hinton introdujeron la normalización por capas utilizando estadísticas dentro de un caso de entrenamiento. Santurkar y sus colegas sostuvieron que los beneficios de la normalización por lotes para la optimización se explican mejor mediante un comportamiento de optimización más suave que mediante la estabilidad de las distribuciones por sí sola.
Estos trabajos establecen métodos y énfasis explicativos contrapuestos, no una explicación causal universal para cualquier arquitectura. No reproducimos los resultados de velocidad o precisión que comunicaron. En su lugar, preguntamos qué se deduce exactamente de la aplicación de normalización. Estas identidades siguen siendo examinables incluso cuando las explicaciones empíricas contrapuestas no se han resuelto. También indican qué intervenciones necesitaría un experimento antes de atribuir una mejora observada a la invariancia, el condicionamiento, la estocasticidad o un cambio en la tasa de aprendizaje efectiva. [1], [2], [3]
3. El centrado elimina una dirección
Para un vector de dimensión d, restar la media de sus coordenadas aplica la proyección P=I-11 transpuesta/d. El vector de unos pertenece a su espacio nulo. Por tanto, x y x+b1 tienen representaciones centradas idénticas para cualquier escalar b. Una ganancia y un sesgo afines posteriores, aplicados coordenada a coordenada, no pueden recuperar un b específico de la muestra a partir de una entrada normalizada idéntica.
Un ejemplo concreto es x=(1,2,4) y x+10=(11,12,14). Una capa que solo recibe sus formas normalizadas no puede distinguir sus niveles globales. Esto es adecuado si el nivel es un factor perturbador, pero inadecuado si la etiqueta está determinada por ese nivel y ninguna otra vía lo preserva. Las conexiones residuales o las características adicionales sin normalizar pueden cambiar la situación informativa. La conclusión se refiere a la transformación aislada, no a una red completa que pueda eludirla.
4. La constante estabilizadora hace que la invariancia de escala sea aproximada
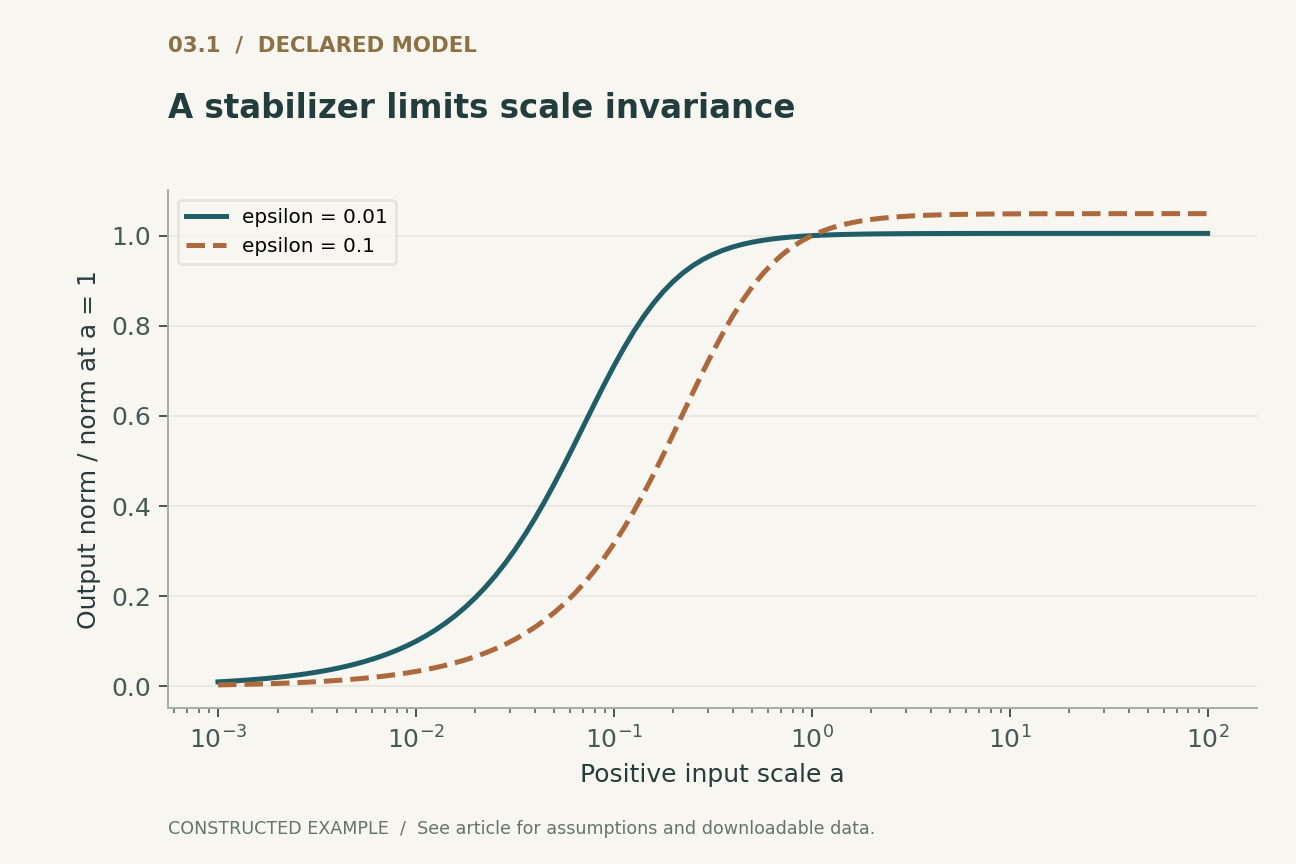
Tras el centrado, sea v la media de los cuadrados de los valores de las coordenadas y defínase el denominador como sqrt(v+epsilon). Para una escala positiva a, el resultado normalizado es el vector centrado multiplicado por a y dividido por sqrt(a al cuadrado v+epsilon). Si epsilon es cero y v es positivo, a se cancela exactamente. Si epsilon es positivo, la cancelación es incompleta.
Para valores muy pequeños de a, epsilon domina el denominador y la amplitud de la salida disminuye hacia cero. Para valores grandes de a, la representación normalizada se aproxima a su límite invariante de escala. El escalado negativo también invierte el signo del vector centrado, por lo que no debe describirse como invariancia frente a cualquier escalado no nulo. Nuestra primera figura calcula esta transición para una varianza fija y dos constantes estabilizadoras. Es una curva matemática de sensibilidad, no una comparación de valores predeterminados de distintos marcos de trabajo.
5. El jacobiano separa dos direcciones suprimidas
Escribamos c=Px y s=sqrt(cᵀ c/d+epsilon). La diferenciación da J=P/s-ccᵀ/(d·s·s·s). La dirección del desplazamiento común tiene autovalor cero. En la dirección radial centrada c, el autovalor es epsilon/(s·s·s). Las direcciones ortogonales tanto a c como al vector de unos tienen autovalor 1/s.
Esta descomposición resulta útil porque distingue una dirección eliminada estructuralmente de otra suprimida por la constante estabilizadora y la magnitud de la señal. Con epsilon=0 y varianza no nula, la dirección radial también desaparece localmente: desplazarse únicamente mediante un escalado positivo no cambia la salida. Con epsilon>0, sigue siendo débilmente observable. La comprobación complementaria compara este jacobiano analítico con diferencias finitas centrales lejos del caso singular de varianza cero y verifica sus relaciones de autovalores y autovectores.
6. Un lote puede cambiar la salida de un ejemplo
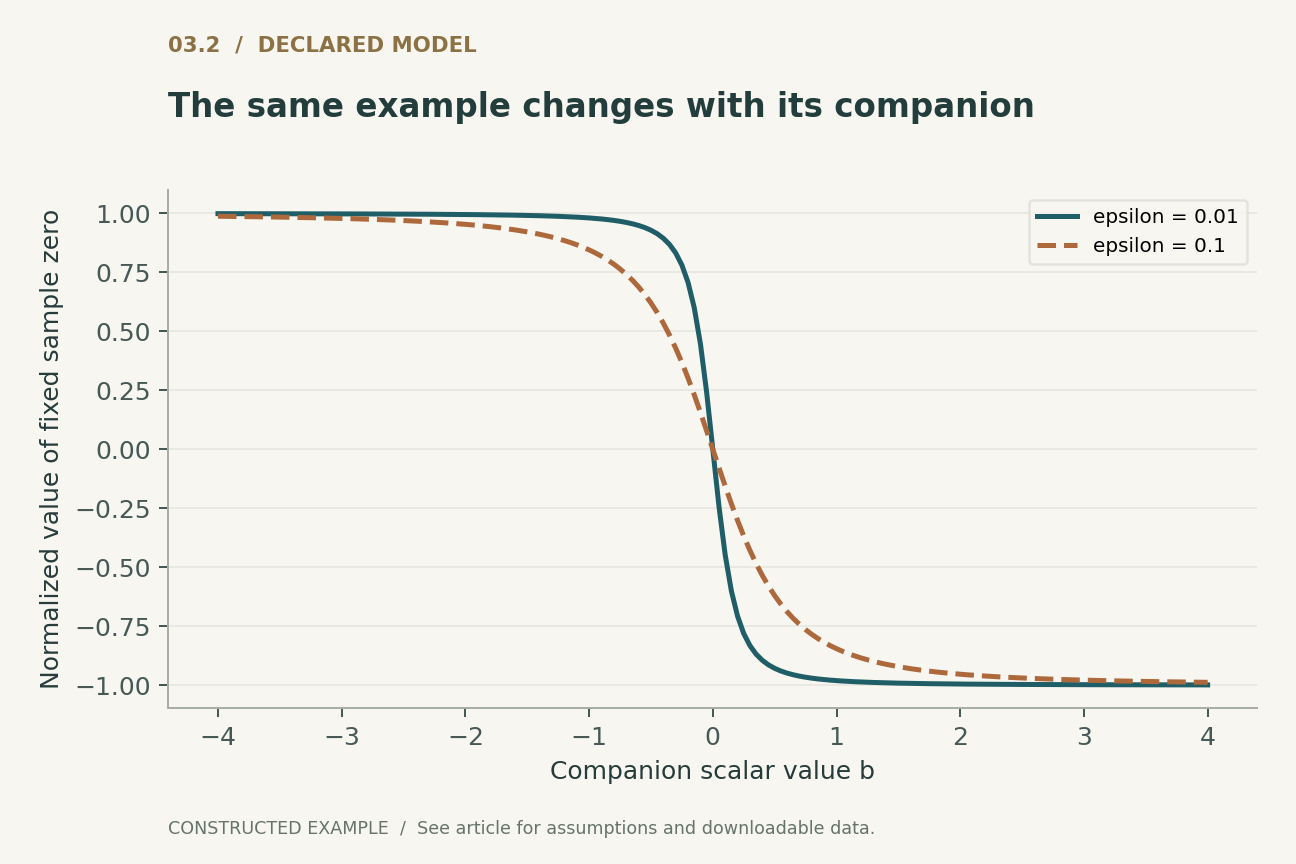
Consideremos una característica escalar y un lote con valores (0,2). Con varianza poblacional y una constante estabilizadora pequeña, el valor normalizado del primer ejemplo es cercano a -1. Sustituyamos el segundo valor por -2 manteniendo el primero en cero; el primer valor normalizado pasa a ser cercano a +1. La primera muestra no ha cambiado y, sin embargo, su representación en modo de entrenamiento invierte el signo.
Esto no es un error aritmético. Se deriva del uso de estadísticas compartidas por el lote. También significa que un experimento que cambia la composición del lote mientras afirma que el modelo no ha cambiado ha alterado la función evaluada en esa muestra. Los ejemplos repetidos o correlacionados pueden alterar aún más las estadísticas. Una evaluación rigurosa debe especificar si las estadísticas se recalculan, se congelan, se sincronizan entre dispositivos o se acumulan mediante otra regla declarada.
7. Las estadísticas de inferencia introducen un estado adicional
Si la inferencia utiliza medias y varianzas almacenadas, el modelo incluye esas cantidades almacenadas como estado. Guardar únicamente los parámetros afines aprendidos resulta entonces insuficiente para reproducir las predicciones. Las estadísticas acumuladas estimadas sobre una distribución pueden producir salidas desplazadas sistemáticamente en otra. Recalcular las estadísticas durante el despliegue, en cambio, modifica el protocolo de evaluación y puede acoplar las predicciones entre usuarios o solicitudes.
Un diagnóstico sencillo mantiene fijos los pesos aprendidos y evalúa una entrada elegida bajo dos conjuntos explícitos de estadísticas. La diferencia observada mide la sensibilidad a ese estado, no necesariamente un fallo del aprendizaje de representaciones. Cualquier adaptación de las estadísticas almacenadas debe utilizar un conjunto de datos autorizado con un proceso de selección declarado y compararse con una referencia congelada. Las etiquetas de prueba no deben influir de forma encubierta en esa adaptación. Esto separa la adaptación legítima durante el despliegue de la fuga de información en la evaluación.
8. La simetría de escala cambia el significado del tamaño de los parámetros
Supongamos que un vector de pesos de una etapa anterior solo aparece a través de una aplicación normalizada exactamente invariante de escala. Multiplicarlo por una constante positiva puede dejar las predicciones inalteradas y, al mismo tiempo, cambiar su norma euclídea y la magnitud de su gradiente respecto de los parámetros. Por tanto, el modelo funcional y su representación en coordenadas tienen nociones distintas de distancia.
Esta observación explica por qué la magnitud de los pesos por sí sola es un mal indicador diagnóstico de la complejidad funcional en un componente así. También significa que una penalización sobre la norma de los parámetros puede influir en la optimización incluso cuando el reescalado apenas cambia las predicciones. La relación exacta depende de la constante estabilizadora, los parámetros afines, las vías de derivación y el optimizador. Por ello, evitamos afirmar que un ajuste particular del decaimiento de pesos tiene una interpretación universal. Un estudio controlado debe examinar por separado los cambios funcionales y los cambios de parámetros, en lugar de tratar cualquiera de ellos como un sustituto completo del otro.
9. Una comparación causal requiere más que una sustitución
Sustituir la normalización por lotes por la normalización por capas cambia simultáneamente los ejes de reducción, el acoplamiento entre ejemplos, las posibles invariancias, el estado almacenado y, a veces, la difusión de parámetros. Si el rendimiento cambia, la sustitución no identifica qué mecanismo causó la diferencia. Igualar únicamente el número de parámetros entrenables es insuficiente.
Una comparación más informativa manipularía una propiedad cada vez cuando fuera factible: congelar las estadísticas, alterar la composición del lote manteniendo fijos los ejemplos, variar epsilon en un intervalo justificado o preservar una característica de nivel sin normalizar mediante una vía independiente. Estas intervenciones deben acompañarse de resultados específicos de la tarea y diagnósticos de optimización. Si una intervención cambia tanto la escala del gradiente como la disponibilidad de información, deben medirse ambos cambios. Este diseño requiere más trabajo que sustituir un componente, pero produce una conclusión capaz de resistir explicaciones alternativas.
10. Qué establecen realmente las figuras y las pruebas
Las gráficas suministradas muestran la sensibilidad al escalado positivo y la dependencia entre ejemplos de una normalización de dos muestras. Las pruebas verifican la invariancia frente a desplazamientos, la respuesta radial dependiente de epsilon, el jacobiano frente a diferencias finitas y la inversión de signo al cambiar la muestra acompañante del lote. Todas las entradas, convenciones de varianza, constantes estabilizadoras y tolerancias numéricas son explícitas.
Estas comprobaciones establecen propiedades de las aplicaciones finitas declaradas. No determinan la mejor normalización para un modelo de lenguaje o un clasificador de imágenes. El valor científico reside en separar el álgebra exacta de la selección empírica de arquitecturas. Una vez comprendida la aplicación, un estudio real de entrenamiento puede preguntar si sus invariancias se ajustan a la tarea y si su comportamiento numérico mejora un compromiso especificado entre recursos y calidad. Sin esa separación, la palabra normalización puede ocultar varias explicaciones incompatibles para un mismo resultado observado.
11. Una secuencia práctica de diagnóstico
Cuando el entrenamiento se vuelva inestable tras un cambio de normalización, verifique primero los ejes y el comportamiento de difusión en un tensor diminuto calculable a mano. Después compare los modos de entrenamiento y evaluación utilizando entradas idénticas y un estado capturado explícitamente. Luego examine la distribución de los denominadores, especialmente cerca de la varianza cero, antes de cambiar la tasa de aprendizaje.
Este orden importa porque una constante estabilizadora numérica puede ocultar un error de eje al impedir la división por cero, sin corregir el error semántico. Del mismo modo, una pasada hacia delante satisfactoria dice poco sobre el condicionamiento de las derivadas. Una comprobación por diferencias finitas con una entrada pequeña y suave aporta evidencia económica sobre la coherencia de la implementación. Debe complementarse con pruebas con entradas constantes y varianzas muy pequeñas, donde el comportamiento esperado debe seguir la convención declarada para epsilon en lugar de suponer una invariancia exacta.
12. La precisión forma parte de la especificación
Un denominador matemáticamente positivo puede seguir representándose de forma inexacta con precisión finita. Restar una media grande de coordenadas casi constantes puede reducir la exactitud relativa, y acumular desviaciones al cuadrado en un tipo de datos de poca precisión puede alterar la varianza. Estas son cuestiones de implementación que van más allá de nuestros ejemplos con float64. Una prueba de despliegue debe registrar la precisión de acumulación y comparar entradas de varianza pequeña con una referencia de mayor precisión antes de interpretar una discrepancia como una propiedad de la propia normalización.
Ejecutado localmente · Alcance acotado
Comprobaciones de invariancia de la normalización y del jacobiano
Normalización tridimensional y normalización por lotes de dos muestras con varianza poblacional y epsilon declarados; excluye el entrenamiento de redes y la implementación con precisión mixta.
Se superaron 10 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar la evidencia registrada
{
  "jacobian": [
    [
      0.23993835872757036,
      -0.3286112304312372,
      0.08867287170366717
    ],
    [
      -0.3286112304312372,
      0.5007409225618855,
      -0.17212969213064816
    ],
    [
      0.08867287170366717,
      -0.17212969213064816,
      0.08345682042698094
    ]
  ],
  "max_finite_difference_error": 1.384497516632166e-10,
  "companion_outputs": [
    -0.9950371902099893,
    0.9950371902099893
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Normalización de coordenadas por ejemplo antes de la ganancia y el sesgo aprendidos; d>=2.
(2) La invariancia frente a desplazamientos es exacta; la invariancia frente a escalado positivo requiere epsilon=0 y v>0.
(3) Jacobiano para epsilon>0; s al cuadrado es igual a v+epsilon.
(4) Primer ejemplo de un lote de dos escalares con varianza poblacional y sin transformación afín.
Ejemplos construidos · Datos reproducibles
Examinar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones procedentes de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Elección | Efecto estructural exacto | Diagnóstico necesario |
|---|---|---|
| Centrado dentro del ejemplo | Elimina el desplazamiento compartido | Información de la tarea en el nivel global |
| Estadísticas entre ejemplos | Acopla los miembros del lote | Sensibilidad a la composición del lote |
| Epsilon positivo | Regulariza la varianza baja | Dependencia de escala y magnitud de las derivadas |
Propuesta de protocolo de validación
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado están documentados en las comprobaciones ejecutables.
- Especificar las dimensiones del tensor, los ejes, el denominador de la varianza, epsilon y la difusión afín.
- Verificar la transformación en un tensor calculable a mano.
- Comparar los jacobianos analíticos y por diferencias finitas lejos de los casos singulares.
- Variar los acompañantes del lote manteniendo fijo el ejemplo objetivo.
- Capturar las estadísticas de inferencia almacenadas y probar explícitamente las transiciones entre modos.
- Declarar de antemano las intervenciones específicas de la tarea antes de atribuir cambios de precisión o velocidad.
Qué establecen las fuentes primarias
Sergey Ioffe, Christian Szegedy · 2015 [1]
Contribución. Introduce la normalización por lotes con estadísticas de minilotes y parámetros afines aprendidos.
Límite. Su motivación histórica no es una explicación causal universal de todos los beneficios observados.
Localización en la fuente. Resumen de la fuente primaria en PMLR y formulación de la normalización.
Jimmy Lei Ba, Jamie Ryan Kiros, Geoffrey E. Hinton · 2016 [2]
Contribución. Introduce la normalización mediante estadísticas dentro de un caso de entrenamiento.
Límite. Los ejes dentro del ejemplo difieren de las estadísticas calculadas sobre el lote y de sus dependencias.
Localización en la fuente. Resumen del manuscrito de los autores y definición de normalización por capas.
Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas et al. · 2018 [3]
Contribución. Estudia la suavidad de la optimización como explicación de los beneficios de la normalización por lotes.
Límite. El argumento no hace que todas las elecciones de normalización o todas las redes sean igual de suaves.
Localización en la fuente. Resumen del manuscrito de los autores y planteamiento de la optimización.
Límites de este análisis
- El análisis algebraico aísla la normalización y excluye una red residual completa.
- No se ejecutó ninguna prueba de rendimiento de velocidad de entrenamiento o precisión.
- Las diferencias finitas son comprobaciones de coherencia basadas en tolerancias, no una demostración simbólica.
- Los ejes y las estadísticas predeterminados específicos de cada marco de trabajo deben comprobarse por separado.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre el acceso a las fuentes y sus versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué señales pertinentes para la tarea elimina un eje de reducción propuesto?
- ¿Cuánto error durante el despliegue procede del estado estadístico almacenado y no de los pesos aprendidos?
- ¿Pueden las intervenciones separar la eliminación de información de la mejora del condicionamiento de la optimización?
Referencias
- Sergey Ioffe, Christian Szegedy. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. Proceedings of the 32nd International Conference on Machine Learning, PMLR 37 (2015). Primary source.
- Jimmy Lei Ba, Jamie Ryan Kiros, Geoffrey E. Hinton. Layer Normalization. arXiv:1607.06450 (2016). 10.48550/arXiv.1607.06450.
- Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas et al.. How Does Batch Normalization Help Optimization?. arXiv:1805.11604 (2018). 10.48550/arXiv.1805.11604.
Acceso a la fuente [1]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Nota de versión. Registro enviado por primera vez en 2018; se inspeccionó la v5 (15 de abril de 2019). El registro primario menciona NeurIPS 2018; esta bibliografía identifica el manuscrito de los autores.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas de acceso y versión que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, con Python y CSV suministrados. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene un registro de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.