
要旨
正規化は単なる数値計算上の便宜ではない。その縮約軸は情報の変換を定義し、安定化定数は厳密なスケール不変性を制限し、学習時の統計量は事例間で予測を結合しうる。本稿では、二つの事例を用いた明示的な構成と有限次元の構成を通じて、バッチ正規化と層正規化を比較する。ヤコビアンの計算により、除去される平均方向と抑制される動径方向を区別し、反例により、同じバッチに属する他の標本が変わると一つの標本のバッチ正規化後の値がどう変わるかを示す。議論は正規化の基礎的論文を歴史的・技術的な拠り所とし、その後、ベンチマークに関する主張を繰り返すのではなく、独立に再現可能な代数的議論を展開する。その結果、学習の改善をすべて単一の因果的説明に帰することなく、正規化の選択を診断するための実践的な枠組みが得られる。
1. 正規化層は一つの仕様である
正規化を仕様として定めるには、テンソルの形状、縮約軸、分散の計算規約、安定化定数、アフィン変換のパラメータ、学習時と推論時の挙動を明示しなければならない。単に平均を引いて標準偏差で割るとだけ記した式では、その仕様の大半が欠落する。二つの実装が同じ式を共有していても、異なる座標にわたって平均を取れば、異なる関数を表すことがある。
これは運用面だけでなく科学的にも重要である。事例をまたぐ軸はバッチ構成への依存を導入するが、事例内の軸はその特定の依存を導入しない。正規化は、タスクに無関係な共通オフセットを消すことも、目的変数の情報を担っていたオフセットを消すこともある。したがって重要な問いは、正規化が一般に有益かどうかではなく、どの変換に対して表現が変わらないべきか、そしてどの情報が復元可能なまま保持されなければならないかである。
2. 歴史的な主張は区別できる状態に保つべきである
IoffeとSzegedyはバッチ正規化を導入し、内部活性値の分布が変化することをその動機として挙げた。Ba、Kiros、Hintonは、学習事例内の統計量を用いる層正規化を導入した。Santurkarらは、バッチ正規化の最適化上の利点は、分布の安定性だけよりも、より滑らかな最適化挙動によって適切に説明されると論じた。
これらの論文が確立するのは手法と競合する説明上の重点であり、あらゆるアーキテクチャに対する普遍的な因果的説明ではない。本稿は、各論文で報告された速度や精度の結果を再現するものではない。その代わりに、正規化写像から厳密に何が導かれるかを問う。競合する経験的説明が未解決であっても、このような恒等関係は検討可能である。また、観測された改善を不変性、数値的な条件の良さ、確率性、あるいは実効学習率の変化に帰する前に、実験でどのような介入が必要かも示している。 [1], [2], [3]
3. 中心化は一つの方向を除去する
d次元ベクトルについて、その座標平均を引く操作は、射影 P=I-11ᵀ/d を適用することに相当する。全成分が一のベクトルはその零空間に属する。したがって、任意のスカラーbに対して、xとx+b1の中心化後の表現は同一になる。後段で座標ごとにアフィン変換のゲインとバイアスを適用しても、同一の正規化入力から標本固有のbを復元することはできない。
具体例はx=(1,2,4)とx+10=(11,12,14)である。これらの正規化後の形だけを受け取る層は、全体的な水準を区別できない。水準が不要な変動要因であればこれは適切だが、ラベルがその水準によって決まり、ほかにそれを保存する経路がない場合には不適切である。残差接続や追加の非正規化特徴があれば、情報に関する状況は変わりうる。この結論が対象とするのは単独の変換であり、それを迂回する経路を持ちうるネットワーク全体ではない。
4. 安定化定数によりスケール不変性は近似的になる
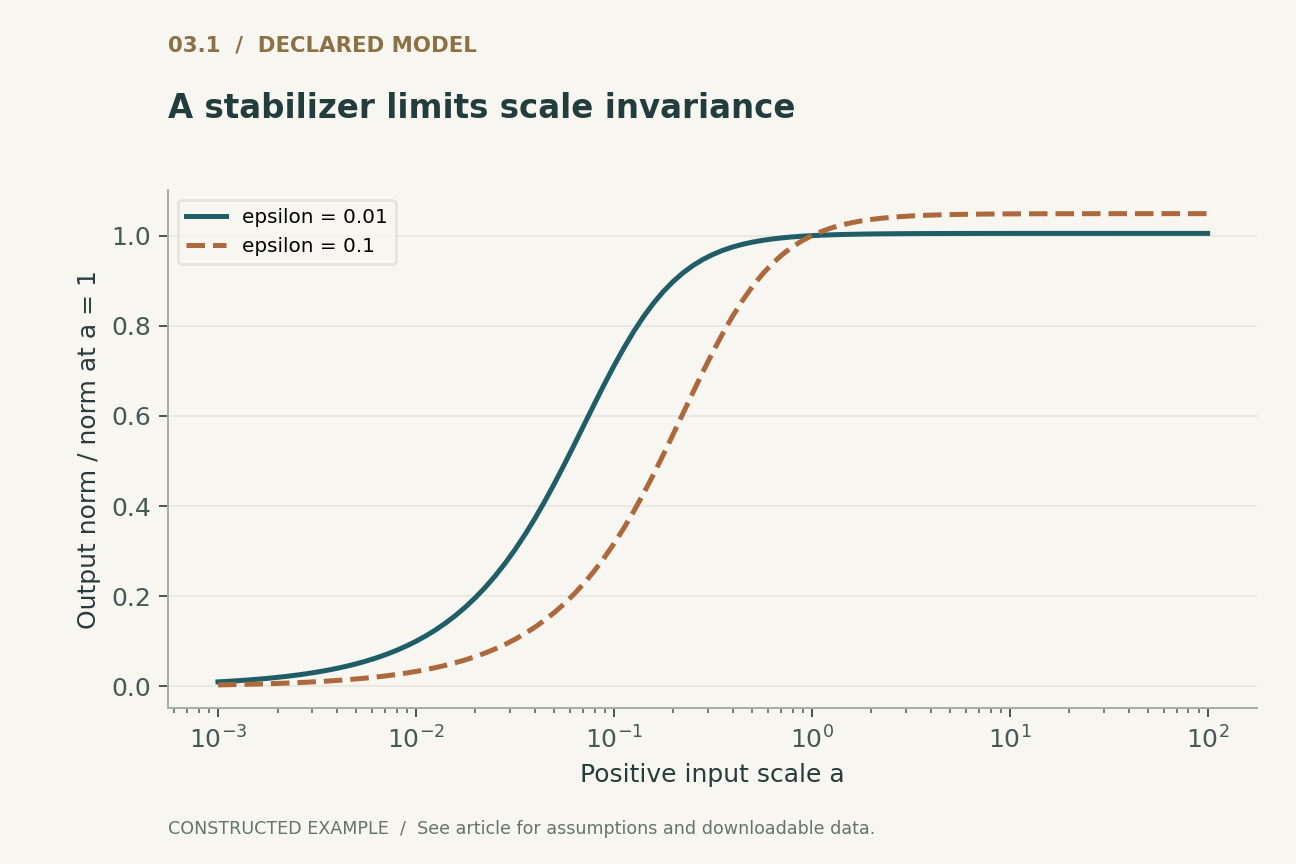
中心化後の座標値の二乗平均をvとし、分母をsqrt(v+epsilon)と定義する。正のスケールaに対して、正規化結果は中心化ベクトルをa倍し、sqrt(aの二乗 v+epsilon)で割ったものである。epsilonがゼロでvが正なら、aは厳密に相殺される。epsilonが正なら、相殺は不完全である。
aが非常に小さいと、分母はepsilonに支配され、出力の振幅はゼロに向かって減少する。aが大きいと、正規化表現はスケール不変な極限に近づく。負のスケーリングでは中心化ベクトルの符号も反転するため、任意の非ゼロのスケーリングに対する不変性と表現すべきではない。最初の図では、固定した分散と二つの安定化定数についてこの遷移を計算する。これは数学的な感度曲線であり、フレームワークの既定値の比較ではない。
5. ヤコビアンは抑制される二つの方向を分離する
c=Pxおよびs=sqrt(cᵀ c/d+epsilon)と書く。微分するとJ=P/s-ccᵀ/(d·s·s·s)が得られる。共通オフセット方向の固有値はゼロである。中心化された動径方向cに沿う固有値はepsilon/(s·s·s)である。cと全成分が一のベクトルの両方に直交する方向の固有値は1/sである。
この分解は、構造的に除去される方向と、安定化定数および信号の大きさによって抑制される方向を区別できるため有用である。epsilon=0で分散が非ゼロの場合、動径方向も局所的に消失する。すなわち、正のスケールに沿ってのみ動いても出力は変化しない。epsilon>0では、この方向は弱く観測可能なまま残る。付随する検査では、分散がゼロとなる特異な場合を避けて、この解析的ヤコビアンを中心有限差分と比較し、その固有値・固有ベクトルの関係を検証する。
6. バッチは一つの事例の出力を変えうる
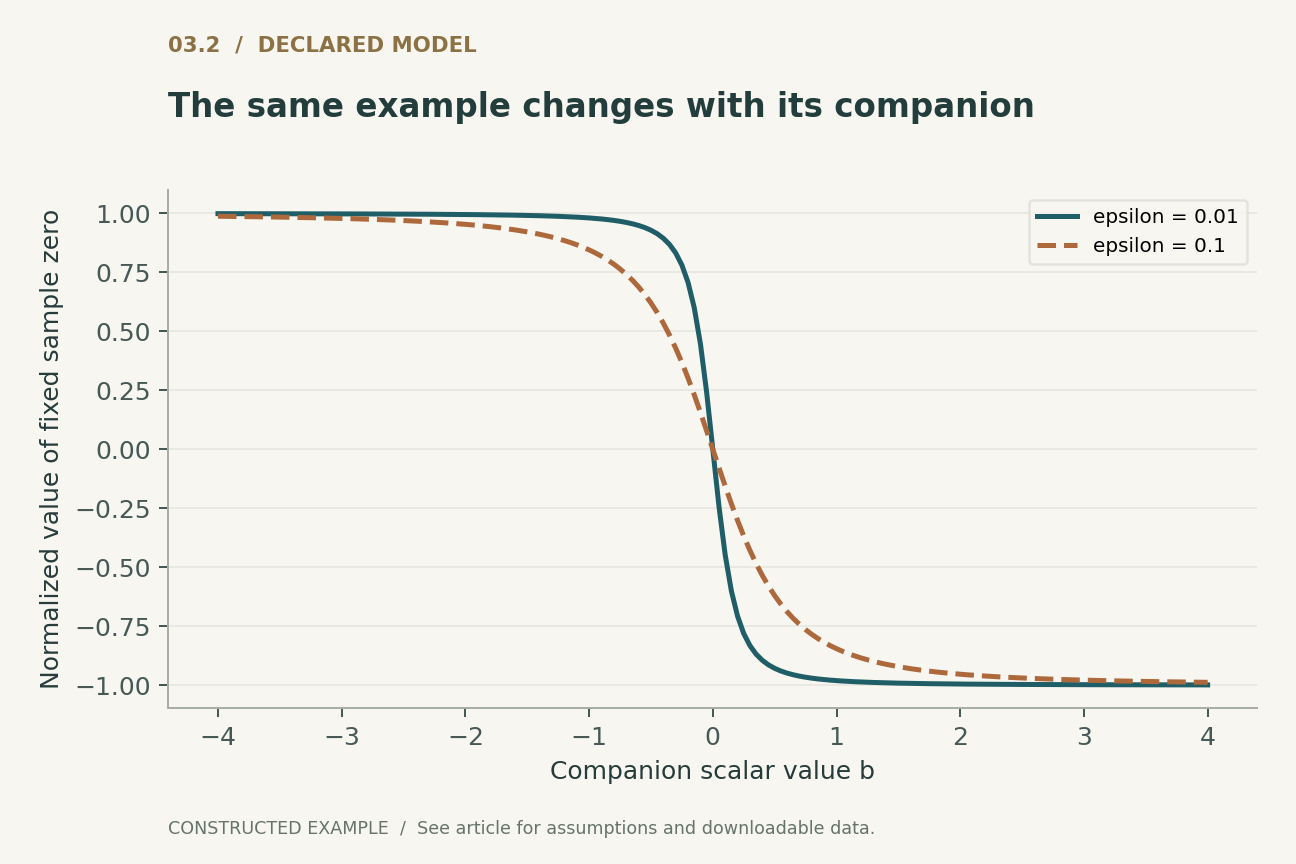
一つのスカラー特徴と、値が(0,2)であるバッチを考える。母分散と小さな安定化定数を用いると、最初の事例の正規化値は-1に近い。最初の値をゼロに保ったまま二つ目の値を-2に置き換えると、最初の正規化値は+1に近くなる。最初の標本は変化していないにもかかわらず、学習モードでの表現は符号が反転する。
これは計算上のバグではない。バッチで共有する統計量を用いることから生じる。また、モデルは変わっていないとしながらバッチ構成を変更する実験は、その標本で評価される関数を変更していることにもなる。重複した事例や相関した事例は、統計量をさらに変えうる。厳密な評価では、統計量を再計算するのか、固定するのか、デバイス間で同期するのか、あるいは別の明示された規則で累積するのかを指定すべきである。
7. 推論時の統計量は追加の状態を導入する
推論で保存済みの平均と分散を使用する場合、モデルはそれらの保存量を状態として含む。その場合、学習されたアフィンパラメータだけを保存しても、予測を再現するには不十分である。ある分布で推定された移動統計量は、別の分布では系統的にずれた出力を生むことがある。一方、運用時に統計量を再計算すると評価プロトコルが変わり、ユーザー間やリクエスト間で予測が結合される可能性がある。
簡単な診断として、学習済みの重みを固定し、選んだ入力を明示的な二組の統計量の下で評価する方法がある。観測される差はその状態への感度を測るものであり、必ずしも表現学習の失敗を意味しない。保存統計量を適応させる場合は、選定過程を明示した、使用が認められたデータセットを用い、固定した基準と比較すべきである。テストラベルがその適応に暗黙のうちに影響してはならない。これにより、正当な運用時の適応と評価における情報漏洩を区別できる。
8. スケール対称性はパラメータの大きさの意味を変える
前段の重みベクトルが、厳密にスケール不変な正規化写像を通じてのみ現れると仮定する。そのベクトルを正の定数倍しても予測は変わらない一方、ユークリッドノルムやパラメータ勾配の大きさは変わりうる。したがって、関数としてのモデルとその座標表現では、距離の概念が異なる。
この観察は、このような構成要素では重みの大きさだけが関数的複雑さの適切な診断指標にならない理由を説明する。また、再スケーリングによって予測がほとんど変わらない場合でも、パラメータノルムへのペナルティが最適化に影響しうることを意味する。厳密な関係は、安定化定数、アフィンパラメータ、迂回経路、最適化手法に依存する。そのため、特定の重み減衰設定に普遍的な解釈があるとは主張しない。統制された研究では、関数の変化とパラメータの変化を別々に調べ、いずれかを他方の完全な代理とみなすことを避けるべきである。
9. 因果的比較には単なる置換以上のものが必要である
バッチ正規化を層正規化に置き換えると、縮約軸、事例間の結合、可能な不変性、保存状態、そして場合によってはパラメータのブロードキャストが同時に変化する。性能が変わっても、その置換だけではどの機構が差を引き起こしたかを特定できない。学習可能なパラメータ数だけを揃えるのでは不十分である。
より有益な比較では、可能な範囲で一度に一つの性質を操作する。例えば、統計量を固定する、対象事例を固定してバッチ構成を変える、根拠のある範囲でepsilonを変える、非正規化の水準特徴を別経路で保存する、といった方法である。これらの介入には、タスク固有の結果と最適化の診断を組み合わせなければならない。介入によって勾配のスケールと情報の利用可能性の両方が変わる場合には、両方を測定すべきである。この設計は構成要素の単純な置換より手間がかかるが、代替説明に耐えうる結論をもたらす。
10. 図とテストが実際に示すこと
提供したプロットは、正のスケーリングへの感度と、二標本の正規化における事例間依存性を示す。テストでは、シフト不変性、epsilonに依存する動径方向の応答、有限差分との比較によるヤコビアン、同じバッチの他の標本を変更したときの符号反転を検証する。入力、分散の計算規約、安定化定数、数値的許容誤差はすべて明示されている。
これらの検査が確立するのは、明示した有限規模の写像の性質である。言語モデルや画像分類器に最適な正規化を決定するものではない。科学的価値は、厳密な代数と経験的なアーキテクチャ選択を分離することにある。写像を理解すれば、実際の学習研究において、その不変性がタスクに適合するか、その数値的挙動が指定された資源と品質のトレードオフを改善するかを問える。この区別がなければ、正規化という語が、同じ観測結果に対する互いに両立しない複数の説明を覆い隠しかねない。
11. 実践的な診断手順
正規化の変更後に学習が不安定になった場合、まず手計算できるごく小さなテンソルで軸とブロードキャストの挙動を確認する。次に、同一の入力と明示的に記録した状態を用いて学習モードと評価モードを比較する。その後、学習率を変える前に、特に分散がゼロに近い領域で分母の分布を調べる。
この順序が重要なのは、数値的な安定化定数がゼロ除算を防ぐことで軸の誤りを隠し、意味上の誤りをそのまま残しうるためである。同様に、順伝播が成功しても、微分の数値的な条件の良さについて分かることは少ない。小さく滑らかな入力での有限差分検査は、実装の整合性について低コストで得られる証拠となる。これに加えて、一定の入力や非常に小さな分散でのテストを行うべきであり、そこでは期待される挙動が厳密な不変性の仮定ではなく、明示したepsilonの規約に従わなければならない。
12. 精度は仕様に含まれる
数学的に正の分母でも、有限精度では不正確に表現されることがある。ほぼ一定の座標値から大きな平均を引くと相対精度が失われる可能性があり、低精度のデータ型で偏差平方を累積すると分散が変わりうる。これらは本稿のfloat64の例を超える実装上の問題である。運用時のテストでは、差異を正規化自体の性質と解釈する前に、累積演算の精度を記録し、分散の小さい入力を高精度の基準と比較すべきである。
ローカルで実行済み · 限定された範囲
正規化の不変性とヤコビアンの検査
母分散とepsilonを明示した三次元の正規化および二標本のバッチ正規化。ネットワーク学習と混合精度実装は対象外である。
10件のアサーションに合格した。 これらの検査は提供した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認する
{
  "jacobian": [
    [
      0.23993835872757036,
      -0.3286112304312372,
      0.08867287170366717
    ],
    [
      -0.3286112304312372,
      0.5007409225618855,
      -0.17212969213064816
    ],
    [
      0.08867287170366717,
      -0.17212969213064816,
      0.08345682042698094
    ]
  ],
  "max_finite_difference_error": 1.384497516632166e-10,
  "companion_outputs": [
    -0.9950371902099893,
    0.9950371902099893
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検査結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 学習されるゲインとバイアスの適用前に行う、事例ごとの座標正規化。d>=2。
(2) オフセット不変性は厳密である。正のスケールに対する不変性にはepsilon=0とv>0.が必要である
(3) epsilon>0の場合のヤコビアン。sの二乗はv+epsilonに等しい。
(4) 母分散を用い、アフィン変換を行わない二つのスカラーからなるバッチの最初の事例。
構成された例 · 再現可能なデータ
定量的な論証を確認する
これらの曲線は、明示したモデルから計算されている。引用した研究から得られた観測ではない。各図には数値データとベクター版が付属する。


どの証拠がどの問いに答えるのか
| 選択 | 厳密な構造的効果 | 必要な診断 |
|---|---|---|
| 事例内での中心化 | 共通オフセットを除去する | 全体的な水準に含まれるタスク情報 |
| 事例をまたぐ統計量 | バッチ内の要素を結合する | バッチ構成への感度 |
| 正のepsilon | 低分散の場合を正則化する | スケール依存性と微分の大きさ |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限規模のモデルは、実行可能な検査に記録されている。
- テンソルの各次元の大きさ、軸、分散の分母、epsilon、アフィンパラメータのブロードキャストを指定する。
- 手計算可能なテンソルで変換を検証する。
- 特異な場合を避けて、解析的ヤコビアンと有限差分によるヤコビアンを比較する。
- 対象事例を固定したまま、同じバッチの他の事例を変える。
- 保存された推論統計量を記録し、モード間の遷移を明示的にテストする。
- 精度や速度の変化の原因を帰属する前に、タスク固有の介入を事前に明示する。
一次資料が確立していること
Sergey Ioffe, Christian Szegedy · 2015 [1]
貢献。 ミニバッチ統計量と学習されるアフィンパラメータを用いたバッチ正規化を導入する。
適用範囲の限界。 その歴史的な動機は、観測されたあらゆる利点に対する普遍的な因果的説明ではない。
資料内の該当箇所。 一次資料であるPMLRの要旨と正規化の定式化。
Jimmy Lei Ba, Jamie Ryan Kiros, Geoffrey E. Hinton · 2016 [2]
貢献。 一つの学習事例内の統計量を用いた正規化を導入する。
適用範囲の限界。 事例内の軸は、バッチ内の事例にわたって計算される統計量およびそれらの依存関係とは異なる。
資料内の該当箇所。 著者原稿の要旨と層正規化の定義。
Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas et al. · 2018 [3]
貢献。 バッチ正規化の利点の説明として、最適化の滑らかさを研究する。
適用範囲の限界。 この議論によって、あらゆる正規化の選択やネットワークが同程度に滑らかになるわけではない。
資料内の該当箇所。 著者原稿の要旨と最適化に関する枠組み。
本分析の限界
- 代数的分析は正規化を単独で扱い、完全な残差ネットワークは含まない。
- 学習速度や精度のベンチマークは実施していない。
- 有限差分は許容誤差に基づく整合性検査であり、記号的な証明ではない。
- フレームワーク固有の既定の軸と統計量は、別途確認しなければならない。
選定した三つの基礎的な一次資料に焦点を当て、独自の計算例を添えた分析的レビューである。2026までの文献を網羅的または体系的に調査したものではない。資料の閲覧範囲と版に関する注記は、参考文献とともに記録されている。
結論を変えうる問い
- 提案された縮約軸によって、タスクに関係するどの信号が除去されるのか。
- 運用時の誤差のうち、学習された重みではなく保存された統計状態に由来するものはどの程度か。
- 介入によって、情報の除去と最適化における数値的な条件の改善を切り分けられるか。
参考文献
- Sergey Ioffe, Christian Szegedy. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. Proceedings of the 32nd International Conference on Machine Learning, PMLR 37 (2015). Primary source.
- Jimmy Lei Ba, Jamie Ryan Kiros, Geoffrey E. Hinton. Layer Normalization. arXiv:1607.06450 (2016). 10.48550/arXiv.1607.06450.
- Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas et al.. How Does Batch Normalization Help Optimization?. arXiv:1805.11604 (2018). 10.48550/arXiv.1805.11604.
資料[1]の閲覧範囲。 一次書誌記録と要旨を確認した。全文や補足資料を網羅的に監査したものではない。
資料[2]の閲覧範囲。 一次書誌記録と要旨を確認した。全文や補足資料を網羅的に監査したものではない。
資料[3]の閲覧範囲。 一次書誌記録と要旨を確認した。全文や補足資料を網羅的に監査したものではない。
版に関する注記。 記録の初回投稿は2018年。v5(2019年四月15日)を確認した。一次記録にはNeurIPS 2018との記載がある。本参考文献一覧では著者原稿を特定している。
書誌情報の同一性は、出版社および著者の一次記録と照合した。以下の資料閲覧と版に関する注記が確認範囲を示す。これは全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術面を自己レビューした。参考文献は元の研究者を明示している。解析的な構成と提案する評価設計は、本記事に帰属する。
表紙はImageGenによる概念的イラストである。技術図は明示したモデルまたは有限規模の例から計算され、PythonとCSVが提供されている。運用中の製品の測定値でも、性能ベンチマークの再現結果でもない。
このローカル原稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。