
要旨
分離可能なデータの分類では、予測と最適化の区別がとりわけ鮮明になる。分類器が分類誤差ゼロを達成していても、ロジスティック損失は減少を続け、パラメータのノルムは増大を続けうる。本展望では、有限の幾何学的な例を構成し、符号付きマージン、正規化マージン、確信度、アルゴリズムのバイアスを区別する。線形モデル、非分離データ、および無限幅の二層モデルに関する選択された結果を、適用範囲を慎重に限定した参照点として用いる。続いて再パラメータ化の計算により、関数と訓練ラベルが同一でも最適化経路が同一になるとは限らない理由を示す。実行可能な検証は、構成したマージンと勾配を確かめるものであり、有限の非線形ネットワークに関する一般定理を確立するものではない。
1. ラベルを正しく予測しても、多くの分類器が候補として残る
訓練集合は、一意の関数を指定するのではなく、分類器に不等式を課す。すべての符号付きスコアが正であれば分類誤差はゼロだが、それらの不等式を満たす方向と大きさは無限に存在しうる。ある方向では決定境界が特定の観測点に近づき、別の方向ではより大きな幾何学的余裕が残る。訓練集合に含まれない点では、これらの分類器はまったく異なる予測をすることがある。
この一意に定まらない性質こそ、暗黙的バイアスが意味のある研究対象となる理由である。最適化手法、初期化、表現、停止規則が一体となって、データに適合する関数の中から一つを選ぶ。本稿の目的は、その選択を普遍的に良いものと位置づけることではない。訓練手続きがどの幾何学的量を選択するのか、その主張を意味あるものにする仮定は何か、そして誤差ゼロという指標がその選択を明らかにするには粗すぎる理由を特定することである。
2. 三つの理論的基盤とその限界
Soudryらは、適切な単調減少損失と勾配降下法の条件の下で、分離可能なデータに対する正則化なしの斉次線形分類の方向収束を特徴づけている。JiとTelgarskyは、分離可能な成分と有界なオフセットを含む分解を通じて、解析を非分離データへ拡張している。ChizatとBachは、無限幅の二層モデルという設定において、これとは異なる関数空間のマージンを研究している。
重要な違いは、マージンが定義される空間にある。ユークリッド線形マージン、カーネルマージン、関数空間のマージンは、同じ対象を指す交換可能な名称ではない。本稿では、これらの論文を議論の適用範囲を示す基準として用いる。以下の有限な計算は初等的な構成であり、それらの漸近的証明を再現するものではなく、無限幅に関する結論を任意の有限アーキテクチャへ移すこともできない。 [1], [2], [3]
3. 境界を動かさずに確信度を拡大する
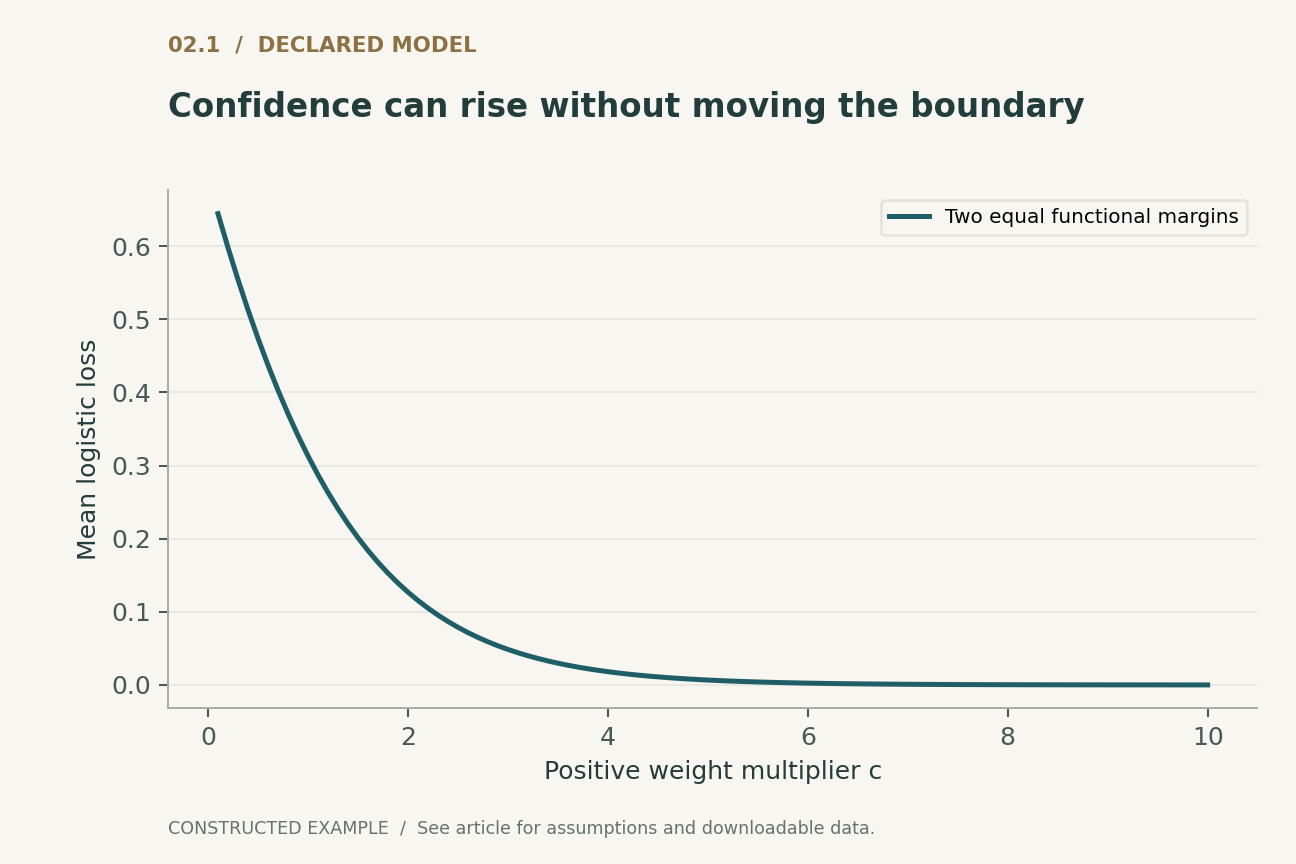
二値ラベルyが{-1,1}に属するとき、ロジスティック損失はlog(1+exp(-y w dot x))である。c>0.の下でwをc wに置き換える。すべての予測の符号は変わらない。最小の符号付きスコアが正であれば、各損失項はcの増加とともに減少し、ゼロに近づく。一方、ノルムはcに比例して増大し、決定境界は固定されたままである。
正規化マージンは符号付きスコアをwのノルムで割ったものなので、この再スケーリングでは変化しない。したがって、損失の減少は、幾何学的構造が変わらないまま確信度だけが増していることを意味する場合がある。方向の変化を伴う場合もあり、損失だけではどちらかを判断できない。損失、ノルム、正規化最小マージン、分類誤差を記録することで、これらの可能性を区別できる。これは定義から直接導かれる診断上の推奨事項である。
4. 二つの制約からなる厳密な例
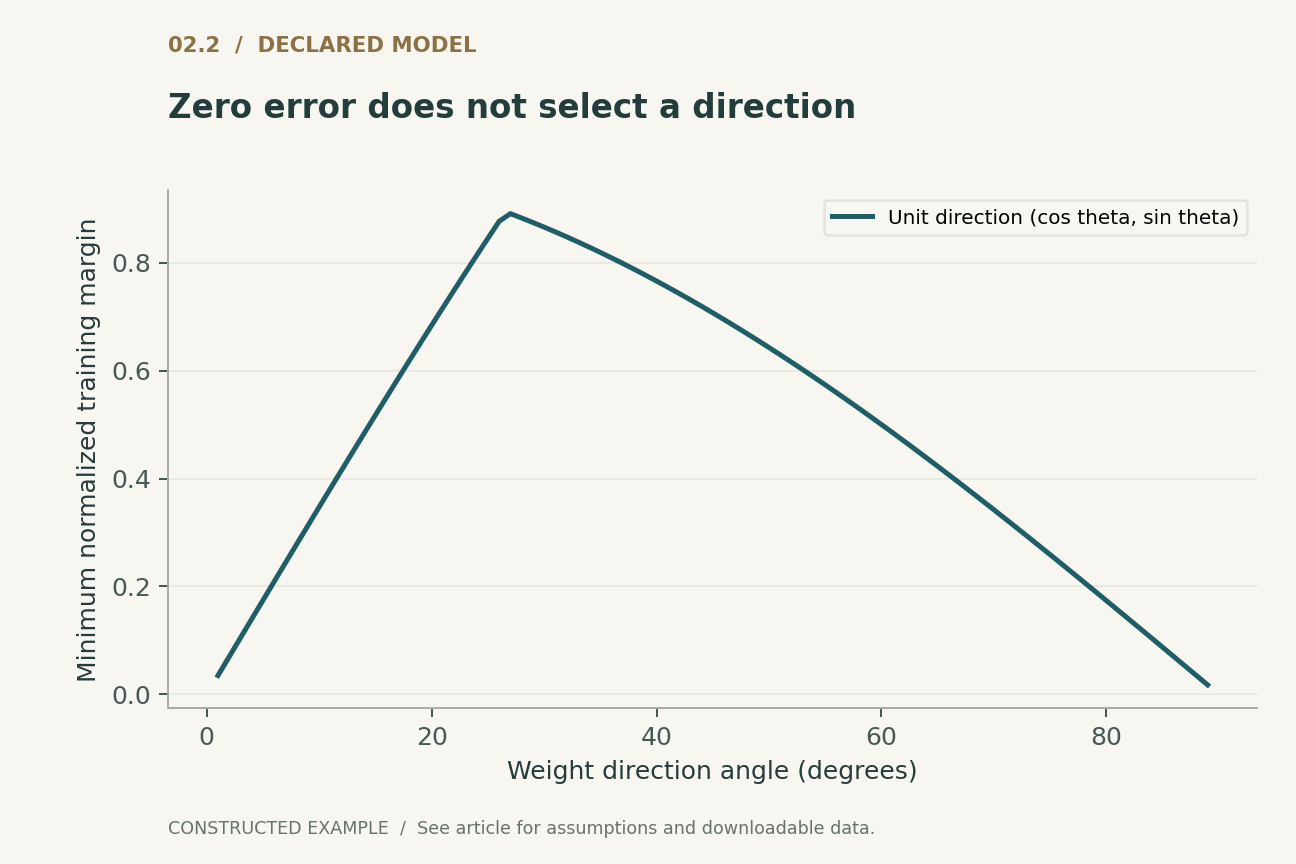
二つの符号付き特徴ベクトルz1=(1,0)とz2=(0,2)を考える。ここで符号付き特徴とは、yとxの積を意味する。単位関数マージンの制約はw1>=1およびw2>=1/2となる。これらの制約の下でユークリッドノルムの二乗を最小化すると、w=(1,1/2)が得られる。どちらの座標を増やしても目的関数は増加するだけだからである。その正規化最小マージンは2/sqrt(5)である。
(1,1)に比例する方向も両方の観測点を正しく分類するが、その正規化最小マージンは1/sqrt(2)である。どちらも訓練誤差はゼロである。同じノルムでは最小スコアが異なり、任意の正の再スケーリングによって、どちらも極めて小さなロジスティック損失を達成できる。この構成は、未報告のデータセットや訓練済みネットワークに依存せず、誤差ゼロという指標が捨ててしまう情報を切り分ける。
5. 損失の速い減少が方向の遅い変化を覆い隠しうる理由
すべてのスコアが大きな正の値になると、ロジスティック損失の勾配は、マージンの大きな観測点よりも小さな観測点に、はるかに強い重みを与える。これは、符号付きスコアmに対する導関数の大きさが1/(1+exp(m))であることから従う。本稿の二座標の例では、特徴の大きさと現在のスコアがともに異なるため、勾配降下法は各座標を異なる速さで更新する。
パラメータが増大するにつれて、更新量の絶対値は小さくなる。そのため、正規化された方向がなお変化していても、損失に基づく閾値では分類器が静止しているように見えることがある。付属の有限回の実行はこの乖離を例示するが、短い軌跡から漸近的収束率を推定するものではない。収束率を主張するには、関連する定理とその仮定、または妥当性のある範囲で競合する漸近形を区別できる実験設計のいずれかが必要である。
6. 座標変換はユークリッド最適化を変える
可逆な対角行列Aに対して、w=A thetaとする。すべてのwに対応するthetaが存在するので、表現される線形関数は変わらない。thetaにおけるユークリッド勾配の一ステップは、wにおいてAとその転置の積で前処理されたステップを誘導する。したがって、表現能力が同一であっても、関数空間における軌跡は座標系に依存する。
thetaのノルムを最小にする制約は、wにおける楕円体ノルムに対応する。この観察は、すべての最適化手法が必ずその最小値に収束すると主張するものではなく、ノルムに基づく結論がどの幾何学的構造を指すことになるかを特定するものである。本稿の検証では、同じ関数を表現している時点で、wの直接更新とAを用いたパラメータ化による更新を比較する。勾配は連鎖律で関係づけられるが、次に得られる関数は一般に異なる。これは、通常の勾配降下法がパラメータ化に対して不変であるという主張に対する、有限で再現可能な反例である。
7. 外れ値が幾何学的な余裕を決めることがある
ハードマージンの構成では、分離境界に最も近い制約が決定的な影響を持つ。この例に、epsilonと(1,0)の積である符号付き点を追加する。その制約はw1>=1/epsilonを要求する。epsilonがゼロに近づくにつれて、最小ノルム解は第一軸の方向へ回転し、そのノルムは増大する。それでも、有限の正のepsilonであれば、どの値でも完全な分類が可能である。
これは、まれな事例がすべてノイズであり、除去すべきだという主張ではない。まれな点が重要な母集団を代表することもある。この例が示すのは、経験的な幾何学的マージンの最大化が、観測点、ラベル、特徴のスケーリングに条件づけられていることである。誤ラベルや破損のある点が分離可能性を変えれば、問題そのものが変わる。したがって、最適化手法の見かけ上のバイアスを解釈する際には、データの来歴とラベルの不確実性を含める必要がある。
8. 非分離性は問いを変える
同一の特徴ベクトル二つに反対のラベルを付け、データセットに入れる。決定論的な斉次線形分類器は、両者に正の符号付きスコアを与えることができない。この二点だけのロジスティック損失への寄与を考えると、大きさを任意に増やすことで、一方の項は改善するが他方は悪化する。この矛盾する対については、スコアがゼロのときに損失が最小となる。
より大きなデータセットには、矛盾した構造と、部分集合をなお分離できる方向の両方が含まれることがある。JiとTelgarskyによる非分離データの解析が重要なのは、そのようなデータを、分離できるかできないかの二者択一の説明に押し込めないためである。本稿では、対称な矛盾対のみを検証し、その有限の最適解を説明する。損失曲線や低い訓練誤差から、現実的なデータセットの完全な分解を推論することはしない。 [2]
9. 汎化は追加の推論である
大きな経験マージンが有用でありうるのは、特徴の尺度、仮説クラス、標本抽出モデルが定義されている場合に限られる。入力を任意に再スケーリングすると、未観測のラベルについて新しい証拠がなくても、生のマージンは変わりうる。テスト集合を調べた後で表現を選択した場合、その表現で測定したマージンは、事前に宣言した評価としては解釈できなくなる。
最適化についての正しい定理であっても、母集団分布を特定するものではない。汎化を評価するには、真に独立に取り置いた集合を保持し、サブグループ別および分布に関する挙動を評価し、確率の較正とラベルの正解率を区別する必要がある。本稿の構成例には、二つの制約の外側に母集団のラベルを意図的に与えていない。訓練マージンが大きいという理由だけで、ある方向にテスト正解率上の優位性を与えるのは、数学的に正当化できない。
10. バイアスの反証可能な研究
提案する実験では、訓練前に予測される極限対象を明示すべきである。それは入力空間の方向、パラメータ空間のノルム、あるいは関数空間の分類器かもしれない。そのうえで、訓練済みモデルをその対象と比較するために必要な量を記録すべきである。小規模な問題では、独立に解いた制約付き最適化問題が有用な基準となる。非線形ネットワークでは、未検証のソルバー出力それ自体が不確実性となる。
付属の例では、厳密な制約、正のスケーリングに対するノルムの不変性、連鎖律による前処理の恒等式、矛盾対の最適解を検証する。これらは、仮定が変わると結論がどのように成立しなくなるかを示す。例は意図的に有限なものとしている。擁護できる結論は、暗黙的バイアスが汎化を解決するということではなく、最適化がある幾何学的構造を選択し、その構造は名前を与えられ、測定され、ラベルに適合するという事実から切り分けられなければならないということである。
11. 停止規則は科学的研究対象の一部である
同じ最適化手法と初期化を用いても、終了規則が異なる二つの訓練実行が、同じ実践上の主張を具体化するとは限らない。損失の閾値は確信度の尺度を優先し、固定されたステップ数は方向の軌跡上の特定の点を優先する。検証規則は、別の標本と追加の選択手続きを導入する。いずれも本質的に誤りではないが、それらの結果を同じ呼称の下でまとめると、比較が不明瞭になる。
報告では、選択したチェックポイントが検証損失を最小化するものか、検証正解率を最大化するものか、それとも固定スケジュールを完了しただけのものかを明記すべきである。判定規則を固定した後で、主張されたマージンの改善を調べられるよう、チェックポイントの軌跡を保存すべきである。スコアの確信度が増すにつれて検証損失が上昇する場合には、とりわけ重要である。確率の質の変化と分類の幾何学的構造の変化は、同じ符号を持つとは限らない。
12. マージンは確率推定値ではない
正のスケーリングは決定境界を固定したまま、ロジスティック確率をゼロまたは一へ近づける。ある入力における真の条件付き確率がどちらの端点でもない場合、確信度が十分に大きくなると、予測ラベルが正しいままであっても、期待対数スコアは悪化しうる。したがって、幾何学的選択の問題と確率推定の問題は、異なる観測量で評価しなければならない。
ローカルで実行済み · 限定された範囲
マージン、座標変換、矛盾するラベル
二つの制約による有限の幾何学的構成、明示的な勾配ステップ、および矛盾対の101個のスコア。有限回の降下は、引用した漸近定理の証明ではない。
116件のアサーションに合格した。 これらの検証は、提示した例を検証するものであり、引用されたシステムを検証するものではない。
記録された検証証跡を確認する
{
  "maximum_margin": 0.8944271909999159,
  "trajectory_step_loss_margin": [
    [
      1,
      0.5533380097486379,
      0.4472135954999579
    ],
    [
      10,
      0.2114391196724853,
      0.6472679469278612
    ],
    [
      100,
      0.02618021290683939,
      0.8076515825626189
    ],
    [
      1000,
      0.002528703690596741,
      0.8472075680971195
    ],
    [
      10000,
      0.00025045209849889,
      0.8617419583557351
    ]
  ],
  "direct_gradient": [
    -0.16590611391591695,
    -0.31002551887238755
  ]
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの式と明示的な仮定
(1) 二値の斉次線形ロジスティック損失。明示的なペナルティはなく、バイアス座標はxに含めた場合にのみ存在する。
(2) 正規化経験マージンは、非ゼロのwに対してスケール不変である。
(3) 本稿の二つの符号付きベクトルに対する厳密な最小ノルム解であり、深層ネットワークの一般解ではない。
(4) thetaにおけるユークリッド勾配の一ステップ。Aは固定され、可逆である。
構成例 · 再現可能なデータ
定量的な論証を確認する
これらの曲線は、明示したモデルから計算したものである。引用した研究の観測結果ではない。各図には数値データとベクター版を添付している。


どの証拠がどの問いに答えるのか
| 観測 | 特定できること | 特定できないこと |
|---|---|---|
| 分類誤差ゼロ | 訓練点における符号 | 方向または較正 |
| ロジスティック損失の減少 | 平均訓練スコアに関する目的の改善 | 境界の変化 |
| 大きな正規化マージン | 指定されたノルムにおける幾何学的構造 | 母集団のラベルまたは因果的不変性 |
提案する検証プロトコル
これは評価設計の提案である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の項に記載している。
- 特徴のスケーリング、ラベル、損失の正規化、パラメータ化を固定する。
- 小規模な参照用マージン問題を、勾配降下法とは独立に解く。
- 各チェックポイントで、誤差、損失、ノルム、方向、正規化マージンを記録する。
- 表現される関数を保持する座標変換を用いて繰り返す。
- 明示した矛盾対を導入し、挙動の変化を調べる。
- 停止規則を報告し、テスト評価をチェックポイントの選択から切り離す。
一次資料が確立していること
Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al. · 2018 [1]
貢献。 明示された勾配降下法の条件の下で、分離可能なデータに対する斉次線形予測器の最大マージン方向への挙動を特徴づける。
適用範囲。 これは、任意の有限な非線形ネットワークに一律に適用できる定理ではない。
資料内の該当箇所。 原論文の第2節および主要な方向収束定理。
Ziwei Ji, Matus Telgarsky · 2019 [2]
貢献。 データが完全には分離可能でない場合のロジスティック勾配の挙動を解析する。
適用範囲。 分離可能な半直線と有界成分を論じるには、論文に示された厳密な分解が必要である。
資料内の該当箇所。 PMLR掲載の原要旨と定理の枠組み。
Lénaïc Chizat, Francis Bach · 2020 [3]
貢献。 無限幅の二層モデルの訓練を、関数空間のマージンに結びつける。
適用範囲。 極限における関数の幾何学的構造と訓練の仮定は、有限の線形例とは異なる。
資料内の該当箇所。 PMLR掲載の原要旨。無限幅および斉次活性化関数による定式化。
本解析の限界
- 具体的に扱ったデータセットには二つの符号付き制約しかなく、テスト母集団は割り当てていない。
- 有限の軌跡は、漸近的な方向収束を証明しない。
- 非線形モデルの参照文献は、理想化された無限幅の設定を扱っている。
- マージンは特徴のスケーリングと選択したノルムに依存する。
選択した三つの基礎的一次資料に焦点を絞った分析的レビューであり、独自の計算例を含む。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセスと版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 有限幅におけるどの診断が、関数空間のマージンとパラメータ空間の代替指標を最もよく区別できるか。
- データ依存の停止規則は、測定される実践上のバイアスをどのように変えるか。
- ラベルの不確実性と特徴の再スケーリングの影響は、どのような場合に最適化手法のマージンに対する選好の影響を上回るか。
参考文献
- Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al.. The Implicit Bias of Gradient Descent on Separable Data. Journal of Machine Learning Research 19(70) (2018). Primary source.
- Ziwei Ji, Matus Telgarsky. The implicit bias of gradient descent on nonseparable data. Proceedings of the Thirty-Second Conference on Learning Theory, PMLR 99 (2019). Primary source.
- Lénaïc Chizat, Francis Bach. Implicit Bias of Gradient Descent for Wide Two-layer Neural Networks Trained with the Logistic Loss. Proceedings of Thirty Third Conference on Learning Theory, PMLR 125 (2020). Primary source.
資料[1]へのアクセス。 JMLRの書誌記録および原論文PDFの序論と定理の文脈を確認した。証明全体の独立した監査は行っていない。
資料[2]へのアクセス。 一次書誌記録と要旨を確認した。全文または補足資料の網羅的な監査は行っていない。
資料[3]へのアクセス。 一次書誌記録と要旨を確認した。全文または補足資料の網羅的な監査は行っていない。
書誌情報の同一性は、出版社と著者の一次記録に照らして確認した。以下の資料へのアクセスと版に関する注記が確認範囲を示しており、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を示し、分析上の構成と提案した評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術的な図は、明示したモデルまたは有限の例から計算し、PythonとCSVを添付している。導入済み製品の測定値でも、性能ベンチマークの再現結果でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示した小規模モデルを検証するものであり、引用されたシステムの形式的検証ではない。