
摘要
可分数据上的分类以一种格外鲜明的方式区分了预测与优化:分类器可能已达到零分类误差,而逻辑斯蒂损失仍在下降,参数范数仍在增长。本文构建一个有限的几何示例,以区分带符号间隔、归一化间隔、置信度与算法偏置。我们选取线性模型、不可分数据以及无限宽双层模型方面的若干结果,作为适用范围经过谨慎限定的参照。随后,通过重参数化计算说明,为何相同的函数与相同的训练标签并不意味着相同的优化路径。可执行检验验证了所构造的间隔与梯度;它们并未建立适用于有限非线性网络的一般定理。
1. 标签预测正确仍允许多种分类器
训练集对分类器施加的是不等式,而非指定一个唯一的函数。如果所有带符号得分均为正,分类误差就是零,但仍可能有无穷多个方向和大小满足这些不等式。有些方向使决策边界靠近特定观测点,另一些方向则留下更大的几何缓冲空间。在训练集未包含的点上,这些分类器的预测可能完全不同。
这种欠确定性正是隐式偏置值得研究的原因。优化器、初始化、表示与停止规则共同从能够拟合数据的函数中作出选择。我们的目的并不是将这种选择一概视为有益,而是明确训练过程选择了哪一种几何量,哪些假设使这一表述具有意义,以及为何零误差指标过于粗糙,无法揭示这种选择。
2. 三个理论支点及其局限
Soudry及其同事刻画了在适当的递减损失与梯度下降条件下,无正则化齐次线性分类器在可分数据上的方向收敛。Ji与Telgarsky通过包含可分分量和有界偏移的分解,将分析扩展到不可分数据。Chizat与Bach则在无限宽双层模型的设定中,研究了另一种函数空间间隔。
重要区别在于间隔定义于哪个空间。欧几里得线性间隔、核间隔与函数空间间隔,并不是同一对象的可互换名称。我们将这些论文用作界定适用范围的参照。下文的有限计算是初等构造,并非对其渐近证明的复现,也不能将无限宽条件下的结论转移到任意有限架构上。 [1], [2], [3]
3. 不移动边界也能缩放置信度
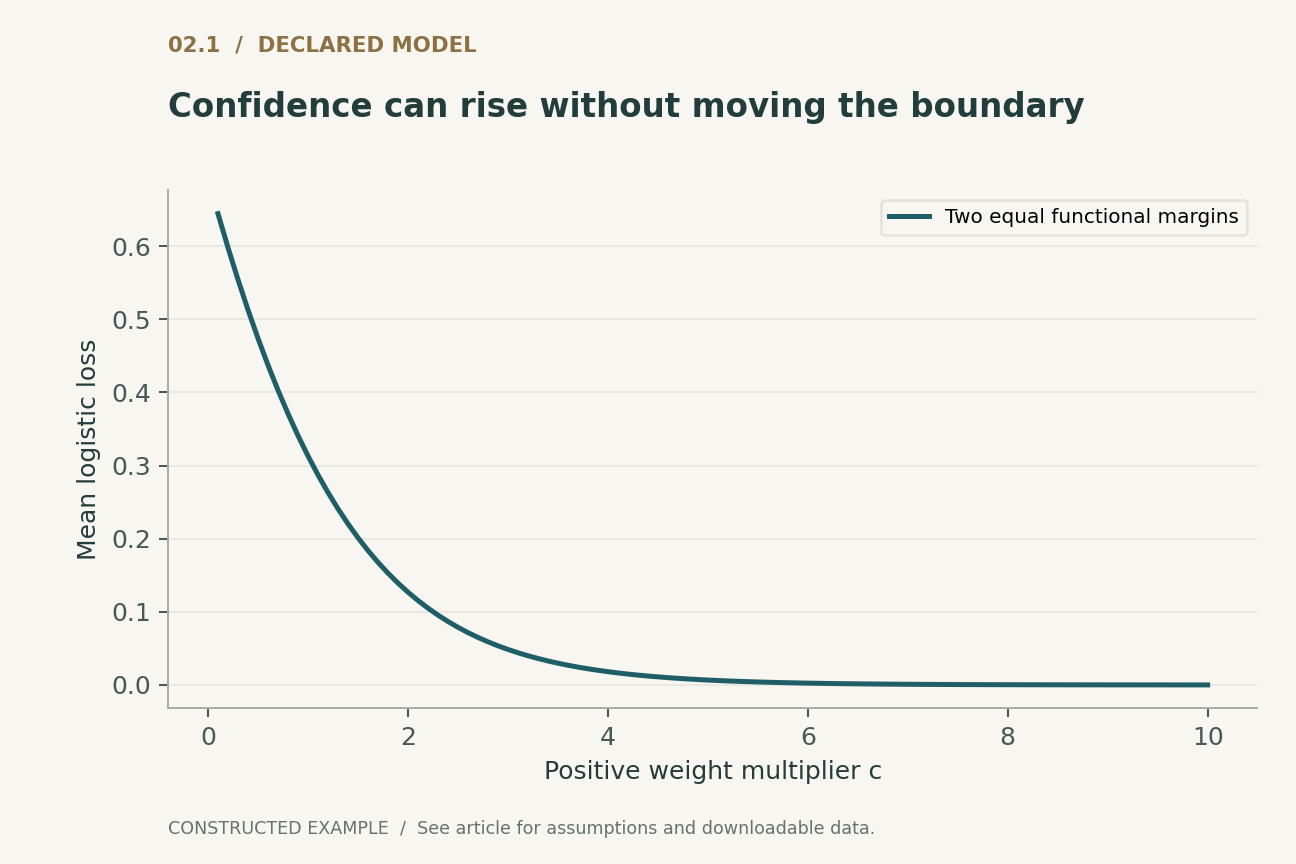
对于取值于{-1,1}的二元标签y,逻辑斯蒂损失为log(1+exp(-y w dot x))。在c>0.的条件下,将w替换为c w。每个预测的符号均保持不变。如果最小带符号得分为正,则随着c增大,每一项损失都会下降并趋于零。与此同时,范数随c线性增长,而决策边界保持固定。
归一化间隔将带符号得分除以w的范数,因此在这种重缩放下保持不变。所以,损失下降可能仅意味着在几何结构不变的情况下置信度上升。它也可能伴随方向变化;仅凭损失无法判断属于哪一种情形。记录损失、范数、归一化最小间隔与分类误差的轨迹,可以区分这些可能性。这是一项直接由定义推导出的诊断建议。
4. 一个具有两个约束的精确示例
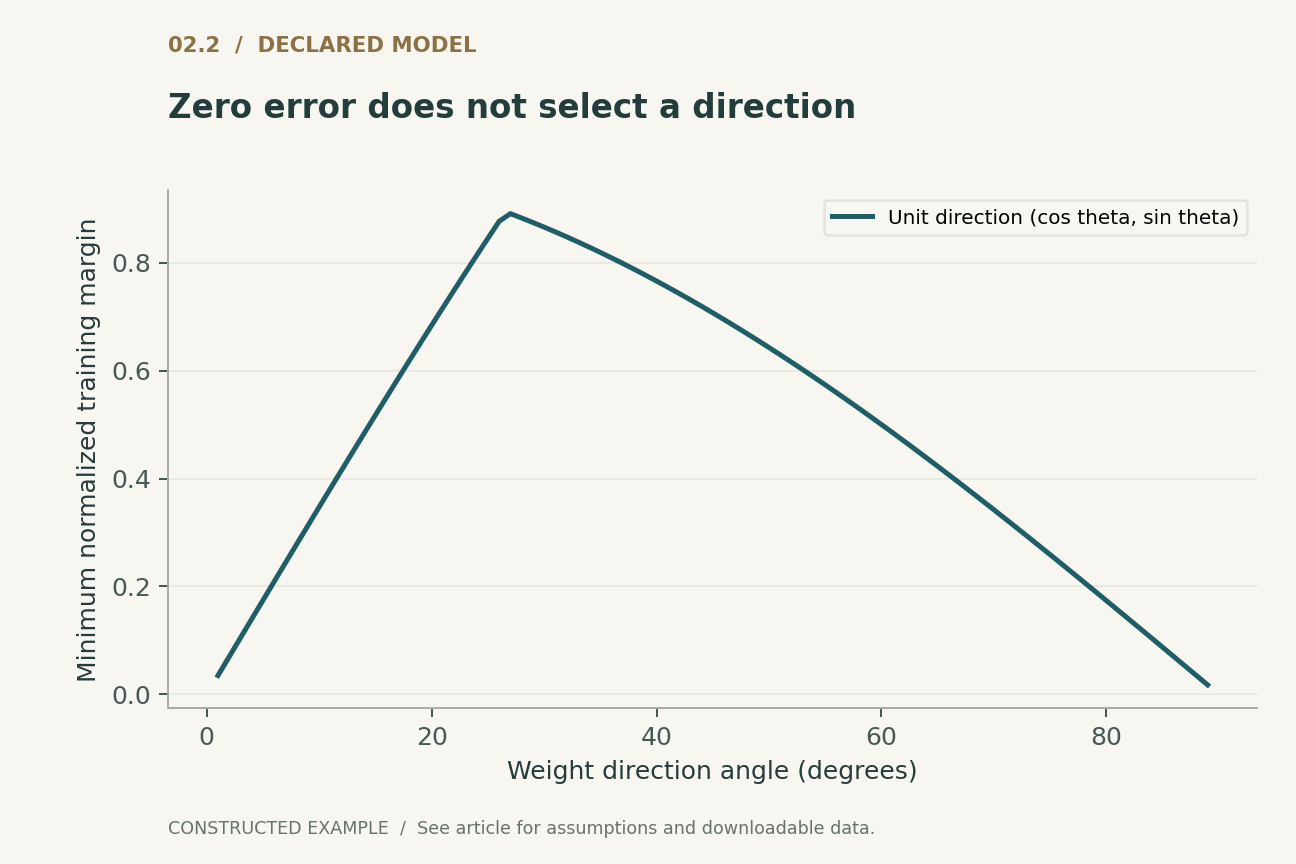
考虑两个带符号特征向量z1=(1,0)和z2=(0,2),其中带符号特征是指y乘以x。单位函数间隔约束变为w1>=1和w2>=1/2。在这些约束下最小化欧几里得范数的平方,得到w=(1,1/2),因为增大任一坐标都只会增大目标函数。其归一化最小间隔为2/sqrt(5)。
与(1,1)成比例的方向同样能正确分类这两个观测点,但其归一化最小间隔为1/sqrt(2)。二者的训练误差均为零。在范数相同时,它们的最小得分不同;经过任意正比例重缩放后,二者都可以达到极小的逻辑斯蒂损失。这个构造不依赖于未报告的数据集或训练好的网络,就能单独揭示零误差指标所丢弃的信息。
5. 为何损失快速下降可能掩盖方向的缓慢变化
一旦所有得分都成为较大的正值,逻辑斯蒂梯度就会对低间隔观测点赋予远高于高间隔观测点的权重。这可由导数得出:对于带符号得分m,导数的绝对值为1/(1+exp(m))。在我们的双坐标示例中,由于特征大小与当前得分均不相同,梯度下降以不同速率更新两个坐标。
随着参数增长,更新量的绝对值会缩小。因此,按照基于损失的阈值判断,分类器可能看似已经静止,但其归一化方向仍在变化。提供的有限次运行展示了这种分离,却并未从一段短轨迹中估计渐近收敛速率。若要对速率作出主张,就需要相关定理及其假设,或者能够在有充分依据的范围内区分不同渐近形式的实验设计。
6. 坐标变换会改变欧几里得优化
设w=A theta,其中A是可逆对角矩阵。由于每个w仍有对应的theta,所表示的线性函数保持不变。theta中的一次欧几里得梯度步,会在w中诱导出一个由A与其转置的乘积进行预条件化的步。因此,即使表示能力相同,函数空间中的轨迹仍依赖坐标系。
最小化theta范数的约束对应于w中的一种椭球范数。这一观察并不是断言每个优化器必然收敛到该最小值,而是在明确基于范数的结论所指向的几何结构。我们的检验在所表示函数相同的情况下,比较直接更新w与采用A参数化的更新。梯度通过链式法则相联系,而下一步得到的函数通常不同。这构成了一个有限且可复现的反例,说明普通梯度下降并不具备参数化不变性。
7. 一个离群点就可能决定几何缓冲空间
硬间隔构造使距离分离边界最近的约束具有决定性影响。在示例中添加一个带符号点epsilon乘以(1,0)。其约束要求w1>=1/epsilon。当epsilon趋近于零时,最小范数解会向第一坐标轴旋转,其范数也会增大。每一个有限的正epsilon仍然允许完美分类。
这并不是说所有罕见样本都是噪声,或都应该被删除。一个罕见点可能代表重要的群体。这个示例说明的是,最大化经验几何间隔取决于观测点、标签和特征缩放。如果一个错误标注或受损的点改变了可分性,问题本身就发生了变化。因此,在解释优化器表现出的偏置时,必须考虑数据来源与标签的不确定性。
8. 不可分性改变了问题
将两个完全相同的特征向量放入数据集,并赋予相反标签。任何确定性的齐次线性分类器都无法让二者的带符号得分同时为正。对于它们单独贡献的逻辑斯蒂损失,任意增大得分的绝对值都会改善其中一项,同时恶化另一项。对于这个矛盾样本对,得分为零时损失最小。
更大的数据集可能既包含矛盾结构,也包含仍可分离某个子集的方向。Ji与Telgarsky关于不可分数据的分析之所以相关,是因为它避免了把这类数据强行纳入非此即彼的可分性叙述。本文仅检验对称的矛盾样本对,并解释其有限最优解。我们并不根据损失曲线或较低的训练误差,推断现实数据集的完整分解。 [2]
9. 泛化是一项额外推断
较大的经验间隔只有相对于明确定义的特征尺度、假设类和采样模型才可能有用。如果任意重缩放输入,原始间隔可能发生变化,却没有任何关于未见标签的新证据。如果在查看测试集之后才选择表示,那么在该表示中测得的间隔就不再具有预先声明的评估所应有的含义。
即使是关于优化的正确定理,也无法确定总体分布。要评估泛化,应保留真正留出的数据集,评估各子群体及分布层面的行为,并区分概率校准与标签准确率。我们刻意没有为构造示例的两个约束之外指定总体标签。仅因某个方向的训练间隔更大,就认定它具有测试准确率优势,在数学上是不成立的。
10. 对偏置的可证伪研究
提出实验时,应在训练前声明所预测的极限对象:输入空间中的一个方向、参数空间中的一种范数,或函数空间中的一个分类器。随后应记录将训练后模型与该对象比较所需的量。对于小规模问题,独立求解的约束优化问题是有用的参照;对于非线性网络,未经验证的求解器输出本身就是一种不确定性。
配套示例检验了精确约束、正比例缩放下的范数不变性、链式法则的预条件化恒等式,以及矛盾样本对的最优解。它们揭示了当某项假设改变时,结论可能如何失效。这些示例被有意限定为有限情形。能够合理支持的结论并不是隐式偏置解决了泛化问题,而是优化会选择一种几何结构,必须明确命名、测量这种结构,并将其与拟合标签这一事实区分开来。
11. 停止规则是科学研究对象的一部分
两次训练即使使用相同优化器和初始化,只要终止规则不同,就不一定体现同一个实践层面的主张。损失阈值偏向某种置信度尺度;固定步数预算偏向方向轨迹上的某个特定位置;验证规则则引入了另一个样本和额外的选择过程。它们本身都没有错,但将其结果归于同一标签之下会模糊比较。
报告应说明,所选检查点是使验证损失最小、使验证准确率最大,还是仅仅完成了固定训练计划。应保留检查点轨迹,以便在决策规则固定后检查所声称的间隔改善。当得分的置信度增加、验证损失却上升时,这一点尤其重要:概率质量的变化与分类几何结构的变化未必具有相同符号。
12. 间隔并非概率估计
正比例缩放使决策边界保持固定,却会将逻辑斯蒂概率推向零或一。如果某个输入处的真实条件概率并非这两个端点中的任何一个,那么足够高的置信度可能使其期望对数评分恶化,即使预测标签仍然正确。因此,几何选择问题与概率估计问题必须用不同的可观测量来评估。
已在本地执行 · 范围有限
间隔、坐标变换与矛盾标签
具有两个约束的有限几何构造、显式梯度步,以及矛盾样本对的101个得分。有限次下降并不能证明所引用的渐近定理。
116项断言通过。 这些检验验证的是提供的示例,而非所引用的系统。
检查记录的验证见证
{
  "maximum_margin": 0.8944271909999159,
  "trajectory_step_loss_margin": [
    [
      1,
      0.5533380097486379,
      0.4472135954999579
    ],
    [
      10,
      0.2114391196724853,
      0.6472679469278612
    ],
    [
      100,
      0.02618021290683939,
      0.8076515825626189
    ],
    [
      1000,
      0.002528703690596741,
      0.8472075680971195
    ],
    [
      10000,
      0.00025045209849889,
      0.8617419583557351
    ]
  ],
  "direct_gradient": [
    -0.16590611391591695,
    -0.31002551887238755
  ]
}明确声明的解析模型
四个方程与明确假设
(1) 二元齐次线性逻辑斯蒂损失;无显式惩罚项,偏置坐标仅在被纳入x时存在。
(2) 对于非零w,归一化经验间隔具有尺度不变性。
(3) 本文两个带符号向量的精确最小范数解;并非深度网络的一般解。
(4) theta中的一次欧几里得梯度步;A固定且可逆。
构造示例 · 可复现数据
检查定量论证
这些曲线根据所声明的模型计算而得,并非来自所引用研究的观测结果。每幅图都附有数值数据和矢量版本。


哪种证据回答哪个问题?
| 观测 | 它能确定什么 | 它不能确定什么 |
|---|---|---|
| 零分类误差 | 训练点上的符号 | 方向或校准 |
| 逻辑斯蒂损失下降 | 平均训练评分目标得到改善 | 边界发生变化 |
| 较大的归一化间隔 | 指定范数下的几何结构 | 总体标签或因果不变性 |
一项建议的验证方案
这是一项拟议的评估设计。未开展生产系统或硬件基准测试。另行执行的有限模型记录于可执行检验部分。
- 固定特征缩放、标签、损失归一化与参数化方式。
- 独立于梯度下降,求解一个小规模的参照间隔问题。
- 在每个检查点记录误差、损失、范数、方向和归一化间隔。
- 使用保持所表示函数不变的坐标变换,重复上述过程。
- 引入一个明确声明的矛盾样本对,并检查行为变化。
- 报告停止规则,并将测试评估与检查点选择分开。
一手来源确立了什么
Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al. · 2018 [1]
贡献。 在所述梯度下降条件下,刻画可分数据上齐次线性预测器的最大间隔方向行为。
适用边界。 这不是适用于任意有限非线性网络的一般性定理。
来源定位。 原始论文第2节及主要方向收敛定理。
Ziwei Ji, Matus Telgarsky · 2019 [2]
贡献。 分析数据并非完全可分时的逻辑斯蒂梯度行为。
适用边界。 可分射线与有界分量需要依据该论文的精确分解。
来源定位。 PMLR原始摘要与定理框架。
Lénaïc Chizat, Francis Bach · 2020 [3]
贡献。 将无限宽双层模型的训练与函数空间间隔联系起来。
适用边界。 极限函数的几何结构与训练假设不同于有限线性示例。
来源定位。 PMLR原始摘要;无限宽与齐次激活函数的形式化设定。
本分析的局限
- 所演算的数据集仅包含两个带符号约束,且未指定测试总体。
- 有限轨迹不能证明渐近方向收敛。
- 非线性模型的参照文献涉及理想化的无限宽设定。
- 间隔取决于特征缩放与所选范数。
本文是一篇聚焦于三项精选基础性一手来源的分析性综述,并包含原创演算示例。这并不是对截至2026年的文献所作的穷尽性或系统性综述。来源访问与版本说明随参考文献一并记录。
可能改变结论的问题
- 哪些有限宽诊断最能区分函数空间间隔与参数空间中的替代指标?
- 依赖数据的停止规则会如何改变所测量的实际偏置?
- 在什么情况下,标签不确定性与特征重缩放的影响会压过优化器对间隔的偏好?
参考文献
- Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al.. The Implicit Bias of Gradient Descent on Separable Data. Journal of Machine Learning Research 19(70) (2018). Primary source.
- Ziwei Ji, Matus Telgarsky. The implicit bias of gradient descent on nonseparable data. Proceedings of the Thirty-Second Conference on Learning Theory, PMLR 99 (2019). Primary source.
- Lénaïc Chizat, Francis Bach. Implicit Bias of Gradient Descent for Wide Two-layer Neural Networks Trained with the Logistic Loss. Proceedings of Thirty Third Conference on Learning Theory, PMLR 125 (2020). Primary source.
来源[1]的访问情况。 已检查JMLR记录,以及原始PDF的引言与定理语境;未独立审计完整证明。
来源[2]的访问情况。 已检查原始书目记录与摘要;未对全文或补充材料进行穷尽性审计。
来源[3]的访问情况。 已检查原始书目记录与摘要;未对全文或补充材料进行穷尽性审计。
已根据出版方和作者的一手记录核对书目身份信息。下文的来源访问与版本说明描述了核查范围;这并非穷尽性的全文审计。
作者与来源
由Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析构造与拟议评估设计归属于本文。
封面是由ImageGen制作的概念插图。技术图表依据明确声明的模型或有限示例计算而得,并提供Python与CSV。它们不是对已部署产品的测量,也不是复现的性能基准测试。
本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检验了所述小型模型;它们并非对所引用系统的形式化验证。