
Resumen
La clasificación con datos separables distingue la predicción de la optimización de una manera inusualmente nítida: un clasificador puede alcanzar un error de clasificación nulo mientras la pérdida logística sigue disminuyendo y las normas de los parámetros siguen creciendo. Esta perspectiva desarrolla un ejemplo geométrico finito para distinguir entre margen con signo, margen normalizado, confianza y sesgo algorítmico. Utilizamos resultados seleccionados sobre modelos lineales, datos no separables y modelos de dos capas de anchura infinita como puntos de referencia con un alcance cuidadosamente delimitado. Un cálculo de reparametrización muestra después por qué unas funciones idénticas y unas etiquetas de entrenamiento idénticas no implican trayectorias de optimización idénticas. Las comprobaciones ejecutables verifican los márgenes y gradientes construidos; no establecen un teorema general para redes no lineales finitas.
1. Acertar las etiquetas deja muchos clasificadores posibles
Un conjunto de entrenamiento impone desigualdades a un clasificador en lugar de especificar una función única. Si todas las puntuaciones con signo son positivas, el error de clasificación es nulo, pero puede haber infinitas direcciones y magnitudes que satisfagan las desigualdades. Algunas direcciones sitúan una frontera de decisión cerca de determinadas observaciones; otras dejan una separación geométrica mayor. En puntos no incluidos en el conjunto de entrenamiento, estos clasificadores pueden discrepar por completo.
Esta indeterminación es lo que hace del sesgo implícito un objeto de estudio significativo. Un optimizador, una inicialización, una representación y una regla de parada eligen conjuntamente entre las funciones que se ajustan a los datos. Nuestro objetivo no es calificar esa elección como universalmente buena. Se trata de identificar qué cantidad geométrica selecciona el procedimiento de entrenamiento, qué supuestos dan sentido a esa afirmación y por qué una métrica de error nulo es demasiado burda para revelar la selección.
2. Tres referentes teóricos y sus límites
Soudry y sus colaboradores caracterizan la convergencia direccional de la clasificación lineal homogénea sin regularización sobre datos separables, con pérdidas decrecientes adecuadas y bajo condiciones apropiadas de descenso por gradiente. Ji y Telgarsky amplían el análisis a datos no separables mediante una descomposición que incluye una componente separable y un desplazamiento acotado. Chizat y Bach estudian un margen distinto en el espacio de funciones, en un entorno de dos capas de anchura infinita.
La distinción importante es el espacio en el que se define un margen. Un margen lineal euclídeo, un margen de núcleo y un margen en el espacio de funciones no son nombres intercambiables de un mismo objeto. Utilizamos estos artículos para delimitar el alcance de las conclusiones. Los cálculos finitos que siguen son construcciones elementales, no reproducciones de sus demostraciones asintóticas, y no permiten trasladar una conclusión de anchura infinita a una arquitectura finita arbitraria. [1], [2], [3]
3. Escalar la confianza sin mover una frontera
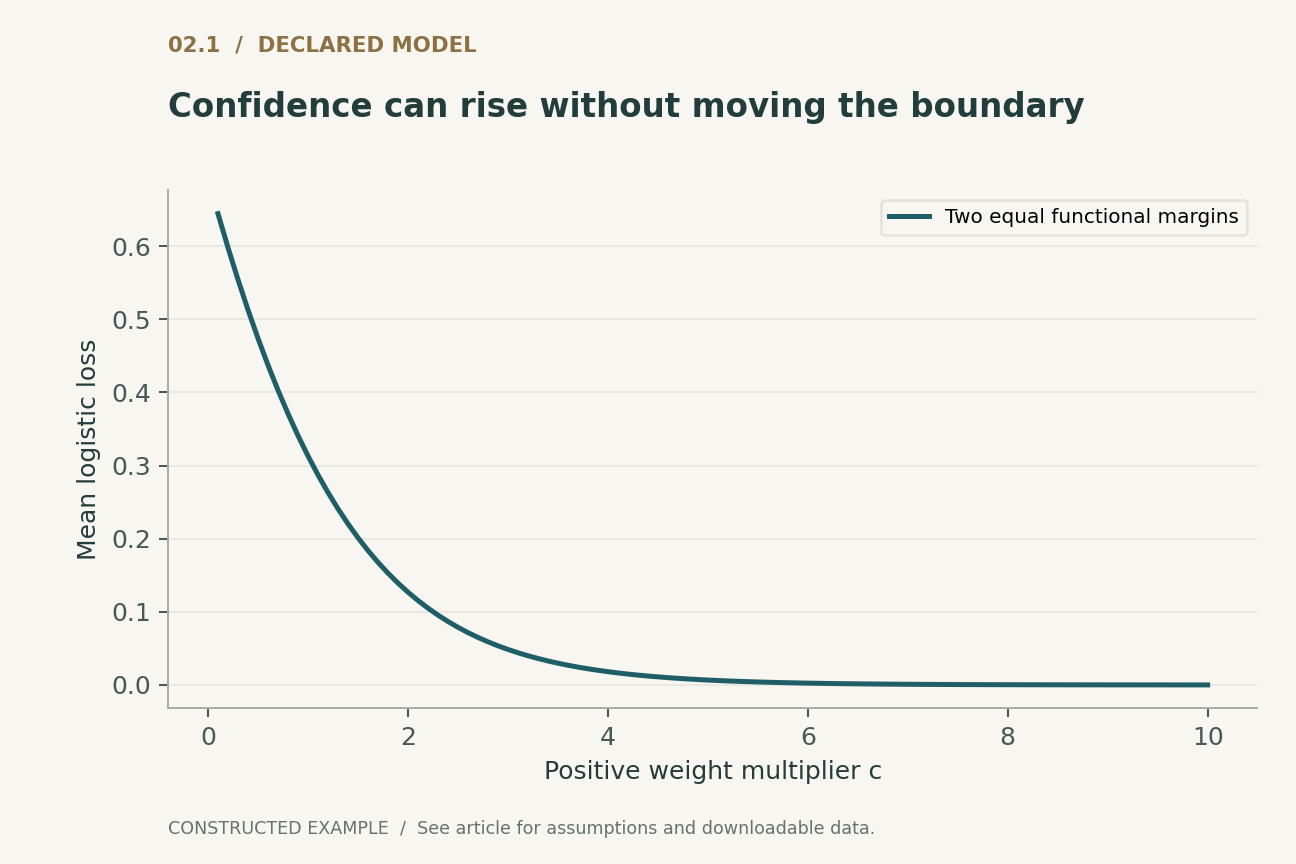
Para etiquetas binarias y en {-1,1}, la pérdida logística es log(1+exp(-y w dot x)). Sustitúyase w por c w con c>0. El signo de todas las predicciones permanece inalterado. Si la menor puntuación con signo es positiva, cada término de pérdida disminuye a medida que c crece y tiende a cero. Entretanto, la norma crece linealmente con c y la frontera de decisión permanece fija.
El margen normalizado divide la puntuación con signo por la norma de w, por lo que no cambia con este reescalado. Por tanto, una pérdida decreciente puede significar únicamente una confianza creciente en una geometría inalterada. También puede acompañar a un cambio de dirección; la pérdida por sí sola no permite distinguirlo. Un registro de la pérdida, la norma, el margen mínimo normalizado y el error de clasificación permite diferenciar estas alternativas. Esta recomendación diagnóstica se deriva directamente de las definiciones.
4. Un ejemplo exacto con dos restricciones
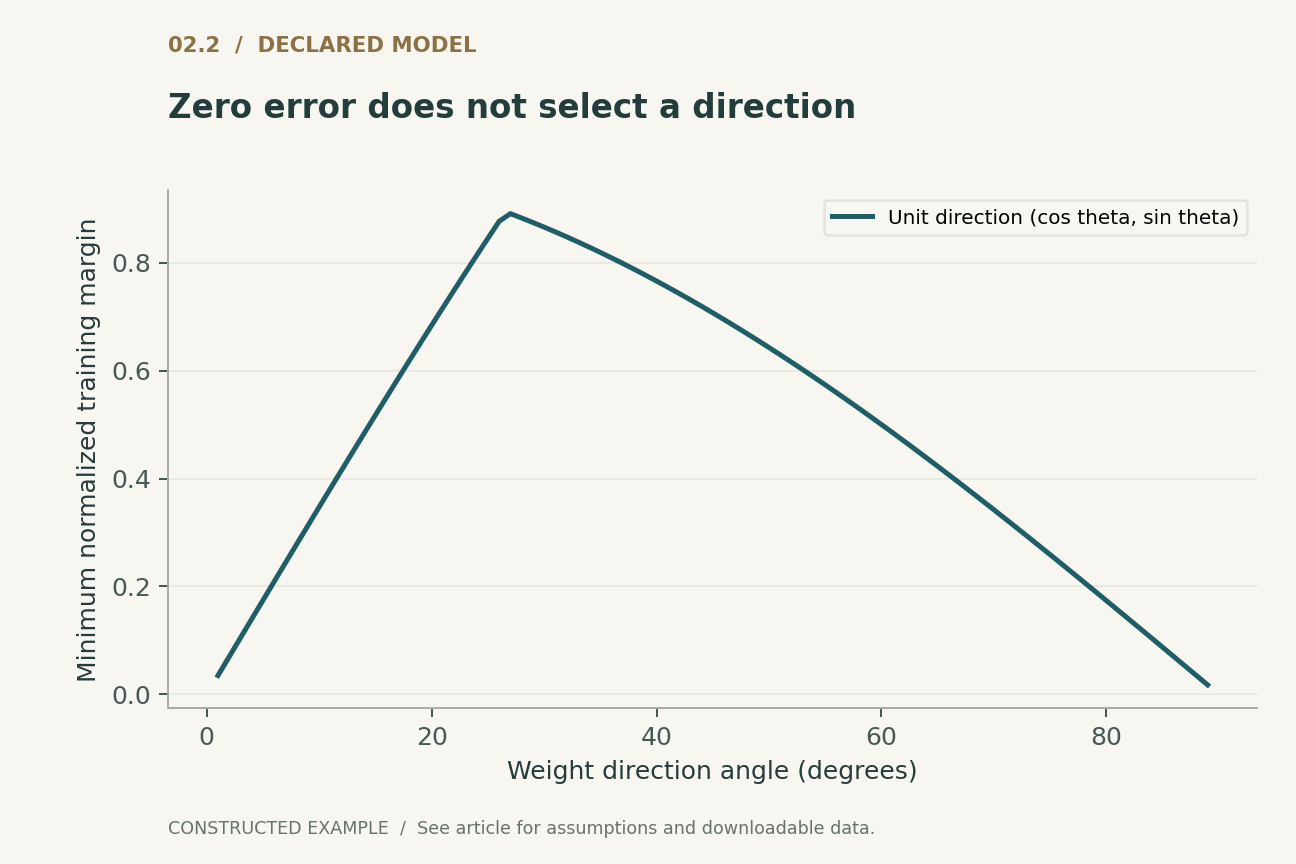
Considérense dos vectores de características con signo z1=(1,0) y z2=(0,2), donde una característica con signo significa y multiplicado por x. Las restricciones de margen funcional unitario pasan a ser w1>=1 y w2>=1/2. Minimizar el cuadrado de la norma euclídea sujeto a estas restricciones da w=(1,1/2), ya que aumentar cualquiera de las coordenadas solo incrementa la función objetivo. Su margen mínimo normalizado es 2/sqrt(5).
Una dirección proporcional a (1,1) también clasifica correctamente ambas observaciones, pero su margen mínimo normalizado es 1/sqrt(2). Ambas tienen un error de entrenamiento nulo. A igual norma tienen puntuaciones mínimas distintas y, tras un reescalado positivo arbitrario, ambas pueden alcanzar una pérdida logística extremadamente pequeña. Esta construcción aísla la información que descarta la métrica de error nulo sin depender de un conjunto de datos no documentado ni de una red entrenada.
5. Por qué una dirección lenta puede quedar oculta tras una pérdida que desciende rápidamente
Una vez que todas las puntuaciones son grandes y positivas, los gradientes logísticos ponderan mucho más las observaciones de menor margen que las de mayor margen. Esto se deduce de la derivada, cuya magnitud es 1/(1+exp(m)) para una puntuación con signo m. En nuestro ejemplo de dos coordenadas, el descenso por gradiente actualiza las coordenadas a ritmos distintos porque difieren tanto las magnitudes de sus características como sus puntuaciones actuales.
A medida que crecen los parámetros, disminuyen las magnitudes absolutas de las actualizaciones. Por ello, el clasificador puede parecer estacionario según un umbral basado en la pérdida mientras su dirección normalizada sigue cambiando. La ejecución finita proporcionada ilustra esta separación, pero no estima una tasa de convergencia asintótica a partir de una trayectoria corta. Una afirmación sobre la tasa requeriría el teorema pertinente con sus supuestos o un diseño experimental capaz de distinguir formas asintóticas alternativas en un intervalo justificado.
6. Los cambios de coordenadas modifican la optimización euclídea
Sea w=A theta para una matriz diagonal invertible A. Las funciones lineales representadas no cambian porque cada w sigue teniendo un theta correspondiente. Un paso de gradiente euclídeo en theta induce un paso en w precondicionado por A multiplicada por su transpuesta. En consecuencia, la trayectoria en el espacio de funciones depende del sistema de coordenadas, aunque la capacidad de representación sea idéntica.
Una restricción de norma mínima en theta corresponde a una norma elipsoidal en w. Esta observación no afirma que todo optimizador converja necesariamente a ese mínimo; identifica la geometría a la que se referiría una conclusión basada en la norma. Nuestra comprobación compara una actualización directa de w con una actualización parametrizada mediante A en la misma función representada. Los gradientes están relacionados por la regla de la cadena, y las funciones siguientes generalmente difieren. Se trata de un contraejemplo finito y reproducible de la invariancia del descenso por gradiente ordinario respecto de la parametrización.
7. Un valor atípico puede determinar la separación geométrica
La construcción de margen duro otorga una influencia decisiva a las restricciones más próximas a la frontera de separación. Añádase al ejemplo un punto con signo igual a epsilon por (1,0). Su restricción exige w1>=1/epsilon. A medida que epsilon se aproxima a cero, la solución de norma mínima gira hacia el primer eje y su norma aumenta. Todo epsilon positivo finito sigue permitiendo una clasificación perfecta.
Esto no significa que todos los ejemplos raros sean ruido o deban eliminarse. Un punto raro puede representar una población importante. El ejemplo muestra, en cambio, que maximizar un margen geométrico empírico está condicionado por las observaciones, las etiquetas y la escala de las características. Si un punto mal etiquetado o corrupto cambia la separabilidad, cambia el propio problema. Por tanto, la procedencia de los datos y la incertidumbre sobre las etiquetas deben formar parte de cualquier interpretación del sesgo aparente de un optimizador.
8. La no separabilidad cambia la pregunta
Inclúyanse en un conjunto de datos dos vectores de características idénticos con etiquetas opuestas. Ningún clasificador lineal homogéneo determinista puede asignar a ambos puntuaciones con signo positivas. Para su contribución logística aislada, aumentar arbitrariamente la magnitud empeora un término mientras mejora el otro. La pérdida de ese par contradictorio se minimiza con una puntuación nula.
Un conjunto de datos mayor puede contener tanto estructura contradictoria como direcciones que aún permitan separar un subconjunto. El análisis de datos no separables de Ji y Telgarsky es pertinente porque evita imponer a esos datos una visión de la separabilidad de todo o nada. En este artículo solo comprobamos el par contradictorio simétrico y explicamos su óptimo finito. No inferimos la descomposición completa de un conjunto de datos realista a partir de una curva de pérdida ni de un error de entrenamiento bajo. [2]
9. La generalización es una inferencia adicional
Un margen empírico grande solo puede ser útil en relación con una escala de características, una clase de hipótesis y un modelo de muestreo definidos. Si las entradas se reescalan arbitrariamente, un margen bruto puede cambiar sin que exista nueva evidencia sobre las etiquetas no observadas. Si una representación se selecciona después de examinar un conjunto de prueba, un margen medido en esa representación deja de tener la interpretación de una evaluación declarada de antemano.
Ni siquiera un teorema correcto sobre optimización identifica la distribución de la población. Para evaluar la generalización, manténgase un conjunto verdaderamente reservado, evalúese el comportamiento por subgrupos y distribuciones, y distíngase la calibración de probabilidades de la exactitud de las etiquetas. Nuestro ejemplo construido carece deliberadamente de etiquetas poblacionales fuera de sus dos restricciones. Sería matemáticamente injustificado atribuir a una dirección una ventaja en exactitud de prueba solo porque su margen de entrenamiento es mayor.
10. Un estudio falsable del sesgo
Un experimento propuesto debería declarar el objeto límite predicho antes del entrenamiento: una dirección en el espacio de entrada, una norma en el espacio de parámetros o un clasificador en el espacio de funciones. Después debería registrar las cantidades necesarias para comparar el modelo entrenado con ese objeto. Para problemas pequeños, un problema de optimización con restricciones resuelto de forma independiente es una referencia útil; para redes no lineales, la salida no verificada de un solucionador constituye por sí misma una incertidumbre.
Los ejemplos complementarios comprueban las restricciones exactas, la invariancia de la norma bajo escalado positivo, la identidad de precondicionamiento de la regla de la cadena y el óptimo del par contradictorio. Ponen de manifiesto cómo pueden fallar las conclusiones cuando cambia un supuesto. Son deliberadamente finitos. La conclusión defendible no es que el sesgo implícito resuelva la generalización, sino que la optimización selecciona una geometría que debe nombrarse, medirse y distinguirse del hecho de ajustar las etiquetas.
11. Las reglas de parada forman parte del objeto científico
Dos ejecuciones de entrenamiento con el mismo optimizador y la misma inicialización, pero con reglas de terminación distintas, no tienen por qué materializar la misma afirmación práctica. Un umbral de pérdida favorece una escala de confianza; un presupuesto fijo de pasos favorece un punto concreto de la trayectoria direccional; una regla de validación introduce otra muestra y un procedimiento adicional de selección. Ninguna es intrínsecamente incorrecta, pero combinar sus resultados bajo una misma etiqueta oscurece la comparación.
Un informe debería indicar si el punto de control elegido minimiza la pérdida de validación, maximiza la exactitud de validación o simplemente completa un programa fijo. Debería conservar la trayectoria de puntos de control para poder inspeccionar una supuesta mejora del margen una vez fijada la regla de decisión. Esto es especialmente importante cuando la pérdida de validación aumenta a medida que las puntuaciones expresan mayor confianza: un cambio en la calidad de las probabilidades y un cambio en la geometría de clasificación no tienen por qué tener el mismo signo.
12. Un margen no es una estimación de probabilidad
El escalado positivo mantiene fija la frontera de decisión, pero desplaza las probabilidades logísticas hacia cero o uno. Si la verdadera probabilidad condicional en una entrada concreta no coincide con ninguno de los extremos, una confianza suficientemente grande puede empeorar su puntuación logarítmica esperada aunque la etiqueta predicha siga siendo correcta. Por tanto, el problema de selección geométrica y el de estimación probabilística deben evaluarse con observables distintos.
Ejecutado localmente · Alcance acotado
Márgenes, cambios de coordenadas y etiquetas contradictorias
Geometría finita con dos restricciones, pasos de gradiente explícitos y 101 puntuaciones del par contradictorio. El descenso finito no demuestra los teoremas asintóticos citados.
Se superaron 116 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "maximum_margin": 0.8944271909999159,
  "trajectory_step_loss_margin": [
    [
      1,
      0.5533380097486379,
      0.4472135954999579
    ],
    [
      10,
      0.2114391196724853,
      0.6472679469278612
    ],
    [
      100,
      0.02618021290683939,
      0.8076515825626189
    ],
    [
      1000,
      0.002528703690596741,
      0.8472075680971195
    ],
    [
      10000,
      0.00025045209849889,
      0.8617419583557351
    ]
  ],
  "direct_gradient": [
    -0.16590611391591695,
    -0.31002551887238755
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Pérdida logística lineal homogénea binaria; sin penalización explícita ni coordenada de sesgo, salvo que se incluya en x.
(2) El margen empírico normalizado es invariante a la escala para w no nulo.
(3) Solución exacta de norma mínima para los dos vectores con signo del artículo; no es una solución general para redes profundas.
(4) Un paso de gradiente euclídeo en theta; A es fija e invertible.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Observación | Qué identifica | Qué no identifica |
|---|---|---|
| Error de clasificación nulo | Signos en los puntos de entrenamiento | Dirección o calibración |
| Pérdida logística decreciente | Mejora del objetivo de puntuación media de entrenamiento | Una frontera cambiante |
| Margen normalizado grande | Geometría en una norma especificada | Etiquetas poblacionales o invariancia causal |
Una propuesta de protocolo de validación
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Fijar la escala de las características, las etiquetas, la normalización de la pérdida y la parametrización.
- Resolver un pequeño problema de margen de referencia con independencia del descenso por gradiente.
- Registrar el error, la pérdida, la norma, la dirección y el margen normalizado en cada punto de control.
- Repetir con una transformación de coordenadas que preserve las funciones representadas.
- Introducir un par contradictorio declarado e inspeccionar el cambio de comportamiento.
- Informar de la regla de parada y mantener la evaluación de prueba separada de la selección del punto de control.
Qué establecen las fuentes primarias
Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al. · 2018 [1]
Contribución. Caracteriza el comportamiento direccional de margen máximo de predictores lineales homogéneos sobre datos separables bajo las condiciones de descenso por gradiente indicadas.
Límite de alcance. No se trata de un teorema general para redes no lineales finitas arbitrarias.
Localización en la fuente. Artículo primario, sección 2 y teorema principal de convergencia direccional.
Ziwei Ji, Matus Telgarsky · 2019 [2]
Contribución. Analiza el comportamiento del gradiente logístico cuando los datos no son completamente separables.
Límite de alcance. Un rayo separable y una componente acotada requieren la descomposición precisa del artículo.
Localización en la fuente. Resumen primario de PMLR y marco de los teoremas.
Lénaïc Chizat, Francis Bach · 2020 [3]
Contribución. Relaciona el entrenamiento de dos capas de anchura infinita con un margen en el espacio de funciones.
Límite de alcance. La geometría funcional límite y los supuestos de entrenamiento difieren de los del ejemplo lineal finito.
Localización en la fuente. Resumen primario de PMLR; formulación de anchura infinita y activaciones homogéneas.
Límites de este análisis
- El conjunto de datos del ejemplo desarrollado contiene solo dos restricciones con signo y no tiene asignada una población de prueba.
- Las trayectorias finitas no demuestran la convergencia direccional asintótica.
- La referencia no lineal se refiere a un entorno idealizado de anchura infinita.
- Los márgenes dependen de la escala de las características y de la norma elegida.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la bibliografía hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué diagnósticos de anchura finita distinguen mejor un margen en el espacio de funciones de una aproximación sustitutiva en el espacio de parámetros?
- ¿Cómo cambia una regla de parada dependiente de los datos el sesgo práctico que se está midiendo?
- ¿Cuándo dominan la incertidumbre de las etiquetas y el reescalado de características sobre la preferencia de margen del optimizador?
Referencias
- Daniel Soudry, Elad Hoffer, Mor Shpigel Nacson et al.. The Implicit Bias of Gradient Descent on Separable Data. Journal of Machine Learning Research 19(70) (2018). Primary source.
- Ziwei Ji, Matus Telgarsky. The implicit bias of gradient descent on nonseparable data. Proceedings of the Thirty-Second Conference on Learning Theory, PMLR 99 (2019). Primary source.
- Lénaïc Chizat, Francis Bach. Implicit Bias of Gradient Descent for Wide Two-layer Neural Networks Trained with the Logistic Loss. Proceedings of Thirty Third Conference on Learning Theory, PMLR 125 (2020). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el registro de JMLR y el contexto de la introducción y del teorema en el PDF primario; la demostración completa no se auditó de forma independiente.
Acceso a la fuente [2]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Las identidades bibliográficas se cotejaron con los registros primarios de los editores y autores. Las notas sobre acceso a las fuentes y versiones que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.