
Resumen
El ruido del gradiente suele tratarse como una única cantidad beneficiosa. Separamos tres preguntas: con qué precisión estima un minilote un gradiente, cómo distribuye un optimizador discreto los parámetros cerca de un mínimo estable y cómo se gastan los recursos computacionales para alcanzar una pérdida objetivo. Un cálculo de población finita y una función cuadrática con ruido resoluble de forma exacta muestran por qué mantener una razón entre tasa de aprendizaje y tamaño de lote no preserva todo el proceso de entrenamiento. Los ejemplos ponen de manifiesto un límite de estabilidad discreta, incertidumbre anisótropa y una ambigüedad en la contabilidad de recursos, sin pretender reproducir una prueba de referencia de redes neuronales. Trabajos fundacionales seleccionados motivan el análisis; la principal contribución de esta perspectiva es una cadena explícita de supuestos y comparaciones falsables.
1. Tres significados del ruido
Un optimizador puede tener una estimación ruidosa del gradiente, una trayectoria variable de los parámetros y una puntuación de prueba variable. Son variables aleatorias diferentes. El ruido del gradiente se define condicionado a los parámetros y a una regla de muestreo. El ruido de la trayectoria acumula esas perturbaciones condicionales mediante una aplicación de actualización que evoluciona. La variación de la puntuación de prueba también contiene variaciones debidas a la selección del conjunto de datos, la inicialización y la evaluación. Un escalar comunicado para una de estas cantidades no puede sustituir a las demás.
Nuestra pregunta es, por tanto, operativa: ¿qué aspectos del entrenamiento son invariantes cuando cambia el tamaño de lote? Una respuesta útil debe especificar la coordenada temporal, la normalización del gradiente, si los ejemplos se muestrean con reemplazo y si cambian las tasas de aprendizaje. Sin esas decisiones, incluso las unidades de una escala de ruido propuesta son ambiguas. Partimos del modelo más pequeño que distingue estas opciones y utilizamos sus fallos para diseñar comparaciones para redes neuronales.
2. Qué establecen las investigaciones seleccionadas
Mandt, Hoffman y Blei analizan la optimización estocástica de paso constante como inferencia bayesiana aproximada bajo una descripción local mediante procesos estocásticos. Smith y Le relacionan la tasa de aprendizaje y el tamaño de lote en datos finitos mediante un argumento de escala de ruido. McCandlish y sus colegas investigan un estadístico del ruido del gradiente como predictor del tamaño de lote útil para el paralelismo. Son perspectivas complementarias: distribuciones estacionarias, dinámicas motivadas por la generalización y eficiencia de recursos.
En conjunto, estos trabajos no establecen que todo optimizador ruidoso muestree una distribución posterior calibrada, que un mayor ruido siempre mejore la exactitud sobre datos reservados ni que exista un tamaño de lote universalmente óptimo. Los cálculos que siguen son nuestros propios ejemplos finitos. Eliminan deliberadamente el aprendizaje de representaciones y la curvatura cambiante para que siga siendo visible la distinción entre error de aproximación y evidencia experimental. [1], [2], [3]
3. El muestreo sin reemplazo modifica la varianza
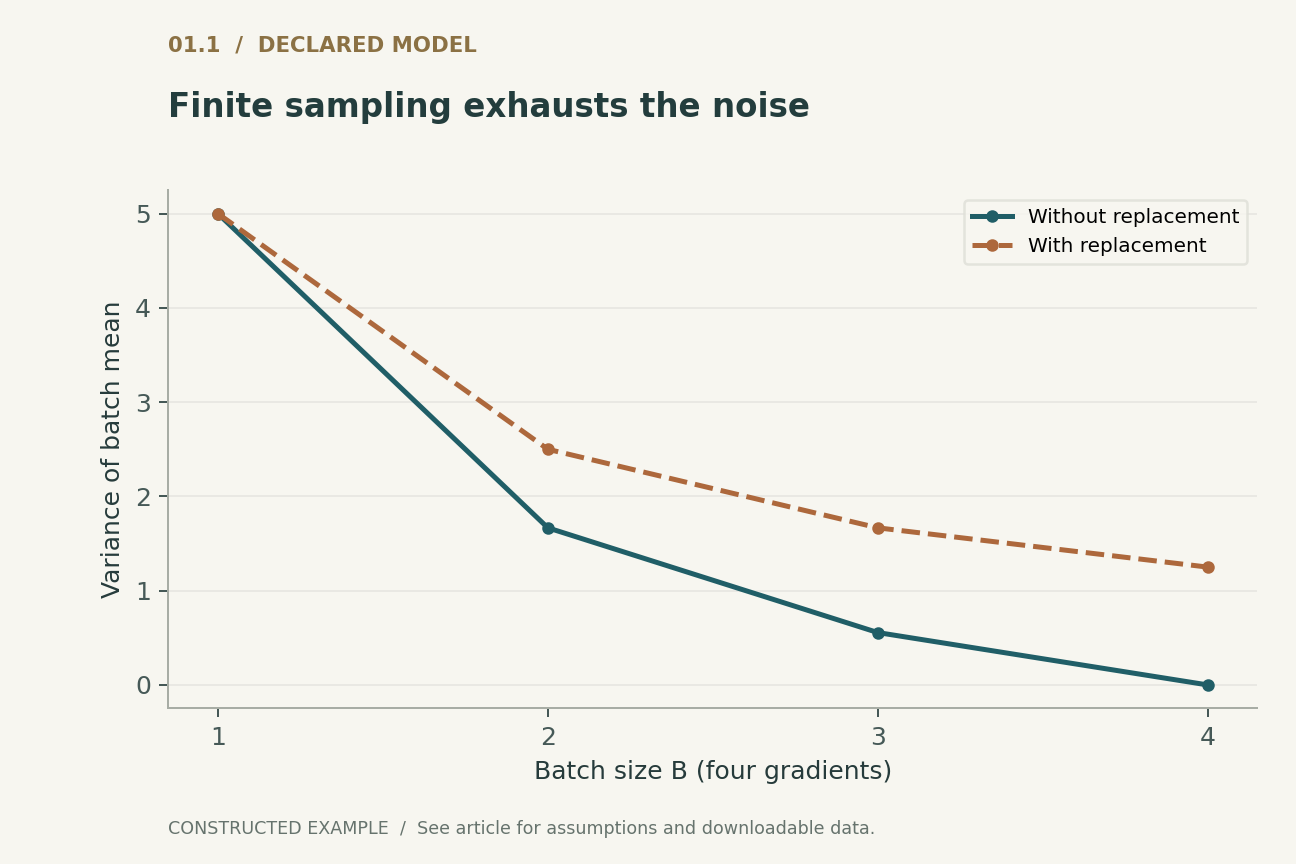
Fijemos N gradientes escalares, uno por ejemplo, y definamos su varianza poblacional con denominador N. La varianza de la media de un subconjunto extraído uniformemente de B ejemplos distintos es igual a esa varianza poblacional multiplicada por (N-B)/(B(N-1)). El factor no es un detalle contable opcional: cuando B=N, la varianza de muestreo es exactamente cero. En cambio, el muestreo independiente con reemplazo da la varianza dividida por B, incluso si el número de extracciones es igual a N.
Consideremos la población finita de gradientes 1, 3, 5, 7. Su media es 4 y su varianza poblacional es 5. La enumeración de los seis lotes distintos de tamaño dos da las medias de lote 2, 3, 4, 4, 5, 6 y una varianza de 5/3. Seis es el número de subconjuntos no ordenados, no el número de pasos de SGD. Esta enumeración exacta se convierte en una prueba compacta de los supuestos de muestreo de un cargador de datos.
4. Un cálculo exacto de la varianza estacionaria discreta
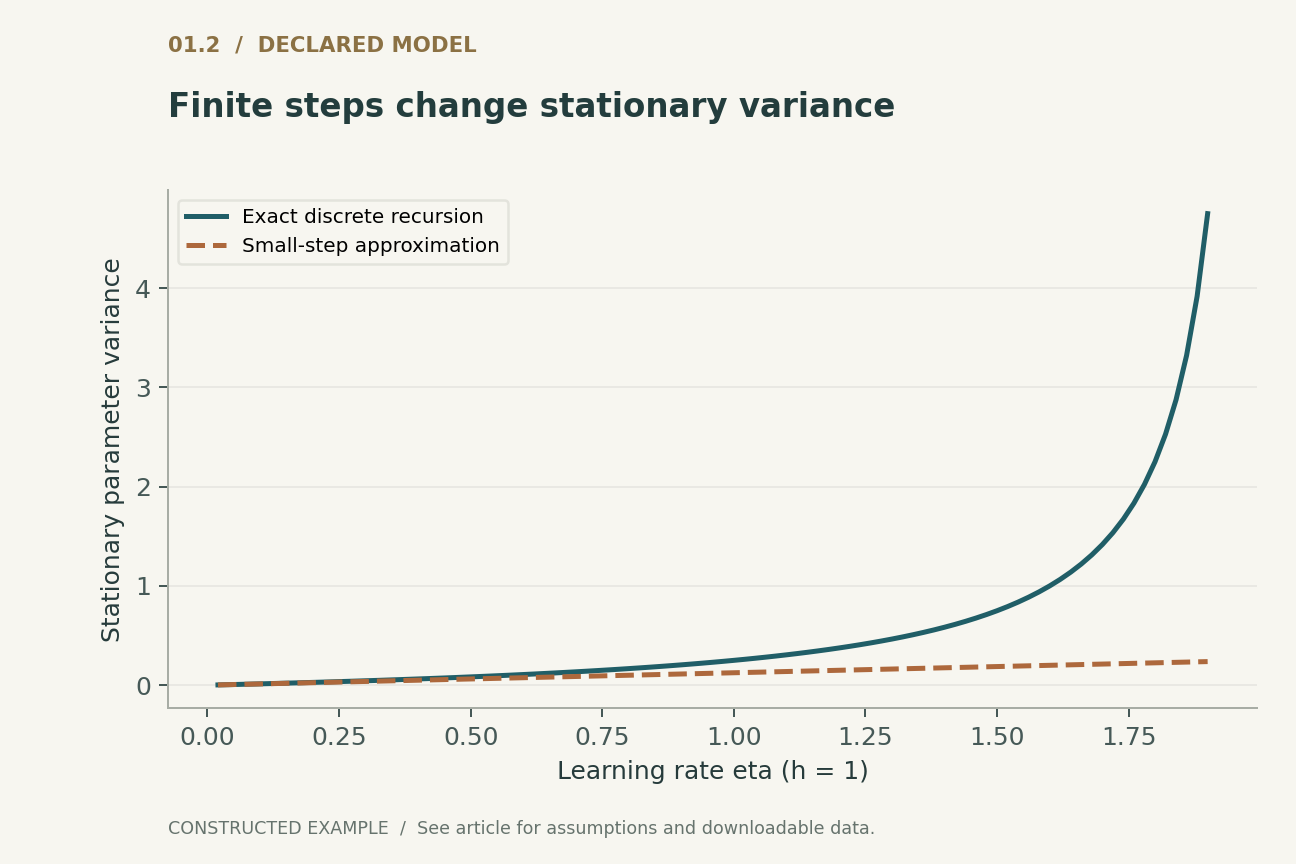
Sea el objetivo una función cuadrática escalar con curvatura h>0, y supongamos que el estimador del gradiente añade ruido independiente de media cero y varianza sigma al cuadrado dividida por B. SGD con paso constante es una autorregresión con coeficiente 1-eta h. La estabilidad exige que su valor absoluto sea menor que uno. En ese intervalo, la suma de la serie geométrica de la varianza acumulada da eta por sigma al cuadrado dividido por B h(2-eta h).
El denominador contiene la corrección discreta que descarta una aproximación de difusión para pasos pequeños. Con h=1, sigma squared=1, B=4 y eta=0.5, la varianza estacionaria es 1/12. La aproximación correspondiente de orden principal para pasos pequeños es 1/16. Ninguno de los resultados es un estadístico observado en una red neuronal. Su diferencia es una advertencia calculable de forma exacta sobre el uso de una aproximación continua con un tamaño de paso finito.
5. Una razón constante no preserva el proceso
Supongamos que eta/B se mantiene fija mientras aumentan tanto eta como B. La aproximación de pasos pequeños predice una varianza inalterada, pero el denominador exacto conserva eta h. En nuestra función cuadrática normalizada, los pares (eta,B)=(0.1,1) y (0.4,4) producen varianzas estacionarias diferentes pese a tener razones idénticas. Además, sus factores de contracción de la media por actualización difieren, por lo que sus errores transitorios difieren incluso antes de que la estacionariedad resulte pertinente.
Igualar los ejemplos procesados no resuelve la discrepancia: una actualización con el lote mayor utiliza cuatro veces más ejemplos y modifica la media con un paso mayor. Igualar el tiempo real transcurrido requiere un modelo del hardware además del modelo estocástico. Por tanto, una regla de escalado puede ser una aproximación local útil y, a la vez, fallar como equivalencia exacta. Una comparación controlada debería identificar el observable que espera preservar.
6. Importan la curvatura y la orientación del ruido
Una función cuadrática vectorial sustituye la contracción escalar por una matriz. En una base en la que tanto la curvatura como la covarianza del ruido son diagonales, cada coordenada sigue su propia recurrencia escalar. Una tasa de aprendizaje común puede estar cerca del límite de estabilidad en una coordenada y ser conservadora en otra. La mayor curvatura controla la estabilidad, mientras que la distribución del ruido inyectado controla qué direcciones fluctúan.
Cuando las matrices no conmutan, sus entradas diagonales no pueden emparejarse sin más; la covarianza estacionaria resuelve una ecuación de Lyapunov discreta. Sus entradas fuera de la diagonal pueden ser distintas de cero. Por ello, dos estimadores del gradiente con la misma traza de la covarianza pueden generar distribuciones de parámetros diferentes. Una única escala de ruido pierde información direccional precisamente donde los valles estrechos y los acoplamientos entre parámetros la hacen útil. Las comprobaciones suministradas verifican la ecuación matricial de covarianza en una construcción bidimensional definida positiva.
7. Hablar de una distribución posterior exige identificar el objetivo
Para llamar distribución posterior a la distribución estacionaria de un optimizador, es preciso especificar una verosimilitud, una distribución previa, un tamaño de conjunto de datos y una medida sobre los parámetros. Una covarianza inyectada arbitraria no suele ser la covarianza que requiere ese modelo estadístico. Incluso en una función cuadrática, igualar una sola varianza escalar no identifica la distribución multidimensional completa. Reparametrizar un modelo también cambia lo que significa el ruido euclídeo.
La interpretación como inferencia aproximada es valiosa porque hace explícitos esos requisitos. No debe convertirse en una afirmación general de que la incertidumbre de SGD es incertidumbre bayesiana. En un experimento práctico, la cobertura predictiva podría evaluarse sobre resultados reservados, mientras que la covarianza de los parámetros podría compararse con una distribución posterior de referencia tratable. Son pruebas distintas con hipótesis nulas distintas. La coincidencia únicamente en la pérdida de entrenamiento no permite establecer ninguna de las dos. [1]
8. La contabilidad de recursos produce óptimos distintos
Imaginemos un modelo de dispositivo en el que una actualización cuesta una sobrecarga fija de lanzamiento más un término proporcional al tamaño de lote. Aumentar B amortiza la sobrecarga, pero reduce el número de actualizaciones de parámetros dentro de un presupuesto fijo de ejemplos. Una política óptima en pasos y una política óptima en ejemplos no tienen por qué coincidir. La comunicación, los límites de memoria y el relleno introducen restricciones adicionales que este modelo simple omite.
Un estudio útil del tamaño de lote informaría conjuntamente de los pasos del optimizador, los ejemplos procesados, el tiempo transcurrido y la pérdida alcanzada. También distinguiría el tamaño de lote solicitado del lote efectivo tras la acumulación o el descarte de ejemplos. Por ello, nuestras figuras representan la varianza frente al tamaño de lote y la tasa de aprendizaje, no una curva de rendimiento de procesamiento inventada. Una afirmación sobre la capacidad real de procesamiento exige mediciones en una pila de ejecución especificada, con un tratamiento coherente del calentamiento y la sincronización. [3]
9. Cómo poner a prueba la extrapolación a redes neuronales
Una extensión significativa fijaría la partición del conjunto de datos, la arquitectura, la distribución de inicialización, la política de aumento de datos y el calendario de evaluación, y después variaría los parámetros de muestreo y del optimizador en un diseño factorial declarado. Un estudio piloto puede estimar la covarianza del gradiente en varios niveles de pérdida equiparados, en lugar de hacerlo solo en la inicialización. Esas estimaciones deberían utilizar minilotes independientes e informar de la incertidumbre tanto de la media del gradiente como de la covarianza.
La predicción clave es condicional, no universal: si el modelo local es adecuado, la covarianza y la relajación observadas deberían seguir su corrección de paso finito en una región acotada. El fallo podría deberse a una curvatura cambiante, lotes correlacionados, un aumento de datos no estacionario, el momento o la salida de la cuenca local. Registrar estas alternativas convierte un resultado negativo en evidencia diagnóstica. Seleccionar únicamente los puntos de control en los que la aproximación coincide por casualidad haría circular la comparación.
10. Qué puede respaldar la evidencia ejecutable
El código complementario enumera todos los tamaños de lote no vacíos para una población de cuatro gradientes, comprueba la identidad de población finita y verifica la covarianza estacionaria mediante una recurrencia y mediante la solución de un sistema lineal. También construye un tamaño de paso fuera del intervalo estable y confirma que las desviaciones deterministas crecen. Estas pruebas abarcan la aritmética, las condiciones de frontera y un contraejemplo concreto a la invariancia al mantener la razón.
No entrenan una red neuronal, no miden la generalización ni validan una ley de escalado universal. Su propósito es permitir la inspección de la lógica del artículo antes de intentar un experimento costoso. La conclusión resultante es limitada pero útil: el tamaño de lote no puede interpretarse independientemente del tamaño de paso, el muestreo, la geometría y el recurso que se optimiza. Toda afirmación empírica más fuerte requiere medir esas cantidades en lugar de presuponerlas tácitamente.
11. La correlación y el error transitorio son factores de control distintos
El supuesto de ruido independiente puede ponerse a prueba en lugar de tratarse como un detalle de implementación. Si dos errores sucesivos del gradiente están correlacionados, aparecen términos cruzados en la varianza acumulada de los parámetros. Barajar una vez por época, visitar repetidamente ejemplos relacionados o reutilizar un flujo de aumento de datos puede crear una estructura temporal que no capta una estimación de covarianza por paso. Entonces, una fórmula de varianza estacionaria derivada para incrementos independientes es una referencia incorrecta, aunque la varianza marginal del ruido no cambie.
El punto de partida también importa. En el modelo escalar, la media se contrae como (1-eta h) elevado a t, mientras que la varianza se aproxima a su límite mediante el cuadrado de ese factor. El error cuadrático esperado de los parámetros es la suma del cuadrado de la media y la varianza. Al principio del entrenamiento, reducir el sesgo puede dominar el efecto de un nivel mínimo de varianza más alto; después, ese nivel mínimo puede dominar. Esta descomposición proporciona una razón concreta para especificar un horizonte de entrenamiento antes de calificar un nivel de ruido como mejor que otro.
Ejecutado localmente · Alcance acotado
Identidades de muestreo y covarianza discreta
Enumera todos los tamaños de subconjunto no vacíos de una población de cuatro gradientes y verifica una covarianza estable en 2 dimensiones. No aporta evidencia de calibración posterior ni de generalización.
Se superaron 10 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testimonio de ejecución registrado
{
  "finite_population_variances": [
    5.0,
    1.6666666666666667,
    0.5555555555555556,
    0.0
  ],
  "scalar_stationary_variance": 0.08333333333333333,
  "matrix_covariance": [
    [
      0.015622805157421303,
      0.0009863914506035294
    ],
    [
      0.0009863914506035294,
      0.019337634775857728
    ]
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Subconjunto elegido uniformemente de B gradientes distintos de una población fija de tamaño N, con N>1; la varianza poblacional utiliza el denominador N.
(2) Ruido aditivo independiente de media cero, curvatura escalar h>0, eta y B constantes.
(3) Varianza estacionaria discreta exacta; diverge en el límite y difiere de la aproximación de pasos pequeños.
(4) Ecuación de covarianza discreta cuando el radio espectral de I-eta H es menor que uno y el ruido aditivo tiene covarianza fija Sigma/B.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Cantidad | Se mantiene fijo | Qué queda sin resolver |
|---|---|---|
| Varianza del gradiente | Parámetros y muestreador | Trayectoria y generalización |
| Covarianza estacionaria | Dinámica local estable | Aprendizaje de representaciones no estacionario |
| Tiempo hasta el objetivo | Hardware y objetivo | Calidad estadística a igual coste |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Reproducir la enumeración de población finita antes de ejecutar un cargador de datos.
- Especificar si los gradientes se suman o se promedian y la política de reemplazo del muestreo.
- Estimar la covarianza en puntos de control equiparados mediante lotes independientes.
- Comparar las predicciones discretas exactas y las de pasos pequeños con intervalos de confianza.
- Informar por separado de los pasos, los ejemplos, el tiempo transcurrido y la calidad sobre datos reservados.
- Declarar de antemano los criterios de fallo del modelo y conservar las ejecuciones inestables o divergentes.
Qué establecen las fuentes primarias
Stephan Mandt, Matthew D. Hoffman, David M. Blei · 2017 [1]
Contribución. Desarrolla una interpretación de SGD con paso constante como inferencia aproximada.
Límite de validez. Son esenciales las aproximaciones estocásticas locales y un modelo estadístico identificado.
Localización en la fuente. Resumen; análisis local de procesos estocásticos en el artículo primario.
Samuel L. Smith, Quoc V. Le · 2017 [2]
Contribución. Relaciona la escala de ruido de SGD con la tasa de aprendizaje y el tamaño de lote en datos finitos.
Límite de validez. Una aproximación de escalado no es una invariancia exacta de las trayectorias del optimizador discreto.
Localización en la fuente. Sección 5 y apéndice C del manuscrito de los autores.
Sam McCandlish, Jared Kaplan, Dario Amodei et al. · 2018 [3]
Contribución. Estudia el ruido del gradiente como predictor de la utilidad del entrenamiento con lotes grandes.
Límite de validez. La utilidad empírica depende de la tarea medida y del objetivo relativo al tiempo de cómputo.
Localización en la fuente. Resumen y planteamiento del modelo empírico.
Límites de este análisis
- El ruido aditivo independiente es un supuesto, no una propiedad de todos los gradientes de minilotes.
- La función cuadrática tiene curvatura fija y no puede representar cambios de cuenca.
- No se entrenó ninguna red neuronal ni se realizó una prueba de referencia de hardware.
- Igualar la varianza de los parámetros no permite establecer la calibración predictiva.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso a las fuentes y de versión se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué direcciones de covarianza predicen mejor el fallo de una aproximación escalar de la escala de ruido?
- ¿Qué parte del efecto del tamaño de lote persiste al igualar la trayectoria del optimizador en lugar del número de ejemplos?
- ¿Puede una planificación adaptativa controlar tanto un margen de estabilidad como un presupuesto de recursos declarado?
Referencias
- Stephan Mandt, Matthew D. Hoffman, David M. Blei. Stochastic Gradient Descent as Approximate Bayesian Inference. Journal of Machine Learning Research 18(134) (2017). Primary source.
- Samuel L. Smith, Quoc V. Le. A Bayesian Perspective on Generalization and Stochastic Gradient Descent. arXiv:1710.06451 (2017). 10.48550/arXiv.1710.06451.
- Sam McCandlish, Jared Kaplan, Dario Amodei et al.. An Empirical Model of Large-Batch Training. arXiv:1812.06162 (2018). 10.48550/arXiv.1812.06162.
Acceso a la fuente [1]. Se inspeccionaron el registro bibliográfico de JMLR, el resumen y la parte inicial del texto PDF; los cálculos estacionarios locales se derivaron de forma independiente.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y el manuscrito HTML de los autores, incluidas la formulación de la escala de ruido y los títulos de las secciones.
Nota de versión. El registro citado se presentó por primera vez en 2017; se inspeccionó la versión v3 (14 de febrero de 2018), indicada como ICLR 2018. El año bibliográfico se refiere al registro de arXiv.
Acceso a la fuente [3]. Se inspeccionaron el registro bibliográfico primario y el resumen; no se realizó una auditoría exhaustiva del texto completo ni del material suplementario.
Nota de versión. Se conserva el autor colectivo OpenAI Dota Team tal como figura en el registro primario.
Las identidades bibliográficas se contrastaron con los registros primarios de las editoriales y los autores. Las notas de acceso a las fuentes y de versión que siguen describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Escrito y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, con Python y CSV suministrados. No son mediciones de productos desplegados ni reproducciones de pruebas de referencia de rendimiento.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.