
要旨
勾配ノイズは、しばしば単一の有益な量として扱われる。本稿では、ミニバッチが勾配をどれほど正確に推定するか、離散的な最適化器が安定な極小点付近でパラメータをどのように分布させるか、目標損失に到達するまでに計算資源がどのように費やされるか、という三つの問いを分離する。有限母集団の計算と厳密に解けるノイズ付き二次関数により、学習率とバッチサイズの比を維持しても学習過程全体が保存されない理由を示す。これらの例は、ニューラルネットワークのベンチマークを再現すると主張することなく、離散時間の安定性境界、異方的な不確実性、資源計上の曖昧さを明らかにする。選定した基礎研究が分析の動機を与えるが、本パースペクティブの主な貢献は、仮定と反証可能な比較を明示的な連鎖として示すことにある。
1. ノイズの三つの意味
最適化器には、ノイズを含む勾配推定値、変動するパラメータ軌道、変動するテストスコアがありうる。これらは異なる確率変数である。勾配ノイズは、パラメータと抽出規則を条件として定義される。軌道ノイズは、変化する更新写像を通じてこれらの条件付き摂動を蓄積する。テストスコアの変動には、データセットの選択、初期化、評価に由来する変動も含まれる。これらの量の一つについて報告されたスカラー値で、他の量を代替することはできない。
したがって、本稿の問いは操作的なものである。バッチサイズが変わるとき、学習のどの側面が不変なのか。有用な回答には、時間座標、勾配の正規化、復元抽出の有無、学習率が変化するかどうかを明記する必要がある。これらの選択がなければ、提案されるノイズスケールの単位さえ曖昧になる。本稿では、これらの選択を区別できる最小のモデルから出発し、その破綻を利用してニューラルネットワークの比較を設計する。
2. 選定した研究が明らかにしていること
Mandt、Hoffman、Bleiは、局所的な確率過程の記述の下で、定ステップ確率的最適化を近似ベイズ推論として分析している。SmithとLeは、ノイズスケールに基づく議論を通じて、学習率と有限データにおけるバッチサイズを結び付けている。McCandlishらは、有効な並列バッチサイズの予測指標として勾配ノイズの統計量を検討している。これらは、定常分布、汎化を動機とするダイナミクス、資源効率という相補的な視点である。
これらの研究を合わせても、あらゆるノイズ付き最適化器が較正された事後分布からサンプリングすること、ノイズを増やせば常にホールドアウトデータ上の正解率が向上すること、普遍的に最適なバッチサイズが存在することは確立されない。以下の計算は、本稿独自の有限の例である。近似誤差と実験的証拠の区別を明確に保つため、表現学習と変化する曲率を意図的に取り除いている。 [1], [2], [3]
3. 非復元抽出は分散を変える
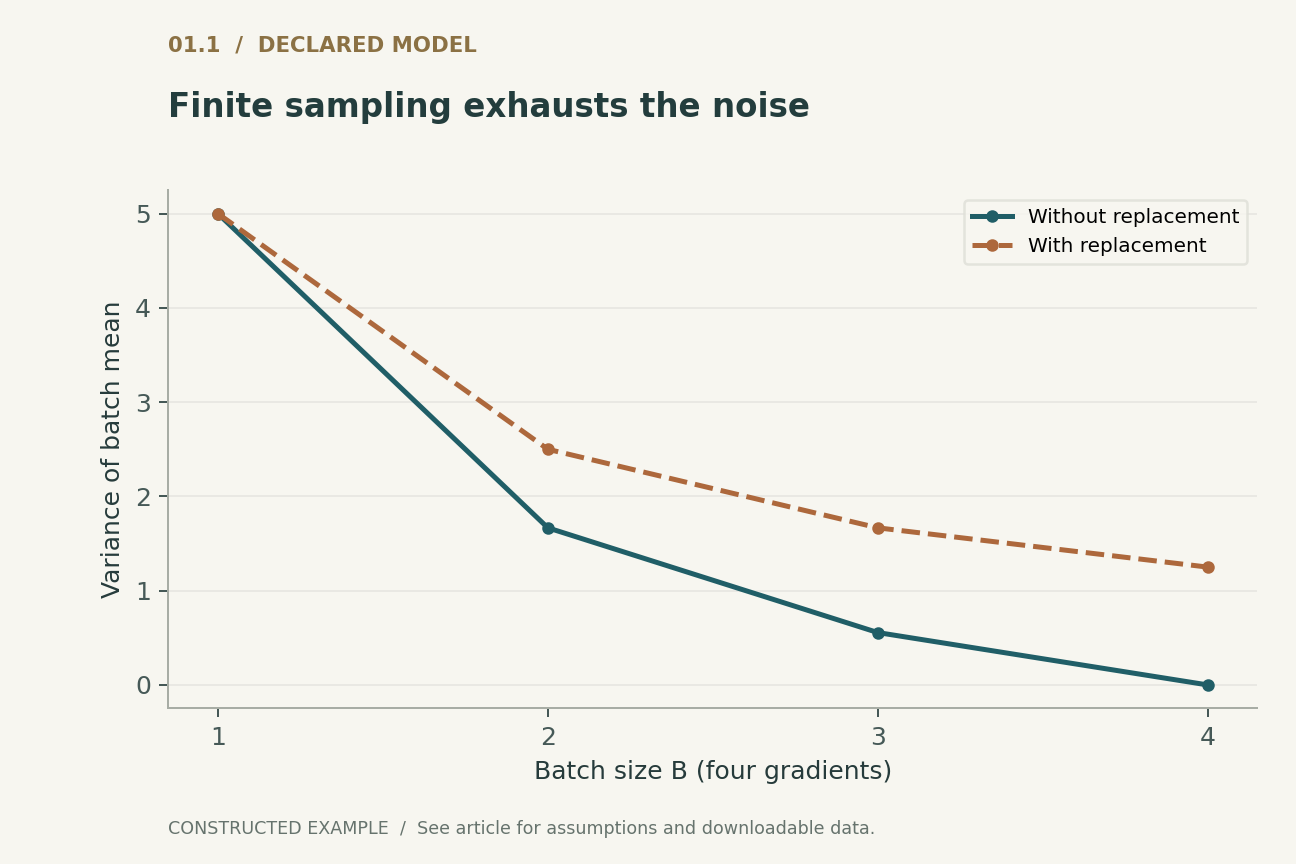
各例に対応するN個のスカラー勾配を固定し、分母をNとして母分散を定義する。異なるB個の例からなる部分集合を一様に抽出したとき、その平均の分散は、母分散に(N-B)/(B(N-1))を乗じた値に等しい。この係数は任意に省略できる帳尻合わせではない。B=Nでは、抽出による分散は厳密にゼロとなる。一方、独立な復元抽出では、抽出回数がNに等しくても、分散は母分散をBで割った値となる。
有限の勾配母集団1、3、5、7を考える。その平均は4、母分散は5である。サイズが二の異なる六つのバッチを列挙すると、バッチ平均は2、3、4、4、5、6となり、分散は5/3となる。六は順序を区別しない部分集合の数であり、SGDのステップ数ではない。この厳密な列挙は、データローダーの抽出に関する仮定を確かめる簡潔なテストとなる。
4. 離散時間における定常分散の厳密計算
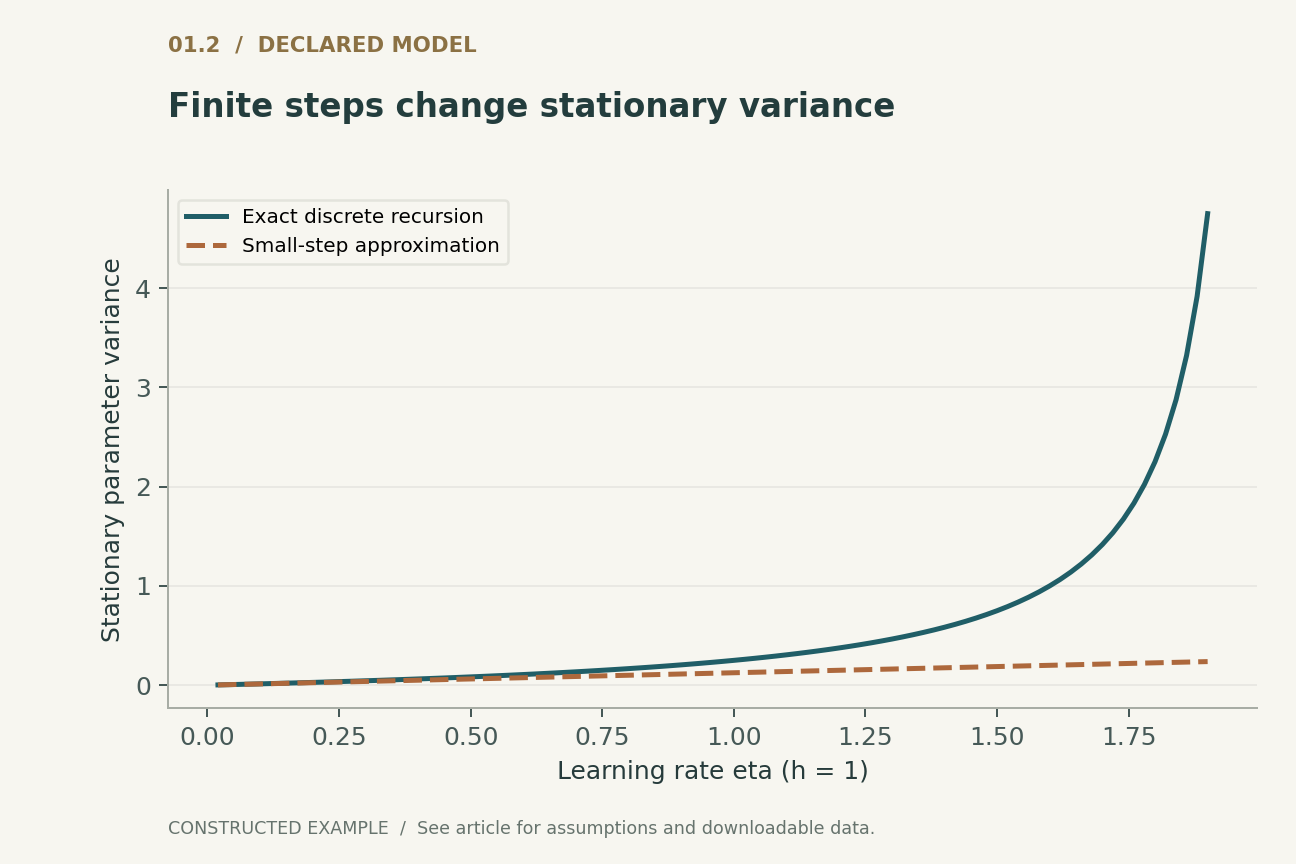
目的関数を曲率h>0のスカラー二次関数とし、勾配推定器が平均ゼロ、分散がsigmaの二乗をBで割った値の独立なノイズを加えるとする。定ステップSGDは、係数1-eta hの自己回帰過程である。安定性には、この係数の絶対値が一未満であることが必要となる。その区間では、蓄積分散の等比級数を足し合わせると、etaとsigmaの二乗の積をB h(2-eta h)で割った値が得られる。
分母には、小ステップの拡散近似では捨てられる離散時間の補正が含まれる。h=1、sigma squared=1、B=4、eta=0.5のとき、定常分散は1/12である。対応する小ステップ近似の主要項は1/16である。いずれの結果も、ニューラルネットワークで観測された統計量ではない。両者の差は、有限のステップサイズで連続近似を用いることに対する、厳密に計算可能な警告である。
5. 比を一定にしても過程は保存されない
etaとBをともに増やしながら、eta/Bを一定に保つとする。小ステップ近似は分散が変わらないと予測するが、厳密な分母にはeta hが残る。本稿の正規化された二次関数では、組(eta,B)=(0.1,1)と(0.4,4)は、比が同じであっても異なる定常分散を生む。さらに、更新ごとの平均の収縮係数も異なるため、定常性が問題となる以前から過渡誤差が異なる。
処理した例の数を揃えても、この不一致は解消されない。大きいバッチによる一回の更新は四倍の例を用い、より大きなステップで平均を変化させる。実経過時間を揃えるには、確率モデルに加えてハードウェアモデルが必要となる。したがって、スケーリング則は有用な局所近似でありえても、厳密な同値性としては成り立たないことがある。統制された比較では、どの観測量を保存すると期待するのかを明示すべきである。
6. 曲率とノイズの方向が重要である
ベクトル変数の二次関数では、スカラーの収縮が行列に置き換わる。曲率とノイズ共分散がともに対角となる基底では、各座標はそれぞれ独自のスカラー漸化式に従う。共通の学習率が、ある座標では安定性境界に近く、別の座標では控えめな値となることがある。最大の曲率が安定性を支配し、注入されるノイズの分布が、どの方向で変動するかを支配する。
行列が可換でない場合、それぞれの対角成分を単純に対応付けることはできない。定常共分散は離散リアプノフ方程式を満たす。その非対角成分は非ゼロになりうる。したがって、共分散のトレースが同じ二つの勾配推定器でも、異なるパラメータ分布を生成しうる。単一のノイズスケールでは、狭い谷やパラメータ間の結合によって方向情報が有用になるまさにその場面で、方向情報が失われる。付属の検証では、二次元の正定値な構成例について行列共分散方程式を検証している。
7. 事後分布という表現には対象の特定が必要である
最適化器の定常分布を事後分布と呼ぶには、尤度、事前分布、データセットサイズ、パラメータ空間上の測度を指定しなければならない。任意に注入した共分散は、一般にはその統計モデルが要求する共分散ではない。二次関数であっても、一つのスカラー分散を一致させるだけでは、多次元分布全体は特定されない。モデルの再パラメータ化も、ユークリッド的なノイズが意味するものを変える。
近似推論という解釈は、こうした要件を明示する点で有用である。それを、SGDの不確実性がベイズ的不確実性であるという包括的な主張に変えてはならない。実際の実験では、予測被覆率をホールドアウトされた結果で検証し、パラメータ共分散を扱いやすい参照事後分布と比較できる。これらは別個の帰無仮説を持つ別個の検定である。学習損失だけの一致では、どちらも確立できない。 [1]
8. 資源の計上方法によって最適解は異なる
一回の更新コストが、固定の起動オーバーヘッドとバッチサイズに比例する項の和であるデバイスモデルを考える。Bを増やすとオーバーヘッドは償却されるが、例数の予算が固定されている場合、パラメータ更新の回数は減少する。ステップ数に関して最適な方策と、例数に関して最適な方策は一致するとは限らない。通信、メモリ制約、パディングは、この単純なモデルが省略している追加の制約をもたらす。
有用なバッチサイズ研究では、最適化器のステップ数、処理した例数、経過時間、達成した損失を併せて報告する必要がある。また、指定したバッチサイズと、勾配累積や例の除外後の実効バッチサイズを区別する必要がある。このため、本稿の図は、架空のスループット曲線ではなく、バッチサイズおよび学習率に対する分散を示す。実機のスループットに関する主張には、実行スタックを指定したうえで、ウォームアップと同期を一貫して扱った測定が必要である。 [3]
9. ニューラルネットワークへの外挿を検証する方法
意味のある拡張では、データセットの分割、アーキテクチャ、初期化分布、データ拡張方針、評価スケジュールを固定したうえで、明示した要因計画に従って抽出と最適化器のパラメータを変える。予備実験では、初期化時だけでなく、損失水準を揃えた複数の時点で勾配共分散を推定できる。それらの推定には独立なミニバッチを用い、平均勾配と共分散の両方について不確実性を報告すべきである。
中心的な予測は普遍的なものではなく、条件付きである。局所モデルが適切なら、観測される共分散と緩和は、限定された領域内でその有限ステップ補正に従うはずである。破綻は、曲率の変化、相関したバッチ、非定常なデータ拡張、モメンタム、局所的な吸引域からの離脱によって生じうる。これらの代替要因を記録すれば、否定的な結果を診断的な証拠に変えられる。近似がたまたま適合するチェックポイントだけを選べば、比較は循環的になる。
10. 実行可能な証拠が支持できること
付属コードは、四つの勾配からなる母集団について、空でないすべてのバッチサイズを列挙し、有限母集団の恒等式を確認し、漸化式と線形方程式系の解の両方によって定常共分散を検証する。また、安定区間の外にあるステップサイズを構成し、決定論的な偏差が増大することを確認する。これらのテストは、算術、境界条件、比を維持した際の不変性に対する具体的な反例を対象とする。
これらのテストは、ニューラルネットワークを学習させたり、汎化を測定したり、普遍的なスケーリング則を検証したりするものではない。その目的は、費用のかかる実験を試みる前に、本稿の論理を検査可能にすることである。得られる結論は限定的だが有用である。バッチサイズは、ステップサイズ、抽出、幾何構造、最適化の対象とする資源から切り離して解釈できない。より強い実証的主張には、これらの量を暗黙に仮定するのではなく、測定する必要がある。
11. 相関と過渡誤差は別個の制御要因である
ノイズの独立性という仮定は、実装上の細部として扱うのではなく、検証できる。連続する二つの勾配誤差が相関していれば、蓄積されるパラメータ分散に交差項が入る。エポックごとに一度シャッフルすること、関連する例を繰り返し参照すること、データ拡張のストリームを再利用することは、ステップごとの共分散推定では捉えられない時間構造を生みうる。その場合、ノイズの周辺分散が変わらなくても、独立増分を仮定して導出された定常分散の式は適切な参照にならない。
出発点も重要である。スカラーモデルでは、平均は(1-eta h)のt乗に従って収縮し、分散はその因子の二乗を通じて極限に近づく。パラメータの期待二乗誤差は、平均の二乗と分散の和である。学習初期には、バイアスの低減が、より高い分散の下限の影響を上回りうるが、後期にはその下限が支配的になりうる。この分解は、あるノイズ水準を別の水準より優れていると呼ぶ前に、学習期間を指定すべき具体的な理由を与える。
ローカルで実行済み · 限定された範囲
抽出と離散共分散の恒等式
四つの勾配からなる母集団について、空でないすべての部分集合サイズを列挙し、2次元の安定な共分散を一例検証する。事後分布の較正や汎化に関する証拠はない。
10件のアサーションに合格した。 これらの検証は付属の例を妥当性確認するものであり、引用したシステムを検証するものではない。
記録された実行証跡を確認
{
  "finite_population_variances": [
    5.0,
    1.6666666666666667,
    0.5555555555555556,
    0.0
  ],
  "scalar_stationary_variance": 0.08333333333333333,
  "matrix_covariance": [
    [
      0.015622805157421303,
      0.0009863914506035294
    ],
    [
      0.0009863914506035294,
      0.019337634775857728
    ]
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 大きさがNでN>1を満たす固定母集団から、異なるB個の勾配を含む部分集合を一様抽出する。母分散の分母はNとする。
(2) 平均ゼロの独立な加法ノイズ、スカラー曲率h>0、一定のetaとB。
(3) 厳密な離散時間の定常分散。境界で発散し、小ステップ近似とは異なる。
(4) I-eta Hのスペクトル半径が一未満で、加法ノイズの共分散がSigma/Bで固定されている場合の離散共分散方程式。
構成例 · 再現可能なデータ
定量的な議論を確認
これらの曲線は、明示したモデルから計算したものである。引用した研究の観測結果ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるのか
| 量 | 固定するもの | 未解決の事項 |
|---|---|---|
| 勾配分散 | パラメータとサンプラー | 軌道と汎化 |
| 定常共分散 | 安定な局所ダイナミクス | 非定常な表現学習 |
| 目標到達時間 | ハードウェアと目的関数 | 同一コストでの統計的品質 |
提案する検証プロトコル
これは評価設計の提案である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の節に記録している。
- データローダーを実行する前に、有限母集団の列挙を再現する。
- 勾配を総和するか平均するか、および抽出時の復元の有無を明記する。
- 独立なバッチを用い、条件を揃えたチェックポイントで共分散を推定する。
- 厳密な離散時間の予測と小ステップの予測を、信頼区間とともに比較する。
- ステップ数、例数、経過時間、ホールドアウトデータ上の品質を別々に報告する。
- モデルの破綻基準を事前に明示し、不安定または発散した実行も保持する。
一次資料が明らかにしていること
Stephan Mandt, Matthew D. Hoffman, David M. Blei · 2017 [1]
貢献。 定ステップSGDを近似推論として解釈する枠組みを展開している。
適用限界。 局所的な確率近似と、特定された統計モデルが不可欠である。
出典内の該当箇所。 要旨、および原論文における局所確率過程の解析。
Samuel L. Smith, Quoc V. Le · 2017 [2]
貢献。 SGDのノイズスケールを学習率および有限データにおけるバッチサイズと関連付けている。
適用限界。 スケーリング近似は、離散的な最適化器の軌道の厳密な不変性ではない。
出典内の該当箇所。 著者稿の第5節および付録C。
Sam McCandlish, Jared Kaplan, Dario Amodei et al. · 2018 [3]
貢献。 大バッチ学習の有用性の予測指標として勾配ノイズを研究している。
適用限界。 実証的な有用性は、測定対象のタスクと計算時間に関する目的に依存する。
出典内の該当箇所。 要旨および実証モデルの枠組み。
本分析の限界
- 独立な加法ノイズは仮定であり、すべてのミニバッチ勾配の性質ではない。
- この二次関数は曲率が固定されており、吸引域の変化を表現できない。
- ニューラルネットワークの学習やハードウェアのベンチマークは実施していない。
- パラメータ分散を一致させても、予測の較正は確立できない。
選定した三つの基礎的な一次資料を対象とする、独自の計算例を伴った焦点を絞った分析的レビューである。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセス範囲と版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- どの共分散方向が、スカラーのノイズスケール近似の破綻を最もよく予測するか。
- 例数ではなく最適化器の軌道を揃えたとき、バッチサイズの効果はどの程度残るか。
- 適応的なスケジューリングによって、安定余裕と明示された資源予算の両方を制御できるか。
参考文献
- Stephan Mandt, Matthew D. Hoffman, David M. Blei. Stochastic Gradient Descent as Approximate Bayesian Inference. Journal of Machine Learning Research 18(134) (2017). Primary source.
- Samuel L. Smith, Quoc V. Le. A Bayesian Perspective on Generalization and Stochastic Gradient Descent. arXiv:1710.06451 (2017). 10.48550/arXiv.1710.06451.
- Sam McCandlish, Jared Kaplan, Dario Amodei et al.. An Empirical Model of Large-Batch Training. arXiv:1812.06162 (2018). 10.48550/arXiv.1812.06162.
資料[1]の確認範囲。 JMLRの書誌レコード、要旨、PDF本文の冒頭部分を確認した。局所的な定常計算は独立に導出した。
資料[2]の確認範囲。 一次レコードと著者のHTML稿を、ノイズスケールの定式化および節見出しを含めて確認した。
版に関する注記。 引用したレコードの初回投稿は2017年。v3(2018年二月14日)を確認し、ICLR 2018と記載されている。書誌上の年はarXivレコードを指す。
資料[3]の確認範囲。 一次書誌レコードと要旨を確認した。全文や補足資料の網羅的な監査は行っていない。
版に関する注記。 団体著者名OpenAI Dota Teamは、一次レコードに記載された表記を維持している。
書誌上の同一性は、出版社および著者の一次レコードと照合した。以下の資料アクセスおよび版に関する注記が確認範囲を示すものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は原研究の研究者を示す。解析的な構成例と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示されたモデルまたは有限の例から計算されており、PythonとCSVを提供している。配備済み製品の測定でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。