
الملخص
يدرّب التقطير الطالب باستخدام مخرجات المعلّم أو تمثيلاته الوسيطة، وقد ينقل العلاقات النسبية بين الفئات، كما قد ينقل التحيزات والأخطاء. يشتق هذا المقال تأثير درجة الحرارة في الاحتمالات والتدرّجات، ويوضح شروط التحجيم الشائع بمربع T، ويناقش الفروق بين تقطير قيم logit للتصنيف وتقطير توليد التسلسلات. يستخدم الرسم أربع قيم logit ثابتة، وليس قياسات فعلية لأي نموذج؛ وتشترط خطة التحقق حقيقة مرجعية مستقلة، وتحليلاً طبقيًا لحالات إخفاق المعلّم، وقيودًا متماثلة على الموارد.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste[3] LoRA: Low-Rank Adaptation of Large Language Models
ترجمة الملخص الإنجليزي
ينقل تقطير المعرفة توزيع المعلّم، لا الحقيقة المرجعية ذاتها. نحلّل التحجيم بدرجة الحرارة، ومقدار التدرّج، وحدود السعة، ونميّز بين الإشراف بقيم logit والإشراف بالتسلسلات والإشراف بالتمثيلات. يوضّح مثال ثابت يتألف من أربع قيم logit تغيّرات الإنتروبيا فقط. ويتطلب تقييم جودة الطالب تسميات مستقلة وتقييم أخطاء المعلّم الموروثة، وزمن الاستجابة، واستخدام الموارد.
1. تحمل التسميات اللينة علاقات نسبية كما تحمل تحيزات
لا تحدد التسميات الصلبة إلا فئة مستهدفة واحدة؛ أما توزيع المعلّم فيمكنه أيضًا التعبير عن أوجه التشابه النسبية بين الفئات الأخرى. لكن هذه الاحتمالات تأتي من المعلّم وسياق تدريبه، وقد لا تكون مُعايرة، كما قد لا تعكس عدم اليقين الحقيقي. وقد يتعلّم الطالب بنية مفيدة، أو ينسخ أخطاء المعلّم المنهجية بشأن بعض المجموعات أو المدخلات النادرة. لذلك، لا يثبت انخفاض خسارة التقطير إلا اقتراب الطالب من إشارة المعلّم المستخدمة، ولا يثبت مباشرة اقترابه من حقيقة مرجعية مستقلة. وينبغي تقييم المعلّم والطالب كليهما على مجموعة بيانات موسومة لم تشارك في التطوير.[1] Distilling the Knowledge in a Neural Network
2. تغيّر درجة الحرارة شكل الاحتمالات ومقياس التدرّج
تؤدي قسمة قيم logit على T إلى تسطيح التوزيع عند ارتفاع T، بما يكشف العلاقات النسبية بين الفئات التالية في الترتيب. وعندما تكون درجة الحرارة واحدة لدى المعلّم والطالب، يتضمن تدرّج الإنتروبيا المتقاطعة بالنسبة إلى قيم logit الخاصة بالطالب العامل 1/T؛ وفي تقريب درجات الحرارة المرتفعة، قد تتقلص فروق الاحتمالات أيضًا بما يتناسب مع 1/T، ولذلك يُستخدم مربع T عادة لضبط مقدار الخسارة. ولا يعني هذا التقريب أن التدرّجات متطابقة تمامًا عند أي T ولأي توزيع. ويجب تسجيل الأوزان ونسبة التسميات الصلبة وخوارزمية التحسين، ولا يجوز إجراء مقارنة مباشرة بين قيم الخسارة بعد تغيير درجة الحرارة.[1] Distilling the Knowledge in a Neural Network
3. تحدّ سعة الطالب من سلوكيات المعلّم التي يمكن تقريبها
حتى مع توافر بيانات إشراف كافية، قد تعجز معمارية الطالب عن تمثيل جميع سلوكيات المعلّم في آن واحد. يؤثر عدد الطبقات، وأبعاد التمثيلات الخفية، وبنية الانتباه، والمفردات في خطأ التقريب؛ كما أن تساوي عدد المعلمات لا يضمن تساوي زمن الاستجابة. يقدّم DistilBERT مسارًا محددًا للتقطير أثناء التدريب المسبق، ولا يعني ذلك إمكان ضغط النماذج بنسبة ثابتة في جميع المهام مع الحفاظ على قدراتها. ويجب التمييز بين آثار تصغير المعمارية، وتغيير أهداف التدريب، وزيادة البيانات، مع الاحتفاظ بخط أساس لطالب لم يخضع للتقطير.[2] DistilBERT, a distilled version of BERT: smaller, faste[1] Distilling the Knowledge in a Neural Network
4. يغيّر تقطير التسلسلات توزيع بيانات التدريب
عند تدريب الطالب على نصوص يولّدها المعلّم، يكون الإشراف على تسلسلات مأخوذة بالاستعيان أو خاضعة للتصفية، وليس على التوزيع الكامل في كل موضع. وتغيّر درجة الحرارة وفك الترميز والموجّهات والتصفية السلوكيات التي تدخل في التدريب. وإذا اقتصر الاحتفاظ على العينات التي أجاب عنها المعلّم إجابة صحيحة أو التي يسهل الإجابة عنها، فقد يفتقر الطالب إلى الحالات الحدّية الصعبة وحالات الامتناع عن الإجابة؛ وإذا كانت تفسيرات المعلّم خاطئة، فقد تُتعلَّم هي أيضًا بوصفها أهدافًا. وينبغي تسجيل إعدادات التوليد واختيار العينات، وعدم الخلط بين محاكاة النصوص وتقطير الاحتمالات باعتبارهما نوعًا واحدًا من الإشراف.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
5. تتطلب مقارنة الموارد تثبيت قيود الجودة
قد يقلل الطالب الأصغر كلفة التخزين والاستدلال، لكن سرعة الخدمة الفعلية تعتمد على الجهاز وحجم الدفعة وطول التسلسل والنوى الحاسوبية. وإذا احتاج الطالب إلى مزيد من الاستعيان أو الاسترجاع الخارجي لبلوغ الجودة المطلوبة، فقد لا تنخفض كلفة النظام بالتناسب مع عدد المعلمات. تُعدّ LoRA طريقة لتحديث المعلمات، وهو هدف يختلف عن تصغير نموذج الاستدلال؛ فتجميد نموذج كبير وتدريب عدد قليل من المعلمات لا ينتج تلقائيًا خدمة تعتمد على نموذج صغير. وينبغي مقارنة الأنظمة الكاملة تحت هدف موحّد للجودة أو زمن الاستجابة، بدلًا من اعتبار خفض عدد معلمات التدريب ضغطًا للاستدلال.[3] LoRA: Low-Rank Adaptation of Large Language Models[2] DistilBERT, a distilled version of BERT: smaller, faste
6. يجب أن تكون مواطن قصور المعلّم نقطة انطلاق لاختبارات القبول
إضافة إلى المقاييس الإجمالية، ينبغي فحص العينات التي يكون فيها المعلّم صحيحًا والطالب مخطئًا، والتي يخطئ فيها المعلّم ويتبعه الطالب، والتي يصحح فيها الطالب خطأ المعلّم، كلٌّ على حدة. ويمكن لتعدد المعلّمين أو التسميات الصلبة توفير قيود إضافية، لكنها لا تضمن تلقائيًا انعدام التحيز. ويجب أن يوضح التقرير النهائي مصدر المعلّم وإصداره وترخيص البيانات وكلفة التوليد والتقييم المستقل، تجنبًا للأدلة الدائرية الناشئة عن تقييم المعلّم لطلابه. يقتصر هذا المقال على تحليل الخسارة وشكل الاحتمالات، ولم يُنجز تدريبًا لطالب ولم يدّع الحفاظ على نسبة معينة من القدرة.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
الصيغ الأساسية والاشتقاقات
(1) قيم logit في الرسم هي 3 و1 و0 و−1، ودرجات الحرارة هي 1 و2 و5؛ ولا يُعرض سوى تنعيم الاحتمالات.
LaTeX
p_i^{(T)}=\frac{\exp(z_i/T)}{\sum_j\exp(z_j/T)}(2) هدف مختلط شائع؛ المعلّم ثابت، ويجب الإفصاح عن λ وT ومصدر التسميات الصلبة.
LaTeX
\mathcal L=(1-\lambda)\operatorname{CE}(y,p_s^{(1)})+\lambda T^2\operatorname{KL}(p_t^{(T)}\Vert p_s^{(T)})(3) يُبيّن عامل درجة الحرارة صراحةً؛ ويعتمد مبرر التحجيم بمربع T أيضًا على السلوك التقريبي لفروق الاحتمالات عند درجات الحرارة المرتفعة.
LaTeX
\frac{\partial\operatorname{CE}(p_t^{(T)},p_s^{(T)})}{\partial z_{s,i}}=\frac{p_{s,i}^{(T)}-p_{t,i}^{(T)}}{T}مسار المنهج والأدلة
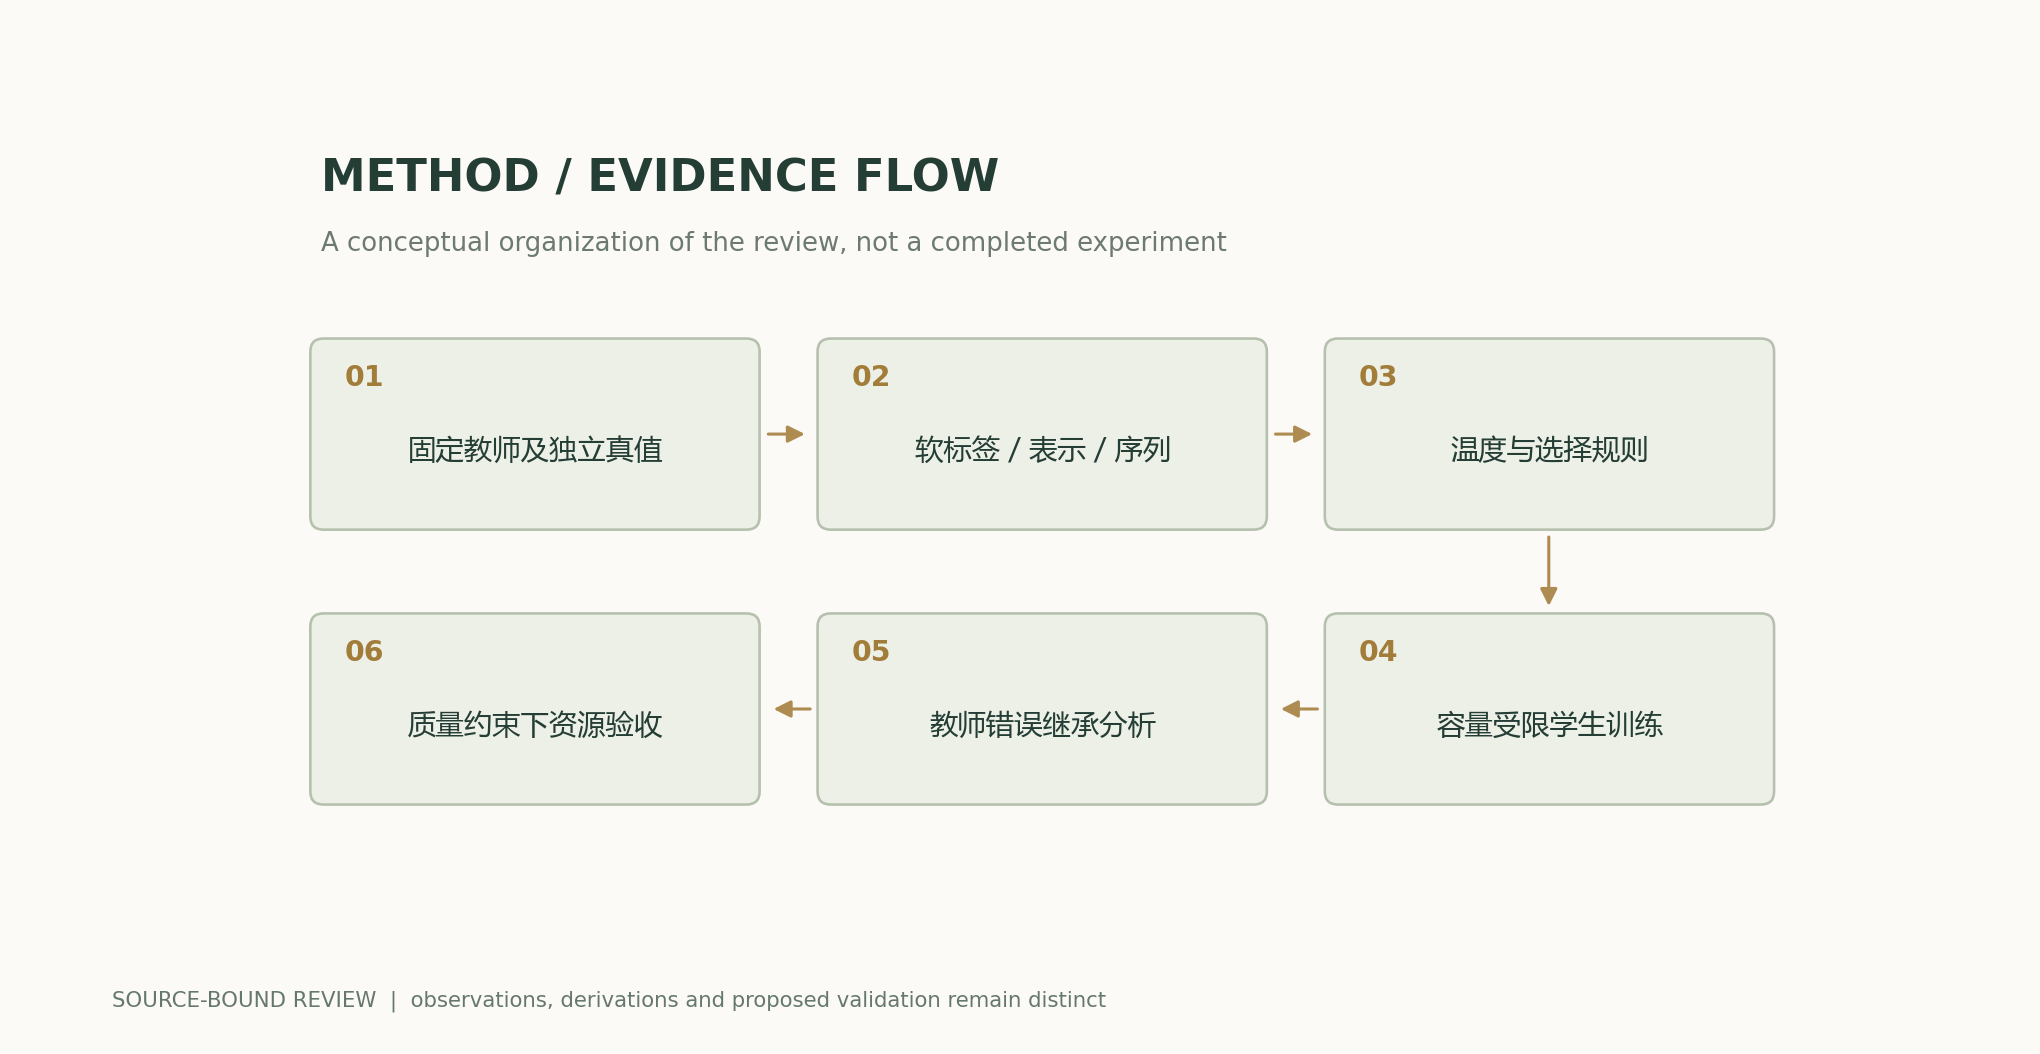
رسوم تحليلية وأمثلة عددية
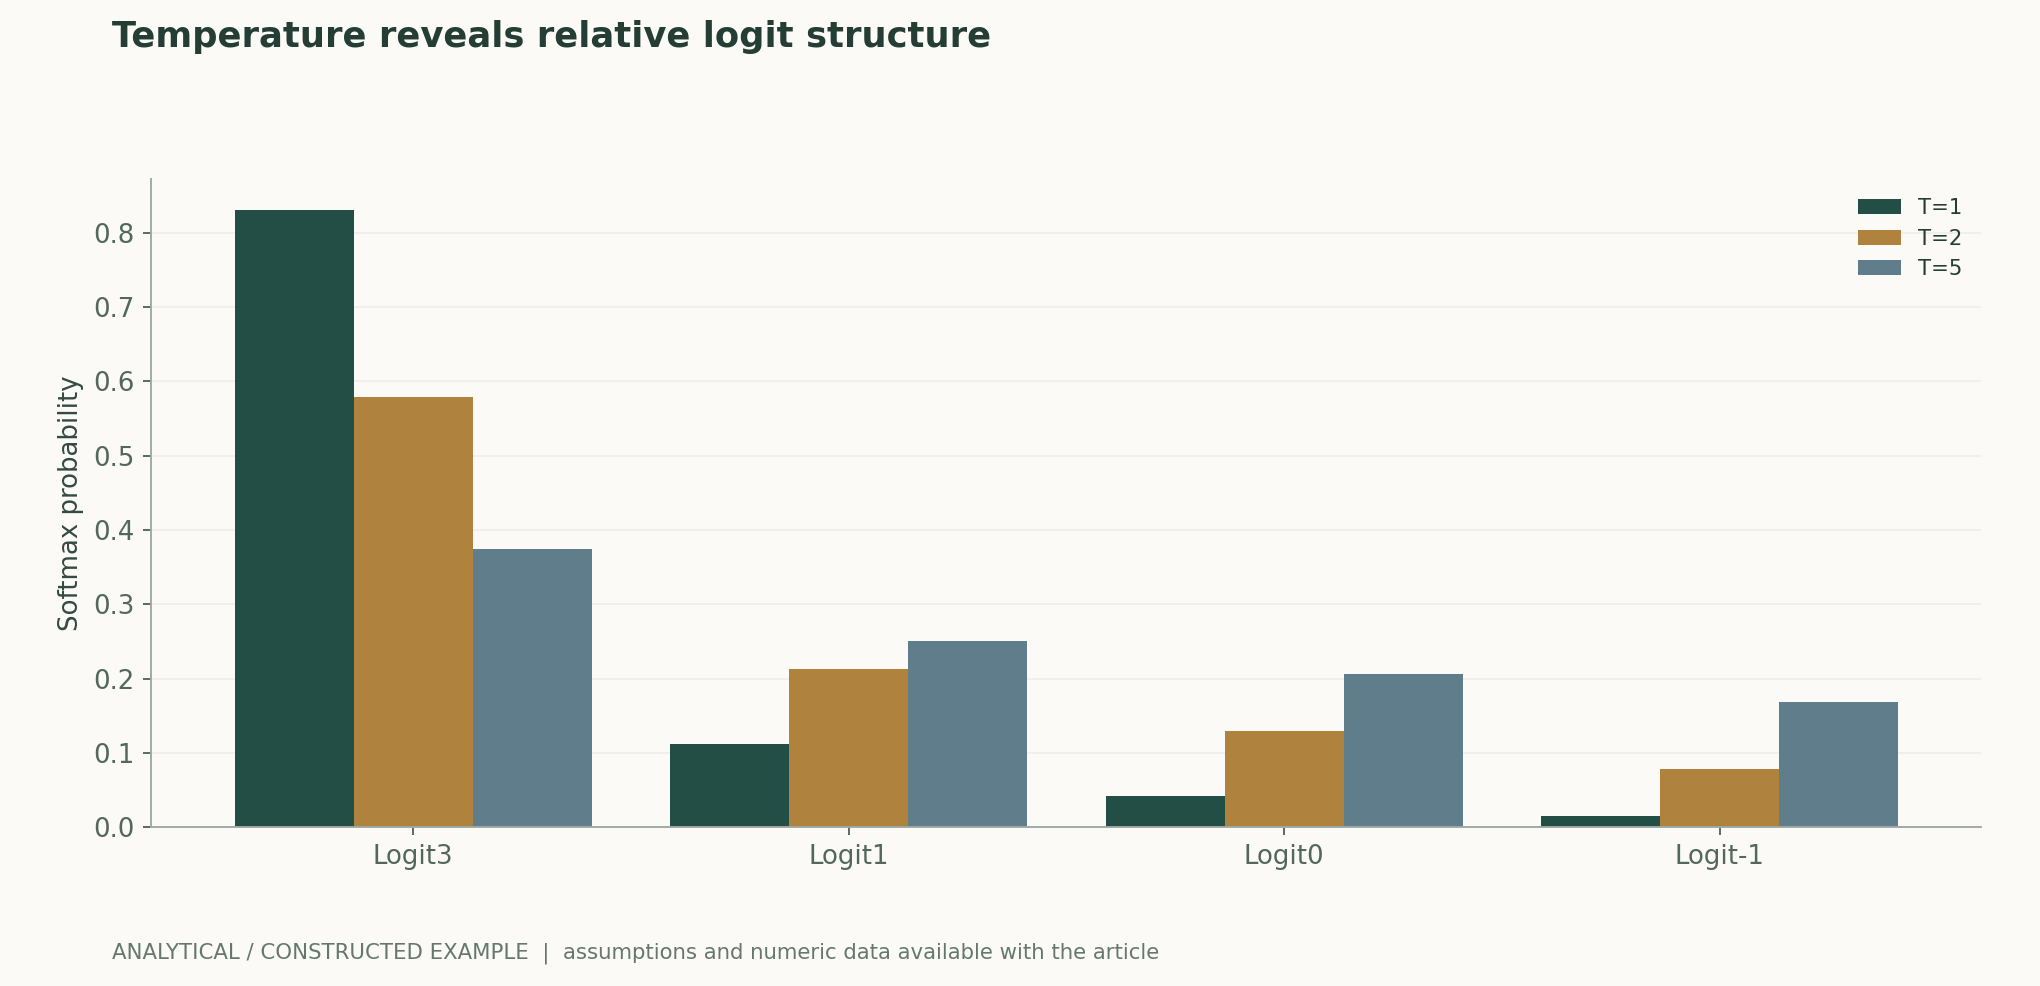
مثال محلول قابل لإعادة الحساب
مع ثبات قيم logit، يبلغ احتمال الفئة الأعلى نحو 0.831 عند T=1، ونحو 0.375 عند T=5. ولا يعني التوزيع الأكثر تسطحًا أن الطالب يتعلّم بصورة أفضل؛ إذ يجب قياس الجودة بالاستناد إلى التسميات الحقيقية على نحو منفصل.
مقارنة الطرق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| تقطير قيم logit | حفظ درجة الحرارة والتوزيعات ونسبة التسميات الصلبة | الاقتراب من المعلّم لا يعادل الاقتراب من الحقيقة المرجعية |
| تقطير التسلسلات | تسجيل الموجّهات وقواعد الاستعيان والتصفية | النص المولّد ليس التوزيع الكامل للمعلّم |
| تقطير التمثيلات | تحديد المطابقة بين الطبقات وأوزان الخسارة بوضوح | التمثيلات المتشابهة لا تضمن سلوكًا متماثلًا في المهمة |
| الضغط لأغراض النشر | قياس الكلفة الكاملة للخدمة عند مستوى جودة متماثل | كفاءة استخدام المعلمات في التدريب ليست تصغيرًا للنموذج |
خطة التحقق والتجارب
- تثبيت إصداري المعلّم والطالب، وتسجيل المعمارية والمفردات ومصادر البيانات.
- تقسيم البيانات إلى مجموعات تدريب وتطوير واختبار موسومة بصورة مستقلة، وتجنب تلويث الاختبار بانتقاء المعلّم.
- مسح قيم درجة الحرارة وأوزان المزج، وتسجيل خط أساس لطالب لم يخضع للتقطير وخط أساس للتسميات الصلبة.
- تقسيم النتائج إلى طبقات حسب نجاح المعلّم أو إخفاقه وصعوبة المهمة، وفحص وراثة الأخطاء.
- قياس تخزين النموذج وذروة استخدام الذاكرة وزمنَي الملء المسبق وفك الترميز، مع تثبيت العتاد وحجم الدفعة.
- الإفصاح عن كلفتي التوليد والتدريب، والإبقاء على تقييم مستقل دون ترك الاستنتاج للمعلّم وحده.
نطاق الانطباق والقيود
- لم يُدرَّب أي نموذج طالب.
- لا يدل رسم تنعيم الاحتمالات على تحسن الجودة.
- لتقريب التدرّج المرتبط بدرجة الحرارة شروط انطباق.
- قد يؤدي إشراف المعلّم إلى توريث تحيزات منهجية.
المصادر الأولية وما يقابلها من ادعاءات
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter, , , · 2019-10-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
الاستشهاد وتصدير المخطوط
BibTeXRISCSL JSONTXTالمقال بصيغة JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex (ذكاء اصطناعي) وأجرى اشتقاقاتها التحليلية استنادًا إلى الأدبيات الأولية المدرجة. لا يتضمن هذا الموقع سجلًا لتحكيم مستقل لهذا المقال أو لتجارب أصلية على نماذج.
تنقيح أداء القارئ: يُعاد أيضًا استخدام الصفحات المقروءة عندما يعيد طلب HEAD حديث الحالة 200 وتكون قيمة ETag مطابقة. ويحتفظ المتن والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
الغلاف المفاهيمي منفصل عن الرسوم العلمية؛ وتُحسب الرسوم العلمية باستخدام صيغ متاحة علنًا وافتراضات مصرّح بها، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
المؤلف والإصدارات وسجل التصحيحات · /guides/distillation-small-models/v1/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770