
Resumen
La destilación entrena al estudiante mediante las salidas o las representaciones intermedias del profesor, y puede transferir relaciones relativas entre clases, así como sesgos y errores. Este artículo deriva los efectos de la temperatura sobre las probabilidades y los gradientes, explica las condiciones del escalado habitual por T al cuadrado y analiza las diferencias entre la destilación de logits para clasificación y la destilación de generación de secuencias. La ilustración utiliza cuatro logits fijos, no mediciones de ningún modelo; el plan de verificación exige una verdad de referencia independiente, la estratificación de los fallos del profesor y restricciones de recursos idénticas.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste[3] LoRA: Low-Rank Adaptation of Large Language Models
Traducción del resumen original en inglés
La destilación de conocimiento transfiere una distribución del profesor, no la verdad de referencia en sí misma. Analizamos el escalado por temperatura, la magnitud del gradiente y los límites de capacidad, y distinguimos la supervisión mediante logits, secuencias y representaciones. Un ejemplo con cuatro logits fijos ilustra únicamente los cambios de entropía. Evaluar la calidad del estudiante requiere etiquetas independientes y la evaluación de los errores heredados del profesor, la latencia y el uso de recursos.
1. Las etiquetas blandas transmiten tanto relaciones relativas como sesgos
Las etiquetas duras solo especifican una clase objetivo; la distribución del profesor también puede expresar similitudes relativas entre otras clases. Sin embargo, estas probabilidades proceden del profesor y de su contexto de entrenamiento, y no necesariamente están calibradas ni reflejan la incertidumbre real. El estudiante puede aprender una estructura útil, pero también reproducir los errores sistemáticos del profesor para ciertos grupos o entradas poco frecuentes. Por tanto, una reducción de la pérdida de destilación solo demuestra que el estudiante se aproxima más a la señal del profesor utilizada, y no demuestra directamente una mayor proximidad a una verdad de referencia independiente. Tanto el profesor como el estudiante deben evaluarse en un conjunto etiquetado que no haya intervenido en el desarrollo.[1] Distilling the Knowledge in a Neural Network
2. La temperatura modifica la forma de las probabilidades y la escala del gradiente
Dividir los logits por T aplana la distribución cuando T es mayor, lo que revela las relaciones relativas entre las clases de menor puntuación. Cuando el profesor y el estudiante utilizan la misma temperatura, el gradiente de la entropía cruzada respecto a los logits del estudiante contiene 1/T; bajo la aproximación de alta temperatura, las diferencias de probabilidad también pueden disminuir en proporción a 1/T, por lo que suele utilizarse T al cuadrado para ajustar la magnitud de la pérdida. Esta aproximación no implica que los gradientes sean estrictamente idénticos para cualquier T y cualquier distribución. Deben registrarse los pesos, la proporción de etiquetas duras y el optimizador; los valores de pérdida obtenidos tras cambiar la temperatura no pueden compararse directamente.[1] Distilling the Knowledge in a Neural Network
3. La capacidad del estudiante limita los comportamientos del profesor que puede aproximar
Incluso con suficientes datos de supervisión, la arquitectura del estudiante puede ser incapaz de representar simultáneamente todos los comportamientos del profesor. El número de capas, las dimensiones ocultas, la estructura de atención y el vocabulario influyen en el error de aproximación; un número idéntico de parámetros no garantiza una latencia idéntica. DistilBERT muestra una vía concreta de destilación durante el preentrenamiento, pero no implica que todas las tareas permitan comprimir en una proporción fija manteniendo las capacidades. Es necesario distinguir los efectos de reducir la arquitectura, modificar los objetivos de entrenamiento y aumentar los datos, y conservar una línea base del estudiante sin destilación.[2] DistilBERT, a distilled version of BERT: smaller, faste[1] Distilling the Knowledge in a Neural Network
4. La destilación de secuencias modifica la distribución de los datos de entrenamiento
Entrenar al estudiante con texto generado por el profesor proporciona supervisión mediante secuencias muestreadas o filtradas, en lugar de la distribución completa en cada posición. La temperatura, la decodificación, las instrucciones de entrada y el filtrado modifican qué comportamientos entran en el entrenamiento. Si solo se conservan ejemplos que el profesor responde correctamente o que son fáciles de responder, el estudiante puede carecer de casos límite difíciles y de situaciones de rechazo a responder; las explicaciones incorrectas del profesor también pueden aprenderse como objetivos. Deben registrarse los ajustes de generación y la selección de ejemplos, sin confundir la imitación textual y la destilación de probabilidades como si fueran la misma forma de supervisión.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
5. La comparación de recursos requiere restricciones de calidad fijas
Un estudiante más pequeño puede reducir los costes de almacenamiento e inferencia, pero la velocidad real del servicio depende del dispositivo, el tamaño del lote, la longitud de la secuencia y los kernels de ejecución. Si el estudiante necesita más muestreo o recuperación externa para alcanzar la calidad requerida, el coste del sistema no necesariamente disminuye en proporción al número de parámetros. LoRA es un método de actualización de parámetros, cuyo objetivo difiere de reducir el tamaño del modelo de inferencia; congelar un modelo grande y entrenar unos pocos parámetros no produce automáticamente un servicio basado en un modelo pequeño. Deben compararse sistemas completos bajo el mismo objetivo de calidad o latencia, en lugar de considerar la reducción de parámetros de entrenamiento como compresión de la inferencia.[3] LoRA: Low-Rank Adaptation of Large Language Models[2] DistilBERT, a distilled version of BERT: smaller, faste
6. Los puntos ciegos del profesor deben ser un punto de partida para las pruebas de aceptación
Además de las métricas globales, deben examinarse por separado los ejemplos en que el profesor acierta y el estudiante falla, aquellos en que el profesor falla y el estudiante lo sigue, y aquellos en que el estudiante corrige al profesor. Varios profesores o las etiquetas duras pueden aportar restricciones adicionales, pero no garantizan automáticamente la ausencia de sesgos. El informe final debe especificar la procedencia y la versión del profesor, las licencias de los datos, los costes de generación y la evaluación independiente, evitando evidencias circulares derivadas de que el profesor evalúe a sus propios estudiantes. Este artículo solo analiza la pérdida y la forma de las probabilidades; no ha completado el entrenamiento de un estudiante ni afirma haber conservado un porcentaje determinado de capacidad.[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
Fórmulas fundamentales y derivaciones
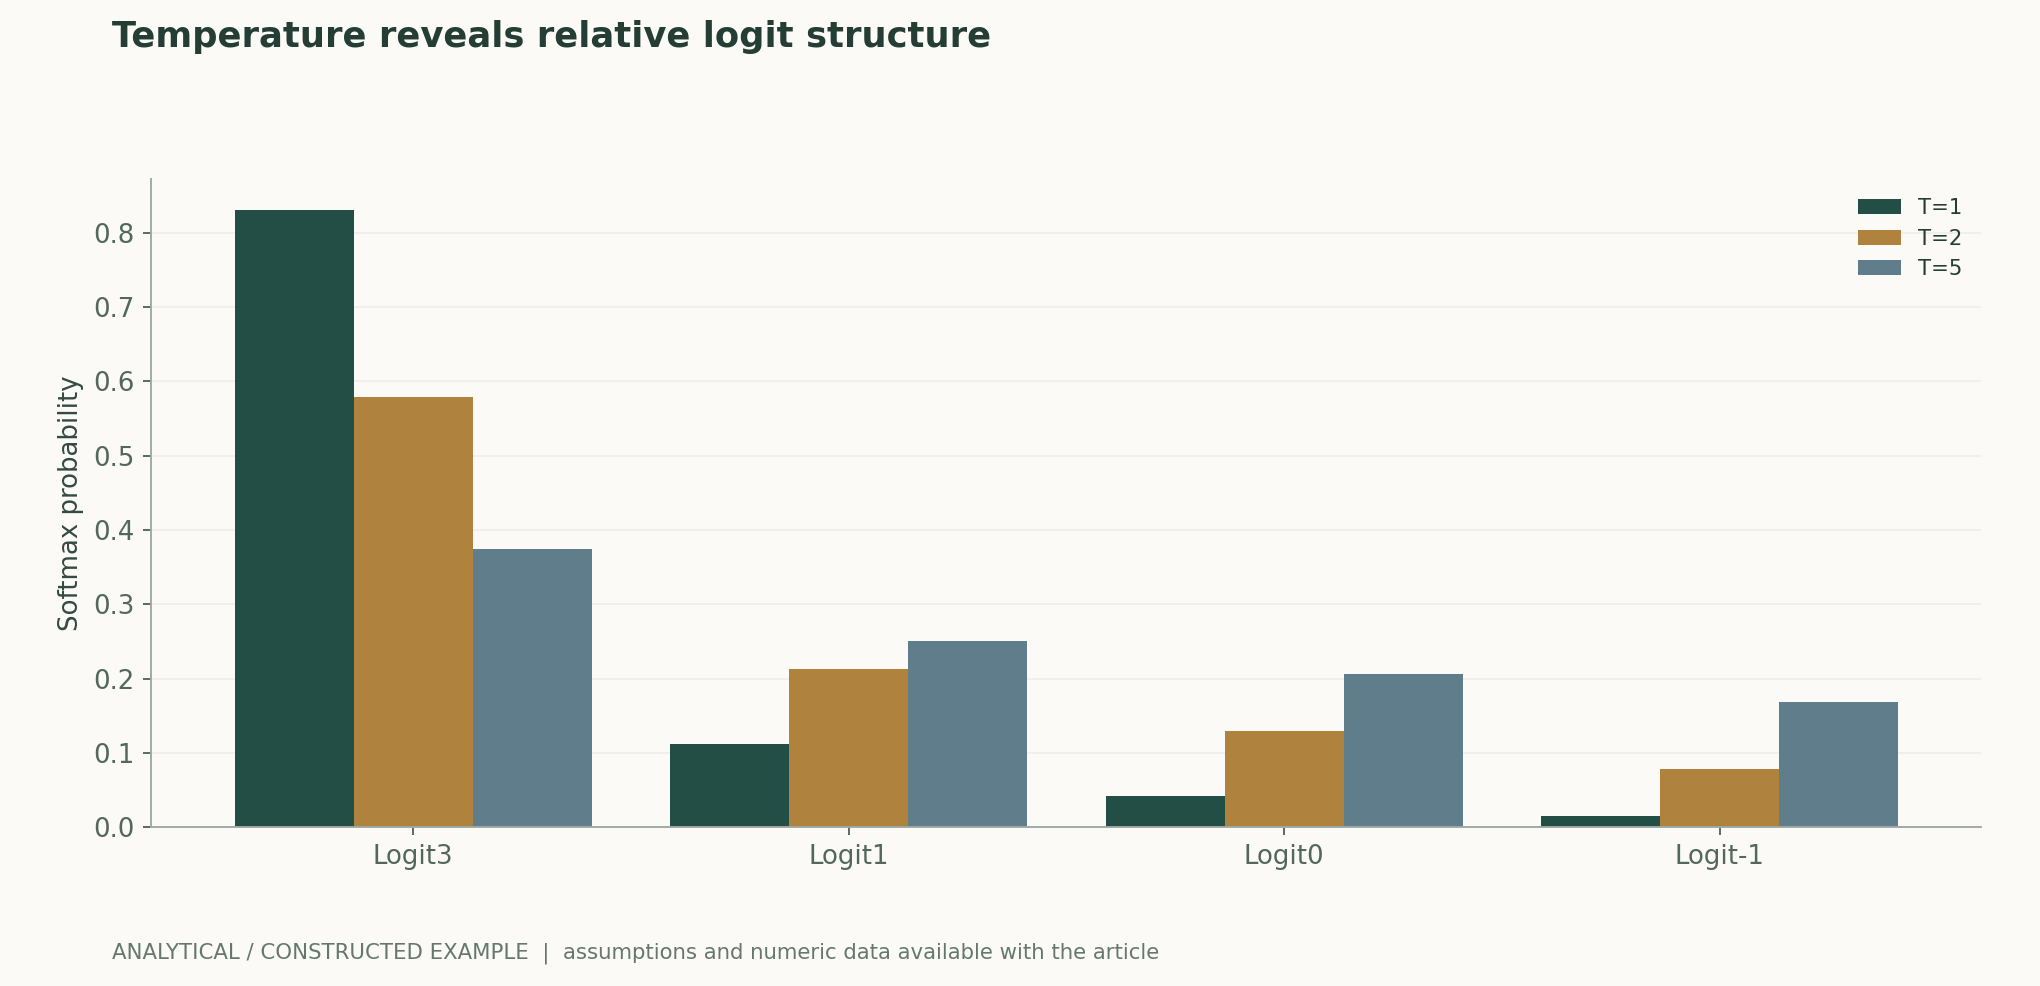
(1) Los logits de la ilustración son 3, 1, 0 y −1, y las temperaturas son 1, 2 y 5; solo se muestra el suavizado de las probabilidades.
LaTeX
p_i^{(T)}=\frac{\exp(z_i/T)}{\sum_j\exp(z_j/T)}(2) Un objetivo mixto habitual; el profesor se mantiene fijo y deben divulgarse λ, T y la procedencia de las etiquetas duras.
LaTeX
\mathcal L=(1-\lambda)\operatorname{CE}(y,p_s^{(1)})+\lambda T^2\operatorname{KL}(p_t^{(T)}\Vert p_s^{(T)})(3) Expone el factor explícito de temperatura; la justificación del escalado por T al cuadrado también depende del comportamiento aproximado de las diferencias de probabilidad a temperaturas altas.
LaTeX
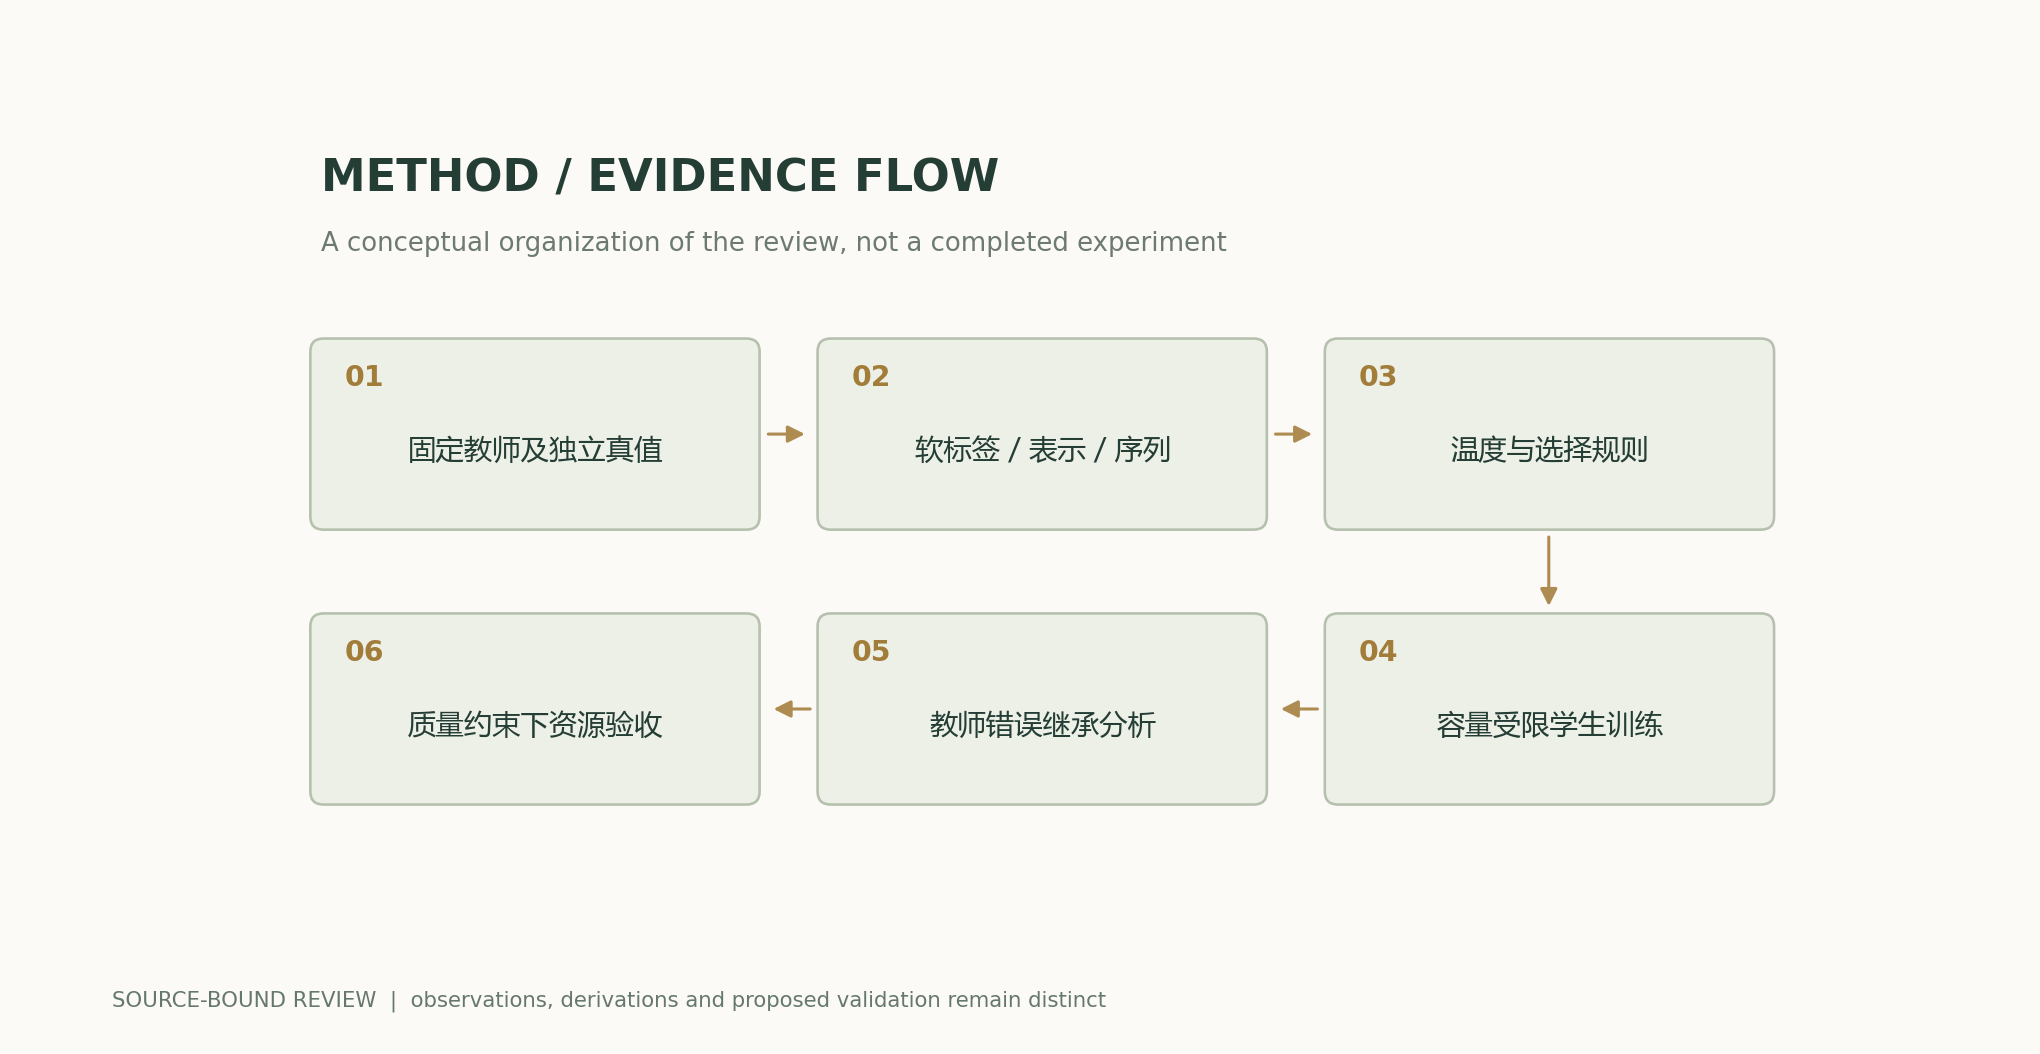
\frac{\partial\operatorname{CE}(p_t^{(T)},p_s^{(T)})}{\partial z_{s,i}}=\frac{p_{s,i}^{(T)}-p_{t,i}^{(T)}}{T}Flujo de métodos y evidencias
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que permite repetir los cálculos
Con logits fijos, la probabilidad de la clase más probable es aproximadamente 0.831 cuando T=1 y aproximadamente 0.375 cuando T=5. Una distribución más plana no significa que el estudiante aprenda mejor; la calidad respecto a las etiquetas verdaderas debe medirse por separado.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Destilación de logits | Conservar la temperatura, las distribuciones y la proporción de etiquetas duras | Aproximarse al profesor no equivale a aproximarse a la verdad de referencia |
| Destilación de secuencias | Registrar las instrucciones de entrada y las reglas de muestreo y filtrado | El texto generado no es la distribución completa del profesor |
| Destilación de representaciones | Especificar la correspondencia entre capas y los pesos de la pérdida | Las representaciones similares no garantizan un comportamiento idéntico en la tarea |
| Compresión para el despliegue | Medir el coste completo del servicio con la misma calidad | La eficiencia en parámetros de entrenamiento no equivale a reducir el tamaño del modelo |
Plan de verificación y experimentación
- Fijar las versiones del profesor y del estudiante, y registrar la arquitectura, el vocabulario y las fuentes de datos.
- Separar los conjuntos de entrenamiento, desarrollo y prueba con etiquetado independiente, evitando contaminar la prueba mediante la selección del profesor.
- Realizar un barrido de temperaturas y pesos de mezcla, y registrar las líneas base del estudiante sin destilación y de etiquetas duras.
- Estratificar según el éxito o el fallo del profesor y la dificultad de la tarea, y examinar la herencia de errores.
- Medir el almacenamiento del modelo, el pico de memoria y las latencias de prellenado y decodificación, manteniendo fijos el hardware y el tamaño del lote.
- Divulgar los costes de generación y entrenamiento, y conservar una evaluación independiente sin dejar las conclusiones exclusivamente en manos del profesor.
Ámbito de aplicación y limitaciones
- No se entrenó ningún modelo estudiante.
- La figura de suavizado de probabilidades no demuestra una mejora de calidad.
- La aproximación del gradiente en función de la temperatura tiene condiciones de aplicabilidad.
- La supervisión del profesor puede transmitir sesgos sistemáticos.
Fuentes primarias y afirmaciones correspondientes
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter, , , · 2019-10-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo en JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag coincide. El texto, las fórmulas, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de las figuras científicas; estas se calculan mediante fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versiones e historial de correcciones · /guides/distillation-small-models/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770