
要旨
蒸留は教師の出力または中間表現を用いて学生を訓練し、クラス間の相対的関係を伝える可能性がある一方、バイアスや誤りも伝えうる。本稿では、温度が確率と勾配に及ぼす作用を導出し、一般的なTの二乗によるスケーリングの成立条件を説明するとともに、分類のロジット蒸留と系列生成の蒸留の違いを論じる。図示には固定した四つのロジットを使用しており、いかなるモデルの実測結果でもない。検証計画では、独立した正解、教師の失敗に関する層別化、および同一の資源制約を要求する。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste[3] LoRA: Low-Rank Adaptation of Large Language Models
原文英語要旨の日本語訳
知識蒸留が転移するのは教師の分布であり、正解そのものではない。本稿では、温度スケーリング、勾配の大きさ、容量の限界を分析し、ロジット、系列、表現による教師信号を区別する。固定した四つのロジットによる例は、エントロピーの変化のみを示す。学生の品質を評価するには、独立したラベルに加え、継承された教師の誤り、レイテンシ、資源使用量の評価が必要である。
1. ソフトラベルは相対的関係とともにバイアスも伝える
ハードラベルが示すのは単一の目標クラスのみであるが、教師の分布は他のクラス間の相対的な類似性も表現できる。ただし、これらの確率は教師とその訓練文脈に由来し、較正されているとは限らず、真の不確実性を反映しているとも限らない。学生は有用な構造を学習する可能性がある一方、特定の集団やまれな入力に対する教師の系統的な誤りを再現する可能性もある。したがって、蒸留損失の低下が証明するのは、学生が使用された教師信号に近づいたことだけであり、独立した正解に近づいたことを直接証明するものではない。教師と学生はともに、開発に使用されていないラベル付きデータセットで評価すべきである。[1] Distilling the Knowledge in a Neural Network
2. 温度は確率分布の形状と勾配のスケールを変える
ロジットをTで割ると、Tが大きい場合に分布が平坦になり、上位に続くクラス間の相対的関係が明らかになる。教師と学生の温度が同じ場合、学生のロジットに関する交差エントロピーの勾配には1/Tが含まれる。高温近似では、確率差も1/Tに比例して縮小する可能性があるため、損失の大きさを調整するためにTの二乗がよく用いられる。この近似は、任意のTと任意の分布で勾配が厳密に等しくなることを意味しない。重み、ハードラベルの比率、オプティマイザをすべて記録すべきであり、温度を変更した後の損失値をそのまま横並びに比較することはできない。[1] Distilling the Knowledge in a Neural Network
3. 学生の容量は近似可能な教師の振る舞いを制限する
教師ありデータが十分にあっても、学生のアーキテクチャは教師のすべての振る舞いを同時に表現できない可能性がある。層数、隠れ次元、注意機構の構造、語彙はいずれも近似誤差に影響する。パラメータ数が同じでも、レイテンシが同じになるとは限らない。DistilBERTは事前学習における具体的な蒸留手法を示したものであり、すべてのタスクで一定の比率による圧縮と能力の維持が可能であることを意味しない。アーキテクチャの縮小、訓練目的の変更、データの追加の効果を区別し、蒸留していない学生のベースラインを保持する必要がある。[2] DistilBERT, a distilled version of BERT: smaller, faste[1] Distilling the Knowledge in a Neural Network
4. 系列蒸留は訓練データの分布を変える
教師が生成したテキストで学生を訓練する場合、教師信号となるのはサンプリングまたは選別された系列であり、各位置における完全な分布ではない。温度、デコーディング、プロンプト、フィルタリングは、どの振る舞いが訓練に取り込まれるかを変える。教師が正答したサンプルや回答しやすいサンプルだけを残すと、学生は難しい境界事例や回答拒否の状況を十分に学べない可能性がある。また、教師の説明が誤っている場合も、それを目標として学習してしまう可能性がある。生成設定とサンプル選択を記録し、テキストの模倣と確率蒸留を同一の教師信号として混同すべきではない。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
5. 資源の比較には品質制約の固定が必要である
小さな学生は保存容量や推論コストを削減する可能性があるが、実際のサービス速度はデバイス、バッチサイズ、系列長、カーネルに依存する。必要な品質を達成するために学生がより多くのサンプリングや外部検索を必要とするなら、システムコストはパラメータ数に比例して低下するとは限らない。LoRAはパラメータ更新の手法であり、推論モデルを縮小することとは目的が異なる。大規模モデルを凍結して少数のパラメータを訓練しても、小規模モデルによるサービスが自動的に得られるわけではない。訓練対象パラメータの削減を推論の圧縮と見なすのではなく、同じ品質目標またはレイテンシ目標の下でシステム全体を比較すべきである。[3] LoRA: Low-Rank Adaptation of Large Language Models[2] DistilBERT, a distilled version of BERT: smaller, faste
6. 教師の盲点を受入評価の出発点にする必要がある
全体的な指標に加えて、教師は正しいが学生は誤るサンプル、教師が誤り学生もそれに追従するサンプル、学生が教師の誤りを修正するサンプルを個別に確認すべきである。複数の教師やハードラベルは追加の制約を提供できるが、バイアスがないことを自動的に保証するものではない。最終報告では、教師の出所、バージョン、データのライセンス、生成コスト、独立評価を明記し、教師が自らの学生を評価することによる循環的なエビデンスを避ける必要がある。本稿は損失と確率分布の形状のみを分析しており、学生の訓練を完了したものでも、特定の割合の能力を保持したと主張するものでもない。[1] Distilling the Knowledge in a Neural Network[2] DistilBERT, a distilled version of BERT: smaller, faste
主要な数式と導出
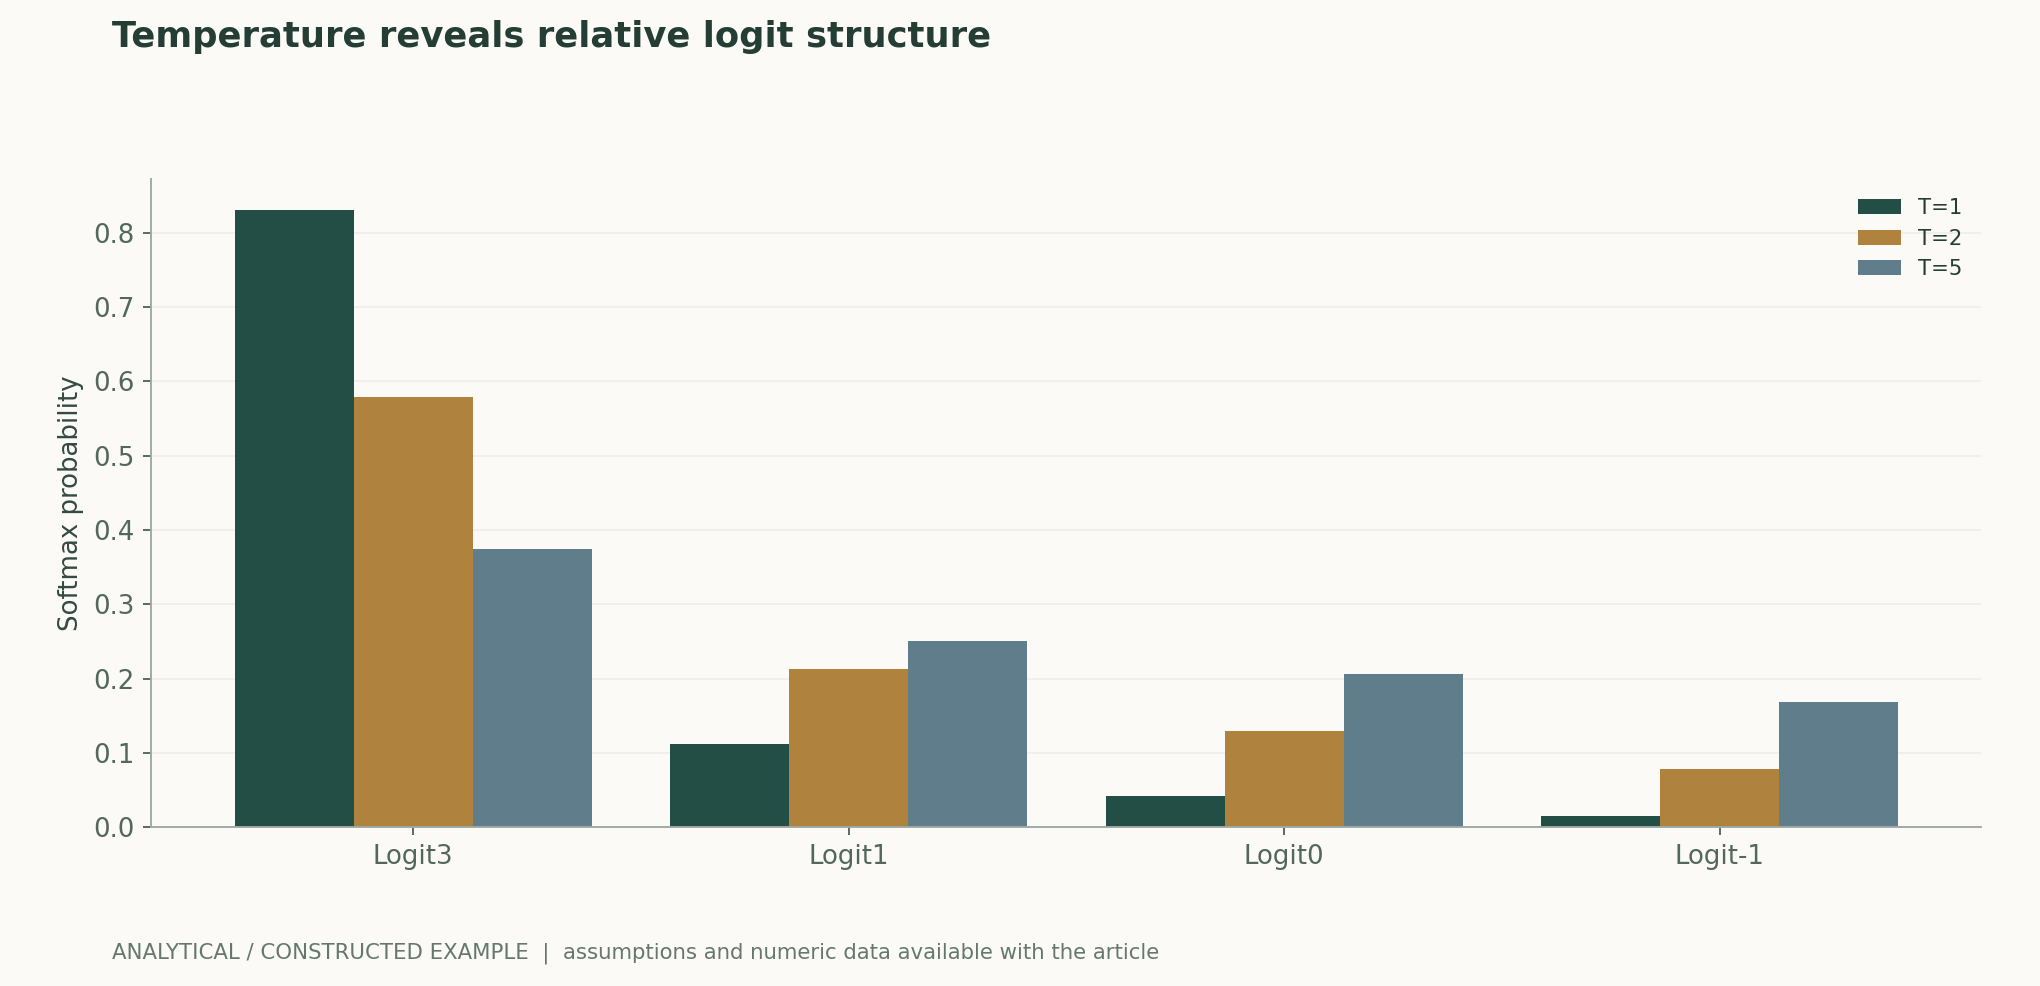
(1) 図示したロジットは3、1、0、−1であり、温度は1、2、5である。確率の平滑化のみを示す。
LaTeX
p_i^{(T)}=\frac{\exp(z_i/T)}{\sum_j\exp(z_j/T)}(2) 一般的な混合目的の一例。教師は固定されており、λ、T、ハードラベルの出所をすべて公開する必要がある。
LaTeX
\mathcal L=(1-\lambda)\operatorname{CE}(y,p_s^{(1)})+\lambda T^2\operatorname{KL}(p_t^{(T)}\Vert p_s^{(T)})(3) 温度の明示的な因子を示す。Tの二乗によるスケーリングの根拠は、高温下における確率差の近似的な振る舞いにも依存する。
LaTeX
\frac{\partial\operatorname{CE}(p_t^{(T)},p_s^{(T)})}{\partial z_{s,i}}=\frac{p_{s,i}^{(T)}-p_{t,i}^{(T)}}{T}方法とエビデンスの流れ
解析図と数値例
再計算可能な例題
ロジットを固定した場合、最大のクラス確率はT=1で約0.831、T=5で約0.375となる。分布が平坦になることは、学生がよりよく学習したことを意味しない。正解ラベルに対する品質を別途測定する必要がある。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| ロジット蒸留 | 温度、分布、ハードラベルの比率を保存する | 教師への接近は正解への接近を意味しない |
| 系列蒸留 | プロンプト、サンプリング、選別の規則を記録する | 生成テキストは教師の完全な分布ではない |
| 表現蒸留 | 層の対応付けと損失の重みを明示する | 表現が類似していても、タスク上の振る舞いが同じとは限らない |
| デプロイのための圧縮 | 同一の品質におけるサービス全体のコストを測定する | 訓練時のパラメータ効率はモデルの縮小ではない |
検証と実験の計画
- 教師と学生のバージョンを固定し、アーキテクチャ、語彙、データの出所を記録する。
- 訓練セット、開発セット、独立にラベル付けしたテストセットを分離し、教師による選別がテストを汚染しないようにする。
- 温度と混合重みを走査し、蒸留していない学生とハードラベルのベースラインを記録する。
- 教師の成功・失敗とタスクの難易度に応じて層別化し、誤りの継承を調べる。
- ハードウェアとバッチサイズを固定し、モデルの保存容量、ピークメモリ使用量、プリフィルおよびデコーディングのレイテンシを測定する。
- 生成と訓練のコストを公開し、教師だけに結論を委ねず、独立評価を維持する。
適用範囲と限界
- 学生モデルの訓練は行っていない。
- 確率の平滑化を示す図は品質向上を意味しない。
- 温度に関する勾配の近似には適用条件がある。
- 教師による監督は系統的なバイアスを継承させる可能性がある。
一次資料と主張の対応
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
- DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter, , , · 2019-10-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
引用と原稿のエクスポート
著者、バージョン、出所
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的な導出を行った。当サイトには、本稿に関する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同じ場合にも、既読ページを再利用する。本文、数式、出所、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学図は区別している。科学図は公開された数式と明示的な仮定から計算し、原論文の結果にはすべて帰属を明記している。
著者、バージョン、訂正履歴 · /guides/distillation-small-models/v1/
表紙と科学図の出所 · データ、出所、仮定 · 公開・バージョン履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770