
Resumen
El descubrimiento de ecuaciones busca explicaciones dinámicas compactas a partir de mediciones, pero varias ecuaciones pueden coincidir a lo largo de una única trayectoria observada. Por tanto, la regresión dispersa y la búsqueda simbólica requieren algo más que un error de ajuste bajo. Esta revisión examina el ruido de las derivadas, la colinealidad de la biblioteca y las variables ocultas, y después muestra cómo nuevas condiciones iniciales e intervenciones pueden convertir una fórmula plausible en una hipótesis científica discriminante.
Una ecuación ajustada es un mecanismo candidato
Un algoritmo puede encontrar una expresión compacta que prediga una serie temporal medida. Esa expresión puede describir una aproximación local, una proyección de una dinámica oculta o una auténtica relación gobernante. La distinción depende de lo que suceda fuera de la trayectoria ajustada. El descubrimiento científico requiere un modelo que resista observaciones diseñadas para poner a prueba su interpretación.
Tres vías hacia leyes compactas
Brunton, Proctor y Kutz desarrollaron la identificación dispersa de dinámicas no lineales. Rudy y sus colaboradores extendieron el descubrimiento basado en datos a las ecuaciones en derivadas parciales. Schmidt y Lipson utilizaron métodos simbólicos para extraer leyes naturales de forma libre a partir de datos experimentales. Estos enfoques demuestran potentes estrategias de búsqueda, aunque su éxito depende de la observabilidad, las representaciones candidatas y la calidad de las mediciones. [1], [2], [3]
Una trayectoria puede hacer que los términos sean indistinguibles
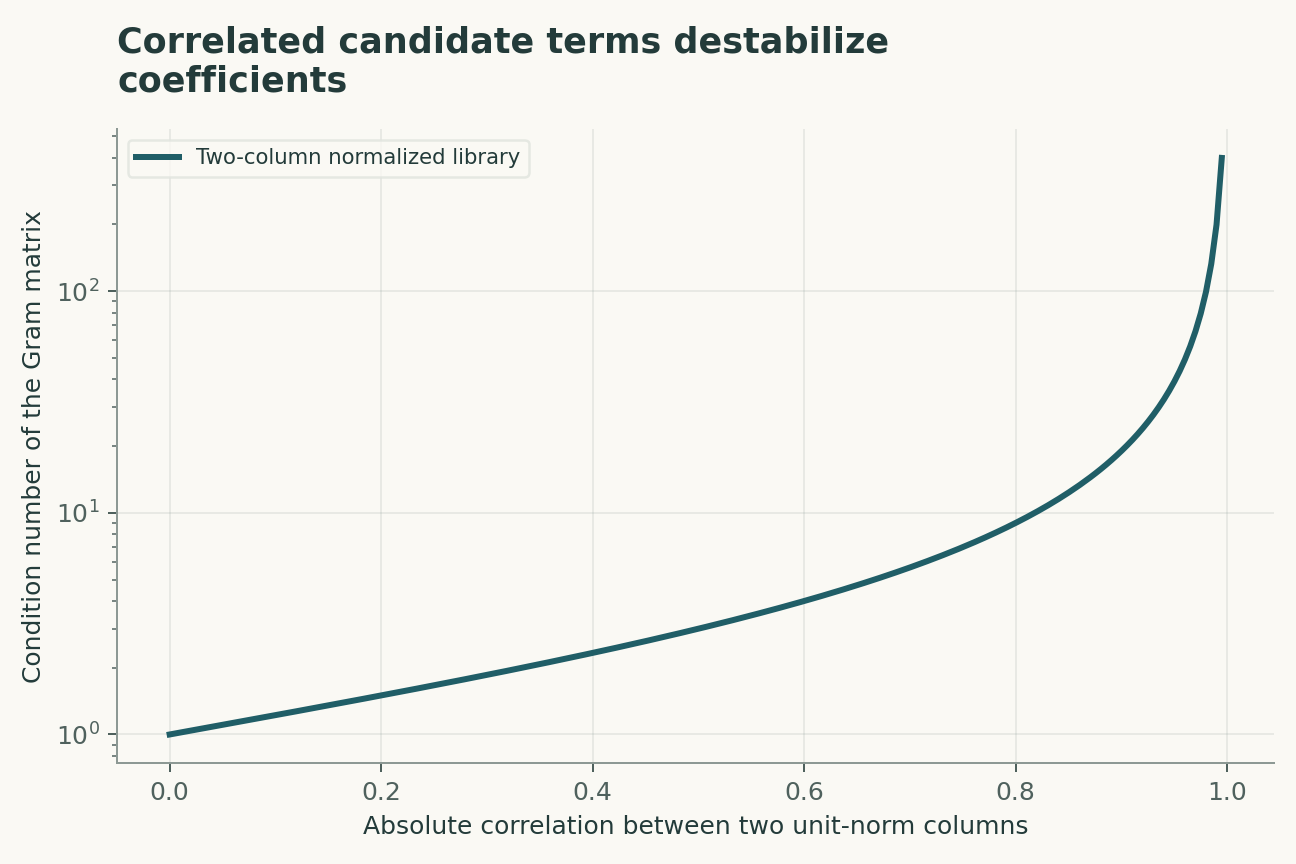
A lo largo de una trayectoria limitada, dos funciones candidatas pueden estar muy correlacionadas. Un ajuste disperso puede seleccionar cualquiera de ellas con escasos cambios en el error residual. El término elegido puede entonces reflejar la regularización o el ruido, en lugar de evidencia física que lo identifique de manera única. Variar las condiciones iniciales o el forzamiento puede separar las funciones al explorar una parte distinta del espacio de estados.
La diferenciación amplifica el ruido
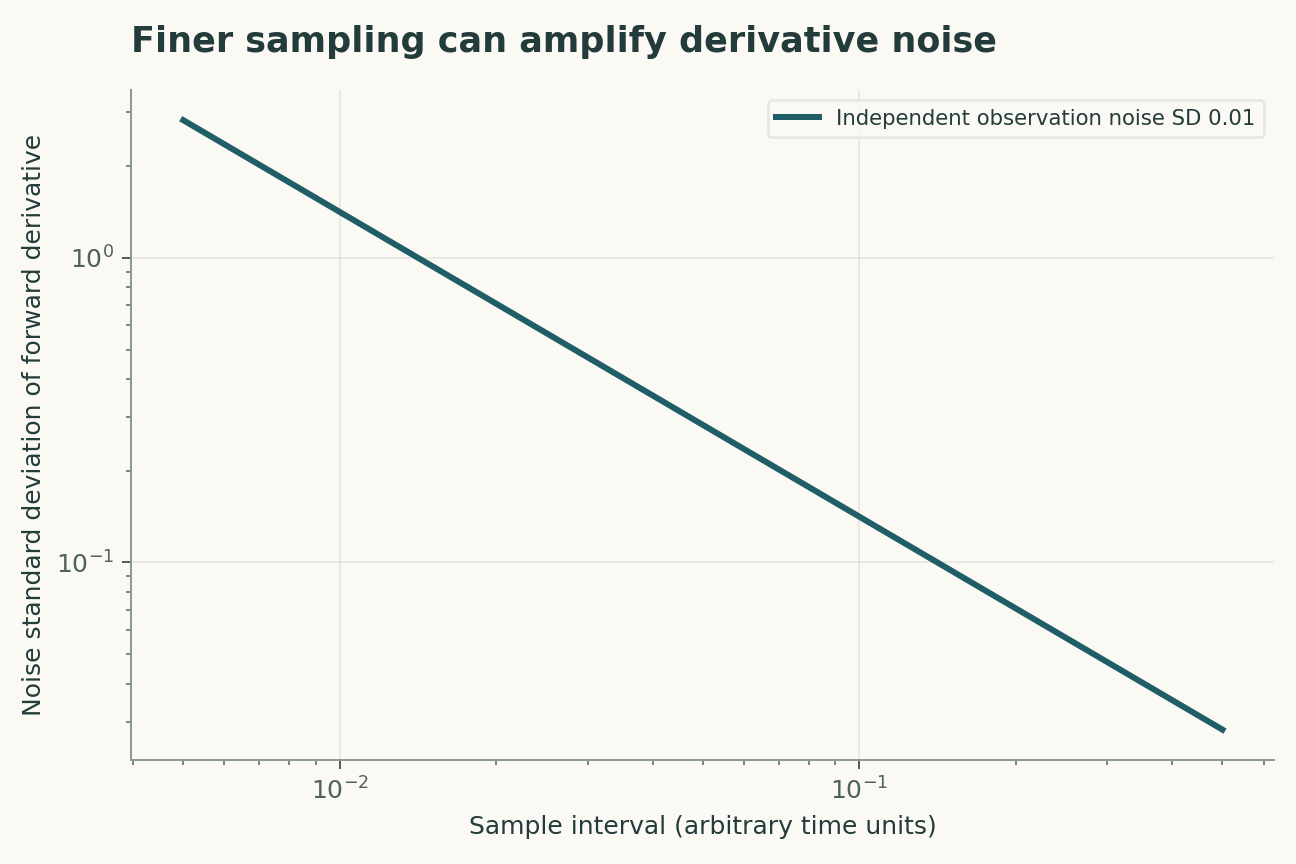
Estimar una derivada temporal a partir de mediciones ruidosas implica dividir diferencias por un intervalo temporal pequeño. Los intervalos más cortos mejoran la resolución temporal, pero pueden amplificar el ruido de medición en la derivada. El suavizado reduce el ruido a costa de introducir sesgo y perder dinámicas rápidas. Por tanto, el procedimiento de estimación de derivadas forma parte de la ecuación inferida y no es un paso neutro de preprocesamiento.
La biblioteca define qué puede descubrirse
Un método no puede seleccionar un mecanismo ausente de sus funciones candidatas, a menos que la representación pueda construirlo. A la inversa, una biblioteca enorme puede generar una colinealidad grave y sobreajuste. Las restricciones físicas, la coherencia dimensional y la simetría pueden reducir el espacio de búsqueda, pero deben declararse como estructura previa, en vez de presentarse como descubrimientos derivados únicamente de los datos.
Las variables ocultas generan memoria aparente
Un observable proyectado puede no obedecer una ecuación cerrada de primer orden, aunque el sistema completo sí lo haga. Eliminar variables no observadas puede producir memoria o ruido efectivo. Imponer un modelo disperso markoviano a ese observable puede generar coeficientes que cambien entre condiciones. Las mediciones adicionales del estado o las coordenadas de retardo pueden revelar la estructura que falta.
La predicción debe cruzar un límite significativo
Reservar puntos temporales adyacentes para la validación evalúa la interpolación dentro de una trayectoria conocida. Reservar una nueva condición inicial o un nuevo régimen de forzamiento evalúa una afirmación más fuerte. La predicción iterada a largo plazo también revela inestabilidades que una puntuación de un solo paso puede ocultar. La validación debe corresponder al uso previsto, examinando las propiedades de conservación y el comportamiento cualitativo en el espacio de fases junto con el error numérico.
Puede elegirse un experimento para suscitar discrepancias
La siguiente medición más útil es aquella para la que las ecuaciones candidatas que siguen siendo viables hacen predicciones diferentes. Esto convierte el descubrimiento en un proceso iterativo de construcción de modelos y discriminación experimental. Un fallo resulta entonces informativo: elimina un candidato o revela una variable omitida. El objetivo no es la expresión más corta, sino el modelo más sencillo que siga siendo adecuado ante pruebas explícitas.
Un término descubierto puede representar una variable oculta
Si el estado observado omite una variable relevante, un algoritmo puede ajustar términos no lineales adicionales que aproximen la dinámica ausente a lo largo de la trayectoria muestreada. Esos términos pueden predecir localmente y, a la vez, representar de forma errónea el mecanismo. Una validación propuesta variaría las condiciones iniciales o un control externo para que los modelos con variables ocultas y los modelos de estado cerrado hicieran predicciones diferentes. Fallar bajo esa intervención sería más informativo que un pequeño aumento del error de interpolación. La biblioteca candidata debe elegirse con restricciones dimensionales y de simetría cuando estén justificadas, conservando la posibilidad de que ningún elemento de la biblioteca describa adecuadamente las observaciones.
La excitación experimental forma parte de la identificabilidad
Dos funciones candidatas pueden ser casi colineales a lo largo de una trayectoria, aunque difieran mucho en otras regiones del espacio de estados. Recoger más puntos de la misma trayectoria mejora entonces la precisión sin resolver la ambigüedad. Un diseño propuesto seleccionaría condiciones que separasen esas funciones y cuantificaría el cambio resultante en el condicionamiento de la biblioteca. La diferenciación numérica añade una segunda disyuntiva: reducir el intervalo de muestreo puede amplificar el ruido de medición independiente. Las formulaciones sin derivadas o integrales pueden ayudar bajo supuestos adecuados, pero deben evaluarse con el mismo modelo de observación. El descubrimiento de una ecuación compacta resulta convincente cuando esta resiste tales intentos deliberados de distinguirla de las alternativas.
Un modelo que puede ponerse a prueba
Las cuatro ecuaciones siguientes constituyen un modelo analítico compacto, no un ajuste conjunto de todos los artículos citados. Su interpretación es la siguiente. Una biblioteca de funciones candidatas Theta y una matriz de coeficientes dispersa Xi representan un modelo dinámico propuesto. Un ajuste ilustrativo con una penalización que favorece la dispersión equilibra el error residual y la dispersión de los coeficientes; otros algoritmos utilizan penalizaciones distintas. Los errores de medición independientes con varianza sigma al cuadrado hacen que el ruido de la derivada por diferencias finitas crezca como el inverso del cuadrado del intervalo. Para dos columnas estandarizadas de la biblioteca con correlación r, este es el número de condición de su matriz de Gram; la casi colinealidad perjudica la identificación de los coeficientes.
El objetivo observacional son ecuaciones que predigan trayectorias independientes e intervenciones. El modelo aísla deliberadamente un mecanismo tratable; su propósito es revelar qué mediciones distinguirían ese mecanismo de una alternativa. Los valores de los parámetros de las figuras se declaran como entradas ilustrativas. Una curva producida con esos valores es una consecuencia matemática, no una estimación de una magnitud biológica o física no medida.
Un diseño de validación discriminante
La comparación principal debe evaluar ecuaciones candidatas que hagan predicciones distintas fuera de la trayectoria. La unidad de replicación independiente es una trayectoria o un experimento independiente; las lecturas repetidas de la misma unidad mejoran la precisión, pero no generan replicación independiente. Una validación sólida reservaría nuevas condiciones iniciales y regímenes de forzamiento antes de elegir umbrales o ajustar correcciones de factores de molestia. En particular, el ruido de las derivadas, las funciones colineales y las variables de estado no observadas deben medirse, restringirse o variarse en un análisis de sensibilidad. Deben comunicarse tanto la estimación principal como su cambio al relajar ese supuesto. Un modelo que solo tiene éxito tras elegir la regla de exclusión más favorable ha respondido a una pregunta diferente de la de un modelo evaluado con una regla fijada de antemano.
Análisis numérico desarrollado
Con una desviación estándar del ruido de medición independiente de 0.01, un intervalo de diferencias finitas de 0.1 produce una desviación estándar del ruido de la derivada de aproximadamente 0.1414; reducir el intervalo a 0.01 la eleva a aproximadamente 1.414. Para columnas estandarizadas de la biblioteca con una correlación de 0.99, el número de condición de la matriz de Gram es 199. Las figuras muestran por separado el ruido de las derivadas y la ambigüedad de los coeficientes, sin afirmar el descubrimiento de una nueva ley física.
Estos cálculos pueden reconstruirse a partir del archivo Python complementario y de su tabla de parámetros. Las etiquetas de los ejes conservan las unidades del modelo, y el pie distingue las magnitudes que se varían de las que se mantienen constantes. Los ejemplos numéricos se seleccionaron para mostrar una dependencia, no para reproducir el aspecto de una figura publicada. Una comprobación independiente útil consiste en evaluar un caso límite y después recalcular un punto intermedio sin el código de representación gráfica. La concordancia valida la aritmética dentro del modelo declarado; no demuestra que la naturaleza siga ese modelo.
Evidencia, transferencia y próximos pasos
El alcance de la conclusión está limitado por el ruido de las derivadas, las funciones colineales y las variables de estado no observadas. La transferencia a nuevas condiciones iniciales y regímenes de forzamiento requiere evidencia que vaya más allá del ajuste a las observaciones originales. Una futura replicación debe conservar las mediciones originales, los registros de calibración, las exclusiones y un vínculo legible por máquina entre cada resultado y el análisis correspondiente. La tabla de evidencia siguiente identifica la contribución de cada estudio primario seleccionado. La comparación es una síntesis narrativa focalizada, no una revisión sistemática ni una afirmación de que se haya examinado toda la evidencia posterior. El estudio propuesto no se ha realizado aquí. Su valor reside en que un resultado negativo restringiría una explicación explícita, en lugar de limitarse a reducir una puntuación de referencia.
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Una biblioteca de funciones candidatas Theta y una matriz de coeficientes dispersa Xi representan un modelo dinámico propuesto.
(2) Un ajuste ilustrativo con una penalización que favorece la dispersión equilibra el error residual y la dispersión de los coeficientes; otros algoritmos utilizan penalizaciones distintas.
(3) Los errores de medición independientes con varianza sigma al cuadrado hacen que el ruido de la derivada por diferencias finitas crezca como el inverso del cuadrado del intervalo.
(4) Para dos columnas estandarizadas de la biblioteca con correlación r, este es el número de condición de su matriz de Gram; la casi colinealidad perjudica la identificación de los coeficientes.
Ejemplos construidos · Datos reproducibles
Examinar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Evidencia o decisión de diseño | Qué identifica | Qué queda sin resolver |
|---|---|---|
| Fuente 1 | SINDy identificó modelos dinámicos dispersos a partir de datos. | La biblioteca candidata y la observabilidad del estado limitan el descubrimiento. |
| Fuente 2 | El descubrimiento de ecuaciones en derivadas parciales (PDE) recuperó ecuaciones espaciotemporales compactas en los contextos estudiados. | La estimación de derivadas y la calidad de las mediciones siguen siendo fundamentales. |
| Fuente 3 | La búsqueda simbólica extrajo relaciones compactas a partir de datos experimentales. | La compacidad y el ajuste no bastan por sí solos para establecer un mecanismo único. |
| Observable principal | ecuaciones que predigan trayectorias independientes e intervenciones | ruido de las derivadas, funciones colineales y variables de estado no observadas |
| Prueba independiente | ecuaciones candidatas que hagan predicciones distintas fuera de la trayectoria | Requiere nuevas mediciones |
| Conjunto de transferencia | nuevas condiciones iniciales y regímenes de forzamiento | No validado por el ejemplo numérico construido |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ningún nuevo experimento biológico, ensayo clínico o experimento físico para este artículo.
- Especificar, antes del ajuste, ecuaciones que predigan trayectorias independientes e intervenciones.
- Conservar identificadores independientes para cada trayectoria o experimento independiente.
- Separar las nuevas condiciones iniciales y los regímenes de forzamiento del desarrollo del modelo.
- Medir o acotar el ruido de las derivadas, las funciones colineales y las variables de estado no observadas.
- Registrar las unidades, la calibración y el operador de observación.
- Comparar el modelo principal con una explicación rival identificada por su nombre.
- Especificar de antemano la prueba: ecuaciones candidatas que hagan predicciones distintas fuera de la trayectoria.
- Archivar los datos originales, las exclusiones, los archivos de parámetros y el análisis ejecutable.
Qué establecen las fuentes primarias
Steven L. Brunton, Joshua L. Proctor, J. Nathan Kutz · 2016 [1]
Contribución. SINDy identificó modelos dinámicos dispersos a partir de datos.
Límite. La biblioteca candidata y la observabilidad del estado limitan el descubrimiento.
Ubicación en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Samuel H. Rudy, Steven L. Brunton, Joshua L. Proctor et al. · 2017 [2]
Contribución. El descubrimiento de ecuaciones en derivadas parciales (PDE) recuperó ecuaciones espaciotemporales compactas en los contextos estudiados.
Límite. La estimación de derivadas y la calidad de las mediciones siguen siendo fundamentales.
Ubicación en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Michael Schmidt, Hod Lipson · 2009 [3]
Contribución. La búsqueda simbólica extrajo relaciones compactas a partir de datos experimentales.
Límite. La compacidad y el ajuste no bastan por sí solos para establecer un mecanismo único.
Ubicación en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Límites de este análisis
- La biblioteca candidata y la observabilidad del estado limitan el descubrimiento.
- La estimación de derivadas y la calidad de las mediciones siguen siendo fundamentales.
- La compacidad y el ajuste no bastan por sí solos para establecer un mecanismo único.
- Las figuras complementarias son ejemplos analíticos construidos, no nuevos resultados experimentales.
- Esta revisión no ha demostrado la transferencia a nuevas condiciones iniciales y regímenes de forzamiento.
Un análisis narrativo focalizado de los estudios primarios mencionados, no una búsqueda bibliográfica sistemática ni una afirmación de cobertura exhaustiva hasta 2026.
Preguntas que cambiarían la conclusión
- ¿Qué nueva condición inicial separa las ecuaciones que siguen siendo viables?
- ¿Qué variable oculta haría que la dinámica estuviera más cerca de ser cerrada?
- ¿Cómo cambia la estimación de derivadas los términos seleccionados y la estabilidad?
Referencias
- Steven L. Brunton, Joshua L. Proctor, J. Nathan Kutz. Discovering governing equations from data by sparse identification of nonlinear dynamical systems. Proceedings of the National Academy of Sciences (2016). 10.1073/pnas.1517384113.
- Samuel H. Rudy, Steven L. Brunton, Joshua L. Proctor et al.. Data-driven discovery of partial differential equations. Science Advances (2017). 10.1126/sciadv.1602614.
- Michael Schmidt, Hod Lipson. Distilling Free-Form Natural Laws from Experimental Data. Science (2009). 10.1126/science.1165893.
Identidad bibliográfica cotejada con Crossref. La interpretación utiliza registros primarios accesibles, resúmenes y textos seleccionados; la cobertura de textos completos y métodos suplementarios no es exhaustiva.
Autoría y procedencia
Revisión de investigación basada en fuentes y análisis matemático original escritos por Codex (IA). Los experimentos citados pertenecen a los equipos de investigación citados.
Portada conceptual creada con la herramienta integrada ImageGen. Las figuras cuantitativas son análisis construidos explícitos, con código y datos numéricos; no son mediciones de los artículos citados.
Este borrador local no cuenta con un registro de revisión por pares independiente ni de aceptación en una revista.