
الملخص
تختزل لوحات الترتيب القدرات المعقدة في عدد واحد، مما ييسّر المقارنة، لكنه قد يحجب أيضاً آثار اختيار العينات والوسم والتلوث وأوزان التجميع. تضيف هذه المراجعة إلى أطر التقييم متعددة الأبعاد القائمة اشتقاقات إحصائية ومقارنات مقترنة وتحليلاً لحوكمة البيانات، لتوضح لماذا لا تستطيع الدرجة المرتفعة بمفردها الإجابة عن أسئلة الموثوقية أو قابلية النقل أو أعباء العمل الفعلية. أمثلة فواصل الثقة ومزيج التلوث المضافة كلها حسابات تستند إلى صيغ متاحة علناً، وليست قياسات تجريبية لنموذج مستخدم فعلياً. وتوصي المراجعة بنشر موضوع التقييم والشيفرة والعينات وتوزيع الإخفاقات معاً، بدلاً من الاكتفاء بنشر نتائج الترتيب.[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
ترجمة الملخص الإنجليزي
تُعامَل درجات الاختبارات المعيارية بوصفها قياسات تنطوي على عدم يقين ناشئ عن أخذ العينات والوسم والاختيار. تشتق المراجعة فواصل للدقة في العينات المحدودة، وتميز بين المقارنات المقترنة والمستقلة للنماذج، وتوضح لماذا يمكن أن تنعكس الترتيبات الإجمالية عند إعادة ترجيح المهام. ويُعد ضبط التلوث وبيان التقييم القابل للتدقيق ضروريين لتفسير أي تحسن ظاهري؛ أما الأمثلة العددية فهي حسابات إحصائية مصطنعة لغرض التوضيح.
1. وسّع MMLU نطاق تغطية اختبارات المعرفة
يتضمن MMLU عدد 57 من المهام الأكاديمية والمهنية، مما يتيح للباحثين ملاحظة اختلاف أداء النماذج بين المجالات. ويمكن لمتوسط عبر المهام أن يساعد على التلخيص، لكنه قد يخفي الإخفاق في مجال معين. كما لا يمكن مساواة الأداء في أسئلة الاختيار من متعدد مباشرةً بالاستشارات المفتوحة أو تنفيذ المهام الطويلة أو الحصول على مؤهلات مهنية. تتمثل مساهمة الاختبار المعياري في توفير مجموعة أسئلة قابلة للمقارنة، وليس في الحلول محل جميع أشكال التحقق في الواقع.[1] Measuring Massive Multitask Language Understanding
2. يوضح HELM أن الدقة ليست سوى بُعد واحد
يُدرج HELM الدقة والمعايرة والمتانة والإنصاف والتحيز والسُّمّية والكفاءة ضمن إطار التقييم، ويوضح الأبعاد التي يمكن قياسها في كل سيناريو. وتكمن أهمية هذا التصميم في إظهار فجوات التغطية والمفاضلات علناً. فلا يجوز جمع مقاييس مختلفة المعاني والوحدات اعتباطياً في «درجة ذكاء شاملة»، ولا ينبغي ملء الخانات التي لم تُقَس بعد بدرجة صفر.[2] Holistic Evaluation of Language Models
3. تغيّر الأسئلة متعددة الوسائط موضوع القياس
يختبر MMMU المعرفة والاستدلال بأسئلة نصية وصورية عابرة للتخصصات، ويتضمن نحو 1.15 × عشرة آلاف سؤال، موزعة على 30 تخصصاً. ولا تقتصر قيمته على زيادة عدد الأسئلة، بل تشمل إدخال أشكال من المعلومات مثل الرسوم البيانية والمخططات البنيوية. فإذا حوّل نظام التقييم الصور أولاً إلى نصوص باستخدام نموذج آخر، فإن الدرجة تقيس سلسلة المعالجة بأكملها؛ أما إذا أُدخلت الصور مباشرةً، فيجب تسجيل دقتها وعمليات الاقتصاص وطريقة الإدخال.[3] MMMU: A Massive Multi-discipline Multimodal Understandi
4. يحدد حجم العينة مدى دقة الاستنتاجات
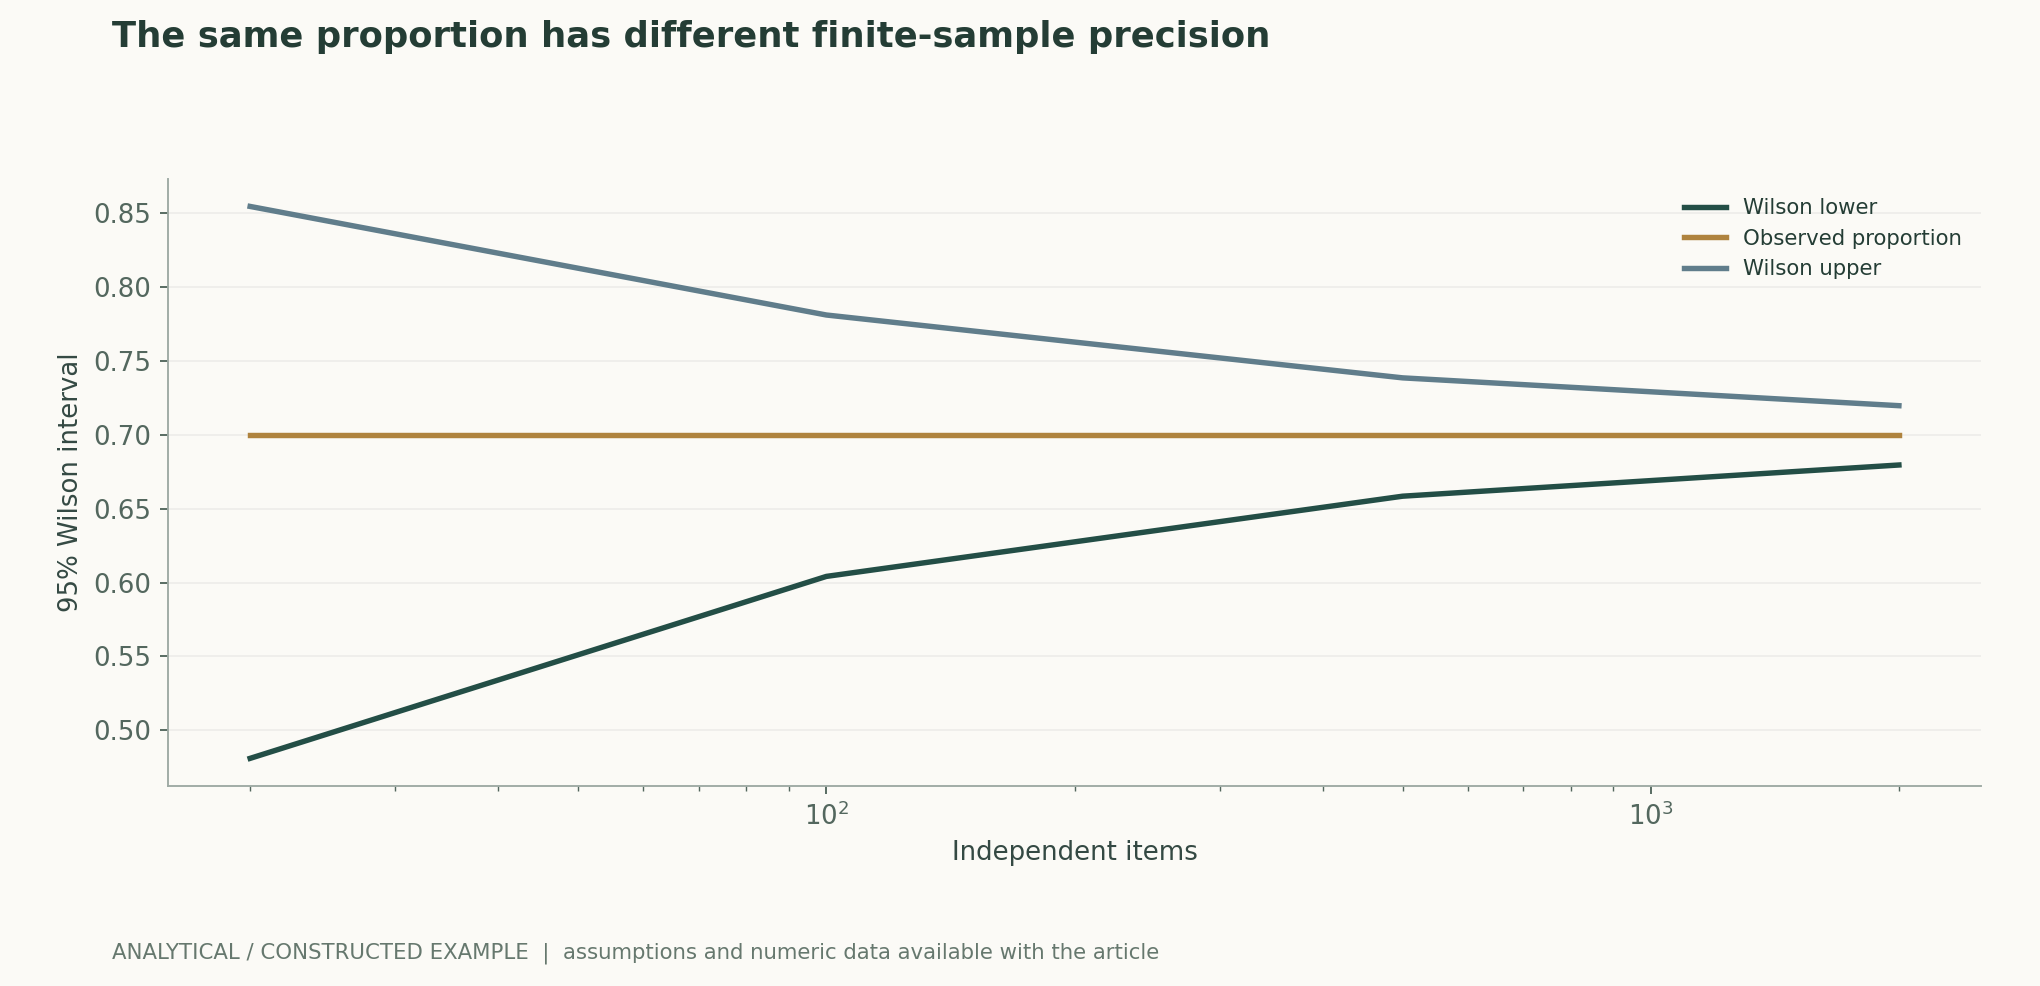
يثبّت الشكل 2 في هذه النسخة النسبة المرصودة عند 70%، ويستخدم n=20 و100 و500 و2000، ويحسب فواصل Wilson عند مستوى 95% لشرح العلاقة بين حجم العينة وعرض الفاصل؛ وهذه القيم ليست مستمدة من أي نموذج. وتعتمد الفواصل على مشاهدات ثنائية الحدين مستقلة؛ وقد تؤدي الأسئلة المتعددة من الوثيقة نفسها أو المستخدمون المتكررون أو القوالب المشتركة إلى خفض حجم العينة الفعّال. وينبغي اختيار إعادة أخذ العينات أو التقدير الطبقي وفق بنية الارتباط الفعلية، وعدم الاكتفاء باعتبار عدد الأسئلة عدداً من الأدلة المستقلة.作者分析与复核建议 / Author analysis
5. يتطلب تلوث الاختبار تسلسلاً زمنياً قابلاً للتتبع
إذا دخلت أسئلة التقييم أو إجاباتها في مواد التدريب، فقد يقيس الاختبار المعياري الحفظ والتعميم معاً. وتوصي هذه المراجعة بتسجيل الحد الزمني للبيانات المتاحة للتدريب، وتاريخ نشر مجموعة التقييم، وطرق إزالة التكرار، والتكرارات التقريبية المحتملة. فلا يجوز الادعاء بانعدام التلوث تماماً لمجرد أن مجموعة الاختبار لم تظهر في قائمة معروفة، كما لا يجوز اتهام نموذج بعينه بتسرب البيانات دون دليل.作者分析与复核建议 / Author analysis
6. المقارنة المقترنة أكثر إفادة من عمودين في رسم بياني
عند مقارنة نموذجين على دفعة الأسئلة نفسها، ينبغي الاحتفاظ بصحة كل إجابة أو خطئها وفئة المهمة، مع التركيز على الأسئلة التي يختلف فيها النموذجان. ولا يكفي تقديم قيمتي الدقة وفاصل كل منهما على حدة لتقييم عدم اليقين في الفرق تقييماً كاملاً. وإذا كانت للأسئلة بنية هرمية للفئات، فيمكن استخدام الأساليب الطبقية أو المقترنة الملائمة؛ وإذا تكرر انتقاء الإعدادات الأكثر ملاءمة، فينبغي الإفصاح عن عملية الاختيار. ولم تحسب هذه المراجعة الدلالة الإحصائية لأي نموذج فعلي.作者分析与复核建议 / Author analysis
7. ما الذي ينبغي أن تتضمنه سجلات إعادة الإنتاج
ينبغي حفظ نسخة الأسئلة، وقوالب التلقين، وأمثلة التلقين قليل الأمثلة، ومعلمات فك الترميز، وصلاحيات الأدوات، ومعرّف النموذج، ووقت التشغيل، وقواعد الإخفاق وإعادة المحاولة، ونسخة أداة التصحيح، على الأقل. وتختلف شروط إعادة الإنتاج بين النماذج ذات الأوزان المفتوحة والخدمات المتاحة عبر الإنترنت؛ فقد تُحدَّث الخدمة مع بقاء اسم المنتج نفسه. ويساعد بروتوكول التسجيل على تحديد ما إذا كانت التغييرات اللاحقة ناتجة عن النموذج أو مكونات النظام أو شروط التصحيح.作者分析与复核建议 / Author analysis
يحتاج المتوسط إلى أوزان محددة بوضوح
قد يؤدي احتساب متوسط يمنح كل سؤال الوزن نفسه إلى نتيجة تختلف عن احتساب متوسط لكل تخصص أولاً ثم منح التخصصات أوزاناً متساوية. فالطريقة الأولى تمنح التخصصات ذات الأسئلة الأكثر وزناً أكبر، بينما تؤكد الثانية التوازن بين المجالات؛ ويجب الإعلان عن تعريف كلتا الطريقتين بوضوح. وإذا كان المستخدمون المستهدفون يعالجون عدداً قليلاً فقط من هذه المهام، فينبغي أيضاً الإبلاغ عن نتائج تتوافق مع التوزيع الفعلي للمهام. ولا تحدد هذه المراجعة أوزاناً تصلح لجميع الاستخدامات، ولا تستنتج أن التخصصات الغائبة مشمولة بالتغطية.作者分析与复核建议 / Author analysis
8. يحتاج التقدير النقطي للدقة إلى نطاق للخطأ
إذا كانت n عينة مستقلة تتبع احتمال نجاح واحداً، فإن الخطأ المعياري لدقة العينة يقارب sqrt[p(1−p)/n]. لكن عند صغر حجم العينة أو الاقتراب من 0 أو 1، قد يكون الفاصل البسيط القائم على التقريب الطبيعي غير مستقر، ويكون فاصل Wilson عادةً أنسب لعرض عدم اليقين في العينات المحدودة. ومع ذلك، يظل معتمداً على نموذج أخذ العينات؛ فإذا شكّلت أسئلة الوثيقة نفسها أو صيغ السؤال نفسه عناقيد، فلا يجوز عدّ كل صيغة عينة مستقلة. وينبغي إجراء إعادة أخذ العينات بحسب وحدة المعاينة، وبيان ما إذا كان الفاصل يعكس أخذ عينات الأسئلة أو عشوائية النموذج أو أخطاء الوسم.[2] Holistic Evaluation of Language Models[1] Measuring Massive Multitask Language Understanding
9. مقارنة النماذج على مجموعة الأسئلة نفسها مسألة مقترنة
إذا أجاب نموذجان عن دفعة الأسئلة نفسها، فينبغي الحفاظ على المطابقة بين الإجابتين لكل سؤال عند مقارنة الفرق. فصيغة الخطأ الخاصة بعينتين مستقلتين تتجاهل بنية الارتباط هذه، وقد تضخّم عدم اليقين أو تقلّله. ويمكن عرض جدول تقاطعي لفئات «A وحده صحيح، وB وحده صحيح، وكلاهما صحيح، وكلاهما خاطئ»، أو إجراء bootstrap مقترن للأسئلة أو عناقيد الوثائق. كما أن تجربة تلقينات متعددة مراراً ثم الإبلاغ عن أفضل تلقين فقط تُدخل تحيزاً في الاختيار؛ لذا يجب إدراج ميزانية البحث عن التلقينات في وصف التجربة.[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
10. قد تهيمن أوزان المهام على الدرجة الإجمالية
لتكن درجة كل مجال s_j، ولتكن الدرجة الإجمالية المتوسط المرجح بأوزان المجالات w_j. إن تقدم نموذج في الترتيب تحت مجموعة من الأوزان لا يضمن بقاءه متقدماً تحت توزيع آخر لاحتياجات المستخدمين. كما يتطلب التقييم متعدد الوسائط التمييز بين أخطاء فهم الصور وقراءة النصوص والمعرفة والاستدلال، لتجنب وصف جميع الإخفاقات بأنها قصور في القدرة البصرية. وإلى جانب الدرجة الإجمالية المسجلة مسبقاً، ينبغي نشر درجات المجالات والأوزان والعناصر المفقودة وأداء المجموعة الفرعية الأسوأ، لتمكين المستخدمين من إعادة التجميع وفق مهامهم الفعلية.[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
11. ينبغي إدراج التلوث وإزالة التكرار في قائمة التحقق من التقييم
إذا دخلت عينات التقييم أو صيغ قريبة منها في التدريب أو الاسترجاع أو أمثلة التلقين، فقد تجمع الدرجة بين الحفظ والتعميم. ولا يكشف فحص التطابق الحرفي وحده إعادة الصياغة الدلالية، لكن التصفية على أساس التشابه بمعايير فضفاضة أكثر من اللازم قد تحذف أيضاً معرفة تخصصية مطلوبة فعلاً. ويُوصى بتسجيل تواريخ البيانات ومصادرها وقواعد إزالة التكرار الدقيق والتقريبي، وإجراء تحقق متقاطع باستخدام مجموعات أسئلة منشأة حديثاً وخاضعة لمراجعة بشرية. ويمكن لبناء نموذج خليط للتلوث أن يفسر ارتفاع الدرجة، لكن لا يمكن الاستدلال عكسياً من هذا الرسم على نسبة التلوث في نموذج واقعي بعينه.[4] Deduplicating Training Data Makes Language Models Bette[5] Documenting Large Webtext Corpora: A Case Study on the
الصيغ الأساسية واشتقاقاتها
(1) يمثل c عدد النجاحات. ولا ينطبق افتراض الاستقلال والتوزيع المتطابق على جميع مجموعات الأسئلة؛ أما p=0.7 في الرسم فهو مجرد إعداد تحليلي مفترض.
LaTeX
\widehat p=\frac{c}{n},\qquad \mathrm{SE}(\widehat p)\approx\sqrt{\widehat p(1-\widehat p)/n}(2) عند اختيار z بوصفه قيمة من دالة الكَمّ (quantile) للتوزيع الطبيعي المعياري، نحصل على فاصل الثقة التقريبي الموافق. وينبغي تحديد وحدة المعاينة، وعدم اعتبار الفاصل ضماناً للأداء في جميع المهام المستقبلية.
LaTeX
\mathrm{CI}_{\rm Wilson}=\frac{\widehat p+\frac{z^2}{2n}\ \pm\ z\sqrt{\frac{\widehat p(1-\widehat p)}{n}+\frac{z^2}{4n^2}}}{1+\frac{z^2}{n}}(3) أوزان المهام جزء من تصميم التقييم. وينبغي تثبيت طريقة التعامل مع المهام المفقودة وما إذا كانت الأوزان ستُعاد معايرتها لتصبح مُطبَّعة، والإفصاح عن ذلك قبل المقارنة.
LaTeX
S=\sum_jw_js_j,\quad \sum_jw_j=1,\quad w_j\ge0مسار المنهج والأدلة
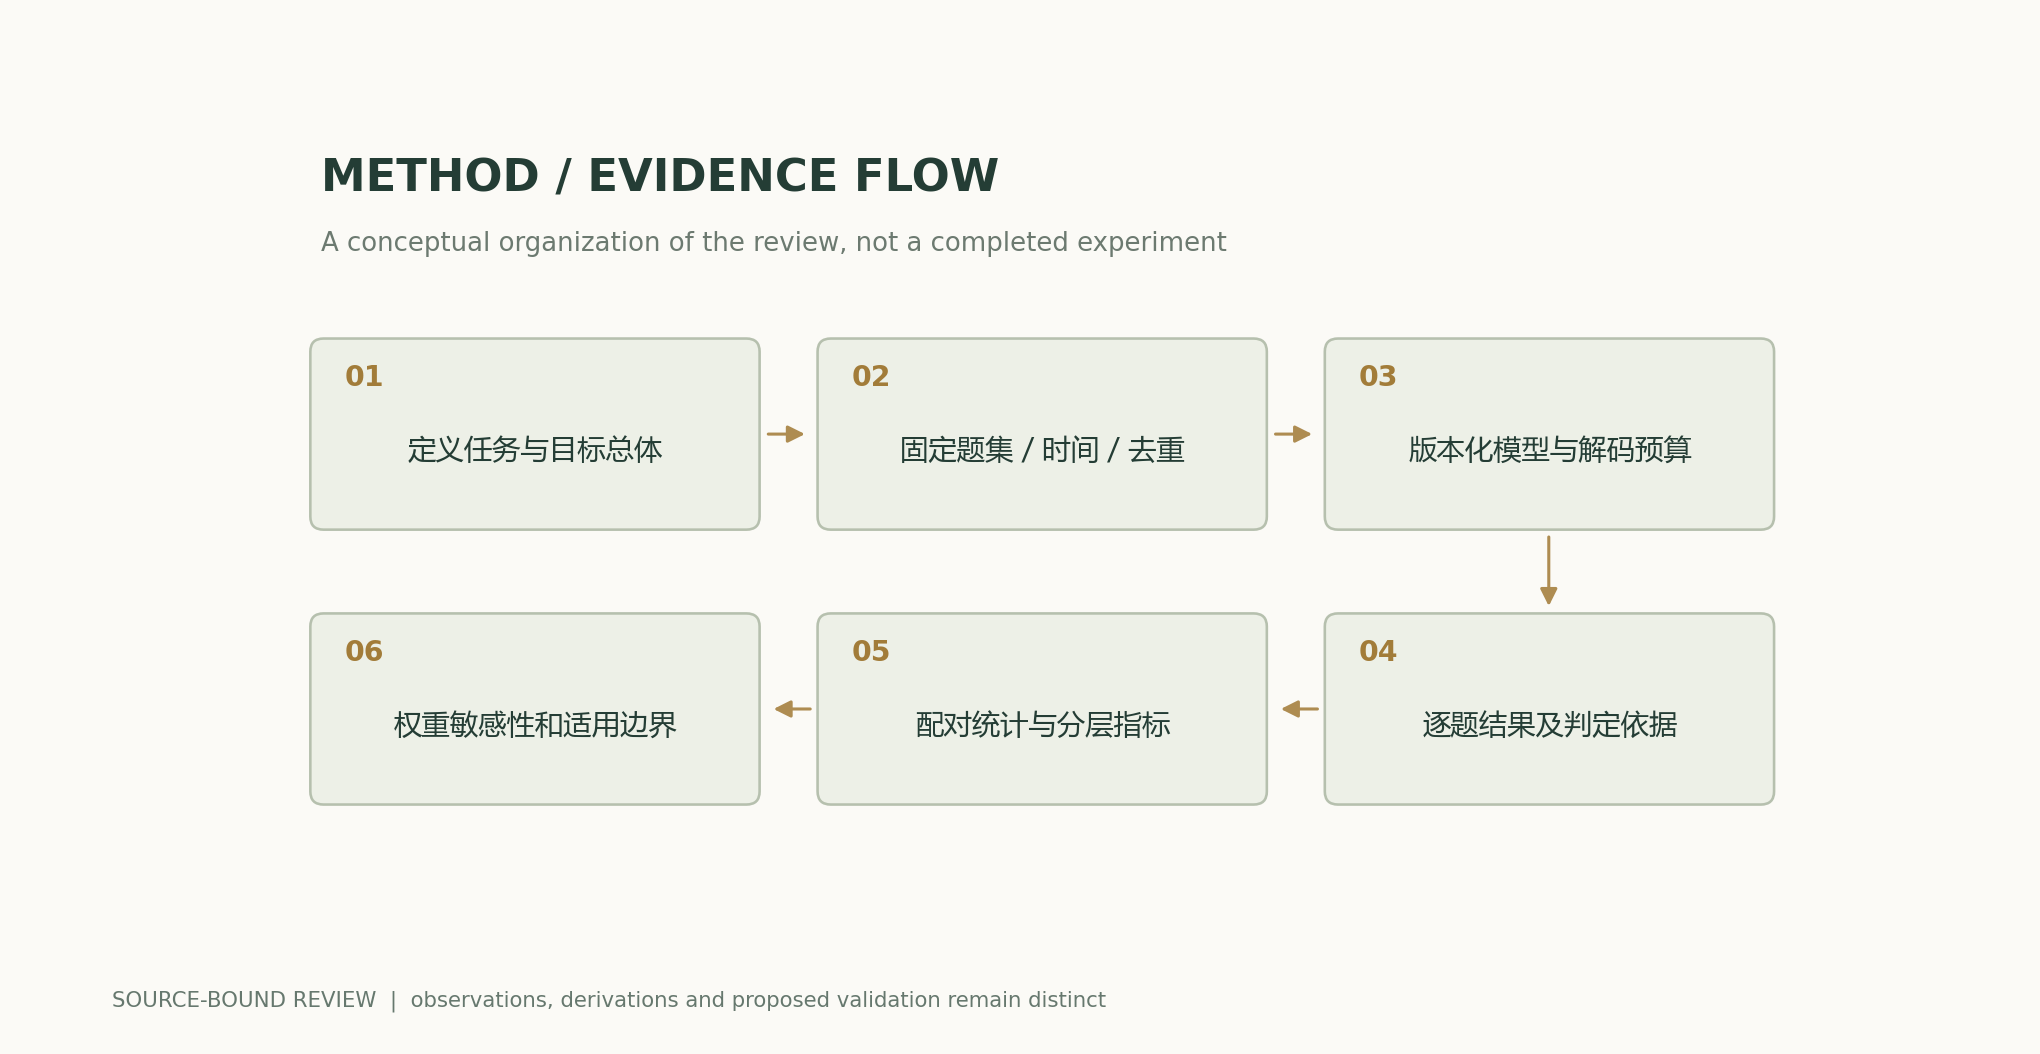
رسوم تحليلية وأمثلة عددية
مثال قابل لإعادة الحساب
عندما تكون النسبة المرصودة 0.7 في الحالتين، يكون فاصل Wilson عند n=20 نحو [0.481,0.855]، وعند n=500 نحو [0.658,0.739]. وتجعل الأسئلة المترابطة نموذج الاستقلال هذا مفرطاً في التفاؤل.
مقارنة المناهج
| المنهج أو الحكم | المتغيرات المضبوطة والقياس | شروط الإخفاق وتفسيره |
|---|---|---|
| درجة إجمالية واحدة | تثبيت أوزان المهام مع عرض الدرجات التفصيلية والمجموعة الفرعية الأسوأ | قد يخفي التجميع إخفاقات موضعية أو يغيّر الترتيب |
| دقة الإجابات عن الأسئلة | تحديد وحدة المعاينة وطريقة حساب الفاصل بوضوح | لا يمكن اعتبار الأسئلة المترابطة عينات مستقلة |
| فرق أداء النماذج على مجموعة الأسئلة نفسها | الاحتفاظ بجدول مقترن أو إعادة أخذ العينات بحسب عناقيد الوثائق | قد لا تنطبق صيغة العينتين المستقلتين |
| كشف التلوث | التقسيم الزمني وإزالة التكرار الدقيق والتقريبي والتحقق المتقاطع بأسئلة جديدة | لا يثبت غياب التداخل بين السلاسل النصية عدم التعرض لها أثناء التدريب |
خطة المراجعة والتجارب
- تثبيت إصدار النموذج وشيفرة التقييم ومجموعة المهام وقواعد التصحيح وأوزان التجميع وميزانية البحث عن التلقينات مسبقاً.
- حفظ مخرجات كل سؤال وأسس الحكم والبذور العشوائية وأنواع الإخفاق؛ ولا يجوز الاكتفاء بحفظ الدرجة الإجمالية.
- تحديد وحدات المعاينة استناداً إلى الوثائق الأصلية أو عائلات الأسئلة، وتقديم الفواصل وإجراء تحليل حساسية لافتراضات أخذ العينات المختلفة.
- الحفاظ على المطابقة بين الإجابات عن السؤال نفسه عند مقارنة النماذج، ونشر جدول تقاطعي للفروق أو إجراء قابل لإعادة التشغيل لإعادة أخذ العينات المقترنة.
- تسجيل مصادر البيانات وتواريخها وقواعد كشف التلوث، وفصل تقييم الأسئلة الأصلية عن الصيغ القريبة منها وعن الأسئلة الجديدة.
- الإبلاغ أيضاً عن زمن الاستجابة والتكلفة ونسب رفض الإجابة وتعذّر الحكم؛ وبعد تغيير أداة التصحيح، إعادة الحساب لجميع النماذج، وليس للنموذج الجديد وحده.
نطاق التطبيق والقيود
- تعتمد الفواصل الإحصائية على افتراضات أخذ العينات والارتباط.
- لا تؤدي زيادة عدد الأسئلة تلقائياً إلى إزالة اختلافات الوسم وأخطاء أداة التصحيح.
- لا تشخّص أمثلة التلوث التحليلية أي نموذج واقعي.
- لا تتضمن المراجعة لوحة ترتيب جديدة للنماذج أو شهادة اعتماد للقدرات.
المطابقة بين المصادر الأولية والادعاءات
- Measuring Massive Multitask Language UnderstandingHendrycks et al. · 2020-09-07v3 abstract; 57-task benchmark
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
- MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGIYue et al. · 2023-11-27v4 abstract; dataset scope
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ أعدّها Codex، وهو ذكاء اصطناعي، استناداً إلى المراجع الأولية المدرجة، وأجرى اشتقاقاتها التحليلية. ولا تتوفر لدى هذا الموقع سجلات لمراجعة أقران مستقلة أو لتجارب أصلية على النماذج خاصة بهذا المقال.
تنقيح أداء القارئ: تُعاد أيضاً الاستفادة من الصفحة المقروءة عندما يُرجع طلب HEAD حديث 200 وتكون قيمة ETag مطابقة. ويحتفظ متن المقال والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
يُفصل الغلاف المفاهيمي عن الرسوم العلمية؛ وتُحسب الرسوم العلمية باستخدام صيغ متاحة علناً وافتراضات معلنة، مع إسناد جميع نتائج الأوراق الأصلية إلى مصادرها.
المؤلف والإصدار وسجل التصحيحات · /guides/evaluation-beyond-leaderboards/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770