
要旨
ランキングは複雑な能力を単一の数値に圧縮するため比較しやすいが、標本選択、アノテーション、汚染、集約時の重みの影響を覆い隠しやすい。本稿は既存の多次元評価枠組みに統計的導出、対応のある比較、データガバナンスの分析を補い、高得点だけでは信頼性、転移可能性、実際のワークロードに関する問いに答えられない理由を説明する。追加した信頼区間と汚染混合の数値例はいずれも公開された数式に基づく計算であり、運用中の特定モデルを実測したものではない。順位だけを公表するのではなく、評価対象、コード、標本、失敗の分布を併せて公開することを推奨する。[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
原文の英語要旨の日本語訳
ベンチマークのスコアを、標本抽出、アノテーション、選択に伴う不確実性を持つ測定値として扱う。本稿は有限標本における正解率の区間を導出し、対応のあるモデル比較と独立したモデル比較を区別するとともに、課題の重みを変更すると総合順位が逆転しうる理由を説明する。見かけ上の改善を解釈するには、汚染管理と監査可能な評価マニフェストが必要である。数値例は説明のために構成した統計計算である。
1. MMLUは知識テストの対象範囲を拡大した
MMLUは57の学術的・専門的課題を含み、研究者が領域ごとのモデルの違いを観察できるようにする。課題横断の平均値は全体像の把握に役立つが、特定領域での失敗を隠す可能性がある。また、多肢選択問題での成績を、自由回答型の相談、長い課題の遂行、専門資格の取得と直接同一視することはできない。ベンチマークの貢献は比較可能な設問集合を提供することであり、現実世界でのあらゆる検証を代替することではない。[1] Measuring Massive Multitask Language Understanding
2. HELMは正解率が一つの次元にすぎないことを示す
HELMは正解率、較正、頑健性、公平性、バイアス、有害性、効率性を評価枠組みに組み込み、どのシナリオでどの次元を測定できるかを明示する。この設計の重要性は、対象範囲の欠落とトレードオフを公開する点にある。意味も単位も異なる指標を恣意的に足し合わせて「総合知能スコア」にしてはならず、まだ測定されていない欄を零点で埋めるべきでもない。[2] Holistic Evaluation of Language Models
3. マルチモーダルな設問は測定対象を変える
MMMUは学際的な画像・文章の設問によって知識と推論を検証し、約1.15万問、30分野を含む。その価値は設問数の増加だけではなく、グラフや構造図などの情報形式を導入する点にある。評価システムがまず別のモデルで画像を文章に変換する場合、スコアは処理パイプライン全体を測定する。画像を直接入力する場合は、画像の解像度、切り抜き、入力方法を記録する必要がある。[3] MMMU: A Massive Multi-discipline Multimodal Understandi
4. 標本サイズが結論の精度を規定する
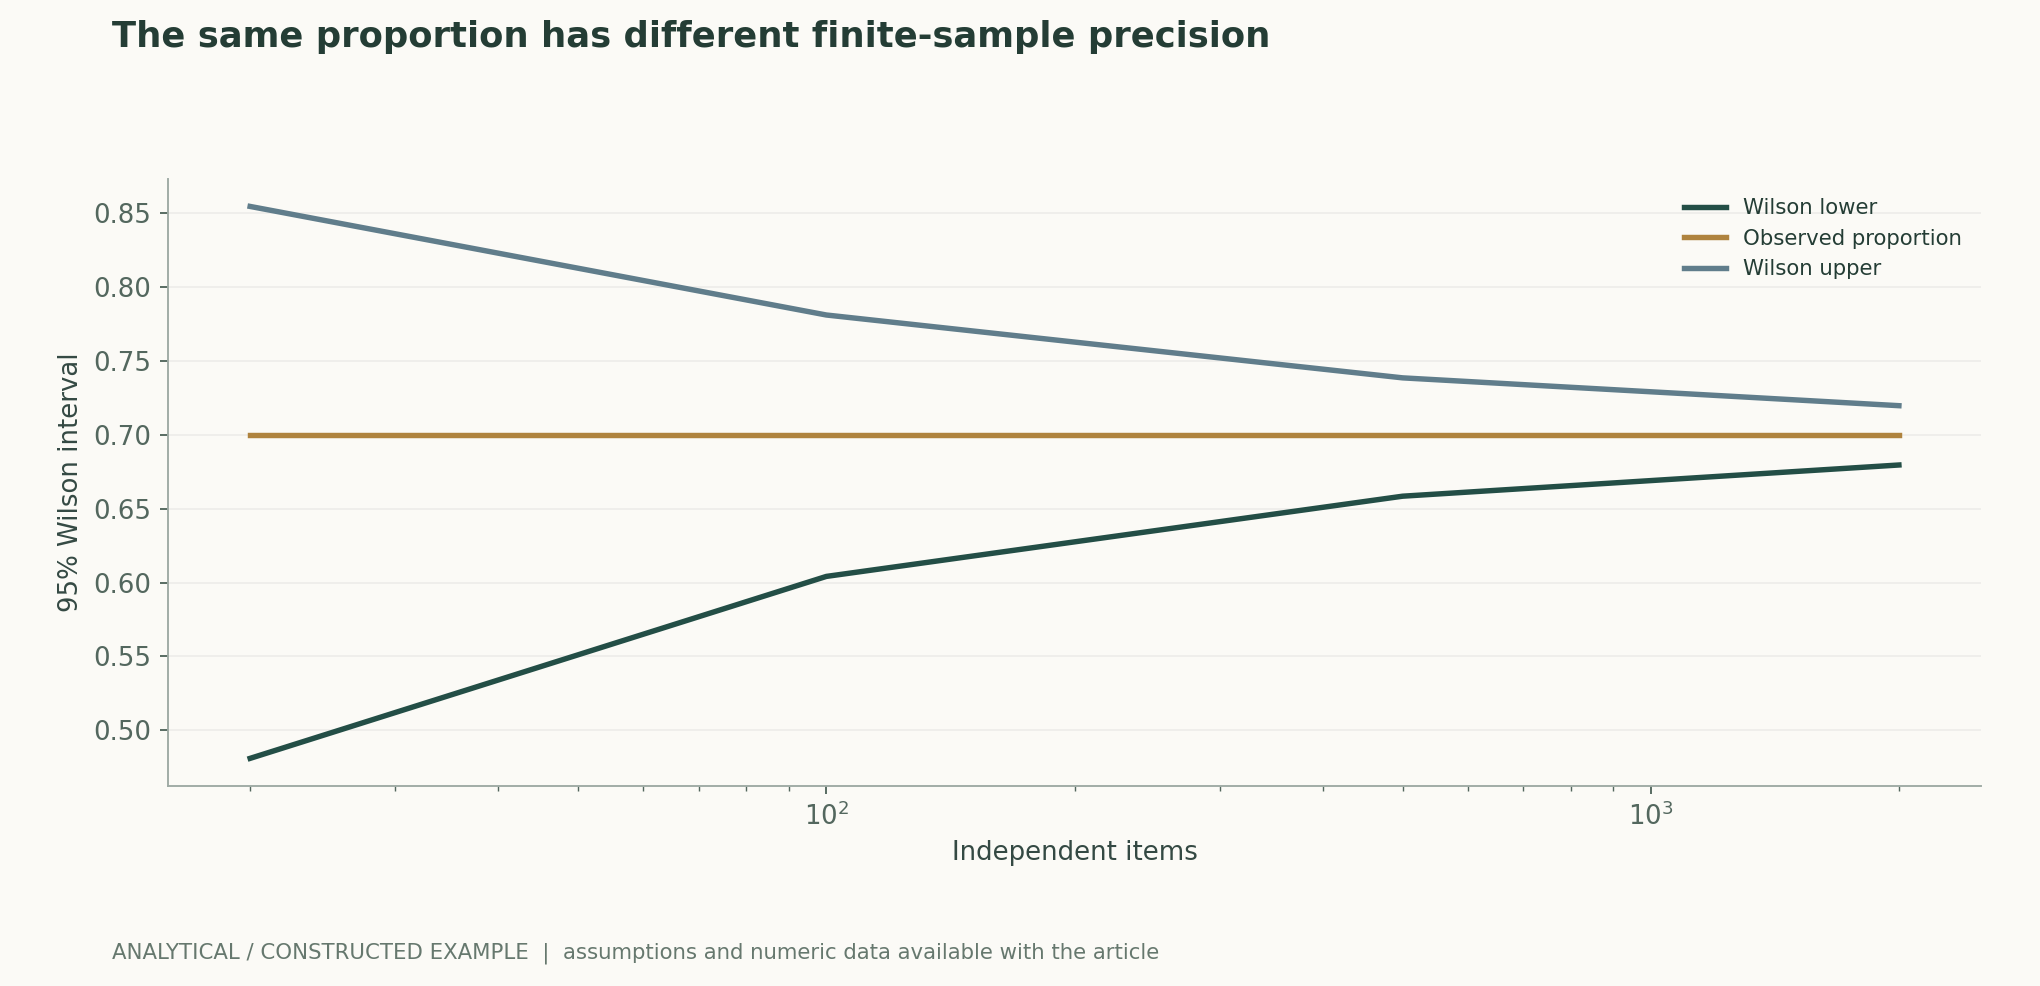
本版の図2は観測比率を70%に固定し、n=20、100、500、2000を用いて95% Wilson区間を計算することで、標本サイズと区間幅の関係を説明する。いずれのモデルに由来する値でもない。区間は独立した二項観測を前提とする。同一文書に含まれる複数の設問、同じ利用者の反復、共通テンプレートは、有効標本サイズを小さくする可能性がある。実際の相関構造に応じて再標本化や層別推定を選ぶべきであり、設問数をそのまま独立したエビデンスの数とみなしてはならない。作者分析与复核建议 / Author analysis
5. テスト汚染には追跡可能な時系列が必要である
評価用の設問や解答が訓練資料に含まれると、ベンチマークは記憶と汎化を同時に測定する可能性がある。本稿では、訓練に利用可能なデータの時間的境界、評価集合の公開履歴、重複除去方法、近似重複の可能性を記録することを推奨する。テスト集合が既知の一覧に見当たらないというだけで完全に汚染がないと主張してはならず、証拠なしに特定モデルのデータ漏洩を非難してもならない。作者分析与复核建议 / Author analysis
6. 対応のある比較は二本の棒グラフより多くの情報をもたらす
同じ設問群で二つのモデルを比較する際は、設問ごとの正誤と課題カテゴリを保持し、どの設問で結果が異なるかに注目すべきである。二つの正解率と各々の区間を個別に示すだけでは、差の不確実性を十分に判断できない。設問のカテゴリに階層構造がある場合は、それに応じた層別手法や対応のある手法を使用できる。最も有利な設定を繰り返し選んだ場合は、その選択過程を開示すべきである。本稿では実在するモデルの統計的有意性を計算していない。作者分析与复核建议 / Author analysis
7. 再現のための記録に含めるべき事項
少なくとも、設問の版、プロンプトテンプレート、few-shotの例、デコードパラメータ、ツール権限、モデル識別子、実行日時、失敗と再試行の規則、採点器の版を保存すべきである。オープンウェイトのモデルとオンラインサービスでは再現可能性の条件が異なり、サービスは同じ製品名のまま更新されることがある。記録プロトコルは、後から変化の原因がモデル、システム構成要素、採点条件のいずれにあるかを判断する助けとなる。作者分析与复核建议 / Author analysis
平均には明確な重み付けが必要である
各設問を等しい重みで平均する方法と、まず各分野のスコアを求めてから分野を等しい重みで平均する方法では、異なる結果になることがある。前者は設問数の多い分野に大きな重みを与え、後者は領域間の均衡を重視する。どちらの方法も定義を公開しなければならない。対象利用者がそのうち少数の課題しか扱わない場合は、実際の課題分布に対応する結果も報告すべきである。本稿はあらゆる用途に適する重みを指定せず、欠落している分野が網羅されているとも推論しない。作者分析与复核建议 / Author analysis
8. 正解率の点推定には誤差範囲が必要である
独立したn個の標本が同じ成功確率に従う場合、標本正解率の標準誤差はおよそsqrt[p(1−p)/n]となる。ただし、標本が小さい場合や0または1に近い場合、単純な正規近似区間は不安定になりうるため、有限標本の不確実性を示すには通常Wilson区間の方が適している。それでも標本抽出モデルへの依存は残る。同一文書の設問や同一問題の変種がクラスターを形成する場合、各変種を独立標本とみなすことはできない。抽出単位に従って再標本化し、区間が設問の抽出、モデルのランダム性、アノテーション誤差のいずれを反映するかを明示すべきである。[2] Holistic Evaluation of Language Models[1] Measuring Massive Multitask Language Understanding
9. 同じ設問集合におけるモデル比較は対応のある問題である
二つのモデルが同じ設問群に回答する場合、差を比較する際には設問ごとの対応関係を保持すべきである。独立した二標本の誤差式はこの相関構造を無視するため、不確実性を過大評価することも過小評価することもある。「Aのみ正解、Bのみ正解、両方正解、両方不正解」のクロス集計表を報告するか、設問または文書クラスターに対して対応のあるブートストラップを実施できる。複数のプロンプトを繰り返し試した後で最良のものだけを報告することも選択バイアスを生むため、プロンプト探索の予算を実験の説明に含めなければならない。[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
10. 総合スコアは課題の重みに支配されうる
各領域のスコアをs_j、総合スコアを領域の重みw_jによる加重平均とする。ある重みの組でモデルの順位が高くても、利用者のニーズの分布が異なれば同じく高い順位になるとは限らない。マルチモーダル評価では、画像理解、文字の読み取り、知識、推論の誤りを区別し、すべての失敗を視覚能力の不足と呼ばないことも必要である。事前登録した総合スコアに加え、領域別成績、重み、欠測項目、最も成績の低いサブグループの成績を公開し、利用者が実際の課題に応じて再集約できるようにすべきである。[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
11. 汚染と重複除去を評価チェックリストに含めるべきである
評価標本やその近似変種が訓練、検索、プロンプト例に含まれると、スコアに記憶と汎化が混在する可能性がある。文字列の完全一致だけを調べても意味的な言い換えは検出できないが、類似性によるフィルタリングの範囲を広げすぎると、本当に必要な領域知識まで除去する可能性がある。データの時期と出所、完全一致および近似一致による重複除去規則を記録し、新たに構成して人手で確認した設問集合による交差検証を行うことを推奨する。汚染の混合モデルを構成すればスコア上昇の理由を説明できるが、この図から現実の特定モデルの汚染割合を逆算することはできない。[4] Deduplicating Training Data Makes Language Models Bette[5] Documenting Large Webtext Corpora: A Case Study on the
主要な数式と導出
(1) cは成功数である。独立同分布の仮定はすべての設問集合に適用できるわけではなく、図中のp=0.7は解析上の設定にすぎない。
LaTeX
\widehat p=\frac{c}{n},\qquad \mathrm{SE}(\widehat p)\approx\sqrt{\widehat p(1-\widehat p)/n}(2) zを標準正規分布の分位点とすると、対応する近似信頼区間が得られる。抽出単位を明示し、区間を将来のすべての課題における性能の保証とみなしてはならない。
LaTeX
\mathrm{CI}_{\rm Wilson}=\frac{\widehat p+\frac{z^2}{2n}\ \pm\ z\sqrt{\frac{\widehat p(1-\widehat p)}{n}+\frac{z^2}{4n^2}}}{1+\frac{z^2}{n}}(3) 課題の重みは評価設計の一部である。欠落した課題の扱いと重みの再正規化の有無は、比較前に固定し開示すべきである。
LaTeX
S=\sum_jw_js_j,\quad \sum_jw_j=1,\quad w_j\ge0方法とエビデンスの流れ
解析図と数値例
再計算可能な例題
観測比率がいずれも0.7の場合、n=20のWilson区間は約[0.481,0.855]、n=500では約[0.658,0.739]となる。設問間に相関があると、この独立性モデルは過度に楽観的になる。
方法の比較
| 方法または判断 | 統制変数と測定 | 成立しなくなる条件と解釈 |
|---|---|---|
| 単一の総合スコア | 課題の重みを固定し、内訳と最も成績の低いサブグループも示す | 集約は局所的な失敗を隠したり順位を変えたりする可能性がある |
| 設問の正解率 | 抽出単位と区間の計算方法を明示する | 相関のある設問を独立標本として扱うことはできない |
| 同一設問集合上でのモデル間の差 | 対応表を保持するか、文書クラスター単位で再標本化する | 独立した二標本の式は適用できない場合がある |
| 汚染の検出 | 時間による分割、完全一致・近似一致による重複除去、新規設問による交差検証 | 文字列の重複がないことは訓練中の接触がないことを証明しない |
検証と実験の計画
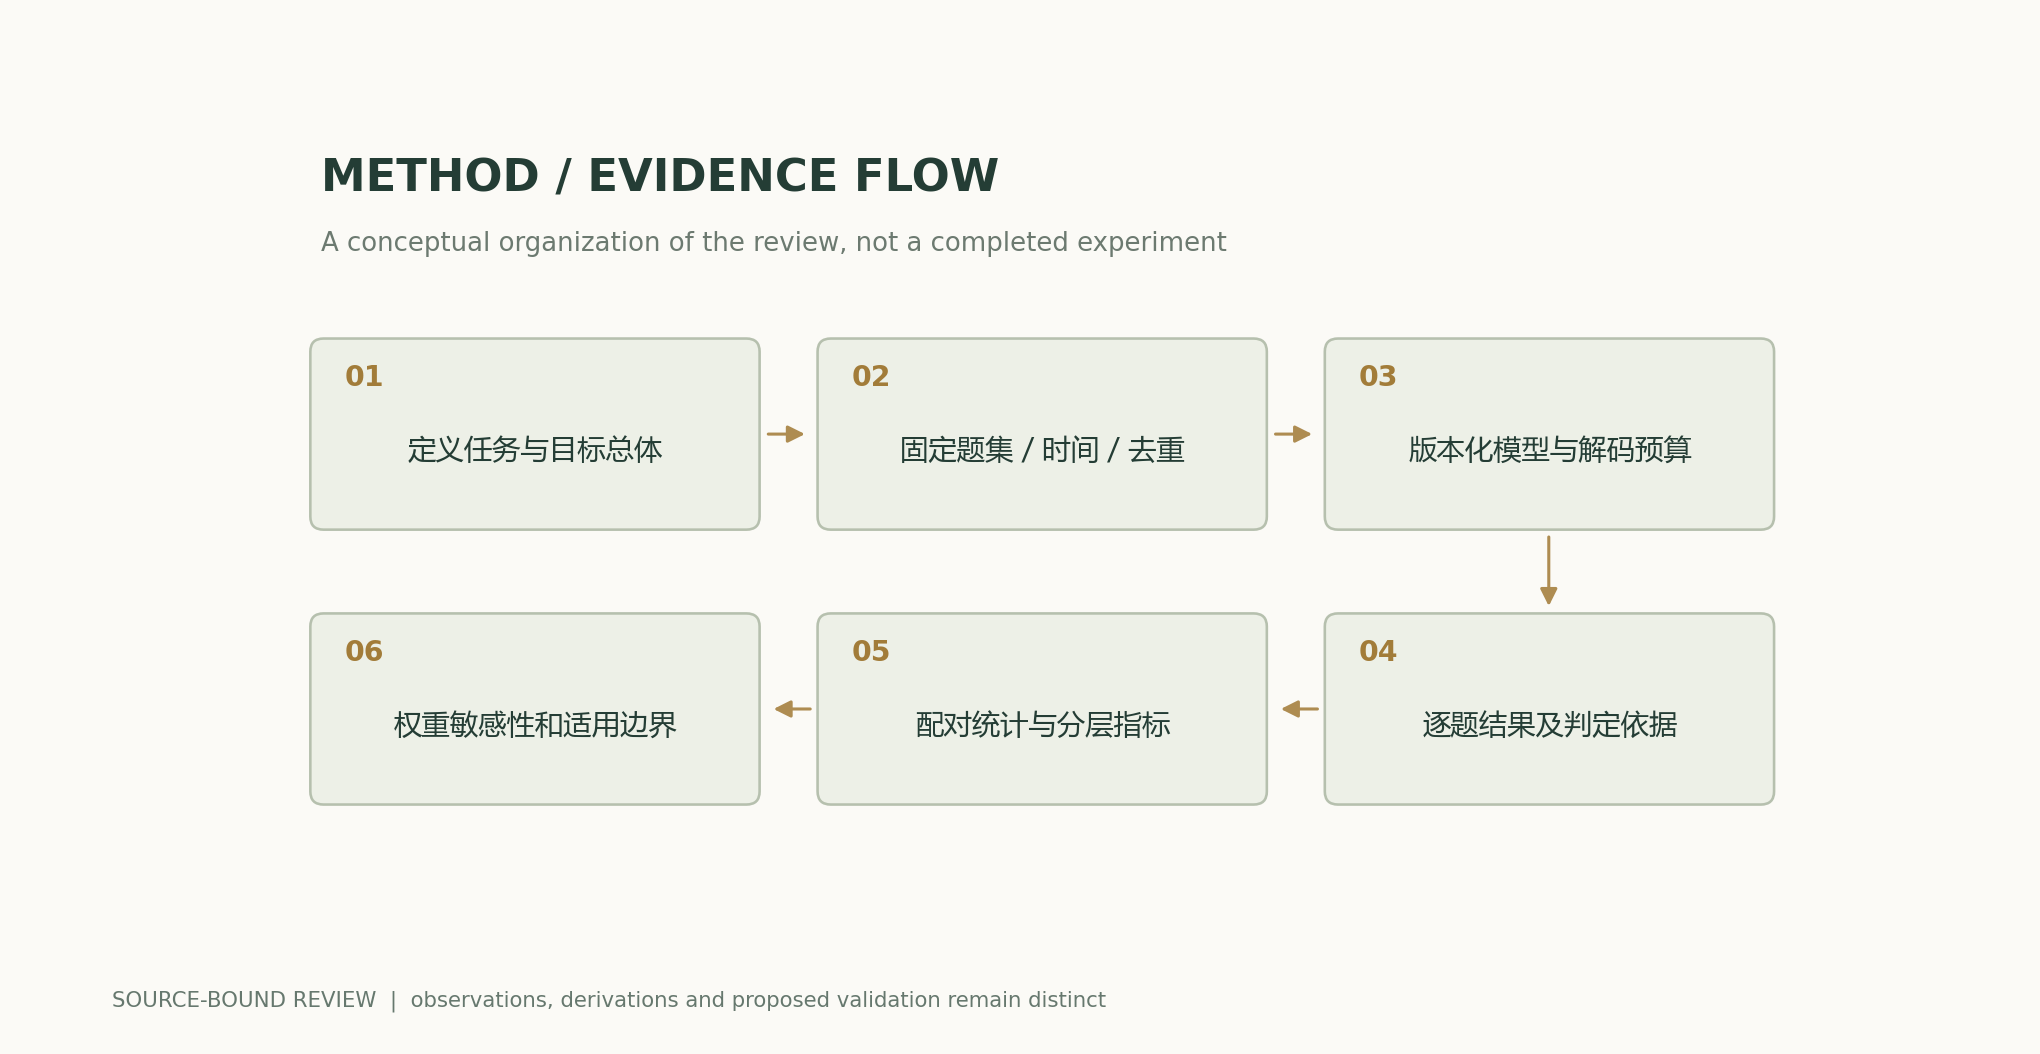
- モデルの版、評価コード、課題集合、採点規則、集約時の重み、プロンプト探索の予算をあらかじめ固定する。
- 各設問の出力、判定根拠、乱数シード、失敗の種類を保存する。総合スコアだけを保存してはならない。
- 元の文書または同系統の設問群に基づいて抽出単位を設定し、区間を示すとともに、異なる抽出仮定に対する感度分析を行う。
- モデル比較では同一設問の対応を保持し、差のクロス集計表または再実行可能な対応のある再標本化手順を公開する。
- データの出所、時期、汚染検出規則を記録し、元の設問、近似変種、新規設問の評価を分ける。
- 遅延、コスト、回答拒否率、判定不能率も報告する。採点器を変更した後は、新しいモデルだけでなく、すべてのモデルについて再計算する。
適用範囲と限界
- 統計的区間は標本抽出と相関の仮定に依存する。
- アノテーションの不一致や採点器の誤りは、設問数によって自動的に解消されるものではない。
- 解析的な汚染例は現実のいかなるモデルも診断しない。
- 新たなモデルランキングや能力認証は提示していない。
一次資料と主張の対応
- Measuring Massive Multitask Language UnderstandingHendrycks et al. · 2020-09-07v3 abstract; 57-task benchmark
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
- MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGIYue et al. · 2023-11-27v4 abstract; dataset scope
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、記載された一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿について独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEAD応答が200を返し、ETagが同じ場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学図解は区別している。科学図は公開された数式と明示された仮定に基づいて計算し、原論文の結果はいずれも帰属を明記している。
著者、版、訂正履歴 · /guides/evaluation-beyond-leaderboards/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開・版の履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770