
Resumen
Las clasificaciones condensan capacidades complejas en un único número, lo que facilita la comparación, pero también puede ocultar los efectos de la selección de muestras, la anotación, la contaminación y las ponderaciones de agregación. Esta revisión complementa los marcos existentes de evaluación multidimensional con derivaciones estadísticas, comparaciones pareadas y un análisis de la gobernanza de datos, para explicar por qué una puntuación alta no basta por sí sola para responder a cuestiones de fiabilidad, transferibilidad o cargas de trabajo reales. Los ejemplos añadidos de intervalos de confianza y mezclas de contaminación son cálculos basados en fórmulas públicas, no mediciones empíricas de ningún modelo en uso. Se recomienda publicar conjuntamente el objeto de evaluación, el código, las muestras y la distribución de los fallos, en lugar de publicar únicamente la clasificación.[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
Traducción del resumen original en inglés
Las puntuaciones de las pruebas de referencia se tratan como mediciones sujetas a incertidumbre de muestreo, anotación y selección. La revisión deriva intervalos de exactitud para muestras finitas, distingue las comparaciones de modelos pareadas de las independientes y explica por qué las clasificaciones agregadas pueden invertirse al modificar las ponderaciones de las tareas. El control de la contaminación y un manifiesto de evaluación auditable son necesarios para interpretar una mejora aparente; los ejemplos numéricos son cálculos estadísticos construidos.
1. MMLU amplía la cobertura de las pruebas de conocimientos
MMLU incluye 57 tareas académicas y profesionales, lo que permite a los investigadores observar diferencias de rendimiento entre ámbitos. Una media entre tareas puede ayudar a sintetizar los resultados, pero también ocultar fallos en un ámbito concreto. El rendimiento en preguntas de opción múltiple tampoco puede equipararse directamente a la consulta abierta, la ejecución de tareas largas o la obtención de cualificaciones profesionales. La contribución de la prueba de referencia consiste en proporcionar un conjunto comparable de preguntas, no en sustituir toda validación en situaciones reales.[1] Measuring Massive Multitask Language Understanding
2. HELM muestra que la exactitud es solo una dimensión
HELM incorpora la exactitud, la calibración, la robustez, la equidad, el sesgo, la toxicidad y la eficiencia a su marco de evaluación, y especifica qué dimensiones pueden medirse en cada escenario. La importancia de este diseño reside en hacer públicas las lagunas de cobertura y las compensaciones entre objetivos. No se deben sumar arbitrariamente indicadores con significados y unidades diferentes para obtener una «puntuación integral de inteligencia», ni asignar una puntuación de cero a las celdas que aún no se han medido.[2] Holistic Evaluation of Language Models
3. Las preguntas multimodales cambian el objeto de medición
MMMU evalúa conocimientos y razonamiento mediante preguntas interdisciplinarias con imágenes y texto; incluye aproximadamente 1.15 por diez mil preguntas de 30 disciplinas. Su valor no se limita a aumentar la cantidad de preguntas, sino que incorpora formatos de información como gráficos y diagramas estructurales. Si el sistema de evaluación convierte primero las imágenes en texto mediante otro modelo, la puntuación mide toda la cadena de procesamiento; si se introducen las imágenes directamente, deben registrarse su resolución, el recorte y la modalidad de entrada.[3] MMMU: A Massive Multi-discipline Multimodal Understandi
4. El tamaño muestral determina la precisión posible de las conclusiones
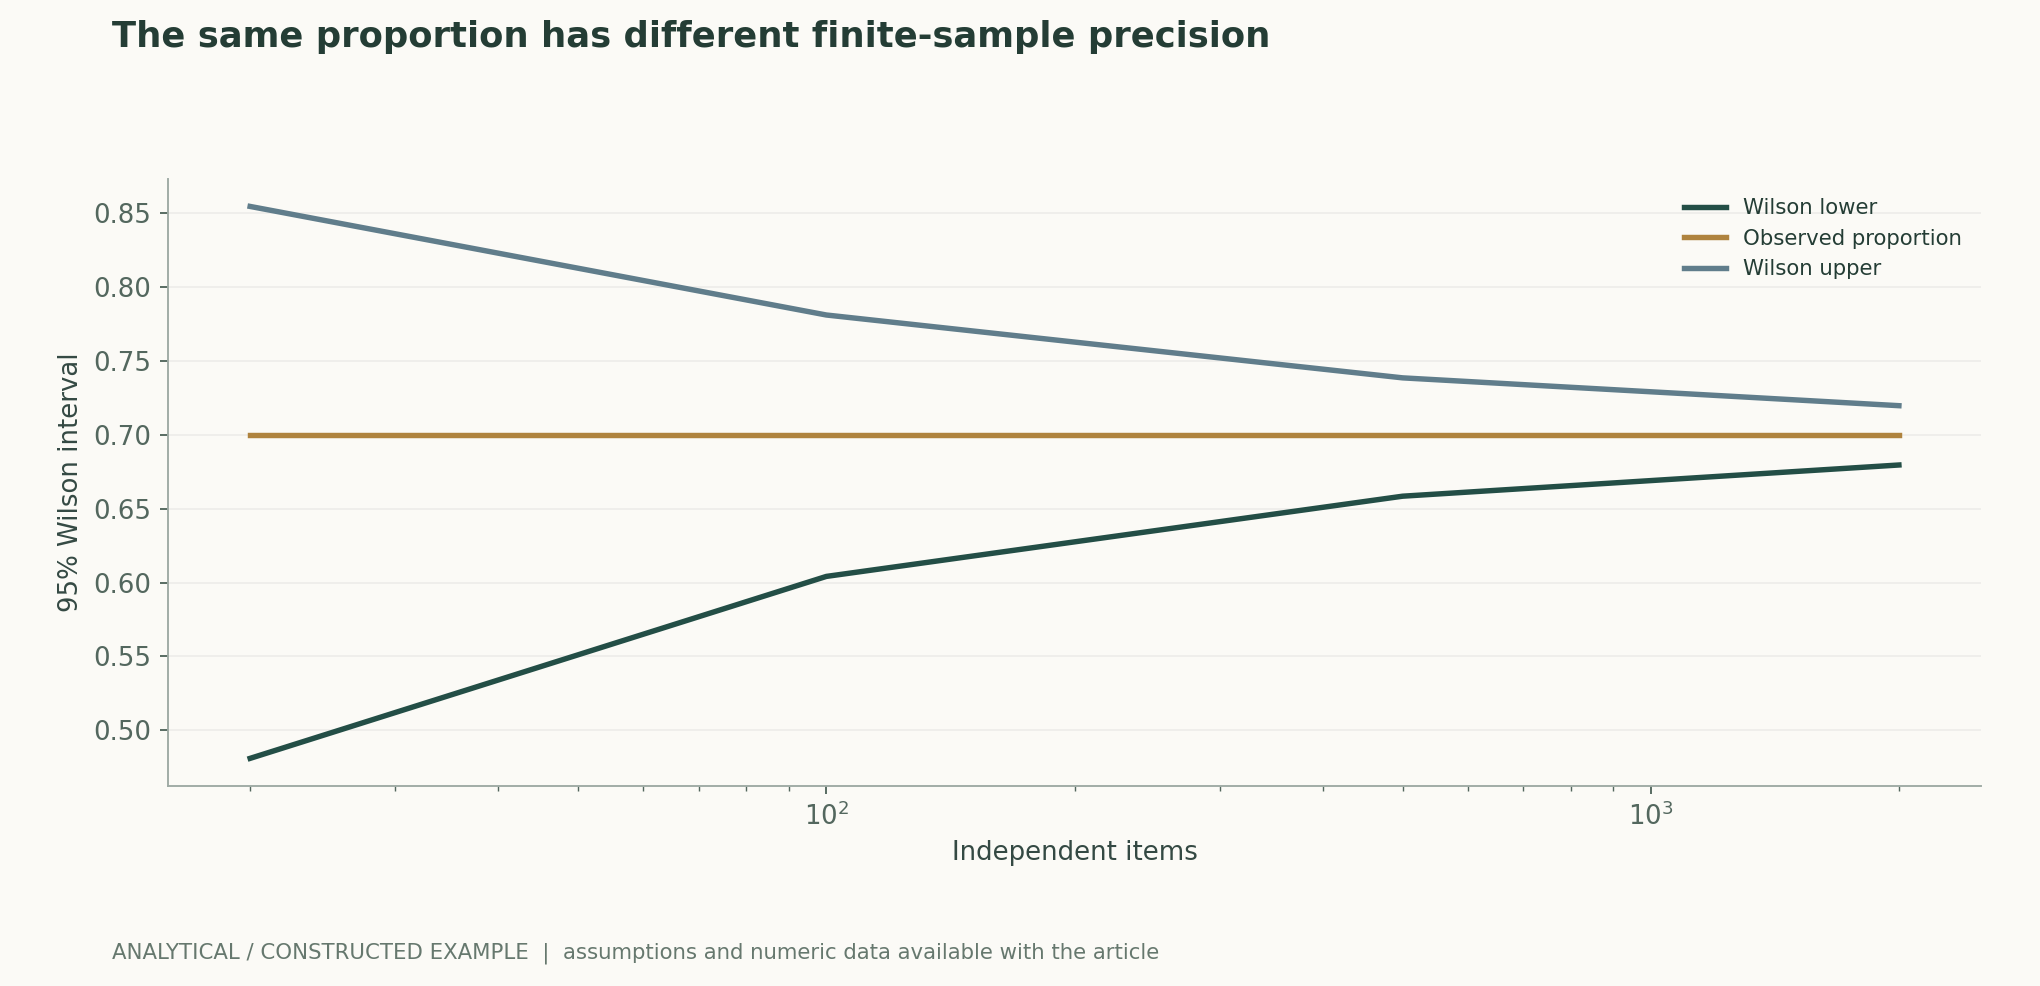
La figura 2 de esta edición fija la proporción observada en 70%, utiliza n=20, 100, 500 y 2000, y calcula intervalos de Wilson del 95% para explicar la relación entre el tamaño muestral y la amplitud del intervalo; los valores no proceden de ningún modelo. Los intervalos dependen de observaciones binomiales independientes; varias preguntas de un mismo documento, usuarios repetidos o plantillas compartidas pueden reducir el tamaño muestral efectivo. Debe elegirse el remuestreo o la estimación estratificada según la estructura real de correlación, sin considerar simplemente el número de preguntas como el número de elementos de evidencia independientes.作者分析与复核建议 / Author analysis
5. La contaminación de las pruebas requiere una cronología trazable
Si las preguntas o respuestas de evaluación pasan a formar parte del material de entrenamiento, la prueba de referencia puede medir simultáneamente memorización y generalización. Esta revisión recomienda registrar el límite temporal de los datos disponibles para el entrenamiento, el historial de publicación del conjunto de evaluación, los métodos de deduplicación y los posibles duplicados aproximados. Que un conjunto de prueba no aparezca en un inventario conocido no permite afirmar que esté completamente libre de contaminación; tampoco debe acusarse a un modelo concreto de filtración de datos sin pruebas.作者分析与复核建议 / Author analysis
6. Las comparaciones pareadas aportan más información que dos barras
Al comparar dos modelos sobre el mismo conjunto de preguntas, deben conservarse los aciertos y errores de cada pregunta y su categoría de tarea, prestando atención a las preguntas en las que difieren. Presentar por separado dos valores de exactitud y sus respectivos intervalos no basta para evaluar plenamente la incertidumbre de la diferencia. Si las preguntas tienen una estructura jerárquica de categorías, pueden utilizarse los métodos estratificados o pareados correspondientes; si se seleccionan repetidamente las configuraciones más favorables, debe revelarse el proceso de selección. Esta revisión no calcula la significación estadística de ningún modelo real.作者分析与复核建议 / Author analysis
7. Qué deben incluir los registros de reproducibilidad
Como mínimo, deben conservarse la versión de las preguntas, las plantillas de instrucciones, los ejemplos few-shot, los parámetros de decodificación, los permisos de las herramientas, el identificador del modelo, el momento de ejecución, las reglas de fallo y reintento y la versión del evaluador. Las condiciones de reproducibilidad difieren entre los modelos de pesos abiertos y los servicios en línea; un servicio puede actualizarse bajo el mismo nombre de producto. Un protocolo de registro puede ayudar a determinar posteriormente si los cambios proceden del modelo, de los componentes del sistema o de las condiciones de puntuación.作者分析与复核建议 / Author analysis
Una media necesita ponderaciones explícitas
Promediar todas las preguntas con el mismo peso puede producir un resultado distinto de calcular primero la puntuación de cada disciplina y después promediar las disciplinas con igual peso. El primer procedimiento otorga más peso a las disciplinas con más preguntas; el segundo enfatiza el equilibrio entre ámbitos. Ambos deben definirse públicamente. Si los usuarios destinatarios solo realizan unas pocas de esas tareas, también deben comunicarse resultados que correspondan a su distribución real de tareas. Esta revisión no prescribe ponderaciones adecuadas para todos los usos ni supone que las disciplinas ausentes estén cubiertas.作者分析与复核建议 / Author analysis
8. La estimación puntual de la exactitud necesita un margen de error
Si n muestras independientes tienen la misma probabilidad de éxito, el error estándar de la exactitud muestral es aproximadamente sqrt[p(1−p)/n]. Sin embargo, con muestras pequeñas o valores próximos a 0 o 1, un intervalo normal simple puede ser inestable, y el intervalo de Wilson suele ser más adecuado para mostrar la incertidumbre de muestras finitas. Sigue dependiendo del modelo de muestreo: cuando las preguntas de un mismo documento o las variantes de una misma pregunta forman conglomerados, no puede tratarse cada variante como una muestra independiente. El remuestreo debe realizarse según la unidad de muestreo, y debe indicarse si el intervalo refleja el muestreo de preguntas, la aleatoriedad del modelo o el error de anotación.[2] Holistic Evaluation of Language Models[1] Measuring Massive Multitask Language Understanding
9. Comparar modelos sobre el mismo conjunto de preguntas es un problema de datos pareados
Si dos modelos responden al mismo conjunto de preguntas, debe conservarse la correspondencia por pregunta al comparar la diferencia. Las fórmulas de error para dos muestras independientes ignoran esta estructura de correlación y pueden sobrestimar o subestimar la incertidumbre. Puede presentarse una tabla de contingencia con «solo A acierta, solo B acierta, ambos aciertan, ambos fallan», o realizarse un bootstrap pareado sobre preguntas o conglomerados de documentos. Probar reiteradamente varias instrucciones y comunicar únicamente la mejor también introduce sesgo de selección; el presupuesto de búsqueda de instrucciones debe incluirse en la descripción experimental.[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
10. Las ponderaciones de las tareas pueden dominar la puntuación global
Sea s_j la puntuación de cada ámbito y sea la puntuación global la media ponderada con los pesos de ámbito w_j. Que un modelo ocupe una posición superior con un conjunto de ponderaciones no garantiza que la mantenga bajo otra distribución de necesidades de los usuarios. La evaluación multimodal también debe distinguir entre errores de comprensión de imágenes, lectura de texto, conocimiento y razonamiento, para evitar atribuir todos los fallos a una capacidad visual insuficiente. Además de la puntuación global prerregistrada, deben publicarse las puntuaciones por ámbito, los pesos, los elementos ausentes y el rendimiento del peor subgrupo, para que los usuarios puedan reagrupar los resultados según sus tareas reales.[1] Measuring Massive Multitask Language Understanding[2] Holistic Evaluation of Language Models[3] MMMU: A Massive Multi-discipline Multimodal Understandi
11. La contaminación y la deduplicación deben incluirse en la lista de comprobación de la evaluación
Si las muestras de evaluación o variantes próximas se incorporan al entrenamiento, a la recuperación de información o a los ejemplos de las instrucciones, las puntuaciones pueden mezclar memorización y generalización. Comprobar únicamente cadenas exactas no detecta las paráfrasis semánticas, pero un filtrado por similitud demasiado amplio también puede eliminar conocimientos del ámbito realmente necesarios. Se recomienda registrar las fechas y fuentes de los datos y las reglas de deduplicación exacta y aproximada, y realizar una validación cruzada con conjuntos de preguntas de nueva creación revisados por personas. Construir un modelo de mezcla de contaminación puede explicar por qué aumenta la puntuación, pero esta figura no permite inferir la proporción de contaminación de ningún modelo real concreto.[4] Deduplicating Training Data Makes Language Models Bette[5] Documenting Large Webtext Corpora: A Case Study on the
Fórmulas fundamentales y derivaciones
(1) c es el número de éxitos. El supuesto de observaciones independientes e idénticamente distribuidas no se aplica a todos los conjuntos de preguntas; p=0.7 en la figura es solo una configuración analítica.
LaTeX
\widehat p=\frac{c}{n},\qquad \mathrm{SE}(\widehat p)\approx\sqrt{\widehat p(1-\widehat p)/n}(2) Al tomar z como un cuantil de la distribución normal estándar se obtiene el intervalo de confianza aproximado correspondiente. Debe indicarse la unidad de muestreo y no tratarse el intervalo como una garantía del rendimiento en todas las tareas futuras.
LaTeX
\mathrm{CI}_{\rm Wilson}=\frac{\widehat p+\frac{z^2}{2n}\ \pm\ z\sqrt{\frac{\widehat p(1-\widehat p)}{n}+\frac{z^2}{4n^2}}}{1+\frac{z^2}{n}}(3) Las ponderaciones de las tareas forman parte del diseño de evaluación. El tratamiento de las tareas ausentes y la decisión de renormalizar o no los pesos deben fijarse y divulgarse antes de la comparación.
LaTeX
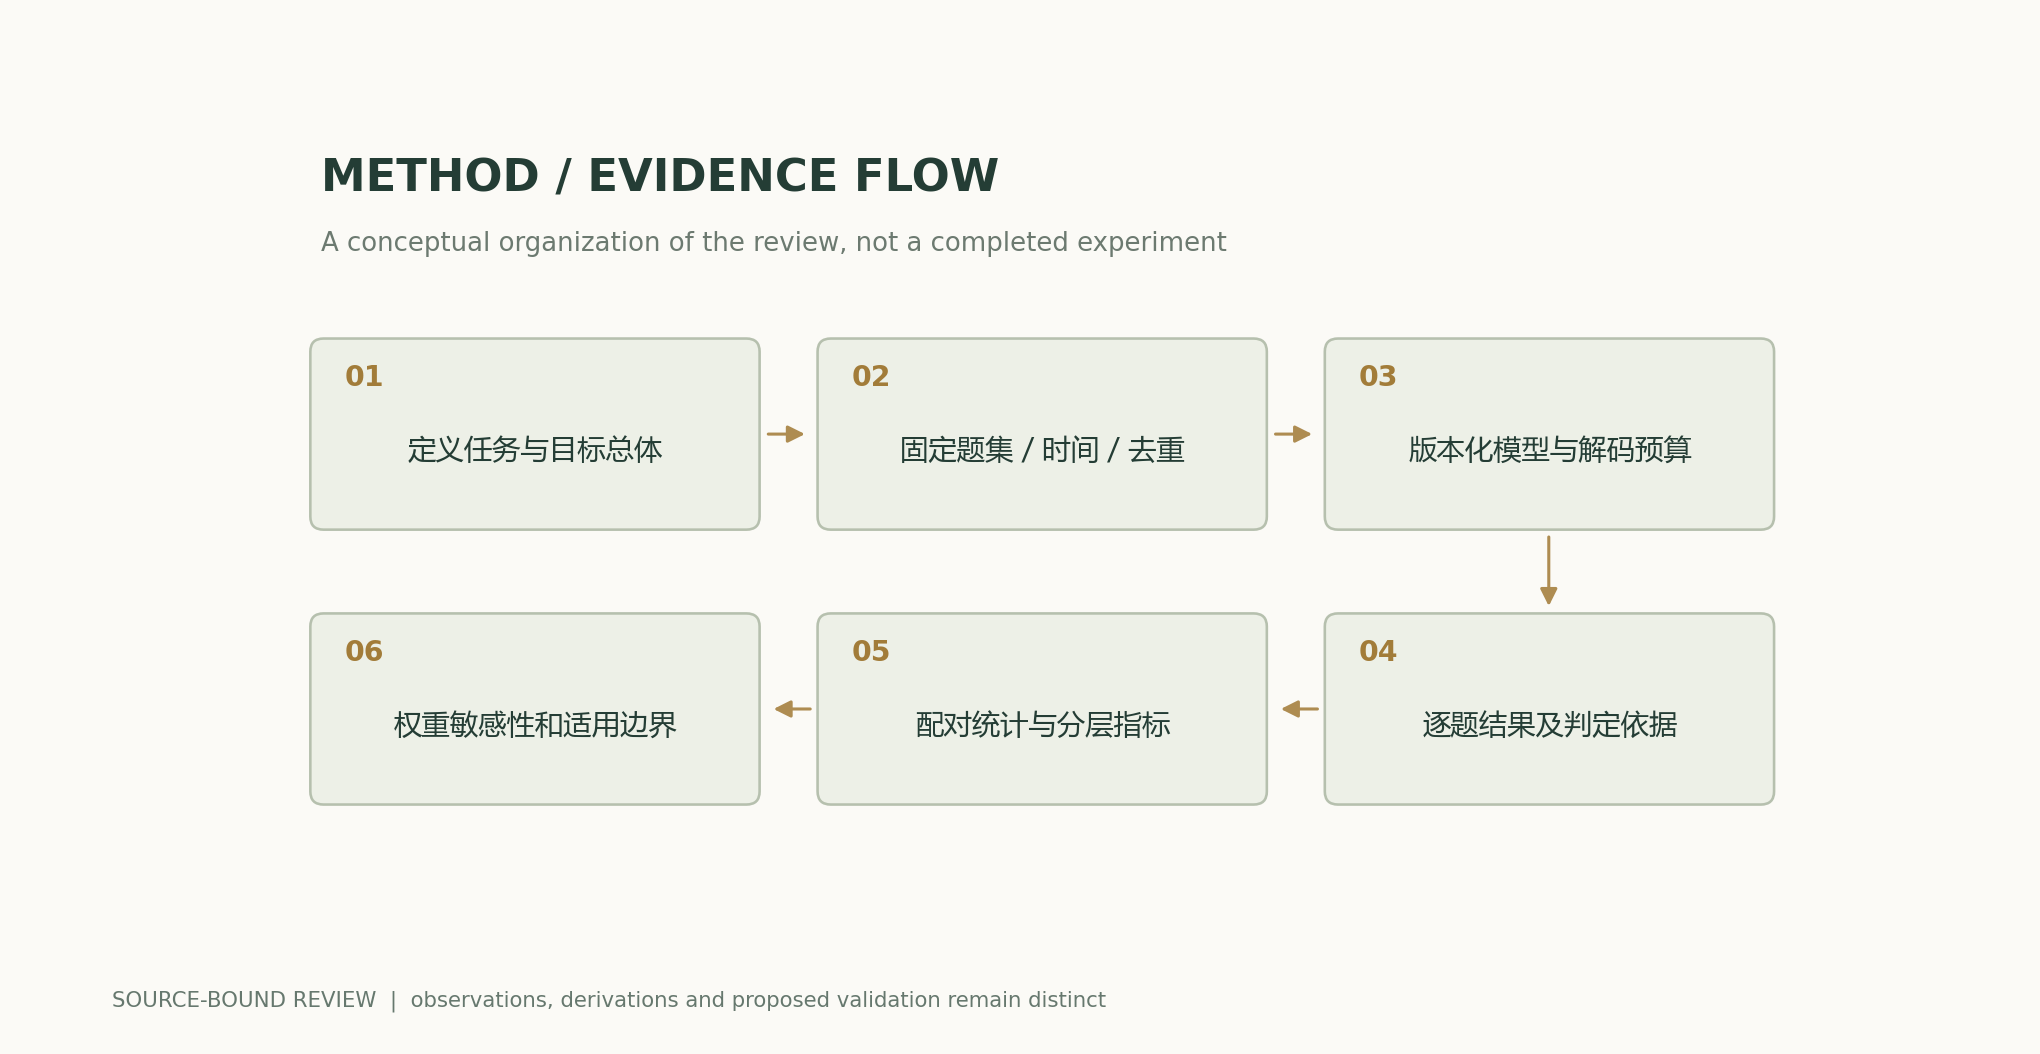
S=\sum_jw_js_j,\quad \sum_jw_j=1,\quad w_j\ge0Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Cuando la proporción observada es 0.7 en ambos casos, el intervalo de Wilson para n=20 es aproximadamente [0.481,0.855], y para n=500, aproximadamente [0.658,0.739]. Las preguntas correlacionadas hacen que este modelo de independencia sea demasiado optimista.
Comparación de métodos
| Método o valoración | Variables controladas y medición | Condiciones de fallo e interpretación |
|---|---|---|
| Puntuación global única | Fijar los pesos de las tareas y presentar también los resultados desglosados y el peor subgrupo | La agregación puede ocultar fallos locales o cambiar la clasificación |
| Exactitud en las preguntas | Especificar la unidad de muestreo y el método de cálculo del intervalo | Las preguntas correlacionadas no pueden actuar como muestras independientes |
| Diferencia entre modelos sobre el mismo conjunto de preguntas | Conservar una tabla pareada o remuestrear por conglomerados de documentos | La fórmula para dos muestras independientes puede no ser aplicable |
| Detección de contaminación | División temporal, deduplicación exacta/aproximada y validación cruzada con preguntas nuevas | La ausencia de solapamiento entre cadenas no demuestra la ausencia de exposición durante el entrenamiento |
Plan de verificación y experimentación
- Fijar de antemano la versión del modelo, el código de evaluación, el conjunto de tareas, las reglas de puntuación, las ponderaciones de agregación y el presupuesto de búsqueda de instrucciones.
- Guardar la salida de cada pregunta, los fundamentos de la valoración, la semilla aleatoria y el tipo de fallo; no basta con guardar la puntuación global.
- Establecer las unidades de muestreo por documento original o familia de preguntas, presentar intervalos y realizar análisis de sensibilidad bajo distintos supuestos de muestreo.
- Conservar la correspondencia por pregunta al comparar modelos y publicar una tabla de contingencia de las diferencias o un procedimiento de remuestreo pareado que pueda volver a ejecutarse.
- Registrar las fuentes y fechas de los datos y las reglas de detección de contaminación, separando la evaluación de las preguntas originales, sus variantes próximas y las preguntas nuevas.
- Informar también de la latencia, el coste y las proporciones de rechazo a responder y de respuestas no evaluables; al cambiar el evaluador, recalcular los resultados de todos los modelos, no solo del nuevo.
Ámbito de aplicación y limitaciones
- Los intervalos estadísticos dependen de los supuestos de muestreo y correlación.
- Los desacuerdos de anotación y los errores del evaluador no desaparecen automáticamente por aumentar el número de preguntas.
- Los ejemplos analíticos de contaminación no diagnostican ningún modelo real.
- No se aporta una nueva clasificación de modelos ni una certificación de capacidades.
Correspondencia entre fuentes primarias y afirmaciones
- Measuring Massive Multitask Language UnderstandingHendrycks et al. · 2020-09-07v3 abstract; 57-task benchmark
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
- MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGIYue et al. · 2023-11-27v4 abstract; dataset scope
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citación y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas basándose en la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutiliza una página ya leída cuando una respuesta HEAD reciente devuelve 200 y la ETag no cambia. El texto, las fórmulas, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de los diagramas científicos; las figuras científicas se calculan mediante fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales incluyen su atribución.
Autoría, versión e historial de correcciones · /guides/evaluation-beyond-leaderboards/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770