
Resumen
Los modelos generativos pueden proponer construcciones auxiliares y fragmentos de programas, pero la validez de las conclusiones matemáticas depende de las especificaciones, los verificadores y las evidencias que puedan reproducirse. AlphaGeometry combina construcciones neuronales con deducción simbólica, mientras que FunSearch busca programas guiado por una evaluación ejecutable. Este artículo compara estos dos tipos de ciclos cerrados y deriva las probabilidades de cobertura de candidatos, la distribución del presupuesto de búsqueda y verificación y un contraejemplo de las pruebas finitas. La conclusión central es que ser ejecutable, obtener una puntuación alta y estar demostrado no constituyen el mismo nivel; la fiabilidad del verificador tampoco puede sustituir a una traducción correcta del problema. El artículo no afirma haber descubierto ningún teorema matemático nuevo, y las figuras solo calculan relaciones de búsqueda bajo supuestos explícitos.[1] Solving olympiad geometry without human demonstrations[2] Mathematical discoveries from program search with large
Traducción del resumen original en inglés
El descubrimiento matemático asistido por máquinas combina propuestas, búsqueda y verificación, pero la solidez de un resultado viene determinada por la especificación y el verificador. Comparamos las construcciones auxiliares de AlphaGeometry con la búsqueda de programas ejecutables de FunSearch. Un análisis de probabilidades de búsqueda, un modelo de distribución del presupuesto y un contraejemplo de las pruebas finitas distinguen el descubrimiento de candidatos de la demostración. Proponemos certificados reproducibles de forma independiente y auditorías de las especificaciones, manteniendo separadas la cobertura del banco de pruebas y la generalidad matemática.
1. Cómo se reparten el trabajo las propuestas neuronales y la clausura simbólica
En AlphaGeometry, el motor simbólico amplía la clausura deductiva a partir de los objetos y relaciones existentes, mientras que el modelo de lenguaje propone construcciones auxiliares cuando es necesario, añadiendo nuevos objetos al motor. Esta división del trabajo conecta un espacio de propuestas sin restricciones con una deducción sujeta a reglas. Su significado científico no consiste en hacer que el lenguaje natural del modelo parezca más creíble, sino en incorporar el contenido generado a una sintaxis explícita y a un procedimiento de comprobación. Este artículo recomienda guardar cada construcción, el grafo deductivo posterior a su incorporación y la cadena final de dependencias, para que los lectores posteriores puedan identificar qué objeto nuevo aportó exactamente el modelo y si la conclusión depende realmente de esa construcción.[1] Solving olympiad geometry without human demonstrations
2. El rendimiento en los bancos de pruebas debe interpretarse junto con el alcance de los problemas expresables
El artículo original de AlphaGeometry resolvió 25 problemas de IMO-AG-30, pero este conjunto procede de problemas traducibles a un lenguaje geométrico específico y excluye tipos como ciertas desigualdades y problemas de geometría combinatoria. Este resultado respalda su capacidad de razonamiento en ese entorno geométrico; no puede reformularse como una tasa de éxito equivalente en problemas matemáticos generales. Este artículo aboga por publicar conjuntamente los problemas originales, sus versiones formalizadas, los tipos de problemas excluidos y las reglas de comprobación manual. Incluso si el comprobador es completamente correcto, si la formalización omite condiciones de no degeneración o sustituye la posición dentro de un segmento por una relación de colinealidad, la proposición demostrada puede diferir del problema original.[1] Solving olympiad geometry without human demonstrations
3. El proceso de descubrimiento de FunSearch se centra en la evaluación ejecutable
FunSearch conecta la generación de programas mediante un modelo de lenguaje con una función de evaluación, una base de datos de candidatos y la selección de poblaciones, utilizando candidatos con puntuaciones altas para construir las instrucciones posteriores. Un programa como salida contiene más estructura interpretable que una respuesta aislada, pero la función de evaluación define el problema que el sistema optimiza realmente. Si la evaluación solo cubre un número finito de instancias, una puntuación alta respalda el rendimiento en esas instancias; si la construcción obtenida satisface restricciones comprobables de forma independiente, puede constituir una evidencia más sólida. Este artículo recomienda tratar la especificación del problema, el evaluador y el buscador como tres objetos con versiones independientes, sin denominar directamente demostración matemática al hecho de que un programa se ejecute satisfactoriamente.[2] Mathematical discoveries from program search with large
4. Derivación de este artículo: un mayor muestreo mejora la probabilidad de existencia, pero no garantiza seleccionar la respuesta correcta
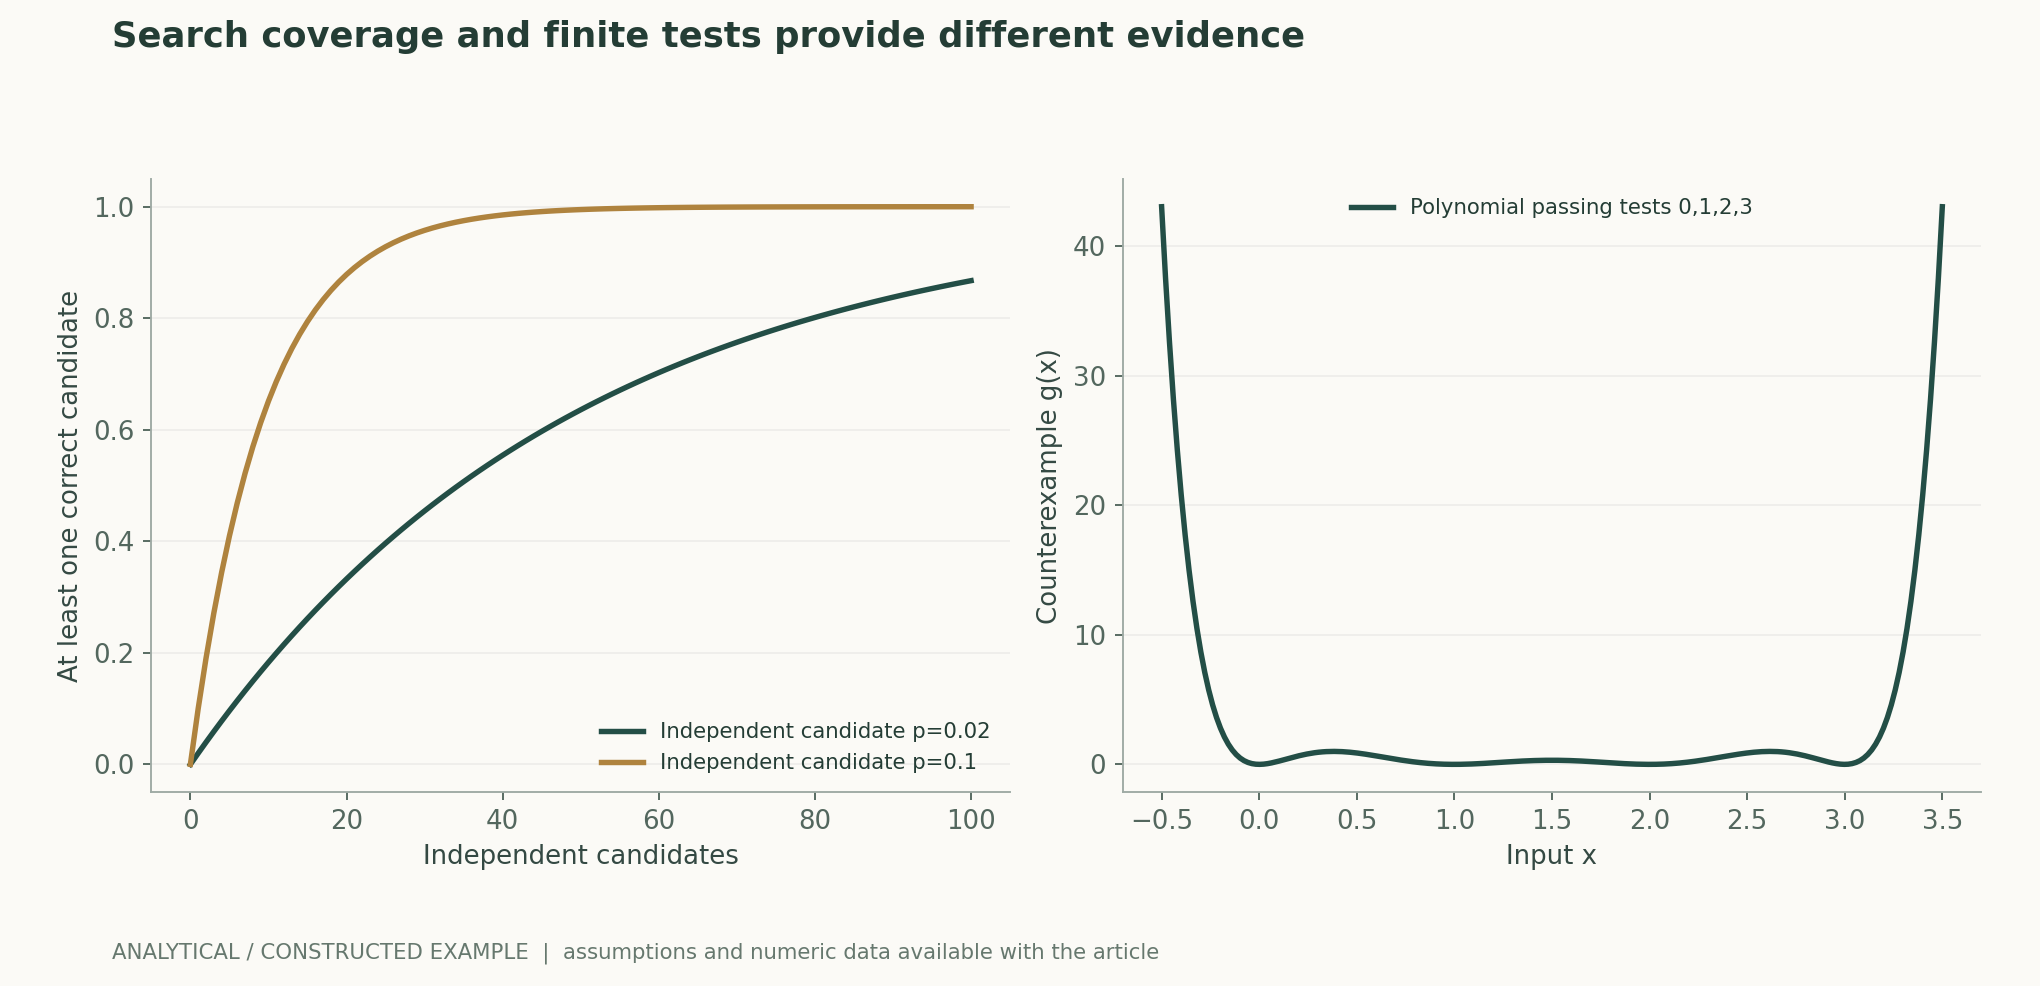
Supongamos que cada candidato independiente es correcto con probabilidad p. La probabilidad de que exista al menos un candidato correcto entre n muestras es 1−(1−p)^n. Esta relación describe la cobertura del conjunto de candidatos, pero no incorpora cuál selecciona el verificador. Si los candidatos están muy correlacionados, el supuesto de independencia sobreestima el beneficio; si el verificador produce falsos positivos, un mayor muestreo también aumenta las oportunidades de que se acepten candidatos incorrectos. La figura representa tanto la cobertura como la probabilidad de aceptación incorrecta, utilizando valores explícitos de p y de la tasa de falsos positivos. No estima el rendimiento de ningún demostrador de teoremas real, sino que ilustra por qué el presupuesto de búsqueda debe comunicarse junto con las reglas de selección y verificación.作者分析与复核建议 / Author analysis
5. Análisis de este artículo: los presupuestos de verificación y de propuestas requieren una optimización conjunta
Sea B el presupuesto total de tiempo, cg el coste de cada propuesta y cv el coste de cada comprobación. El número de candidatos comprobados por completo es, como máximo, la parte entera inferior de B/(cg+cv). Un verificador más complejo puede reducir los falsos positivos, pero también el número de candidatos que pueden comprobarse; un generador de propuestas más rápido también puede producir numerosos objetos duplicados. Este artículo propone utilizar como criterio final las «evidencias válidas reproducibles obtenidas por unidad de presupuesto», registrando por separado los costes de generación, eliminación de duplicados, verificación y certificado final. Describir únicamente la velocidad de la pasada hacia delante del modelo como aceleración del descubrimiento omite los pasos de expansión simbólica, compilación o reproducción independiente que más tiempo pueden consumir.作者分析与复核建议 / Author analysis
6. Contraejemplo de este artículo: las pruebas finitas no demuestran la corrección para entradas no acotadas
Para cualquier conjunto finito de puntos de prueba, puede construirse un polinomio que sea cero en todos ellos y distinto de cero en otros puntos. Por tanto, que una función candidata supere todas las muestras finitas no garantiza que satisfaga la misma propiedad en un dominio no acotado. Este artículo utiliza los puntos de prueba 0, 1, 2 y 3 y el cuadrado de un polinomio para construir una curva ilustrativa: supera perfectamente las pruebas en esos puntos, pero se desvía rápidamente fuera de ellos. Este contraejemplo no niega el valor de los experimentos numéricos, sino que exige denominar con precisión las evidencias. La enumeración exhaustiva de un dominio finito, las construcciones verificables, las demostraciones formales y las pruebas empíricas poseen distintas fuerzas lógicas que no deben ocultarse bajo la etiqueta uniforme «verificación superada».作者分析与复核建议 / Author analysis
7. La comprobación de demostraciones también tiene límites impuestos por las especificaciones y la base de confianza
Un comprobador independiente pequeño puede reducir considerablemente la cantidad de código en la que es necesario confiar, pero siguen siendo necesarias la revisión de los axiomas, la semántica, el núcleo computacional y la traducción de las entradas. Este artículo recomienda separar las herramientas complejas utilizadas durante la búsqueda de la reproducción final del certificado: la búsqueda puede emplear heurísticas, mientras que la conclusión final depende de pasos explícitos y comprobables. Si existen llamadas numéricas externas, supuestos no demostrados o añadidos manuales tras agotar el tiempo, deben enumerarse explícitamente en el certificado. La aceptación de una demostración por el comprobador establece su validez con respecto al sistema dado; no significa que también sean correctos el modelado o la medición del problema original del mundo real.作者分析与复核建议 / Author analysis
8. Las puntuaciones obtenidas mediante búsqueda son sensibles a la elección del evaluador
Optimizar repetidamente frente al mismo evaluador equivale a convertirlo gradualmente en un objetivo de entrenamiento. El ciclo cerrado de FunSearch utiliza este mecanismo para encontrar mejores programas; sin embargo, las comparaciones de investigación también requieren instancias externas de prueba fijadas o demostraciones independientes para evaluar la transferencia. Este artículo recomienda registrar todas las rondas de búsqueda, las familias de candidatos y los momentos de modificación del evaluador, y reservar tamaños o estructuras de instancias que no hayan participado en la búsqueda. Si una heurística mejora únicamente en una distribución conocida, debe denominarse estrategia eficaz para esa distribución, y no teorema que se generaliza a tamaños arbitrarios.[2] Mathematical discoveries from program search with large[3] Let's Verify Step by Step
9. Los nuevos descubrimientos deben distinguir entre nuevos valores numéricos, nuevas construcciones y nuevos teoremas
Mejorar la cota inferior de un problema finito, encontrar una construcción factible mejor, descubrir una regularidad y demostrar una proposición general son resultados valiosos, pero requieren entregables diferentes. Este artículo propone una ficha de descubrimiento que incluya la especificación original, la referencia conocida, el programa candidato, la comprobación independiente, el rango de entradas aplicable y las partes no demostradas. Si el programa candidato contiene una estructura interpretable matemáticamente, la regularidad debe presentarse por separado como una nueva hipótesis, seguida de una demostración o de pruebas mediante contraejemplos. Que el modelo genere un programa que los humanos no hayan escrito antes no justifica afirmar automáticamente que ha resuelto un problema matemático general.作者分析与复核建议 / Author analysis
10. Las comparaciones reproducibles también deben hacer interpretables los fallos
Proponemos prerregistrar un conjunto por tipo y complejidad de los problemas e igualar entre métodos los presupuestos totales de cómputo y trabajo humano. El criterio principal es la proporción de problemas cuya reproducción independiente resulta satisfactoria, complementado con el tamaño de los certificados, el tiempo de búsqueda y los fallos de traducción. Deben contabilizarse por separado la imposibilidad de expresar el problema, la ausencia de una solución encontrada, el rechazo del comprobador y el agotamiento de recursos. Solo así puede determinarse si un método nuevo mejora la generación de objetos, la capacidad deductiva, la estrategia de búsqueda o el rendimiento de ingeniería, sin reducir todos los fallos a una categoría «no resuelto» difícil de diagnosticar.作者分析与复核建议 / Author analysis
Suplemento técnico A · Los grafos de dependencias revelan la contribución real de las propuestas
Que un punto auxiliar aparezca en el diagrama final no significa que la demostración realmente lo necesite. Es posible rastrear hacia atrás las dependencias deductivas desde la conclusión objetivo, eliminar premisas y términos intermedios irrelevantes y reproducir de forma independiente el certificado restante. Los trabajos relacionados con AlphaGeometry muestran la importancia del seguimiento de dependencias. Este artículo recomienda conservar los certificados anteriores y posteriores a la minimización junto con las condiciones eliminadas; si la eliminación de premisas produce una proposición más general, deben revisarse de nuevo el alcance y las condiciones de no degeneración del problema original. Simplificar el grafo de dependencias aporta una pista para el descubrimiento, no un atajo que permita ignorar diferencias semánticas.[1] Solving olympiad geometry without human demonstrations
Suplemento técnico B · La búsqueda adaptativa modifica la muestra efectiva
Los candidatos se generan a partir de los programas ganadores de rondas anteriores, por lo que sus puntuaciones y estructuras están correlacionadas. Tratar todos los candidatos como muestras de Bernoulli independientes exagera la cobertura de búsqueda; contabilizar únicamente la población final también puede ocultar una gran cantidad de cómputo fallido. Este artículo recomienda utilizar ejecuciones independientes de búsqueda y problemas como unidades estadísticas principales, conservando las relaciones de ascendencia y la detección de duplicados. Para comparar generadores, deben fijarse las reglas de evaluación y de población; para comparar sistemas completos, deben igualarse los presupuestos totales y realizarse estudios de ablación de componentes. El nivel de independencia estadística debe corresponder a la afirmación: un número enorme de candidatos no puede sustituir a un número reducido de problemas independientes.[2] Mathematical discoveries from program search with large
Suplemento técnico C · Las vulnerabilidades del evaluador difieren de los contraejemplos matemáticos
Los programas pueden aprovechar detalles de implementación, desbordamientos, tiempos de espera agotados o entradas no comprobadas para obtener puntuaciones altas, lo que no constituye necesariamente una mejora válida respecto al objetivo matemático. Este artículo recomienda añadir comprobaciones semánticas independientes a la ejecución aislada y probar entradas límite, extremas y estructuradas; si el resultado es una construcción factible, sus restricciones también deben volver a comprobarse mediante otra implementación. El descubrimiento de una vulnerabilidad del evaluador debe registrarse como un defecto de ingeniería y no contabilizarse como un descubrimiento matemático. En cambio, un contraejemplo válido que refuta la conjetura original sí es un resultado científico. Ambos deben distinguirse claramente mediante las especificaciones y comprobaciones independientes.作者分析与复核建议 / Author analysis
Suplemento técnico D · La enumeración exhaustiva de un dominio finito tiene límites explícitos
Las pruebas finitas no constituyen una demostración sobre un dominio no acotado, pero si el dominio del problema es en sí mismo un conjunto finito definido con precisión, la enumeración exhaustiva completa puede proporcionar evidencias sólidas, siempre que no omita ningún elemento y que el comprobador sea correcto. Este artículo recomienda registrar el tamaño del dominio, las reglas de enumeración, la eliminación de duplicados y la cobertura de las particiones, y aportar una comprobación independiente del recuento total. Si se utiliza una reducción por simetría, deben explicarse la relación de equivalencia y la completitud de los representantes. No debe llamarse enumeración exhaustiva al muestreo, ni descartarse una demostración sobre un dominio finito por el mero uso de un ordenador; lo decisivo es que el alcance y la cobertura puedan confirmarse de forma independiente.作者分析与复核建议 / Author analysis
11. Conclusión: la solidez del descubrimiento automático procede de compromisos comprobables
El mayor valor de los sistemas neurosimbólicos reside en poner la capacidad exploratoria de los modelos generativos al servicio de restricciones lógicas o programáticas explícitas. Los análisis de probabilidad y presupuesto y el contraejemplo de las pruebas finitas de este artículo muestran que existen pasos ineludibles entre encontrar un candidato, superar la evaluación y obtener una demostración. Los entregables públicos deben permitir que incluso un lector que no confíe en el modelo generativo compruebe las conclusiones fundamentales y sepa a qué clase de problemas se aplican las evidencias. Tales descubrimientos pueden llegar a convertirse en conocimiento matemático acumulable, comparable y generalizable.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) Existencia de un candidato correcto entre candidatos independientes; no incluye la capacidad de selección del verificador.
LaTeX
P(\exists\ \mathrm{correct})=1-(1-p)^n(2) Cota presupuestaria simplificada para la generación secuencial y la verificación individual; el paralelismo y los costes compartidos deben contabilizarse por separado.
LaTeX
n_{\mathrm{checked}}\le\left\lfloor\frac B{c_g+c_v}\right\rfloor(3) Contraejemplo de las pruebas finitas: vale 0 en cada uno de los puntos 0, 1, 2 y 3, pero generalmente es distinto de 0 en los demás puntos.
LaTeX
g(x)=\left[\prod_{i=0}^{3}(x-i)\right]^2(4) La probabilidad a priori p de que el candidato sea correcto, la tasa de aceptación verdadera t y la tasa de aceptación falsa f del verificador determinan la fiabilidad final.
LaTeX
P(\mathrm{correct}\mid\mathrm{accept})=\frac{p\,t}{p\,t+(1-p)f}Flujo de métodos y evidencias
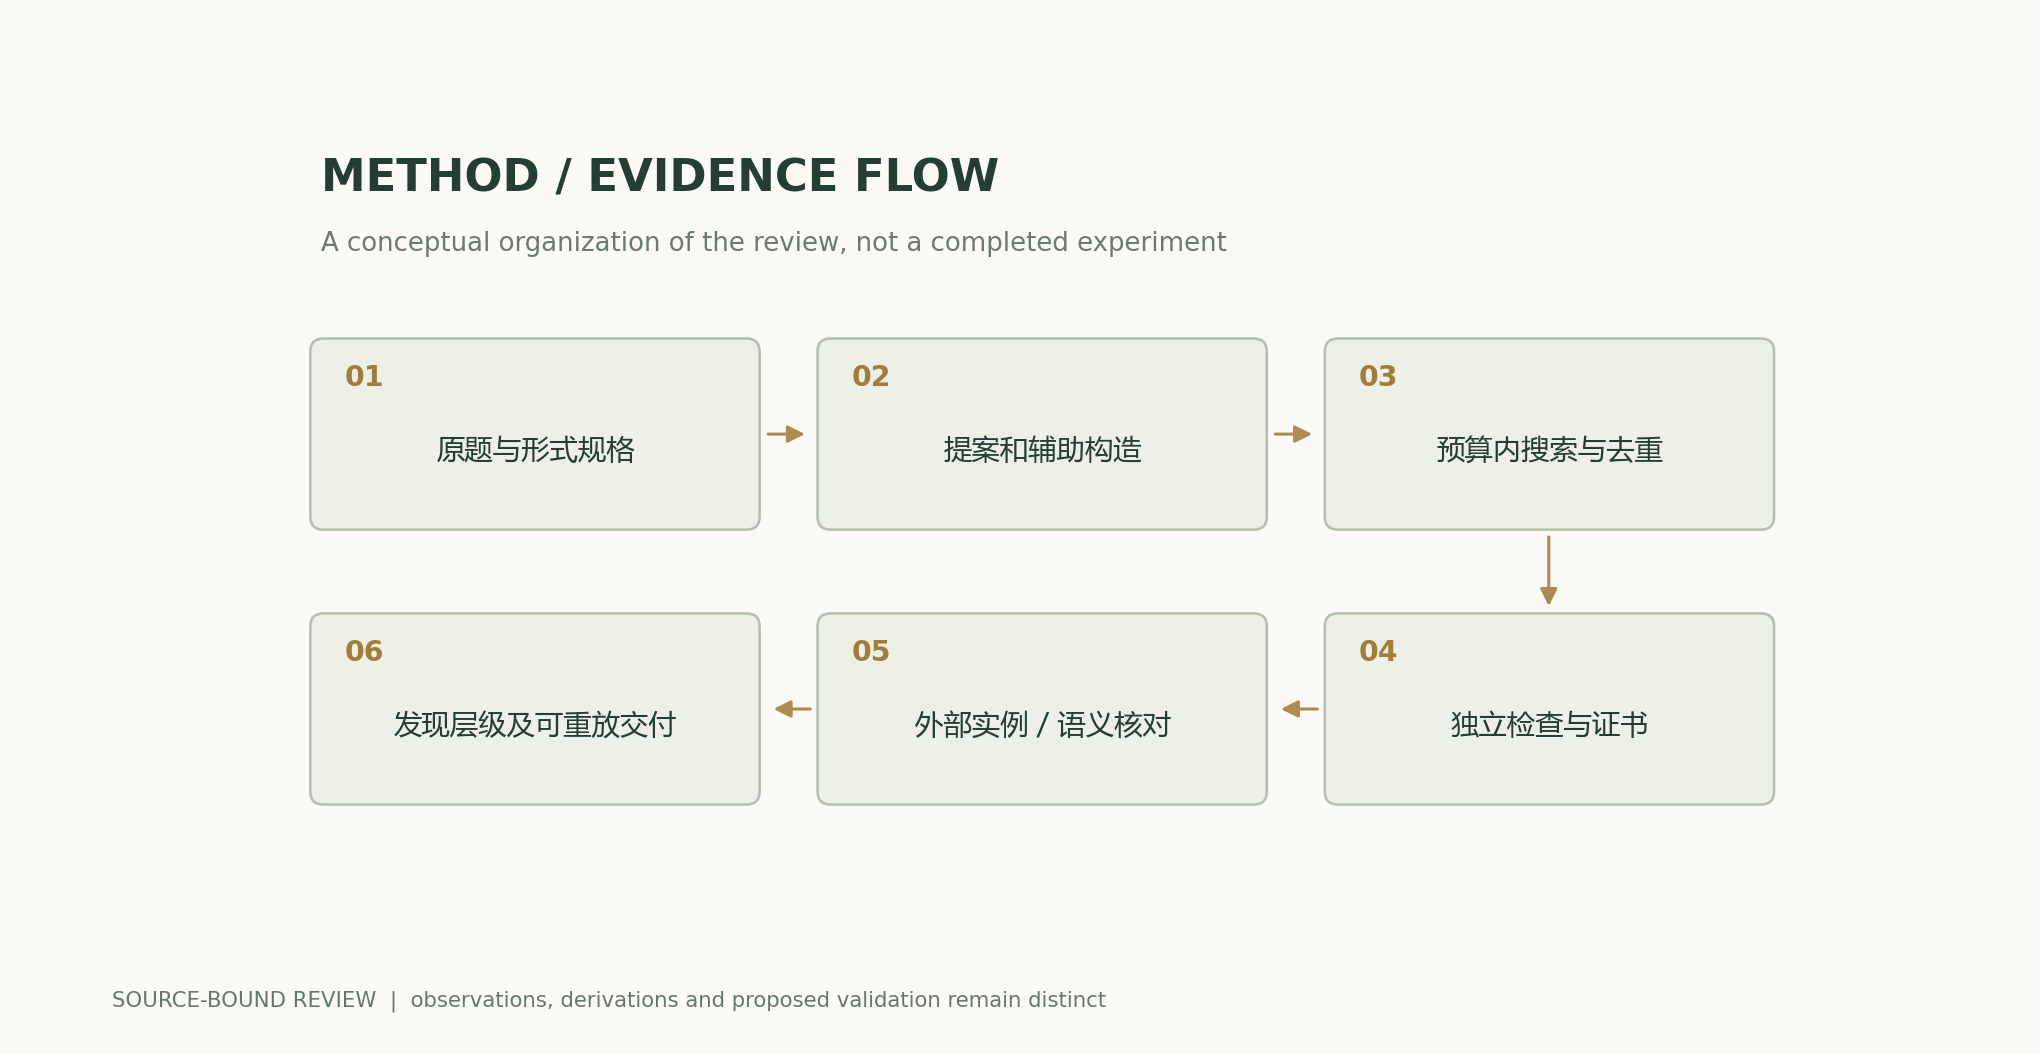
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto recalculable
Con p=0.1 y n=20, la probabilidad de obtener al menos un candidato correcto es aproximadamente 0.878423; g vale 0 en todos los puntos de 0,1,2,3, pero g(0.5)=0.87890625, por lo que las pruebas finitas no demuestran una propiedad sobre un dominio no acotado.
Comparación de métodos
| Nivel del resultado | Evidencias que deben entregarse | No establece automáticamente |
|---|---|---|
| Programa ejecutable | Entradas, código y condiciones de ejecución | Corrección para todas las entradas |
| Mejora en pruebas finitas | Instancias fijadas y resultados completos | Teorema general sobre un dominio no acotado |
| Construcción factible | Objeto comprobable de forma independiente | Optimalidad global |
| Mejora de la cota inferior | Construcción y demostración del cumplimiento de las restricciones | Valor óptimo exacto |
| Demostración formal | Especificación, axiomas y reproducción del certificado | Traducción correcta del problema original |
| Descubrimiento general | Proposición explícita y demostración / contraejemplo | Validez basada únicamente en la novedad del programa |
Plan de comprobación y experimentación
- Fijar el problema original y la especificación formal, comprobando explícitamente las condiciones de no degeneración y de alcance.
- Gestionar por separado las versiones del buscador, el evaluador y el comprobador final.
- Igualar los presupuestos completos de cómputo y trabajo humano, registrando los costes de generación y verificación.
- Conservar todas las búsquedas y familias de candidatos, evitando contar duplicados como muestras independientes.
- Verificar mediante instancias independientes o reproducción de certificados, registrando por separado las partes no demostradas.
- Distinguir entre imposibilidad de expresar, ausencia de solución encontrada, rechazo del comprobador y agotamiento de recursos.
- Comunicar los distintos niveles de evidencia de las construcciones, las cotas inferiores, las regularidades empíricas y los teoremas generales.
- Entregar evidencias que puedan reproducirse sin invocar el modelo generativo y no denominar al contraejemplo de este artículo descubrimiento de un nuevo teorema.
Ámbito de aplicación y limitaciones
- Las curvas de probabilidad suponen candidatos independientes; las búsquedas reales presentan dependencias.
- No se ejecutaron AlphaGeometry ni FunSearch.
- El contraejemplo de las pruebas finitas solo ilustra un límite lógico; no evalúa la veracidad o falsedad de los resultados de programas concretos.
- Las demostraciones formales siguen dependiendo de las especificaciones y de la base de computación de confianza.
- Este artículo no reivindica ningún nuevo récord matemático, resultado de optimalidad ni teorema general.
Evidencias de los estudios originales y su alcance
| Resultado del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Resolución de 25 problemas de IMO-AG-30 y generación de demostraciones legibles. | El conjunto está limitado por un lenguaje geométrico específico y un determinado alcance de tipos de problemas. | Resolución de problemas de geometría de olimpiadas sin demostraciones humanasDefinición del banco de pruebas; tabla 1; alcance de la traducción |
| Integra la generación de programas, la evaluación y una base de datos de poblaciones en un ciclo cerrado de búsqueda. | La solidez de las evidencias depende de la especificación y de la cobertura de la evaluación. | Descubrimientos matemáticos mediante la búsqueda de programas con grandes modelos de lenguajeMétodo FunSearch; base de datos de programas |
Preguntas de investigación que merece la pena contrastar
- Con un presupuesto total fijo, ¿resulta más eficaz disponer de más candidatos o de un comprobador más potente?
- ¿Cómo limitan conjuntamente el éxito la novedad de las construcciones auxiliares y el alcance expresivo de las reglas deductivas?
- ¿Pueden las mejoras finitas producidas por la búsqueda de programas destilarse en una estructura general demostrable?
Fuentes primarias y afirmaciones correspondientes
- Solving olympiad geometry without human demonstrationsTrinh et al. · 2024-01-17IMO-AG-30: 25/30; geometry-language coverage and excluded problem types; author correction noted.
- Mathematical discoveries from program search with large language modelsRomera-Paredes et al. · 2023Program generation, evaluation function, population database and search; evaluator validity is part of the system.
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de registros de revisión independiente por pares de este artículo ni de experimentos originales con modelos, clínicos o físicos para él.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se conservan las fuentes por sección y los límites entre las evidencias de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se elaboraron con el código y los archivos numéricos adjuntos; sus leyendas explican individualmente los supuestos y las definiciones de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código recalculable · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c