
要旨
生成モデルは補助構成やプログラム断片を提案できるが、数学的結論が成立するかどうかは、仕様、検証器、再実行可能な証拠に依存する。AlphaGeometryはニューラルな構成と記号的推論を組み合わせ、FunSearchは実行可能な評価に導かれてプログラムを探索する。本稿はこれらの閉ループを比較し、候補の被覆確率、探索と検証の予算配分、有限テストに対する反例を導く。中心的な結論は、実行可能であること、高得点であること、証明されていることは同じ水準ではなく、検証器の信頼性も問題の翻訳の正しさを代替できないという点である。本稿は新しい数学的定理の発見を主張せず、図は明示された仮定の下で探索に関する関係のみを計算する。[1] Solving olympiad geometry without human demonstrations[2] Mathematical discoveries from program search with large
原文の英語要旨の日本語訳
機械支援による数学的発見は提案、探索、検証を組み合わせるが、結果の強さは仕様と検証器によって決まる。本稿では、AlphaGeometryの補助構成とFunSearchの実行可能なプログラム探索を比較する。探索確率の分析、予算配分モデル、有限テストに対する反例によって、候補の発見と証明を区別する。ベンチマークの被覆範囲と数学的な一般性を分けた上で、独立に再実行可能な証明書と仕様監査を提案する。
1. ニューラルな提案と記号的閉包はいかに役割を分担するか
AlphaGeometryでは、記号エンジンが既存の対象と関係から演繹閉包を拡張し、必要に応じて言語モデルが補助構成を提案して、エンジンに新たな対象を追加する。この役割分担は、制限のない提案空間を、規則に制約された推論へと結び付ける。その科学的意義は、言語モデルの自然言語をより信頼できるように聞こえさせることではなく、生成内容を明示的な構文と検査手順に組み込むことにある。本稿は、各構成、その追加後の推論グラフ、最終的な依存連鎖を保存することを推奨する。これにより、後の読者はモデルが実際にどの新たな対象を提供したのか、また結論が本当にその構成に依存するのかを確認できる。[1] Solving olympiad geometry without human demonstrations
2. ベンチマーク性能は表現可能な問題の範囲と併せて理解する必要がある
AlphaGeometryの原論文はIMO-AG-30で25問を解いたが、この集合は特定の幾何言語に翻訳可能な問題から構成され、一部の不等式や組合せ幾何などの種類は除外されている。この結果は、その幾何環境における推論能力を裏付けるものであり、一般的な数学の問題でも同じ成功率が得られると読み替えることはできない。本稿は、原問題、形式化版、除外された問題の種類、人手による照合規則を併せて公開することを提唱する。検査器が完全に正しくても、形式化で非退化条件を落としたり、線分内の位置関係を共線関係へ置き換えたりすれば、証明された命題は原問題と異なり得る。[1] Solving olympiad geometry without human demonstrations
3. FunSearchの発見過程は実行可能な評価を中心とする
FunSearchは、言語モデルによるプログラム生成を評価関数、候補データベース、集団選択と結び付け、高得点の候補を用いて後続のプロンプトを構成する。出力としてのプログラムは単一の答えより多くの解釈可能な構造を含むが、システムが実際に最適化する問題は評価関数によって定まる。評価が有限個の事例のみを対象とするなら、高得点が裏付けるのはそれらの事例での性能である。出力された構成が独立に検査可能な制約を満たすなら、より強い証拠を形成できる。本稿は、問題仕様、評価器、探索器を別々に版管理する三つの対象として扱い、「プログラムが実行を通過した」ことをそのまま数学的証明と呼ばないことを推奨する。[2] Mathematical discoveries from program search with large
4. 本稿の導出:サンプリングの増加は存在確率を高めるが、正解の選択を保証しない
独立な各候補が確率pで正しいと仮定すると、n回のサンプリングで少なくとも一つの正しい候補が存在する確率は1−(1−p)^nである。この関係は候補集合の被覆を記述するが、検証器がどの候補を選ぶかは含まない。候補間の相関が強ければ、独立性の仮定は利得を過大評価する。検証器に偽陽性があれば、サンプリングを増やすことで誤った候補が通過する機会も増える。図では、明示されたpと偽陽性率を用いて、被覆率と誤通過確率を併せて示す。これは実在する定理証明器を推定するものではなく、探索予算を選択規則および検証規則と併せて報告すべきことを示すものである。作者分析与复核建议 / Author analysis
5. 本稿の分析:検証予算と提案予算は同時に最適化する必要がある
総時間予算をB、提案一件当たりの費用をcg、検査一回当たりの費用をcvとすると、完全に検査できる候補数は高々B/(cg+cv)の床関数値である。より複雑な検証器は偽陽性を減らす可能性がある一方、検査できる候補数を減らす。より高速な提案器も、大量の重複対象を生成する可能性がある。本稿は「単位予算当たりに得られる、再実行可能で有効な証拠」を評価の到達点とし、生成、重複除去、検証、最終証明書の費用を別々に記録することを提案する。モデルの順伝播の速度だけを発見の高速化と記述すると、最も時間を要する記号展開、コンパイル、独立した再実行の段階を見落とす。作者分析与复核建议 / Author analysis
6. 本稿の反例:有限テストは非有界な入力に対する正しさを証明できない
任意の有限なテスト点集合に対して、そのすべての点で零となり、他の点では非零となる多項式を構成できる。したがって、候補関数が有限個の全標本を通過しても、非有界領域で同じ性質を満たすとは保証されない。本稿はテスト点0、1、2、3と多項式の平方を用いて、テスト点では完全に通過し、その外では急速に逸脱する様子を直観的な曲線で示す。この反例は数値実験の価値を否定するものではなく、証拠に正確な名称を付すことを求めるものである。有限領域の全数探索、検証可能な構成、形式的証明、経験的テストはそれぞれ論理的強度が異なり、一律に「検証済み」と表示して違いを覆い隠してはならない。作者分析与复核建议 / Author analysis
7. 証明検査にも仕様と信頼基盤に由来する境界がある
小規模な独立検査器は、信頼する必要のあるコードの範囲を大きく縮小できるが、それでも公理、意味論、計算カーネル、入力の翻訳を確認する必要がある。本稿は、探索中に用いる複雑なツールと最終証明書の再実行を分離することを推奨する。探索にはヒューリスティクスを用いてよいが、最終結論は明確に検査可能な手順に依存する。外部の数値計算の呼出し、未証明の仮定、タイムアウト後の人手による補記がある場合は、証明書に明示的に列挙すべきである。検査器による証明の受理は、与えられた体系に相対的に成立することを示すのであって、元の現実問題のモデル化や測定も正しいことを意味しない。作者分析与复核建议 / Author analysis
8. 探索で得られるスコアは評価器の選択に影響されやすい
同じ評価器に対して繰り返し最適化することは、その評価器を徐々に学習目標へ変えることに等しい。FunSearchの閉ループはこの仕組みを利用してより良いプログラムを見いだすが、研究上の比較では、転移を判断するために固定した外部テスト事例や独立した証明も必要である。本稿は、すべての探索ラウンド、候補の系統群、評価器を変更した時点を記録し、探索に参加しなかった規模または構造の事例を別に設けることを推奨する。あるヒューリスティクスが既知の分布でのみ改善するなら、それはその分布に有効な戦略と呼ぶべきであり、任意の規模へ一般化する定理と呼ぶべきではない。[2] Mathematical discoveries from program search with large[3] Let's Verify Step by Step
9. 新たな発見では新しい数値・構成・定理を区別すべきである
ある有限問題の下界を改善すること、より良い実行可能な構成を見いだすこと、規則性を発見すること、一般命題を証明することはいずれも価値ある成果だが、提示すべき成果物の形は異なる。本稿は、原仕様、既知のベースライン、候補プログラム、独立検査、適用可能な入力範囲、未証明部分を記載する発見カードを提案する。候補プログラムに数学的に解釈可能な構造が含まれるなら、その規則性を新たな仮説として別に掲げ、続いて証明または反例による検証を示すべきである。モデルが人間のまだ書いたことのないプログラムを生成したという理由だけで、一般的な数学の問題を解決したと自動的に主張することはできない。作者分析与复核建议 / Author analysis
10. 再現可能な比較では失敗も解釈可能にすべきである
本稿では、問題の種類と複雑さに応じて集合を事前登録し、各手法の総計算予算と人的予算を揃えることを提案する。主要評価項目は独立した再実行に成功する問題の割合とし、証明書の大きさ、探索時間、翻訳失敗を補助指標とする。表現不能、未発見、検査による拒否、資源枯渇は別々に集計すべきである。こうすることで初めて、すべての失敗を診断しにくい「未解決」にまとめることなく、新手法が改善したのは対象生成、推論能力、探索戦略、実装上の処理量のいずれなのかを判断できる。作者分析与复核建议 / Author analysis
技術補足 A · 依存グラフが提案の実際の寄与を明らかにする
最終図に補助点が現れることは、証明が実際にその点を必要としていることを意味しない。目標となる結論から推論の依存関係を遡り、無関係な前提と中間項を削除して、残った証明書を独立に再実行できる。AlphaGeometry関連の研究は、依存関係の追跡の重要性を示している。本稿は、最小化の前後の証明書と削除された条件を併せて保存することを推奨する。前提の削除によってより一般的な命題が得られた場合には、原問題の範囲と非退化条件を改めて確認する必要がある。依存グラフの簡略化は発見の手掛かりであって、意味上の違いを無視してよい近道ではない。[1] Solving olympiad geometry without human demonstrations
技術補足 B · 適応的探索は有効な標本を変える
候補は前のラウンドで優れたプログラムから生成されるため、スコアと構造に相関が生じる。すべての候補を独立なベルヌーイ標本とみなすと探索の被覆を過大評価し、最終集団のみを集計すると大量の失敗計算が隠れる可能性がある。本稿は、独立した探索実行と問題を主要な統計単位とし、祖先関係と重複検出を保持することを推奨する。生成器を比較するなら評価と集団の規則を固定し、システム全体を比較するなら総予算を揃えて構成要素のアブレーションを行うべきである。統計的独立性の水準は主張と一致しなければならず、膨大な候補数を少数の独立した問題の代わりにすることはできない。[2] Mathematical discoveries from program search with large
技術補足 C · 評価器の脆弱性と数学的反例は異なる
プログラムは、実装の細部、オーバーフロー、タイムアウト、未検査の入力を利用して高得点を得る場合があり、それが数学的目標に対する有効な改善とは限らない。本稿は、隔離実行に加えて独立した意味論的検査を設け、境界的、極端、構造化された入力をテストすることを推奨する。成果が実行可能な構成であれば、異なる実装で制約を再検査すべきである。評価器の脆弱性の発見は実装上の欠陥として記録し、数学的発見には数えてはならない。一方、元の予想を覆す正当な反例は科学的成果であり、両者は仕様と独立検査によって明確に区別する必要がある。作者分析与复核建议 / Author analysis
技術補足 D · 有限領域の全数探索には明確な境界がある
有限テストは非有界な領域に対する証明にはならないが、問題領域がもともと厳密に定義された有限集合であれば、完全な全数列挙は、列挙に漏れがなく検査器が正しいことを条件として、強い証拠となり得る。本稿は、領域の大きさ、列挙規則、重複除去、分割ごとの被覆を記録し、総数について独立した照合を行うことを推奨する。対称性による縮約を用いる場合には、同値関係と代表元の完全性を説明する必要がある。標本検査を全数探索と誤称してはならず、コンピュータを使ったというだけで有限領域の証明を否定してもならない。重要なのは、範囲と被覆を独立に確認できるかどうかである。作者分析与复核建议 / Author analysis
11. 結論:機械による発見の強さは検査可能な確約に由来する
ニューロシンボリックシステムの最も価値ある点は、生成モデルの探索能力を、明確な論理的制約やプログラム上の制約のために役立てることである。本稿の確率分析、予算分析、有限テストに対する反例は、候補を見つけること、評価を通過すること、証明を得ることの間に、省略できない段階があることを示す。公開する成果物は、生成モデルを信用しない読者にも主要な結論を検査でき、証拠がどの種類の問題に適用されるのかを理解できるものであるべきだ。そのような発見こそ、蓄積、比較、一般化が可能な数学的知識となる可能性を持つ。作者分析与复核建议 / Author analysis
主要な式と導出
(1) 独立な候補における正しい候補の存在性。検証器の選択能力は含まない。
LaTeX
P(\exists\ \mathrm{correct})=1-(1-p)^n(2) 逐次生成し一件ずつ検証する場合の簡略化した予算上の限界。並列化と共通のオーバーヘッドは別途計上する必要がある。
LaTeX
n_{\mathrm{checked}}\le\left\lfloor\frac B{c_g+c_v}\right\rfloor(3) 有限テストに対する反例:0、1、2、3ではすべて0であり、他の点では通常0ではない。
LaTeX
g(x)=\left[\prod_{i=0}^{3}(x-i)\right]^2(4) 候補が正しい事前確率p、検証器が正しい候補を受理する率t、誤った候補を受理する率fが最終的な信頼性を決める。
LaTeX
P(\mathrm{correct}\mid\mathrm{accept})=\frac{p\,t}{p\,t+(1-p)f}方法と証拠の流れ
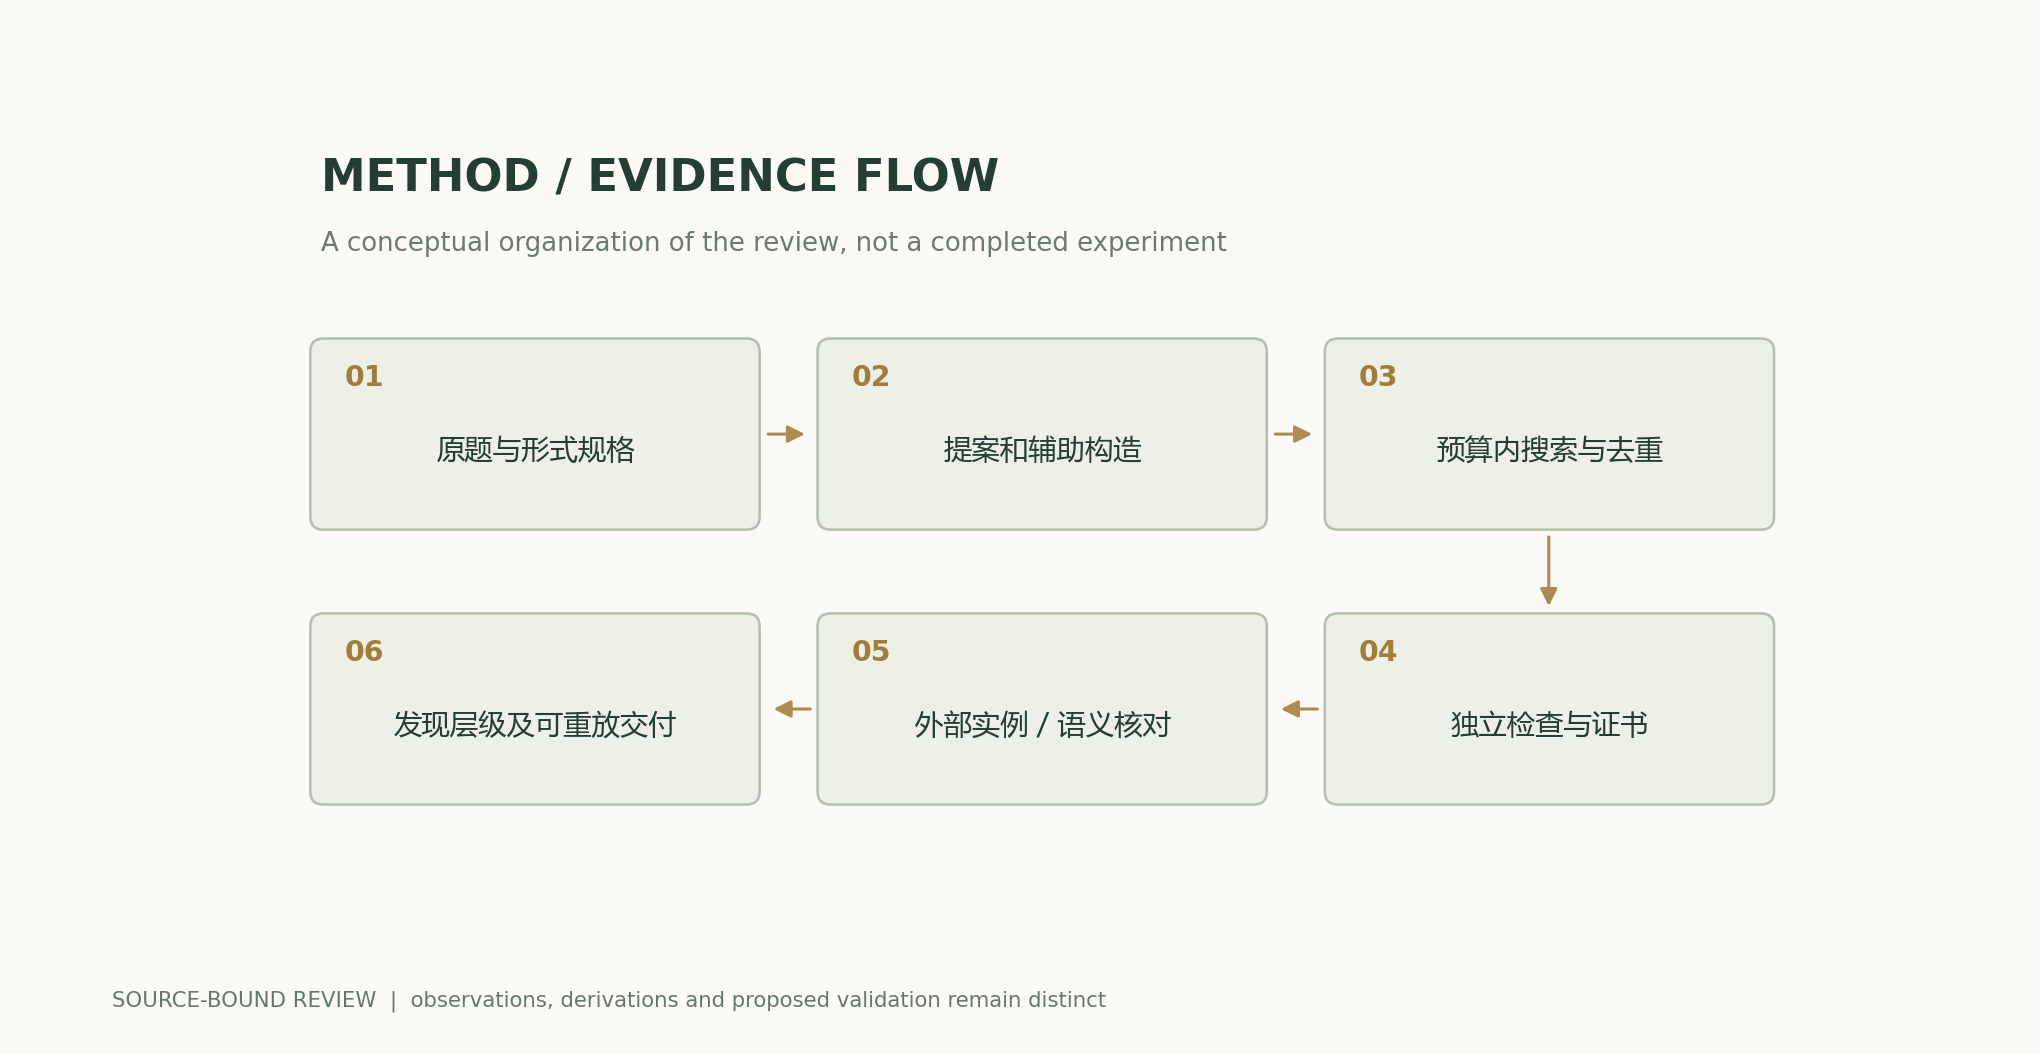
解析図と数値例
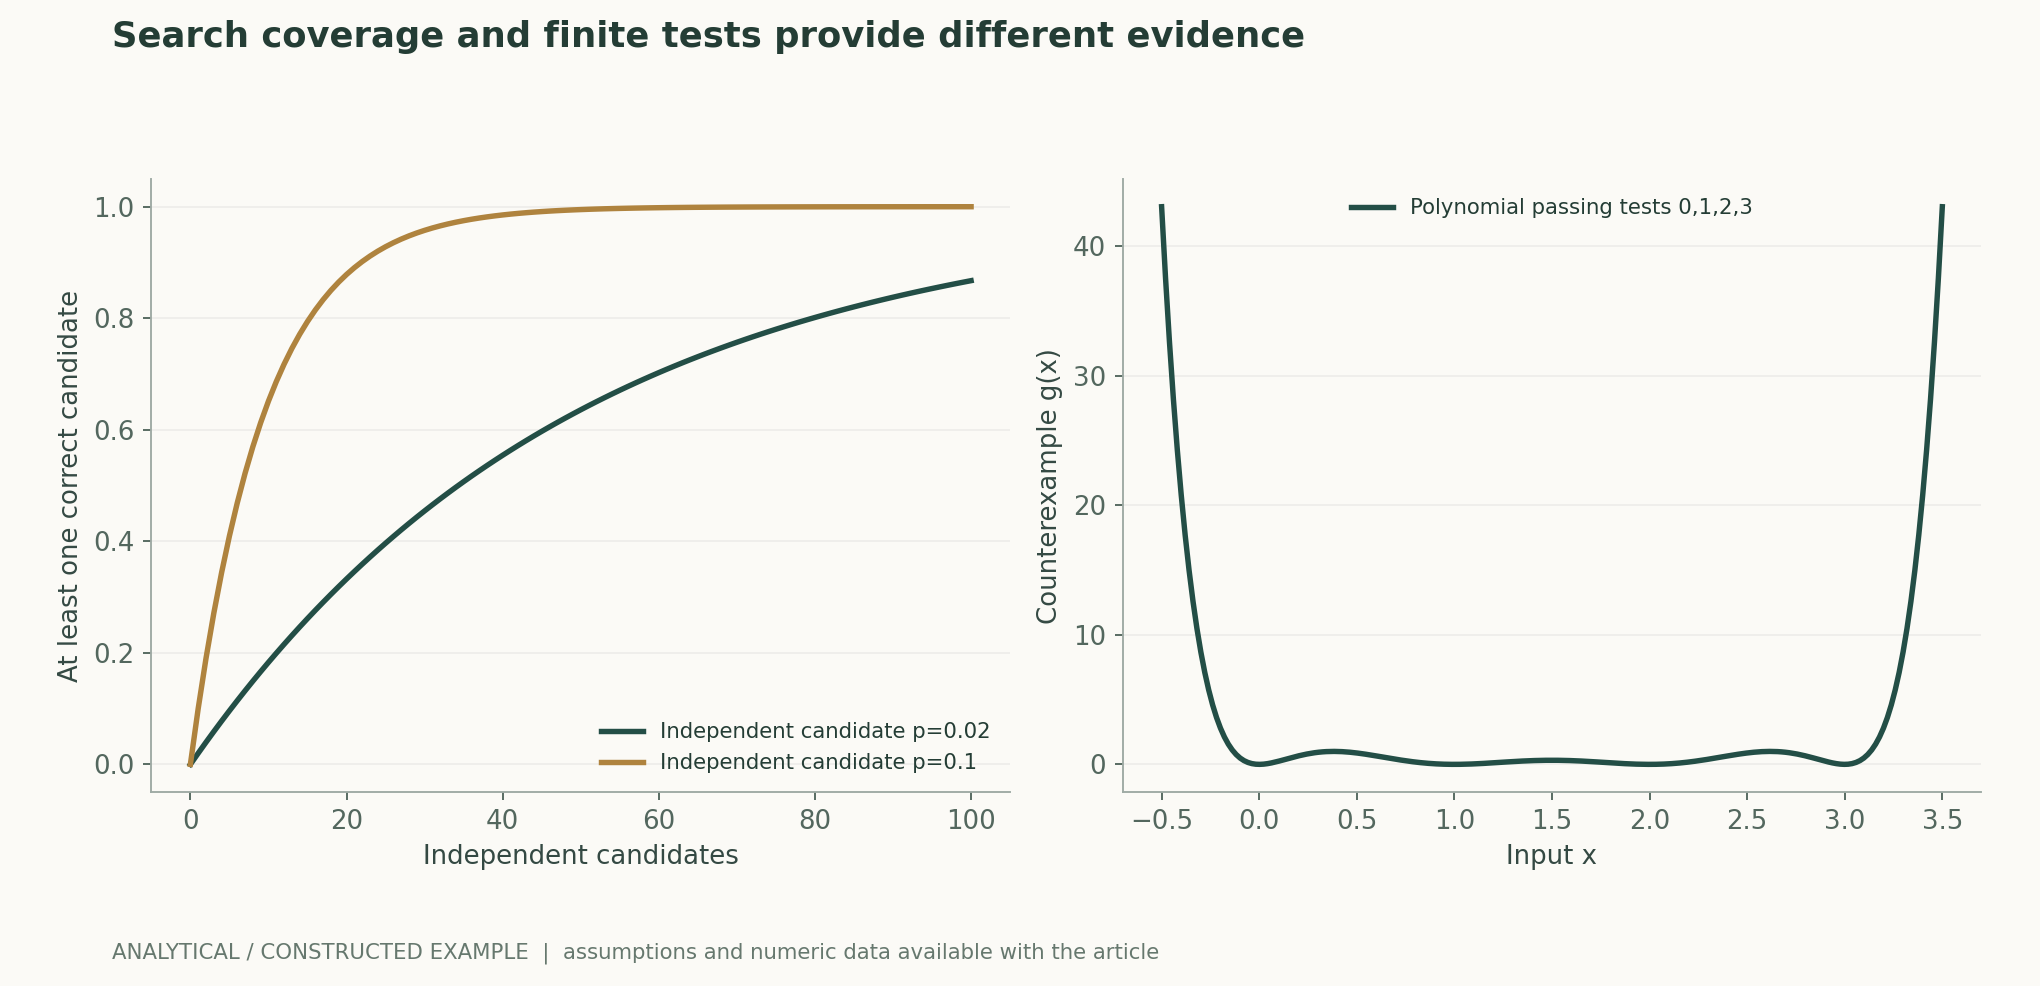
再計算可能な例題
p=0.1、n=20のとき、少なくとも一回正しい候補が得られる確率は約0.878423である。gは0,1,2,3でいずれも0だが、g(0.5)=0.87890625であり、有限テストは非有界な領域での性質を証明しない。
方法の比較
| 成果の水準 | 提示すべき証拠 | 自動的には導けないもの |
|---|---|---|
| 実行可能なプログラム | 入力・コード・実行条件 | すべての入力に対する正しさ |
| 有限テストでの改善 | 固定した事例と完全な結果 | 非有界な領域に対する一般定理 |
| 実行可能な構成 | 独立に検査可能な対象 | 大域的最適性 |
| 下界の改善 | 構成と制約充足の証明 | 厳密な最適値 |
| 形式的証明 | 仕様・公理・証明書の再実行 | 原問題の翻訳の正しさ |
| 一般的な発見 | 明確な命題と証明/反例 | プログラムの新規性だけに基づく成立 |
再検証と実験の計画
- 原問題と形式仕様を固定し、非退化条件と範囲条件を明示的に照合する。
- 探索器、評価器、最終検査器を別々に版管理する。
- 計算と人手の全予算を揃え、生成と検証の費用を記録する。
- すべての探索と候補の系統群を保存し、重複を独立したサンプリングとして数えない。
- 独立した事例または証明書の再実行で検証し、未証明部分は別に登録する。
- 表現不能、未発見、検査による拒否、資源枯渇を区別する。
- 構成、下界、経験的規則性、一般定理の異なる証拠水準を報告する。
- 生成モデルを呼び出さずに再実行できる証拠を提示し、本稿の反例を新たな定理の発見とは呼ばない。
適用範囲と限界
- 確率曲線は候補の独立性を仮定するが、実際の探索には依存関係がある。
- AlphaGeometryもFunSearchも実行していない。
- 有限テストに対する反例は論理的境界のみを示し、特定のプログラムの成果の真偽を評価するものではない。
- 形式的証明も依然として仕様と信頼計算基盤に依存する。
- 本稿は新たな数学的記録、最適性、一般定理を主張しない。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| IMO-AG-30の25問を解き、可読な証明を生成した。 | 集合は特定の幾何言語と問題の種類の範囲によって限定される。 | 人間による解答の実演なしで数学オリンピックの幾何問題を解くベンチマークの定義;表1;翻訳の範囲 |
| プログラム生成、評価、集団データベースによって探索の閉ループを構成する。 | 証拠の強さは仕様と評価の被覆範囲に依存する。 | 大規模言語モデルによるプログラム探索からの数学的発見FunSearchの方法;プログラムデータベース |
検証に値する研究課題
- 総予算を固定したとき、候補数の増加とより強力な検査器のどちらが有効か。
- 補助構成の新規性と推論規則の表現範囲は、どのように共同で成功を制限するのか。
- プログラム探索が生み出す有限の改善を、証明可能な一般構造へと抽出できるか。
一次資料と主張の対応
- Solving olympiad geometry without human demonstrationsTrinh et al. · 2024-01-17IMO-AG-30: 25/30; geometry-language coverage and excluded problem types; author correction noted.
- Mathematical discoveries from program search with large language modelsRomera-Paredes et al. · 2023Program generation, evaluation function, population database and search; evaluator validity is part of the system.
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
引用と原稿のエクスポート
著者・版・出典
Codex(AI)が執筆した、出典を伴う研究レビューと独自の解析である。原論文の実験は元の研究チームに帰属し、本稿の計算は列挙した式と明示した仮定のみを検証する。当サイトには現時点で、本稿に対する独立した査読、または独自のモデル実験・臨床実験・物理実験の記録はない。
初出:AIと科学的発見の詳細特集。節ごとの出典、および原研究の証拠と著者の解析との境界を保持する。
概念的な表紙はImageGenが生成した。科学図は付属のコードと数値ファイルから作成し、図注では仮定と測定の定義を項目ごとに説明する。
表紙と科学図の出典 · データ・出典・仮定 · Python · 再計算可能なコード · 公開・版履歴
ソースのリビジョン: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c