
摘要
生成模型能够提出辅助构造与程序片段,但数学结论是否成立取决于规格、验证器和可重放证据。AlphaGeometry 将神经构造与符号推导结合,FunSearch 则在可执行评价驱动下搜索程序。本文比较这两类闭环,并推导候选覆盖概率、搜索与验证预算分配以及有限测试的反例。核心结论是,可执行、高分和被证明不是同一个层级;验证器可靠性也不能代替问题翻译正确性。全文未宣称发现新数学定理,图只计算明确假设下的搜索关系。[1] Solving olympiad geometry without human demonstrations[2] Mathematical discoveries from program search with large
English abstract
Machine-assisted mathematical discovery combines proposal, search and verification, but the strength of a result is determined by the specification and verifier. We compare AlphaGeometry's auxiliary constructions with FunSearch's executable program search. A search-probability analysis, a budget-allocation model and a finite-test counterexample distinguish candidate discovery from proof. We propose independently replayable certificates and specification audits, while keeping benchmark coverage and mathematical generality separate.
1. 神经提案与符号闭包如何分工
AlphaGeometry 中,符号引擎从已有对象和关系扩展推导闭包,语言模型在需要时提出辅助构造,为引擎增加新的对象。这个分工将不受限的提案空间与受规则约束的推导连接起来。其科学意义不是让语言模型的自然语言听起来更可信,而是把生成内容放入明确语法与检查流程。本文建议保存每次构造、加入后的推导图和最终依赖链,让后续读者看到模型到底贡献了哪个新对象,以及结论是否真的依赖该构造。[1] Solving olympiad geometry without human demonstrations
2. 基准表现必须连同可表达的问题范围理解
AlphaGeometry 原文在 IMO-AG-30 上解出 25 题,但该集合来自可翻译到特定几何语言的题目,排除了某些不等式和组合几何等类型。这个结果支持其在该几何环境中的推理能力,不能改写为通用数学问题的同等成功率。本文主张同时公开原始题目、形式化版本、被排除的题型和人工核对规则。即使检查器完全正确,若形式化遗漏了非退化条件或把区间位置改成共线关系,所证明的命题也可能与原题不同。[1] Solving olympiad geometry without human demonstrations
3. FunSearch 的发现过程以可执行评价为中心
FunSearch 将语言模型生成程序与评价函数、候选数据库和种群选择连接起来,利用高分候选构造后续提示。程序作为输出比单个答案包含更多可解释结构,但评价函数定义了系统实际优化的问题。若评价仅覆盖有限实例,高分支持的是这些实例上的表现;若输出构造满足可独立检查的约束,则可以形成更强证据。本文建议把问题规格、评价器和搜索器作为三个分别版本化的对象,而不把“程序通过运行”直接称为数学证明。[2] Mathematical discoveries from program search with large
4. 本文推导:更多采样改善存在性,不保证选中正确答案
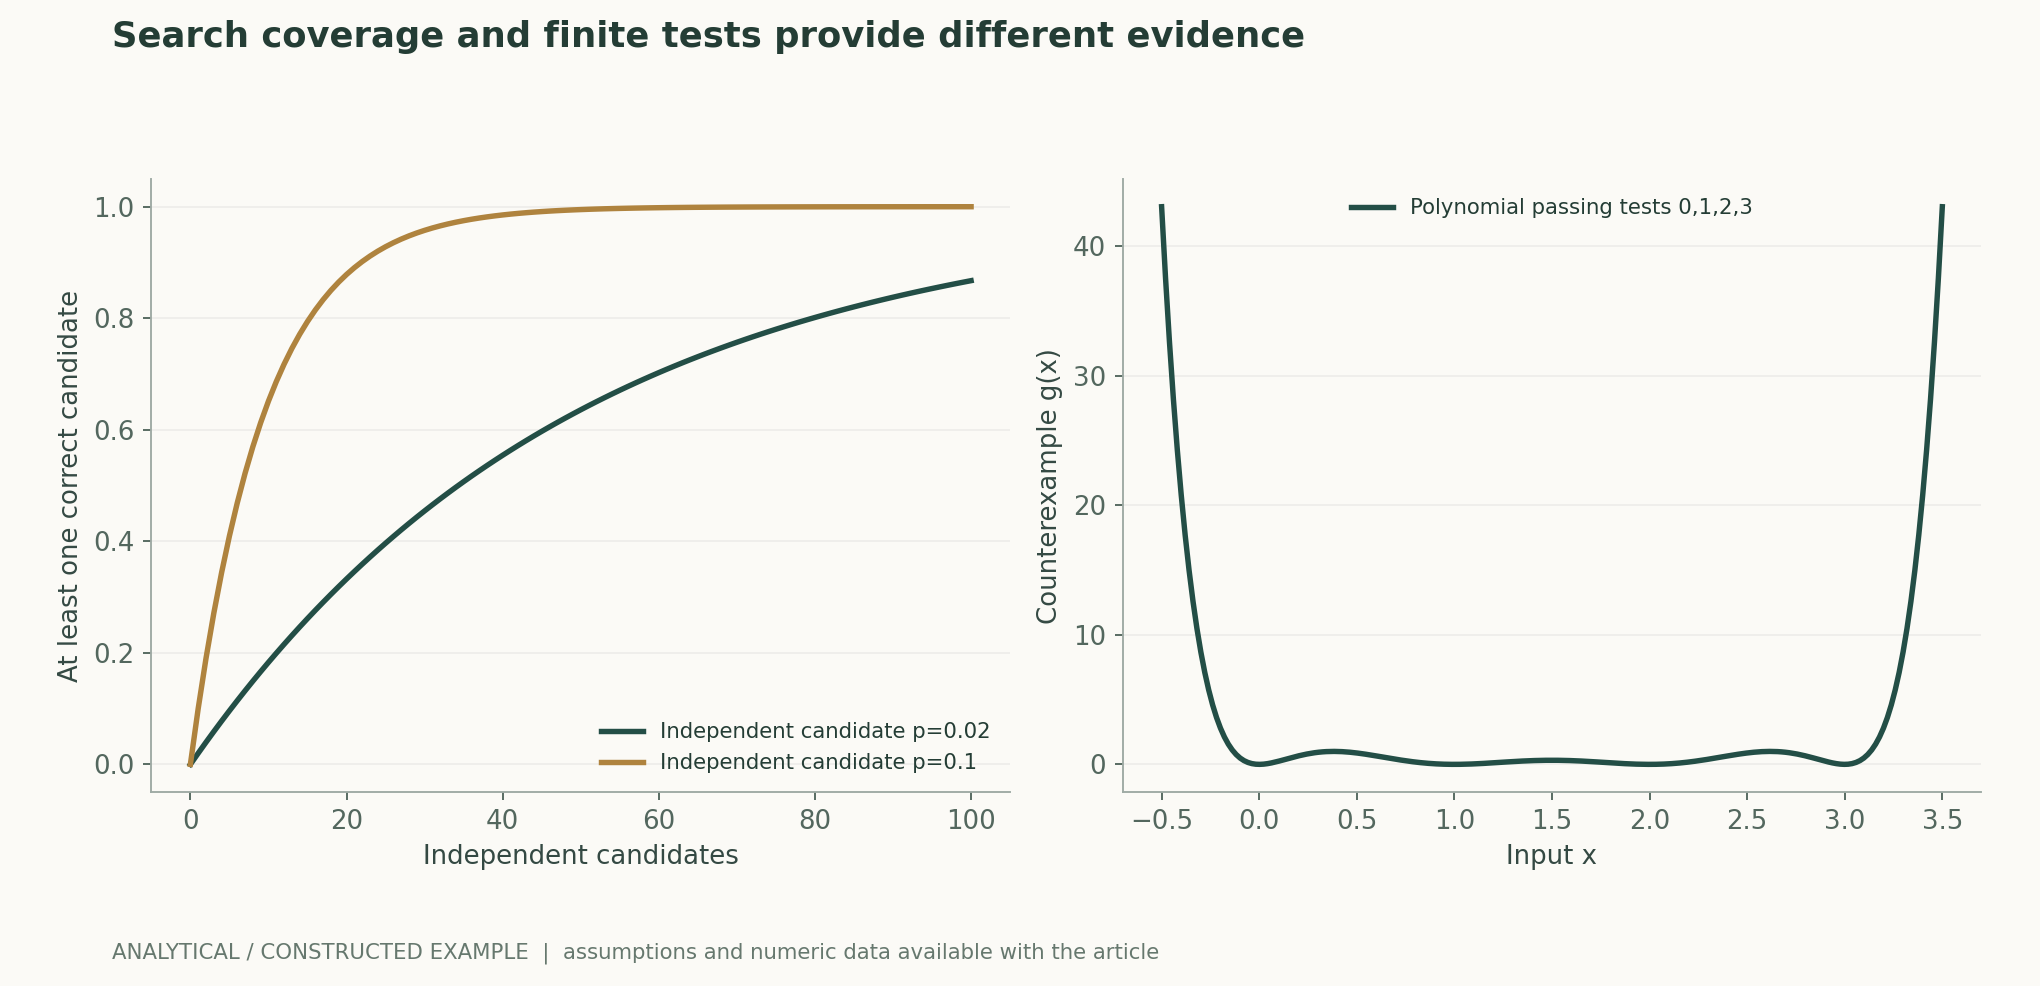
假设独立候选各以概率 p 正确,n 次采样中至少存在一个正确候选的概率为 1−(1−p)^n。这个关系描述候选池的覆盖,却没有包含验证器选中谁。若候选高度相关,独立假设会高估收益;若验证器误报,多采样还会增加错误通过机会。图同时绘制覆盖率与错误通过概率,使用明确的 p 和误报率。它不估计任何实际定理证明器,而是说明搜索预算必须连同选择和验证规则一起报告。作者分析与复核建议 / Author analysis
5. 本文分析:验证预算与提案预算需要共同优化
设总时间预算 B,每个提案成本 cg、每次检查成本 cv,完整检查的候选数至多为 B/(cg+cv) 的向下取整。更复杂的验证器可能降低误报,却减少可检查候选;更快的提案器也可能生成大量重复对象。本文提出以“单位预算获得的可重放有效证据”作为终点,分别记录生成、去重、验证与最终证书成本。只把模型前向速度写成发现加速,会漏掉最耗时的符号展开、编译或独立重放步骤。作者分析与复核建议 / Author analysis
6. 本文反例:有限测试不能证明无界输入上的正确性
对任意有限测试点集合,可以构造一个多项式在这些点全部为零,却在其他点非零。因此,一个候选函数通过全部有限样本,不保证它在无界域满足同一性质。本文用测试点 0、1、2、3 和多项式的平方构造直观曲线:测试点处完全通过,点外迅速偏离。这个反例不否定数值实验的价值,而是要求准确命名证据。有限域的穷举、可核验构造、形式证明和经验测试分别有不同逻辑强度,不能用统一“验证通过”标签掩盖。作者分析与复核建议 / Author analysis
7. 证明检查也有规格与可信基的边界
一个小型独立检查器可以显著缩小需要信任的代码范围,但仍须核对公理、语义、计算内核与输入翻译。本文建议把搜索期间使用的复杂工具与最后证书重放分开:搜索可以使用启发式,最终结论依赖明确可检查步骤。若存在外部数值调用、未证明的假设或超时后人工补写,应在证书中显式列出。检查器接受证明说明相对于给定体系成立,不意味着原始现实问题的建模或测量也已正确。作者分析与复核建议 / Author analysis
8. 搜索所得分数容易受评价器选择影响
反复对同一评价器优化,相当于把它逐渐变成训练目标。FunSearch 的闭环利用这一机制寻找更好程序;但对研究比较而言,还需要冻结外部测试实例或独立证明来判断迁移。本文建议记录全部搜索轮次、候选家族和改动评价器的时间,另设未参与搜索的实例规模或结构。若一个启发式只在熟悉分布上改善,应把它称为该分布的有效策略,而不是泛化到任意规模的定理。[2] Mathematical discoveries from program search with large[3] Let's Verify Step by Step
9. 新发现应区分新数值、新构造与新定理
提高某个有限问题的下界、找到更好的可行构造、发现一个规律和证明一般命题都是有价值成果,但交付形式不同。本文提出一张发现卡:原始规格、已知基线、候选程序、独立检查、适用输入范围以及未证部分。若候选程序包含可被数学解释的结构,应把规律作为新假说单列,再给出证明或反例检验。不能因为模型生成了人类尚未写过的程序,就自动声称它解决了普遍数学问题。作者分析与复核建议 / Author analysis
10. 可复现比较应让失败也可解释
我们提出按问题类型和复杂度预注册集合,对每种方法匹配总计算与人工预算。主要终点为独立重放成功的题目比例,辅以证书大小、搜索时间与翻译失败。未表达、未找到、检查拒绝与资源耗尽应分别统计。这样才能判断新方法改善的是对象生成、推导能力、搜索策略还是工程吞吐,而不把所有失败压成一个难以诊断的“未解”。作者分析与复核建议 / Author analysis
技术补充 A · 依赖图揭示提案的实际贡献
一个辅助点出现在最终图中,不代表证明真正需要它。可从目标结论回溯推导依赖,删除无关前提和中间项,再独立重放剩余证书。AlphaGeometry 相关工作展示了依赖追踪的重要性。本文建议把最小化前后的证书和被移除条件一起保存;如果删去前提后得到更一般命题,还要重新核对原题中的范围和非退化条件。简化依赖图是发现线索,而不是允许忽略语义差异的捷径。[1] Solving olympiad geometry without human demonstrations
技术补充 B · 适应性搜索会改变有效样本
候选由前轮优胜程序生成,分数和结构因此相关。把所有候选看成独立伯努利样本,会夸大搜索覆盖;只统计最终种群又可能隐藏大量失败计算。本文建议以独立搜索运行和问题为主要统计单位,保留祖先关系与重复检测。若想比较生成器,应固定评价与种群规则;若比较完整系统,则匹配总预算并对组件做消融。统计独立性的层级应与主张一致,不能用巨大候选数代替少数独立问题。[2] Mathematical discoveries from program search with large
技术补充 C · 评价器漏洞与数学反例不同
程序可以利用实现细节、溢出、超时或未检查输入获得高分,这不一定是对数学目标的有效改进。本文建议在隔离运行之外设置独立语义检查,并对边界、极端和结构化输入做测试;若成果是可行构造,还应由不同实现重新检查约束。发现评价器漏洞应作为工程缺陷记录,不能被计入数学发现。相反,一个合法反例推翻原猜想是科学成果,两者需要靠规格与独立检查明确区分。作者分析与复核建议 / Author analysis
技术补充 D · 有限域的穷举具有明确边界
有限测试不构成无界证明,但若问题域本来就是精确定义的有限集合,完整穷举可以形成强证据,前提是枚举无遗漏且检查器正确。本文建议记录域大小、枚举规则、去重和分片覆盖,并为总计数提供独立核对。若利用对称性缩减,需要说明等价关系和代表元完备性。不能把抽样检查误称穷举,也不能因使用了计算机就否定有限域证明;关键在于范围和覆盖是否可被独立确认。作者分析与复核建议 / Author analysis
11. 结论:机器发现的强度来自可检查的承诺
神经符号系统最有价值的地方,是让生成模型的探索能力服务于明确的逻辑或程序约束。本文的概率、预算与有限测试反例说明,找到候选、通过评价和获得证明之间存在不可跳过的步骤。公开交付应让一个不信任生成模型的读者也能检查关键结论,并知道证据适用于哪一类问题。这样的发现才有机会成为可以积累、比较和推广的数学知识。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 独立候选存在性,不包含验证器选择能力。
LaTeX
P(\exists\ \mathrm{correct})=1-(1-p)^n(2) 顺序生成并逐一验证的简化预算界;并行与共享开销需另计。
LaTeX
n_{\mathrm{checked}}\le\left\lfloor\frac B{c_g+c_v}\right\rfloor(3) 有限测试反例:在 0、1、2、3 全为0,其他点通常非0。
LaTeX
g(x)=\left[\prod_{i=0}^{3}(x-i)\right]^2(4) 候选正确先验 p、验证器真通过率 t 与假通过率 f 决定最终可靠性。
LaTeX
P(\mathrm{correct}\mid\mathrm{accept})=\frac{p\,t}{p\,t+(1-p)f}方法与证据流程
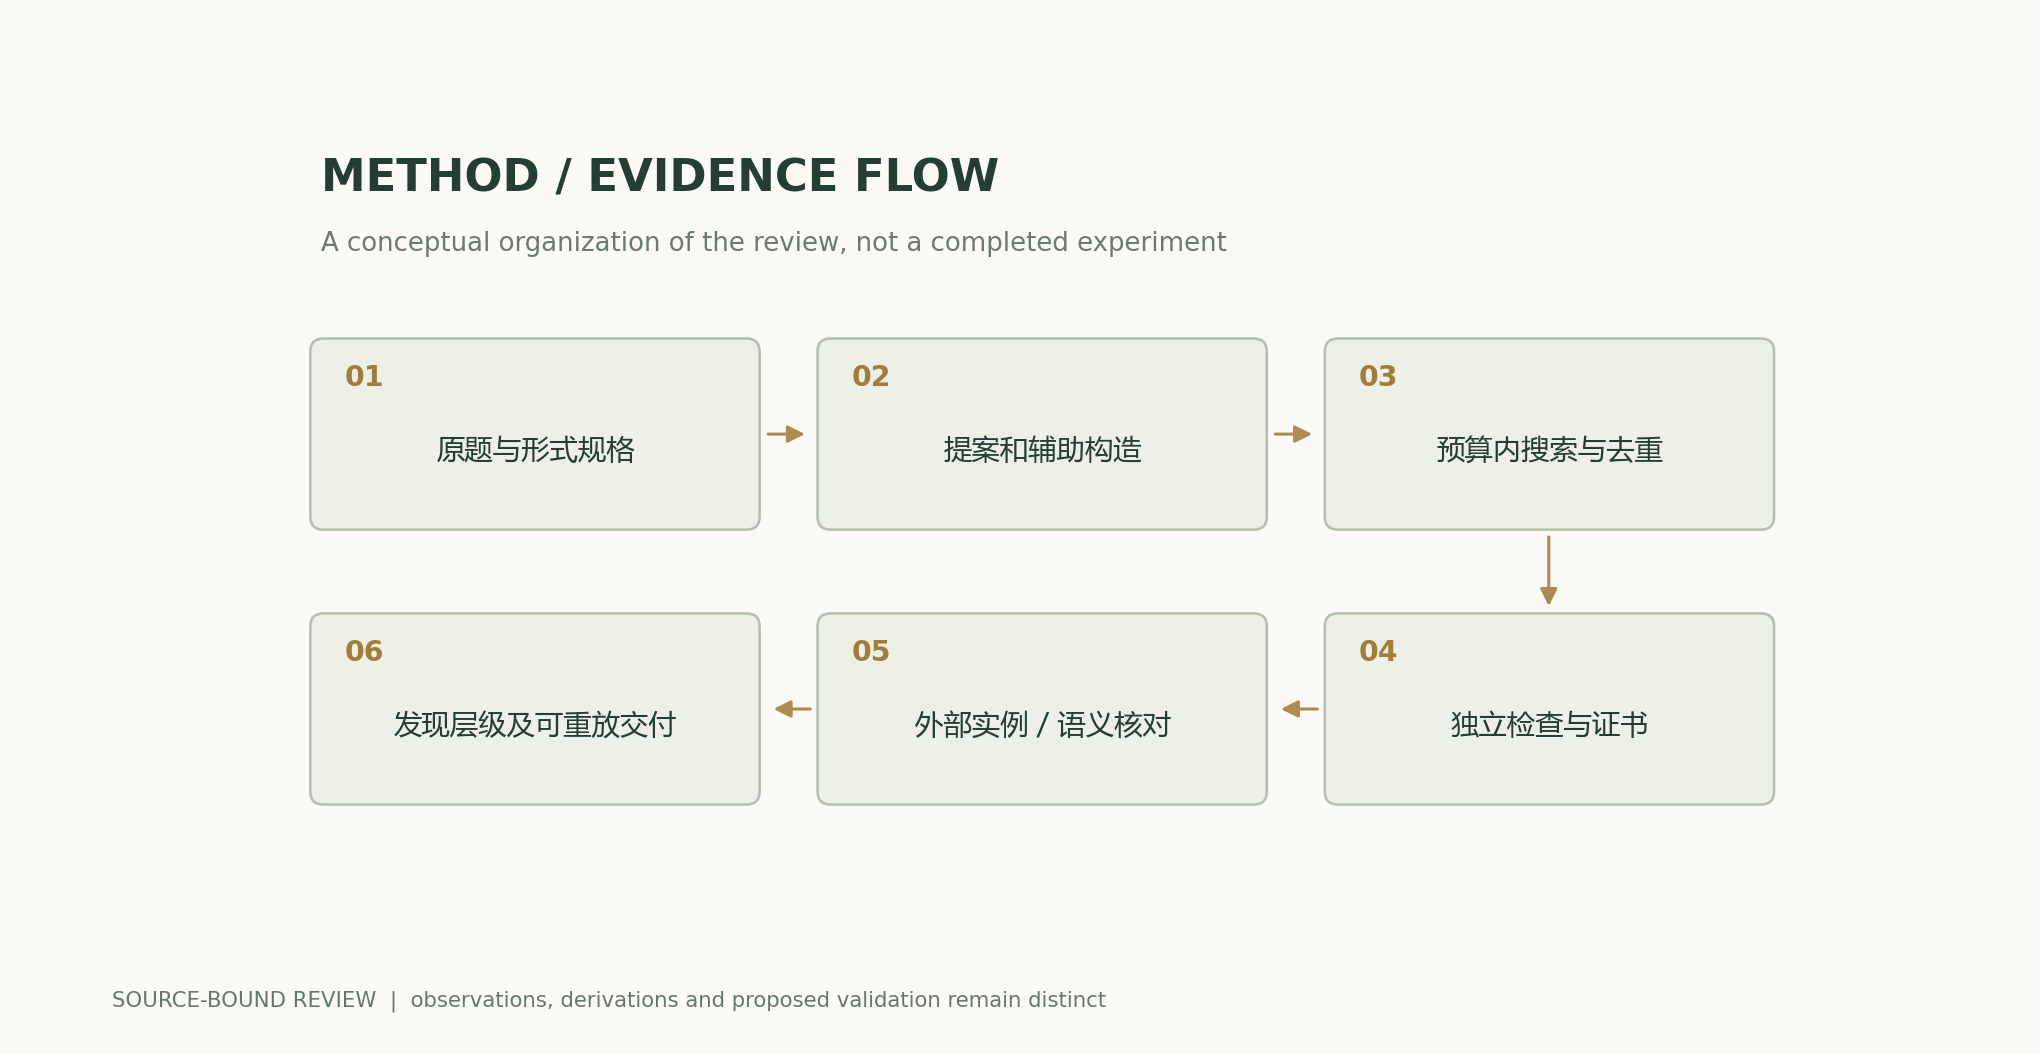
解析图与数值示例
可复算例题
p=0.1、n=20时至少一次正确约0.878423;g在0,1,2,3全为0,但g(0.5)=0.87890625,有限测试不证明无界性质。
方法比较
| 成果层级 | 需要交付的证据 | 不能自动升级为 |
|---|---|---|
| 可运行程序 | 输入、代码和运行条件 | 所有输入正确 |
| 有限测试改进 | 冻结实例及完整结果 | 无界一般定理 |
| 可行构造 | 独立可检查对象 | 全局最优 |
| 下界提升 | 构造与约束证明 | 精确最优值 |
| 形式证明 | 规格、公理、证书重放 | 原题翻译已正确 |
| 一般发现 | 明确命题与证明 / 反例 | 只凭新颖程序成立 |
复核与实验方案
- 冻结原题与形式规格,显式核对非退化和范围条件。
- 将搜索器、评价器与最终检查器分别版本化。
- 匹配完整计算及人工预算,记录生成与验证成本。
- 保留全部搜索和候选家族,避免重复计独立采样。
- 以独立实例或证书重放验证,未证部分单独登记。
- 区分未表达、未找到、检查拒绝和资源耗尽。
- 报告构造、下界、经验规律与一般定理的不同证据等级。
- 交付可在不调用生成模型时重放的证据,不把本文反例称为新定理发现。
适用范围与局限
- 概率曲线假设独立候选,实际搜索有依赖。
- 没有运行 AlphaGeometry 或 FunSearch。
- 有限测试反例只说明逻辑边界,不评价特定程序成果真假。
- 形式证明仍依赖规格和可信计算基。
- 本文未宣称新的数学纪录、最优性或一般定理。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| IMO-AG-30 中解出 25 题并生成可读证明。 | 集合受特定几何语言及题型范围限定。 | Solving olympiad geometry without human demonstrationsBenchmark definition; Table 1; translation scope |
| 将程序生成、评价与种群数据库构成搜索闭环。 | 证据强度取决于规格与评价的覆盖。 | Mathematical discoveries from program search with large language modelsFunSearch method; program database |
值得检验的研究问题
- 固定总预算后,更多候选还是更强检查器更有效?
- 辅助构造的新颖性如何与推导规则的表达范围共同限制成功?
- 程序搜索产生的有限改进能否提炼为可证明的一般结构?
一手来源与主张对应
- Solving olympiad geometry without human demonstrationsTrinh et al. · 2024-01-17IMO-AG-30: 25/30; geometry-language coverage and excluded problem types; author correction noted.
- Mathematical discoveries from program search with large language modelsRomera-Paredes et al. · 2023Program generation, evaluation function, population database and search; evaluator validity is part of the system.
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c