
Resumen: qué debe demostrarse tras ampliar los catálogos
La metagenómica incorpora al ámbito de la investigación secuencias de microorganismos no cultivados, pero un nuevo clúster génico, una especie candidata y una función predicha por un modelo se sitúan en niveles de evidencia distintos. Basándose en el catálogo global de genomas microbianos y el catálogo unificado del intestino humano, este artículo analiza los errores desde las lecturas crudas hasta el ensamblaje, el agrupamiento en bins, la clasificación y la inferencia funcional. Proponemos contabilizar por separado la «información genómica recuperable» y las «funciones biológicas validadas», evitando convertir directamente el tamaño de una base de datos en un número de descubrimientos mecanísticos.[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
Traducción del resumen original en inglés
La metagenómica resuelta a nivel genómico amplía el acceso a la diversidad no cultivada, pero el tamaño del catálogo no constituye una validación funcional. Analizamos los límites de detección, la incertidumbre del ensamblaje y del agrupamiento en bins, la evaluación que tiene en cuenta los linajes y los componentes ausentes de las vías. Los ejemplos de muestreo de Poisson y de completitud muestran cómo la profundidad de secuenciación y la recuperación de genomas condicionan las afirmaciones que pueden hacerse a partir de una novedad aparente.
Los recursos que realmente proporcionan dos grandes catálogos
Nayfach y colaboradores recopilaron genomas ensamblados a partir de metagenomas de distintos ambientes, mientras que Almeida y colaboradores integraron genomas de referencia del intestino humano. Estos recursos amplían el acceso a la diversidad no cultivada y ofrecen un marco de referencia para estudios comparativos. Este artículo utiliza las páginas de las fuentes actualizadas y sus avisos de corrección; no reutiliza cifras de filos que podrían diferir entre el texto principal y el resumen, ni equipara directamente el número de registros genómicos no redundantes con el de especies independientes o validaciones experimentales.[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
Las lecturas no son un microcosmos sin sesgos de los microorganismos
La eficiencia de extracción del ADN, la longitud de los fragmentos y la profundidad de secuenciación afectan a la probabilidad de que cada grupo microbiano quede representado en los datos. Un mismo número de células no garantiza un mismo número de lecturas, porque pueden variar el tamaño del genoma, el número de copias y el procesamiento de las muestras. Los estudios deben especificar si la magnitud que se pretende estimar es la abundancia relativa de lecturas, las copias genómicas o el número de células. Sin la calibración correspondiente, pasar de una base de medición a otra produce interpretaciones ecológicas excesivamente precisas.作者分析与复核建议 / Author analysis
La falta de detección puede deberse simplemente a una profundidad insuficiente
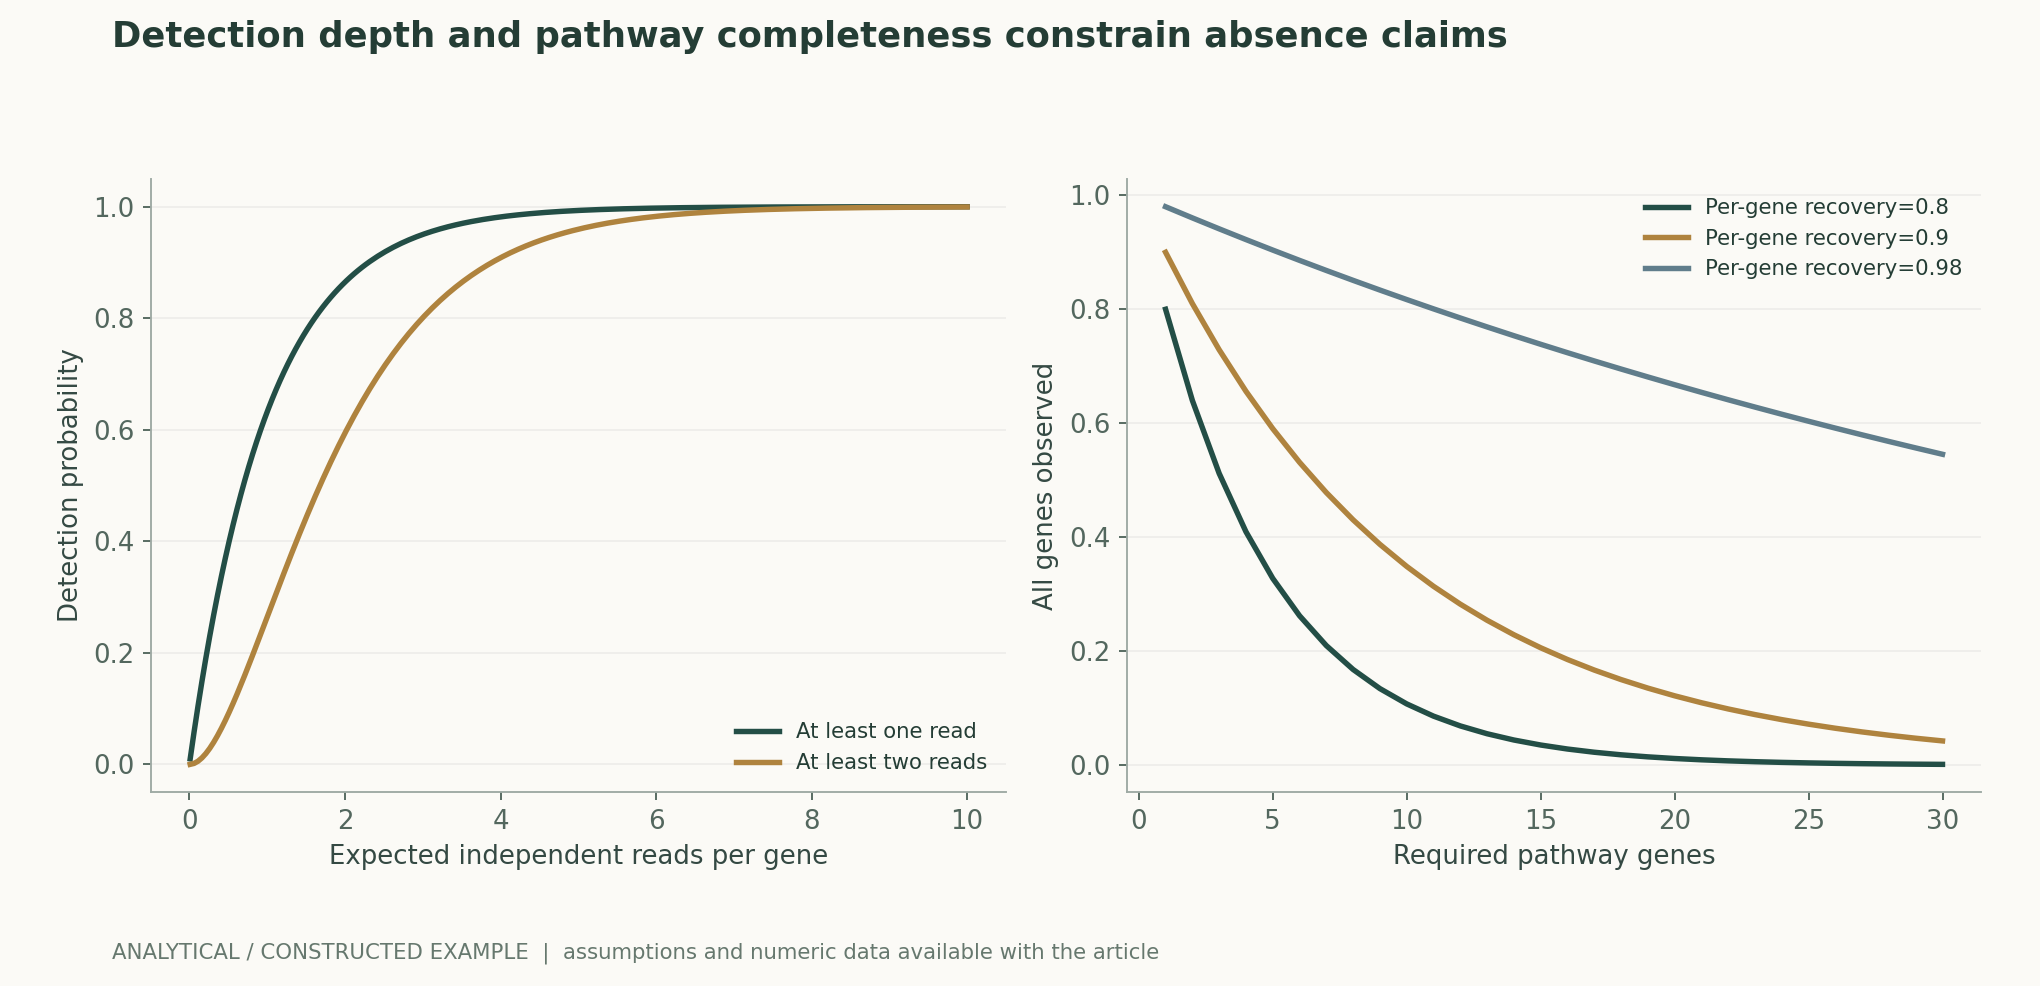
En un modelo de Poisson simplificado, un gen recibe una media de λ lecturas independientes, y la probabilidad de detectarlo al menos una vez es 1−exp(−λ). Cuando λ es 0.5, incluso si el gen está realmente presente, sigue habiendo una probabilidad aproximada de 60.7% de no observarlo en absoluto. Si se exigen al menos dos lecturas de apoyo, la probabilidad de detección es aún menor. La figura muestra únicamente el efecto del muestreo aleatorio; el alineamiento real, las copias múltiples y los sesgos de extracción modifican adicionalmente los resultados, por lo que la falta de detección no puede clasificarse directamente como ausencia biológica.作者分析与复核建议 / Author analysis
Cobertura del ensamblaje y ausencia de funciones
Una vía requiere varios genes y, aunque la probabilidad de recuperar cada gen sea relativamente alta, la probabilidad de recuperarlos todos disminuye al aumentar el número de componentes necesarios. En un modelo construido con probabilidades independientes e iguales, diez genes con una probabilidad de recuperación de 90% cada uno presentan una probabilidad de observación completa de aproximadamente 34.9%. Esta no es una tasa real de completitud de las vías, sino una ilustración de que un «eslabón perdido» puede deberse a un ensamblaje incompleto. A la inversa, la contaminación de los bins también puede reunir genes de organismos distintos en una función aparentemente completa.作者分析与复核建议 / Author analysis
Los límites del agrupamiento en bins definen la entidad biológica
Los genomas ensamblados a partir de metagenomas suelen ser entidades compuestas reconstruidas a partir de poblaciones mixtas, y no necesariamente corresponden a una única cepa aislada y cultivada. Las cepas próximas, los elementos móviles y las secuencias repetitivas pueden difuminar sus límites. La evaluación debe informar conjuntamente sobre la completitud, los indicadores de contaminación y las mezclas estructurales que estos indicadores no captan. Ordenarlos únicamente por una puntuación de calidad puede condensar distintos tipos de error en un mismo valor y perder información necesaria para la interpretación funcional posterior.作者分析与复核建议 / Author analysis
Los umbrales de no redundancia no definen las especies naturales
El agrupamiento por similitud de secuencia ayuda a organizar grandes catálogos, pero los umbrales son reglas operativas. Diferentes criterios de similitud, coberturas de alineamiento y versiones de referencia pueden producir distintos números de clústeres. Este artículo recomienda conservar los parámetros de agrupamiento y las reglas de selección de representantes, y comparar la sensibilidad a los umbrales. Denominar directamente a un clúster operativo especie ecológica independiente requiere más evidencias poblacionales, evolutivas y funcionales; debe mantenerse su condición de candidato, especialmente cuando solo se dispone de un genoma incompleto.作者分析与复核建议 / Author analysis
La novedad tiene al menos tres niveles
La novedad de secuencia significa diferencia respecto de secuencias conocidas; la novedad estructural concierne al plegamiento o a la organización; la novedad funcional exige un efecto nuevo y medible. Una única etiqueta de «sin anotación» no puede demostrar las tres. La falta de anotación también puede deberse a secuencias cortas, ensamblajes erróneos o una cobertura insuficiente de la base de datos. Los estudios deben aportar indicadores independientes para cada nivel y situar las predicciones en la categoría de hipótesis, en lugar de utilizar la confianza del modelo para elevar directamente lo desconocido a la categoría de nuevo mecanismo.作者分析与复核建议 / Author analysis
Fuga de datos de entrenamiento en la anotación mediante IA
Los modelos de predicción funcional pueden alcanzar puntuaciones de prueba muy altas gracias a secuencias próximas o familias homólogas y, aun así, tener dificultades para extrapolar a funciones verdaderamente no vistas. La partición aleatoria por secuencias suele ser insuficiente para evaluar ese objetivo. Este artículo recomienda reservar conjuntos de evaluación según la familia proteica, la distancia filogenética y la procedencia de las muestras, y declarar las versiones de las bases de entrenamiento. Si la entidad evaluada ya tiene un homólogo anotado casi idéntico, el resultado se describe mejor como transferencia de anotación que como descubrimiento de una función desconocida.作者分析与复核建议 / Author analysis
Por qué la adyacencia génica es útil pero insuficiente
La adyacencia génica, la coocurrencia y las asociaciones ambientales pueden aumentar la plausibilidad de las hipótesis funcionales, pero los patrones de correlación pueden deberse a un linaje compartido, elementos móviles o errores de ensamblaje. Al utilizar estos indicios como evidencia, debe controlarse el parentesco filogenético y examinarse su repetición entre muestras. Los patrones de adyacencia no sustituyen la medición funcional directa ni distinguen automáticamente los componentes necesarios de un clúster génico de las secuencias acompañantes. Un modelo razonable debe indicar qué observaciones refutarían la interpretación actual.作者分析与复核建议 / Author analysis
De la presencia a la expresión y al efecto
La presencia de un gen indica una capacidad potencial; su expresión sugiere que se utiliza en determinadas condiciones, y las mediciones de proteínas o metabolitos restringen aún más la interpretación del proceso funcional; los efectos ecológicos requieren además una conexión con las poblaciones y el ambiente. Los distintos niveles pueden discrepar, y esas discrepancias suelen ser informativas. Este artículo recomienda conservar la correspondencia entre niveles para una misma muestra, en lugar de unir los resultados más sólidos de estudios diferentes en una cadena de evidencias aparentemente completa que, en realidad, no ha sido validada en la misma entidad.作者分析与复核建议 / Author analysis
La representatividad ambiental limita las conclusiones globales
El número de continentes de los que proceden las muestras no implica una cobertura uniforme de ambientes, estaciones y microhábitats. Los lugares de fácil muestreo y los focos de investigación consolidados pueden concentrar la mayor parte de los datos. Los catálogos globales son muy valiosos, pero los nichos ecológicos no muestreados no pueden cubrirse automáticamente mediante interpolación con modelos. Las estadísticas publicadas deben especificar la cobertura ambiental y sus lagunas, comparar las tasas de recuperación entre procedencias y evitar calificar directamente de raros en la naturaleza a los taxones poco frecuentes en el catálogo.作者分析与复核建议 / Author analysis
Abundancia relativa y efectos composicionales
La metagenómica suele normalizar todas las lecturas como proporciones cuya suma es uno. Cuando un taxón se expande, la proporción de otros puede disminuir aunque sus cantidades absolutas no cambien. Por tanto, las redes de asociación deben interpretarse con cautela. Este artículo recomienda incorporar cantidades absolutas o estándares externos cuando sea posible y comparar las reglas de normalización. Una correlación negativa entre abundancias relativas no basta para establecer competencia, inhibición o exclusión ecológica; los modelos necesitan intervenciones adicionales o datos mecanísticos.作者分析与复核建议 / Author analysis
Cómo establecer prioridades de validación
La selección de funciones candidatas puede combinar novedad, mensurabilidad, importancia ambiental e incertidumbre, pero sus ponderaciones deben ser transparentes de antemano. Validar únicamente las puntuaciones más altas del modelo mantiene invisibles sus patrones de error a largo plazo. Deben conservarse candidatos de control seleccionados aleatoriamente o mediante muestreo estratificado para estimar la tasa de aciertos de todo el proceso de descubrimiento. Tanto los éxitos como los fracasos deben reincorporarse al catálogo, de modo que los modelos posteriores aprendan del proceso de selección completo y no solo de los ganadores seleccionados.作者分析与复核建议 / Author analysis
Cuando las versiones de los datos cambian las conclusiones
La incorporación de referencias puede reasignar secuencias antes «desconocidas» a familias conocidas; un nuevo agrupamiento en bins también puede desarticular vías que parecían completas. Por ello, las anotaciones funcionales deben vincularse a huellas digitales de las secuencias, versiones de las bases de datos y versiones de los modelos. Las correcciones posteriores deben conservar los registros antiguos y sus motivos, sin reescribir silenciosamente los descubrimientos previos. El control de versiones permite distinguir las reinterpretaciones debidas a nuevos conocimientos de los errores del análisis original.作者分析与复核建议 / Author analysis
Implicaciones contrastables de los ejemplos analíticos
Los modelos de detección de Poisson y de recuperación independiente de genes de este artículo no utilizan muestras microbianas reales. Proporcionan dos contraejemplos capaces de refutar conclusiones excesivas: la presencia no garantiza la detección, y una recuperación elevada de genes individuales no garantiza que una vía completa sea observable. Al repetir los cálculos pueden modificarse la profundidad, el umbral de apoyo y la longitud de la vía para examinar cómo cambian las conclusiones. Las aplicaciones reales requieren sustituir estos supuestos por modelos de detección específicos de cada muestra; las curvas ilustrativas no deben tratarse como estimaciones de la calidad de una base de datos.作者分析与复核建议 / Author analysis
Contenido mínimo de un paquete de investigación revisable de forma independiente
Deben conservarse los metadatos de las muestras permitidos legalmente, los resúmenes de lecturas y ensamblajes, las asignaciones a bins, los indicadores de control de calidad, las versiones de anotación, las reglas de agrupamiento y los niveles de evidencia. Las hipótesis funcionales principales deben poder rastrearse, como mínimo, hasta las secuencias exactas y las muestras de origen, mostrando las explicaciones alternativas. Compartir únicamente una lista de nombres de funciones no permite una revisión independiente. Los materiales publicados con este artículo son datos analíticos, figuras y código; no incluyen nuevos cultivos microbianos ni experimentos funcionales.作者分析与复核建议 / Author analysis
Conclusión: mantener lo desconocido abierto a la investigación
El valor científico de la materia oscura microbiana reside en ampliar el espacio de hipótesis contrastables, no en presentar el número de nombres desconocidos como funciones ya comprendidas. Una cadena de descubrimiento fiable debe explicar, nivel por nivel, el muestreo, la recuperación, los límites de las entidades y las evidencias de sus efectos. La IA puede ayudar a ordenar y relacionar indicios, pero el avance final sigue requiriendo vincular las predicciones con entidades bien definidas y mediciones reproducibles, e incorporar también los fracasos y las correcciones al conocimiento público.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Muestreo simplificado de lecturas independientes, sin sesgos de extracción ni de alineamiento.
LaTeX
P(K\geq1)=1-e^{-\lambda},\qquad K\sim\operatorname{Poisson}(\lambda)(2) Probabilidad de detección con al menos dos lecturas de apoyo.
LaTeX
P(K\geq2)=1-e^{-\lambda}(1+\lambda)(3) Modelo supuesto con m componentes independientes y probabilidades de recuperación iguales.
LaTeX
P(\mathrm{all\ genes\ recovered})=p^m(4) Normalización composicional; los cambios de abundancia relativa por sí solos no determinan los cambios absolutos.
LaTeX
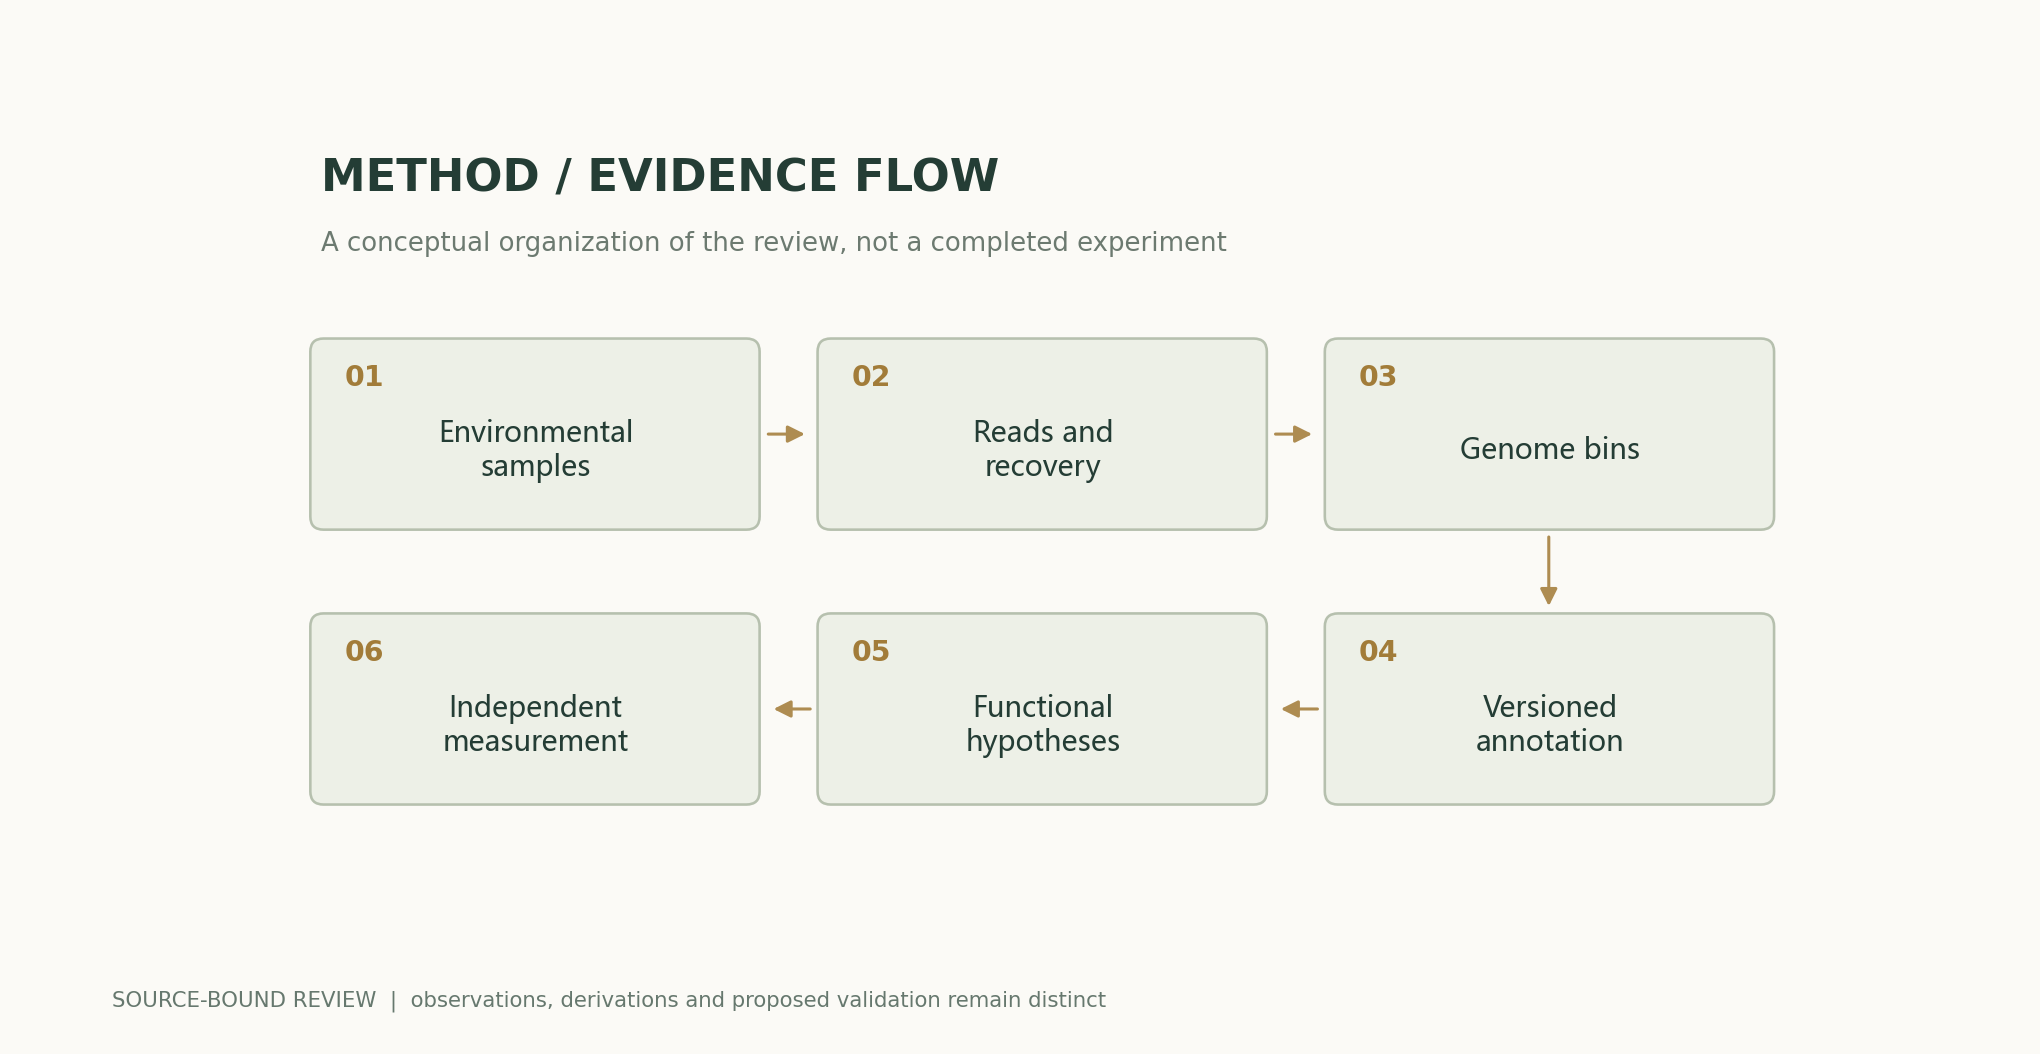
a_i=x_i/\sum_j x_jFlujo de métodos y evidencias
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto con cálculos reproducibles
Cuando lambda=0.5, la probabilidad de obtener cero lecturas es exp(-0.5)=0.606531. Si diez componentes tienen cada uno una probabilidad independiente de recuperación de 90%, la probabilidad de observarlos todos es 0.9^10=0.348678.
Comparación de métodos
| Método o base de medición | Qué se restringe directamente | Evidencias aún necesarias |
|---|---|---|
| Secuencia nueva | Diferencias de secuencia no observadas previamente | Ensamblaje erróneo y lagunas de la base de datos |
| Clúster operativo nuevo | Agrupamiento según un umbral | Límites de las especies naturales |
| Función nueva predicha | Asociaciones del modelo | Medición directa de efectos |
| Vía completa | Observación de los componentes necesarios | Contaminación entre bins y expresión |
| Asociación ambiental | Coocurrencia y distribución | Confusión por linaje y causalidad |
| Experimento funcional | Efectos en condiciones específicas | Contexto ecológico y transferibilidad |
Plan de revisión y experimentación
- Fijar el alcance de las muestras, los permisos y la magnitud objetivo que se desea estimar.
- Registrar la extracción, la profundidad y el filtrado de lecturas.
- Conservar las versiones del ensamblaje y del agrupamiento en bins, así como los casos fallidos.
- Comprobar la contaminación y la completitud mediante criterios independientes.
- Etiquetar por separado la novedad de secuencia, estructural y funcional.
- Evaluar la anotación mediante IA con conjuntos reservados por familia y procedencia.
- Examinar la sensibilidad a los datos ausentes, la composición y la cobertura ambiental.
- Publicar las huellas digitales exactas de las secuencias, los niveles de evidencia y una interfaz para correcciones posteriores.
Ámbito de aplicación y limitaciones
- Sin nuevos metagenomas ni experimentos funcionales.
- El muestreo de Poisson omite múltiples errores sistemáticos.
- La independencia de los componentes del modelo de vías generalmente no se cumple.
- Los registros del catálogo no equivalen a especies independientes.
- La predicción y la coocurrencia no sustituyen la validación funcional y causal.
Evidencias de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| El catálogo global de MAG amplía el acceso a microorganismos no cultivados. | Limitado por las muestras y los umbrales de calidad; se utiliza la página corregida. | Un catálogo genómico de los microbiomas de la TierraResumen; figuras 1–3 |
| UHGG integra recursos no redundantes de genomas y proteínas intestinales. | Recursos de catálogo y anotación; no equivalen a experimentos funcionales de cada entrada. | Un catálogo unificado de 204,938 genomas de referencia del microbioma intestinal humanoResumen; construcción del catálogo |
Preguntas de investigación que merece la pena contrastar
- ¿Cómo modifica la información ausente en el ensamblaje la evaluación probabilística a posteriori de la presencia de una vía?
- ¿Pueden calibrarse las puntuaciones funcionales de IA para familias no vistas?
- ¿El muestreo de qué ambientes aporta más información funcional real?
Correspondencia entre fuentes primarias y afirmaciones
- A genomic catalog of Earth’s microbiomesStephen Nayfach, Simon Roux, Rekha Seshadri, Daniel Udwary, Neha Varghese, Frederik Schulz, et al. · 2020-11-09Abstract; Figs. 1–3; encoded functional potential
- A unified catalog of 204,938 reference genomes from the human gut microbiomeAlexandre Almeida, Stephen Nayfach, Miguel Boland, Francesco Strozzi, Martin Beracochea, Zhou Jason Shi, et al. · 2020-07-20Abstract; catalogue construction and clustering
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versiones y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo examinan las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de una revisión por pares independiente de este artículo ni de registros de experimentos originales con modelos, clínicos o físicos correspondientes a él.
Primera publicación: un monográfico interdisciplinario en profundidad sobre evidencia científica; mantiene la separación entre las fuentes de cada sección, las evidencias de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se elaboraron con el código y los archivos numéricos adjuntos; sus leyendas detallan los supuestos y las bases de medición de cada elemento.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da